LoRA(Low-Rank Adaptation)とは?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
fine-tuningのコストについて調べていて「AIにおけるLoRAとは何か」と疑問に思われたなら、短く答えるとこうなります。LoRA(Low-Rank Adaptation)は、パラメータ効率の高いfine-tuning手法です。事前学習済みモデルの元の重みを固定し、代わりにその横に置いた小さな「アダプター」行列だけを学習させます。数十億のパラメータを更新する代わりに、そのごく一部(多くの場合1%未満)だけを更新しながら、フルfine-tuningと同等かそれに近い品質を、計算資源とストレージのわずかなコストで実現します。
LoRAの仕組み
大規模なニューラルネットワークの各層には、学習中に更新される重み行列が含まれています。フルfine-tuningは、そのすべての数値に手を加えます。LoRAは異なるアプローチを取ります。元の重み行列を完全に固定し、その隣に、2つの細い行列を掛け合わせて作った、はるかに小さい第2の経路(「低ランク分解」)を追加するのです。学習中に学ぶのは、その2つの小さな行列だけです。元のモデルは一切変わりません。
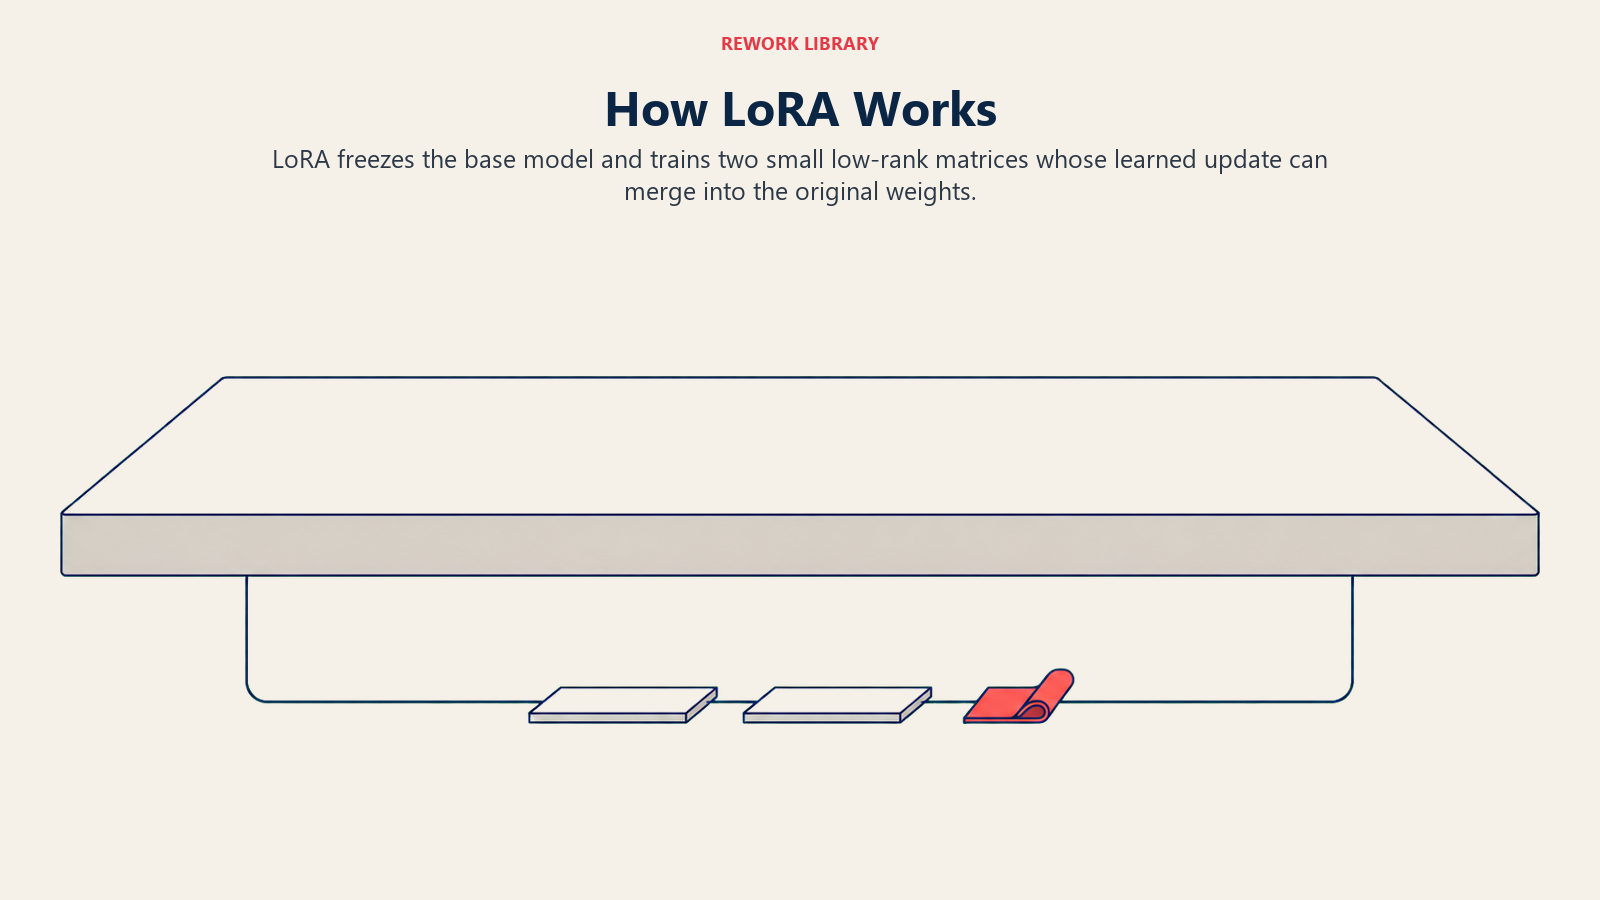
直感的な考え方は、数式の印象よりずっと単純です。大きな重み行列には数百万のパラメータがあるかもしれませんが、モデルを新しいタスクや新しい文体に適応させるために必要な変化分は、はるかに小さな部分空間に収まることが多いのです。LoRAは、この「差分」、つまり汎用モデルと目的に特化したモデルとの違いが、1つの巨大な行列ではなく2つの小さな行列で表現できるという見方に賭けています。この手法は、事前学習済みモデルを新しいタスクに適応させるのに、ゼロから再学習する必要はほとんどないことを示した、初期の転移学習の研究から発展しました。
推論時には、2つの小さな行列を数学的に元の重みへ統合できるため、LoRAで適応させたモデルはベースモデルとまったく同じ速度で動作します。追加の層も、増えるレイテンシもありません。学習が終われば、アダプターは事実上重みの中に溶け込むからです。
重要な事実:LoRA(Low-Rank Adaptation)
- 元のLoRA論文(Hu et al., 2021, arXiv:2106.09685)によると、LoRAは、AdamによるGPT-3 175Bのフルfine-tuningと比べて、学習可能なパラメータ数を1万分の1に、GPUメモリ要件を3分の1に削減します。
- GPT-3 175BのLoRAチェックポイントは約35MBで、フルfine-tuningしたコピーの約350GBに対し、ランクr=4で約1万分の1の削減です(Hu et al., 2021)。
- 4ビット量子化を加えたLoRAの派生手法であるQLoRAは、650億パラメータのモデルを1枚の48GB GPUでfine-tuningでき、フル16ビットのfine-tuningと同等の品質を維持します(Dettmers et al., 2023, arXiv:2305.14314)。
LoRAがビジネスAIにとって重要な理由
経営層にとってLoRAとは、フルfine-tuningが要求する計算資源、ストレージ、エンジニアリング工数をかけずに、大規模なfoundation modelを自社のトーン、専門用語、タスクに合わせてカスタマイズできることを意味します。 汎用ツールを一から作り直すのではなく、目的に特化した小さなアタッチメントを取り付けるようなものと考えてください。
このコストの差はわずかではありません。Hu et al.(2021)によると、LoRAはフルfine-tuningと比べて、GPT-3 175Bの学習可能なパラメータ数を1万分の1に、GPUメモリ要件を3分の1に削減しながら、RoBERTa、DeBERTa、GPT-2、GPT-3にわたるベンチマークタスクで、フルfine-tuningと同等かそれ以上の性能を示しました。リソースコストのごく一部で、ほぼ同等の品質を実現するというこの組み合わせこそ、LoRAが大規模言語モデルを扱うほとんどのチームにとって例外ではなく標準のfine-tuning手法となった理由です。
ストレージも同じ構図です。GPT-3 175Bのフルfine-tuningしたコピーには約350GBが必要です。同じモデルのLoRAアダプターに必要なのは約35MBです(Hu et al., 2021)。つまり企業は、法務文書レビュー用、カスタマーサポートのトーン用、特定の製品ライン用など、タスクごとのアダプターを何十個も共有のベースモデル上に保持でき、バリエーションごとに数百GBを複製する必要がありません。Hu et al.は、この方法で100個の適応済みモデルをホスティングする場合のコストは合計約354GBで、100個の独立したフルコピーの約35TBに比べてはるかに小さいと述べています。
LoRAは、2つ目のブレークスルーであるQLoRAも可能にしました。Dettmers et al.(2023)が発表したQLoRAは、LoRAと固定されたベースモデルの4ビット量子化を組み合わせ、メモリ要件を大きく縮小して、650億パラメータのモデルを1枚の48GB GPUでfine-tuningしつつ、フル16ビットのfine-tuningと同等のタスク性能を維持します。この論文から生まれたモデルファミリーGuanacoは、1枚のGPUでわずか24時間のfine-tuningを行っただけで、VicunaベンチマークでChatGPTの性能水準の99.3%に達しました。この成果によって、多くのチームにとって大規模モデルのカスタマイズは、複数GPUのサーバークラスターから、1台のワークステーションGPUへと移りました。
LoRAの一般的なユースケース
LoRAは、1つのベースモデルに対して、それぞれを完全に再学習するコストをかけずに多数の特化バージョンを必要とする場面で活躍します。
- ドメイン適応。 汎用LLMに、法務、医療、金融といった業界の語彙を、ベースモデルに触れることなく教えます。
- ブランドボイスとトーン。 モデルの文体を、企業のサポートスクリプトやマーケティングの語り口に合わせます。
- マルチテナントのAIプロダクト。 多数の顧客にサービスを提供するSaaSプラットフォームは、共有のベースモデルを1つ保持し、顧客ごとに軽量なLoRAアダプターを切り替えることで、数百のフルモデルコピーにかかるストレージとサービングのコストを避けられます。
- 迅速な実験。 LoRAの学習は数日ではなく数時間で終わり、必要なGPUメモリもはるかに少ないため、同じ予算でより多くのfine-tuningのアイデアを試せます。
- 画像・拡散モデルのカスタマイズ。 LoRAはテキストモデル以外でも広く使われています。アーティストや製品チームは、数ギガバイトの再学習済みモデルではなく小さなアダプターファイルで、画像生成モデルを特定のアートスタイルや製品ラインに適応させられます。
- エッジおよびリソース制約のある環境への展開。 モデル最適化の手法と組み合わせることで、フル再学習のインフラがない環境でも、LoRAアダプターが特化した能力を利用可能にします。
LoRA、フルfine-tuning、RAGの比較
この3つのアプローチは、関連はあっても異なる課題を解決するもので、チームは複数を組み合わせることもよくあります。
| アプローチ | 変更対象 | 最適な用途 | 計算資源・ストレージのコスト | 更新速度 |
|---|---|---|---|---|
| フルfine-tuning | すべてのモデルの重み | 予算と大規模で高品質なデータセットがある場合の最大限のカスタマイズ | 最高(GPUクラスター全体、バージョンごとにモデル全体のストレージ) | 再学習に時間がかかる |
| LoRA(およびQLoRA) | 追加した少数の低ランクアダプター行列。ベースの重みは固定 | 新しいトーン、専門用語、タスク固有の挙動を効率的に学習させる | 低(単一GPUで可能、アダプターはMB単位) | 再学習が速く、アダプターの切り替えが容易 |
| Retrieval-augmented generation | モデルには何も変更しない。クエリ時に関連ドキュメントを取得してプロンプトに渡す | 変化の速い事実に回答を追従させる、または特定の出典ドキュメントを引用する | 低(学習不要、インデックス化したナレッジベースのみ) | 即時。元のドキュメントを更新するだけ |
実用上の経験則は次のとおりです。モデルに最新の情報や自社固有の事実を知らせたいときはRAGを使い、モデルの振る舞いや書き方を変えたいときはLoRAを使い、LoRAの小さなパラメータ予算では必要な変化を捉えきれないまれなケースに限ってフルfine-tuningを選びます。両者は別の課題を解決するため、本番システムの多くはLoRAで適応させたモデルと、検索用のRAGを組み合わせています。
LoRAの限界
LoRAはフルfine-tuningの万能な代替ではなく、現実的なトレードオフがあります。
- ランクの選択が重要。 ランクが低すぎると複雑なタスクで適合不足になり、高すぎるとLoRAの効率面の優位性が失われ始めます。Hu et al.(2021)は、テストしたGPT-3のタスクではランクが1と小さくても十分なことが多いと報告していますが、これはタスクによって異なり、ユースケースごとに検証が必要です。
- まったく新しい知識を教えるのには不向き。 LoRAは振る舞いや文体の適応には優れていますが、ベースモデルが一度も見たことのない大量の新しい事実知識を注入するのには適していません。その場合は、一般的にRetrieval-augmented generationや継続的な事前学習の方が向いています。
- 有能なベースモデルが依然として必要。 LoRAはfoundation modelがすでに知っていることを適応させるもので、基盤となる能力そのものを欠いたベースモデルを補うことはできません。
- アダプター管理のオーバーヘッド。 多数のLoRAアダプターを本番で運用するには、それらを読み込み、切り替え、バージョン管理するインフラが必要です。モデル全体のバージョン管理よりは小さな問題ですが、ゼロではありません。
- 圧縮技術とは異なる。 LoRAが削減するのは学習コストであり、必ずしも推論コストやサービング時のモデルサイズではありません(統合後のモデルはベースモデルと同じサイズです)。デプロイするモデル自体を小さくしたいチームは、通常、LoRAに加えて別途モデル圧縮や知識蒸留に取り組みます。
詳しく知る
- Fine-tuning - LoRAが属する、より広い手法のカテゴリ
- Foundation Models - LoRAアダプターが上に学習される基盤モデル
- 大規模言語モデル - LoRAがもともと対象としていたモデルクラス
- 量子化 - QLoRAがLoRAと組み合わせる手法
- 転移学習 - LoRAが土台とする研究基盤
- 知識蒸留 - モデルを適応させるのではなく縮小するための代替アプローチ
LoRAに関するよくある質問
AIにおけるLoRAとは、一言で言うと何ですか?
LoRA(Low-Rank Adaptation)は、パラメータ効率の高いfine-tuning手法で、事前学習済みモデルの重みを固定し、追加した小さなアダプター行列だけを学習させます。計算資源とストレージのわずかなコストで、フルfine-tuningの品質の多くを実現します。
LoRAはfine-tuningの一種ですか?
はい。LoRAは、パラメータ効率の高いfine-tuning(PEFT)手法です。PEFTとは、すべての重みを更新するフルfine-tuningとは異なり、モデル全体ではなく少数のパラメータだけを更新して事前学習済みモデルを適応させる手法群のことです。
LoRAはフルfine-tuningと比べてどれくらい安いのですか?
元のLoRA論文(Hu et al., 2021)によると、LoRAは、AdamによるGPT-3 175Bのフルfine-tuningと比べて、学習可能なパラメータを1万分の1に、GPUメモリ要件を3分の1に削減しながら、テストしたベンチマークでフルfine-tuningと同等かそれ以上の品質を達成しています。
QLoRAとは何で、LoRAとどう違うのですか?
QLoRAは、標準のLoRAに固定されたベースモデルの4ビット量子化を加え、メモリ要件をさらに削減します。Dettmers et al.(2023)は、QLoRAが650億パラメータのモデルを1枚の48GB GPUでfine-tuningでき、フル16ビットのfine-tuningと同等の性能を維持できることを示しました。
LoRAは推論時にモデルを遅くしますか?
いいえ。学習が終われば、小さなLoRA行列を数学的に元の重みへ統合できるため、適応済みのモデルはベースモデルと同じ速度で動作し、推論時のレイテンシは増えません。
RAGではなくLoRAを使うのはどんなときですか?
モデルに異なるトーンで書かせたい、特定の形式に従わせたい、特化したタスクを処理させたいときはLoRAを使います。最新の情報や自社固有の事実を参照させたいときはretrieval-augmented generationを使います。RAGは、モデルが学習した内容ではなく、クエリ時にモデルが見る内容を更新するからです。
LoRAでモデルにまったく新しい知識を教えられますか?
効率的にはできません。LoRAは、大量の新しい事実知識の注入よりも、既存の振る舞いや文体の適応に向いています。新しい知識には、通常、retrieval-augmented generationや継続的な事前学習の方が適しています。
LoRAは言語モデルだけで使われるのですか?
いいえ。LoRAは画像モデルや拡散モデルでも広く使われており、チームはモデル全体を再学習する代わりに小さなアダプターファイルで、画像生成モデルを特定のアートスタイルや製品ラインに適応させられます。
AI用語コレクションの一部。最終更新:2026年7月

Co-Founder, Rework.com