コンテキストエンジニアリングとは?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
2026年7月更新
コンテキストエンジニアリングとは、大規模言語モデルが推論時に目にするすべての要素、システムプロンプト、検索で取得したドキュメント、ツールの出力結果、会話履歴、作業メモリを組み立て、タスクをうまく完了させるために必要な情報を過不足なく与える実践のことです。これは2025年から2026年にかけて、AI構築の中核スキルとしてプロンプトエンジニアリングに取って代わった手法です。
ビジネスリーダーにとって、コンテキストエンジニアリングは、推測するAIシステムと、実際に把握しているAIシステムとの違いを生み出すものです。 顧客の注文履歴、返金ポリシー、過去のチケットを回答前に作業コンテキストへ取り込むサポートエージェントは、巧みなプロンプトだけに頼るエージェントよりも高い確率で正しい回答にたどり着きます。プロンプトは数ある入力の一つに過ぎず、コンテキストエンジニアリングとは、最初の呼び出しだけでなく、すべての呼び出しにおいてそれらすべてを一体として管理する仕事です。
コンテキストエンジニアリングがプロンプトエンジニアリングに取って代わった理由
プロンプトエンジニアリングは、優れたAI出力を得ることを言葉選びの問題として扱ってきました。魔法のようなフレーズ、適切なペルソナ、完璧な指示構造を見つければ、モデルは期待通りに動くという考え方です。この捉え方は、ユーザーがコントロールできるものの大部分が、うまく練られた一つのプロンプトだった時代には理にかなっていました。しかしチームがAIエージェントや複数ステップのシステムを構築し始めると、プロンプトはモデルが参照すべき、はるかに大きく絶えず変化する情報群の中の、小さく固定された一部分に過ぎなくなり、この考え方は成り立たなくなりました。
「コンテキストエンジニアリング」という言葉は、2025年半ばにAI業界の著名な2人によって広まりました。Andrej Karpathy氏はこれを「次のステップに必要な情報だけをコンテキストウィンドウに詰め込む、繊細な技術と科学」と表現し、「コンテキストエンジニアリング」という言葉のほうが「プロンプトエンジニアリング」よりも、本番環境でAIチームが実際に時間を費やしている内容をはるかによく表していると主張しました。同時期、Shopify CEOのTobi Lutke氏は、これを「LLMがタスクをもっともらしく解決できるよう、すべてのコンテキストを提供する技術」と公に説明しています。
Anthropicのエンジニアリングチームは、AIエージェント構築に関する独自のガイダンスの中で、この転換を次のように位置づけています。コンテキストエンジニアリングとは、推論時における「最適なトークン群をキュレーションし維持するための戦略の集合」であり、プロンプト単体ではなく、システムプロンプト、ツール、例、メッセージ履歴、検索データをまとめて扱うものだとしています。この転換を後押ししている根底の気づきは、フロンティアモデルがすでにほとんどのビジネスタスクに対して十分な性能を持っているということです。機能するシステムと機能しないシステムの差は、多くの場合、どんな言葉で依頼したかではなく、モデルにどんな情報が与えられたかで決まります。
コンテキストエンジニアリングの主要な構成要素
コンテキストエンジニアリングが施されたシステムは、どれも同じ一握りの要素から構成されており、モデルを呼び出すたびにそれらが組み立て直されています。
- システムプロンプト: AIの役割、トーン、境界を定める常設の指示です。多くの人が「プロンプトエンジニアリング」と呼んでいるのはこの部分であり、今ではいくつもある入力の一つに過ぎません。
- メモリ: 現在のタスクのための短期的な作業メモリと、セッションをまたいで保持すべき事実・好み・成果のための長期的なメモリです。これがモデルの学習データとどう違うかについてはAIメモリをご覧ください。
- 検索拡張生成(RAG): モデルがすでに知っていることを期待するのではなく、必要になった瞬間に関連するドキュメント、レコード、ナレッジベースの項目をコンテキストに取り込む仕組みです。詳しくは検索拡張生成で解説しています。
- ツール: モデルが呼び出せる関数、API、システムのことであり、同じくらい重要なのが、それらの呼び出しが返す出力です。この出力は次のステップのコンテキストの一部になります。詳しくはツールの使用をご覧ください。
- 例: モデルに優れた出力とはどのようなものかを示す、厳選された少数の代表的な例(few-shotデモンストレーション)です。網羅性ではなく関連性を基準に選ばれます。
- ステート: 進行中の会話履歴、これまでに取られた行動、そして中間結果のことで、複数ステップにわたるエージェントが、各ターンを新規のやり直しとして扱うのではなく、最初から最後まで一貫性を保つために役立ちます。
これらのいずれか一つでも間違えると(肥大化したツールリスト、古くなったメモリ、関連性のない検索ドキュメントなど)、かつて言葉選びの悪いプロンプトが引き起こしていたのと同じくらい、出力品質は低下します。
エージェンティックシステムにおけるコンテキストエンジニアリングの仕組み
エージェンティックAIシステムでは、コンテキストは一度組み立てられてそのまま放置されるものではありません。ループのすべてのステップで再構築、または更新されます。システムは現時点で把握している情報(システムプロンプト、メモリ、検索データ)を集め、モデルはそのコンテキストを踏まえて推論し、行動を決定します。ツールの使用がその行動を実際のシステムに対して実行し、その結果は次の意思決定のためにコンテキストへ再び組み込まれます。複数ステップのエージェンティックワークフローは、タスクが完了するまでにこのループを数十回、時には数百回実行することがあり、初期の小さなコンテキストの誤りが最後には積み重なって大きくなる可能性があります。
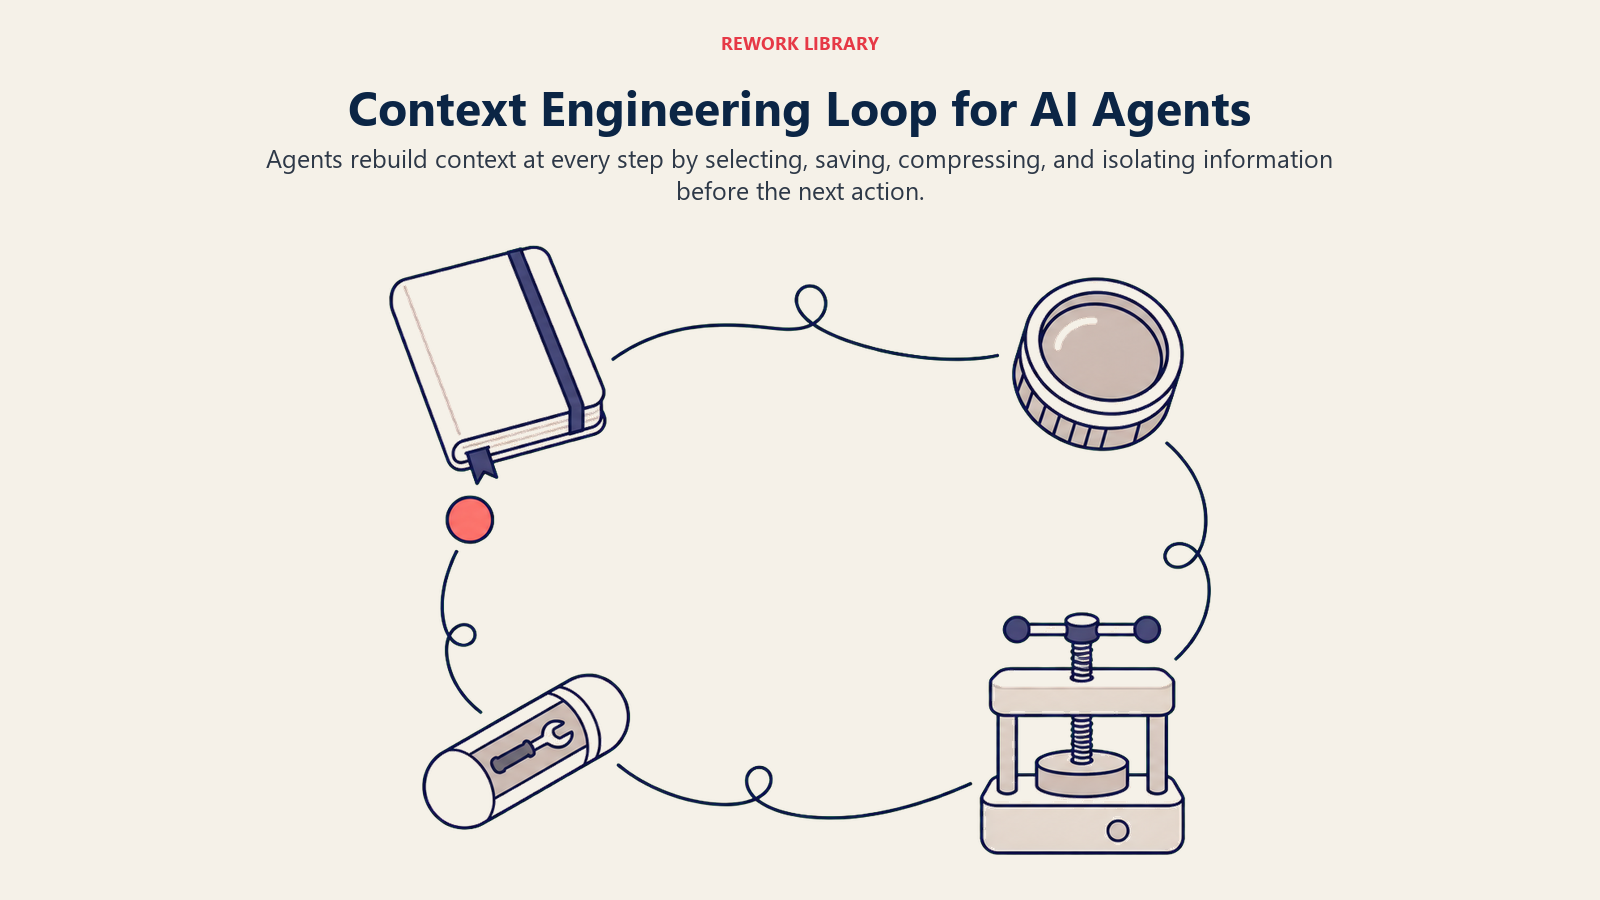
LangChainのエンジニアリングチームは、コンテキストエンジニアリングの実務を4つの繰り返し可能な戦略に整理しています。write(書く)(スクラッチパッドやメモのように、メインのコンテキストの外に情報を保存できる場所をエージェントに与える)、select(選ぶ)(利用可能なすべてのドキュメントではなく、現在のステップに関連するものだけを取り込む)、compress(圧縮する)(コンテキストが長くなったら要約または削る)、isolate(分離する)(単一のコンテキストが過負荷にならないよう、複雑なタスクを複数のエージェントやサブコンテキストに分割する)の4つです。本番環境でのコンテキストエンジニアリング作業の多くは、タスクの実行中にこの4つの動きを組み合わせ、継続的に繰り返すことで成り立っています。AIオーケストレーションは、通常、単一のエージェント上、あるいは複数のエージェントをまたいでこれを管理する層です。
コンテキストウィンドウの管理と失敗パターン
どのモデルにも有限のコンテキストウィンドウ、つまり一度に処理できる最大トークン数があります。しかしコンテキストエンジニアリングが必要とされるのは、実際にはウィンドウの容量オーバーが主な問題ではないからです。ChromaによるリサーチはGPT-4.1、Claude Opus 4、Gemini 2.5、Qwen3を含む18のフロンティアモデルを、25語から10,000語までの入力でテストしたところ、単純な検索・想起タスクの精度が、いずれのモデルも公称のトークン上限に達するはるか手前から、入力が長くなるにつれて着実に低下していくことがわかりました。この緩やかな低下には名前がついています。コンテキストロットです。これは、保持しているコンテキストの量が増えるにつれて、たとえ短い入力であれば完璧にこなせるタスクであっても、モデルが情報を正確に使いこなす能力が低下していく傾向を指します。
コンテキストロットは単一の失敗ではなく、互いに関連した複数の失敗の集まりです。ライターのDrew Breunig氏は、実務者が直面する事象のほとんどを説明する4つの具体的なパターンを整理しています。
- コンテキストポイズニング(汚染): ハルシネーションや誤りがコンテキストに書き込まれ(メモリのメモに書かれた誤った事実や、追跡中の目標に含まれる誤った思い込みなど)、その後繰り返し参照されることで、修正されるどころかミスが積み重なっていく現象です。
- コンテキストディストラクション(注意散漫): モデルが蓄積された履歴に過度に頼るようになり、次に何をすべきかを新たに推論するのではなく、過去の行動を繰り返し始める現象です。
- コンテキストコンフュージョン(混乱): コンテキスト内にある無関係な情報が回答に取り込まれてしまい、正しい情報も同時に存在しているにもかかわらず、回答の質が低下する現象です。
- コンテキストクラッシュ(衝突): 長いセッションの異なる時点で追加された情報同士が矛盾し始め、モデルにはどちらが最新のバージョンなのかを確実に判断する手段がなくなる現象です。
コンテキストポイズニングの実例としてよく知られているのが、Google DeepMind自身が手がけたGemini Plays Pokemonプロジェクトです。これはGemini 2.5 Proに『ポケットモンスター 青』を自律的にプレイさせる、ライブ配信された実験でした。あるとき、このエージェントは「TEA」というアイテム(そのバージョンのゲームには存在しない)を見つける必要があるとハルシネーションを起こし、その誤った目標を永続的なコンテキストに書き込んでしまいました。その後、チームが行き詰まりを解消できるまでの数時間、エージェントは不可能な目標を追い続けました。本番システムにおける解決策は、より大きなコンテキストウィンドウではなく、何をどれだけの期間コンテキストに残すかを積極的に管理することです。
コンテキストエンジニアリング vs プロンプトエンジニアリング
| 観点 | プロンプトエンジニアリング | コンテキストエンジニアリング |
|---|---|---|
| 中心的な問い | どんな言葉が最良の応答を引き出すか | モデルが成功するためにはどんな情報が必要か |
| 対象範囲 | 単一の指示やメッセージ | モデルの作業コンテキストにあるすべて: プロンプト、メモリ、ツール、検索データ、履歴 |
| タイミング | 一度書いたらほぼ静的なまま | 継続的にキュレーションされ、ステップごとに組み立て直される |
| 主なスキル | 文章表現と言葉選び | 情報の選択、圧縮、構造化 |
| よくある失敗 | あいまいで不明瞭な指示 | コンテキストロット(ポイズニング、ディストラクション、コンフュージョン、クラッシュ) |
| 最も適した用途 | シングルターンのチャット、単純なQ&A | 複数ステップのエージェンティックワークフロー、RAGシステム、長時間稼働するエージェント |
| 現在の位置づけ | コンテキストエンジニアリングの一部 | プロンプトエンジニアリングを含む、より広い分野 |
プロンプトエンジニアリングが消えたわけではなく、その中に吸収されたのです。明確なシステムプロンプトを書くことは今も仕事の一部ですが、それがすべてではなくなったというだけのことです。
コンテキストエンジニアリングの実際の活用事例
カスタマーサポートエージェント: 回答する前に、システムは顧客のアカウント状況、注文履歴、質問に関連する具体的な規定文書を取得し、そのコンテキストを毎ターン再取得するのではなく、会話の残りの部分でも利用できるように保持します。
コーディングエージェント: Claude Codeやそれに類するコーディングアシスタントは、リポジトリのコンテキストを直接管理します。タスクが多数のステップにわたって進行する中で、どのファイル、過去の編集内容、テスト結果をモデルの作業コンテキストに残すかを判断しています。コードベース全体を一度に含めてしまうと、どのウィンドウも超えてしまい、コンテキストロットを招くためです。
営業・RevOpsエージェント: リードの資格判定やフォローアップを行うエージェントは、モデルが持つ会社に関する一般的な知識に頼るのではなく、RAGを通じて関連するCRMレコード、過去のやり取り、アカウント詳細を取得します。
長時間稼働する自律エージェント: 多くのステップやセッションにまたがって動作するブラウザ操作エージェントやリサーチエージェントは、意図的なメモリ管理に依存しています。重要な情報を永続ストレージに保存し、不要な情報を削ることで、エージェントがこれまでに見たすべてを蓄積するのではなく、作業コンテキストを焦点の絞られた状態に保っています。
重要なポイント
- Anthropicは、コンテキストエンジニアリングを、推論中にモデルが利用できる「最適なトークン群をキュレーションし維持するための戦略の集合」と定義しており、プロンプト単体ではなく、システムプロンプト、ツール、例、メッセージ履歴にまたがるものだとしています。Anthropic Engineering
- Andrej Karpathy氏が2025年6月に投稿した、コンテキストエンジニアリングを「次のステップに必要な情報だけをコンテキストウィンドウに詰め込む、繊細な技術と科学」と表現した投稿は、この用語を広めた発端として広く知られています。X / Karpathy
- Chromaのコンテキストロットに関するリサーチは、GPT-4.1、Claude Opus 4、Gemini 2.5、Qwen3を含む18のフロンティアモデルを、25語から10,000語までの入力長でテストし、いずれのモデルも公称のコンテキスト上限に達するはるか手前から、入力が長くなるにつれて精度が一貫して低下することを明らかにしました。Chroma Research
- LangChainの2026年State of AI Agents調査によると、回答したチームの57%がすでに本番環境でエージェントを稼働させており、大規模なコンテキスト管理を含む出力品質は、信頼できる本番パフォーマンスを妨げる最大の要因として32%が挙げています。LangChain
- LangChainのエンジニアリングチームは、実務的なコンテキストエンジニアリングの作業を、write(書く)、select(選ぶ)、compress(圧縮する)、isolate(分離する)という4つの繰り返し可能な戦略を軸に整理しています。LangChain Blog
- Google DeepMindのGemini Plays Pokemonプロジェクトは、コンテキストポイズニングの記録された事例を生み出しました。ハルシネーションによって生まれたゲーム内の目標がエージェントの永続的なコンテキストに入り込み、チームが修正できるまでの数時間、プレイを迷走させました。TechCrunch
- ライターのDrew Breunig氏は、ポイズニング、ディストラクション、コンフュージョン、クラッシュという4つの異なるコンテキストの失敗パターンを整理しており、これらを合わせると、実務者がコンテキストロットと呼ぶ現象のほとんどを説明できます。dbreunig.com
コンテキストエンジニアリングに関するよくある質問
コンテキストエンジニアリングを一言で言うと何ですか?
コンテキストエンジニアリングとは、大規模言語モデルが応答する前に何の情報を目にするかを決める実践のことです。システムプロンプト、検索したドキュメント、ツールの結果、メモリ、会話履歴などを通じて、タスクをうまくこなすために必要なものを与えます。これは優れたプロンプトを書くことよりも広い概念です。
コンテキストエンジニアリングはプロンプトエンジニアリングとどう違いますか?
プロンプトエンジニアリングは、単一の指示の言葉選びに焦点を当てます。コンテキストエンジニアリングは、モデルが各ステップで目にするすべて、つまりプロンプトに加えてメモリ、検索データ、ツールの出力、履歴を管理し、一度書いたら終わりではなく継続的にキュレーションします。
コンテキストエンジニアリングの主な構成要素は何ですか?
システムプロンプト、短期・長期のメモリ、関連知識を取り込むための検索拡張生成(RAG)、ツールとその出力、厳選された例、そして進行中の会話のステートです。
コンテキストロットとは何ですか?
コンテキストロットとは、モデルの公称のコンテキストウィンドウ上限にはるかに達する前から、コンテキスト内の情報量が増えるにつれてモデルの精度と想起力が低下していく傾向のことです。明確な打ち切りラインがあるわけではなく、緩やかに低下していきます。
コンテキストポイズニングとは何ですか?
コンテキストポイズニングとは、ハルシネーションや誤りが、メモリのメモや追跡中の目標といったシステムの永続的なコンテキストに書き込まれ、その後も参照され続けることで、元の間違いが修正されるどころか積み重なっていく現象です。
「コンテキストエンジニアリング」という言葉を最初に使ったのは誰ですか?
この言葉は2025年半ば、Andrej Karpathy氏とShopify CEOのTobi Lutke氏の投稿をきっかけに広く採用されるようになり、Anthropicを含むAIラボや、LangChainのようなフレームワークが、自社のエンジニアリングガイダンスの中ですぐに取り入れました。
コンテキストエンジニアリングはプロンプトエンジニアリングを完全に置き換えるのですか?
いいえ。明確で構造化されたプロンプトを書くことは今も仕事の一部ですが、それがすべてなのではなく、より大きなコンテキストエンジニアリングという分野の中の一要素に過ぎません。
コンテキストエンジニアリングはRAGとどのように関係していますか?
検索拡張生成は、コンテキストエンジニアがよく使う主要な手段の一つです。モデルがすでに何かを知っていることを期待するのではなく、RAGは必要になった瞬間に関連するドキュメントやレコードを取得し、コンテキストに追加します。
コンテキストエンジニアリングを実践するための良い最初のステップは何ですか?
プロンプトの言葉選びが問題だと決めつける前に、実際の本番呼び出しにおいてシステムのコンテキストに何が含まれているか、プロンプト、検索データ、ツールの出力、履歴を監査し、古くなっているもの、無関係なもの、欠けているものを確認してください。
関連するAIコンセプト
- エージェンティックAIとは? - 信頼性高く動作するために、よく設計されたコンテキストに依存する自律システム
- コンテキストウィンドウ - コンテキストエンジニアリングが対応しなければならないトークン上限
- プロンプトエンジニアリング - コンテキストエンジニアリングが吸収し、発展させた、より狭い分野
- 大規模言語モデル - 組み立てられたコンテキストを消費するシステム
- 検索拡張生成 - 外部の知識をコンテキストに取り込む主要な手法
- AIメモリ - コンテキストエンジニアリングの構成要素としての短期・長期メモリ
- ツールの使用 - ツールの出力がエージェントの進行中のコンテキストの一部になる仕組み
- モデルコンテキストプロトコル - 外部のツールやデータをモデルのコンテキストへ一貫した形で取り込むためのオープンな標準規格
- エージェンティックワークフロー - 多数のステップにわたってコンテキストの一貫性を保つ必要がある、複数ステップのプロセス
- AIオーケストレーション - 複数のエージェントやステップにまたがってコンテキストを管理する調整レイヤー
外部リソース
- Anthropic: AIエージェントのための効果的なコンテキストエンジニアリング - エージェントの信頼性のためにコンテキストをキュレーションするAnthropic独自のガイダンス
- LangChain: エージェントのためのコンテキストエンジニアリング - write、select、compress、isolateのフレームワーク
- LangChain: State of AI Agents 2026 - 本番環境でのエージェント導入と品質面の障壁に関する調査データ
- Chroma Research: コンテキストロット - 18のフロンティアモデルにおける性能低下に関するベンチマークデータ
- Drew Breunig: 長いコンテキストが失敗する理由 - 名前のついた4つのコンテキスト失敗パターン
- TechCrunch: GoogleのGeminiがポケモンプレイ中にパニックに陥った - コンテキストポイズニングの記録された実例
AI用語集コレクションの一部です。最終更新日: 2026-07-16
