Agentic RAGとは?定義、アーキテクチャ、従来のRAGとの違い
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Agentic RAGとは、固定されたパイプラインではなくAIエージェントが制御するretrieval-augmented generationです。1回の検索で回答を生成するのではなく、エージェントがいつ検索するか、どの情報源に問い合わせるか、得られた根拠が十分か、回答前に再検索すべきかを判断します。
検索に関する判断をスクリプトではなく推論システムに任せるというこの1点の変化こそが、Agentic RAGがより難しい企業の課題で活躍する理由です。たとえば、複数ドキュメントにまたがる調査、複数のポリシーに同時に関わるコンプライアンスの問い合わせ、あるシステムを確認してから別のシステムと突き合わせる必要があるサポートチケットなどです。
Agentic RAGと従来のRAG:何が実際に変わるのか
標準的なRetrieval-Augmented Generationは、決まった順序で動きます。質問をベクトルに変換し、1つのナレッジベースから一致度の高いチャンクを取り出し、モデルに渡して回答を生成します。高速で予測しやすい反面、質問が1回の検索で済まなくなった途端に脆くなります。
Agentic RAGは、同じ検索の仕組みを推論ループで包み込みます。パイプラインの手前にAIエージェントが置かれ、静的なパイプラインにはできない3つの判断を行います。
- いつ検索するか。 すべての質問に検索が必要なわけではありません。単純な確認の質問なら不要な場合もあれば、複数の要素からなる質問では、最初の1回だけでなく各ステップで検索が必要になる場合もあります。
- 何を、どこから検索するか。 エージェントは、ベクトルデータベース、SQLテーブル、API、Web検索の中から選べます。1つのナレッジベースでは質問全体に答えられない場合は、複数の情報源に問い合わせることもできます。
- 回答として十分か。 検索後、エージェントは根拠を評価します。根拠が乏しい、矛盾している、または的外れな場合、不確かな根拠から弱い回答を生成するのではなく、クエリを練り直してもう一度検索します。
3つ目の判断である自己修正は、多くのチームが最初に実感する実用上の違いです。従来のRAGでは、最初の検索が不適切だと、その結果をもとに自信満々の誤った回答を生成してしまいます。Agentic RAGなら、検索が弱かったことに気づき、別のクエリや別の情報源を試したり、質問をより小さな単位に分解したりしてから、最終回答を生成できます。
Agentic RAGのアーキテクチャ
ベンダーごとのブランド名を取り払うと、Agentic RAGシステムには共通の構成要素があります。その多くは標準的なRAGでおなじみのもので、その上に推論レイヤーが加わります。
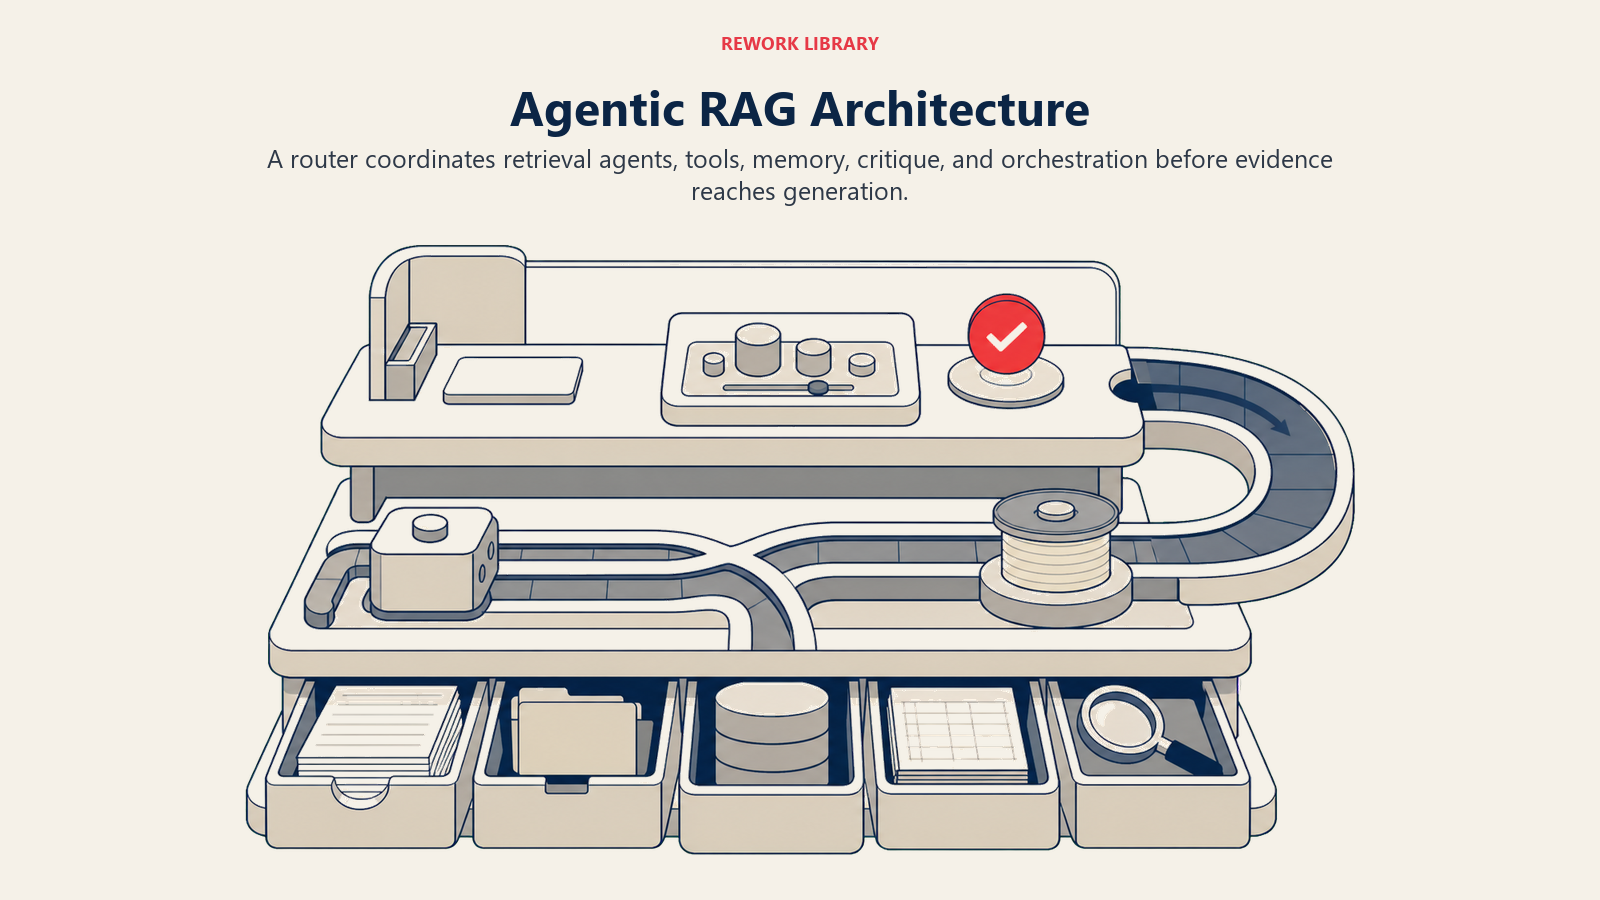
- クエリルーター: 最初の判断ポイントです。受け取った質問を分類し、そもそも検索が必要か、どの情報源に問い合わせるか、先に質問をサブクエスチョンに分解すべきかを判断します。従来のRAGには存在しない要素です。
- 検索エージェント: それぞれが1つのナレッジソースを担当する専門のサブエージェントです。たとえば、製品ドキュメントのベクトルストア、CRMレコードの検索、ライブのWeb検索、構造化データベースへのクエリなどがあります。ルーターは質問に応じて、1つまたは複数を呼び出せます。
- ツール: テキスト検索以外にシステムが呼び出せるものすべてです。数値の質問には電卓、構造化データにはSQLエンジン、最新の出来事にはWeb検索APIなどがあります。エージェント型システム全般でのしくみについては、ツール使用をご覧ください。
- メモリ: ワーキングメモリは、現在の質問と、このセッションでこれまでに取得したすべての情報を保持します。長期メモリは多くの場合ベクトルデータベースに支えられており、過去の検索結果を再利用したり、類似の質問で何がうまくいったかを記憶したりできます。詳しい内訳はAIメモリをご覧ください。
- 批評と自己修正のループ: 各検索の後、レビューのステップ(同じモデルの場合も、別のモデルの場合もあります)が、取得した根拠が本当に回答を裏付けているかを確認します。裏付けがなければ、クエリを練り直して再度検索します。無限ループにならないよう、回数の上限が設定されています。
- オーケストレーションレイヤー: 全体の流れを調整します。どのタイミングで検索エージェント間を引き継ぐか、いつ検索をやめて生成に移るか、いつ人間にエスカレーションするかを管理します。これは一般的なAIオーケストレーションやエージェント型ワークフローと大きく重なります。
各検索ステップの中核では、引き続きセマンティック検索とembeddingsが主役を担います。Agentic RAGはこの仕組みを置き換えるのではなく、いつ、どのように使うかを決めるものです。
Agentic RAGと標準RAGの比較
| 項目 | 標準RAG | Agentic RAG |
|---|---|---|
| 検索のトリガー | すべてのクエリで必ず1回実行 | エージェントが、検索するか、いつ、何回行うかを判断 |
| 情報源の選択 | 固定。通常は1つのナレッジベース | エージェントが複数の情報源から選択、または複数に問い合わせ |
| 複数ステップの質問 | 苦手。質問を1回の検索として扱う | 質問をサブクエスチョンに分解し、それぞれで検索 |
| 自己修正 | なし。取得した内容からそのまま生成 | 根拠の質を評価し、弱ければ再検索 |
| ツール使用 | 通常はベクトル検索以外なし | 電卓、SQLエンジン、API、Web検索を呼び出し可能 |
| レイテンシとコスト | 低い。検索は1回のみ | 高い。複数回の検索と推論 |
| 失敗のしかた | 不適切な根拠から自信満々の誤答 | 遅くなるが、不適切な最初の検索を指摘・修正できる可能性が高い |
| 最適な用途 | 範囲の明確な単一ドキュメント群に対する単純なQ&A | マルチホップの調査、システム横断の質問、コンプライアンスチェック |
実務上のポイントは次のとおりです。標準RAGは、速度とコストがエッジケースへの対応より重要な、範囲の狭い検索のデフォルトとして適切です。Agentic RAGは、1回の検索では足りない質問や、根拠のセカンドオピニオンが必要な質問でこそ、追加のレイテンシとコストに見合う価値を発揮します。
2026年の企業におけるAgentic RAGの実際の活用例
金融リサーチ: アナリストは、複数の開示資料、決算説明会、市場データフィードにまたがる質問をします。Agentic RAGシステムは各情報源を確認し、数値を突き合わせ、2つの情報源が食い違う場合は、黙ってどちらかを選ぶのではなく指摘します。
法務・コンプライアンスのレビュー: 「この契約条項は現行のデータ処理ポリシーと矛盾しないか」といった1つのコンプライアンス上の質問でも、契約書、ポリシー文書、場合によっては規制の参照先を互いに照合する必要があります。Agentic RAGは3つすべてから検索し、回答前に整合性を検証します。
カスタマーサポートのエスカレーション: サポートシステムは、まず製品ドキュメントへ質問を回し、それで十分に答えられなければアカウント固有のデータへ、どちらでも確信を持って解決できなければ人間へと回します。この分岐ロジックこそ、クエリルーターと自己修正ループが想定している使い方です。
技術・エンジニアリング検索: 開発者は、コードベース、社内ドキュメント、過去のインシデントレポートにまたがる質問をします。Agentic RAGは3つすべてに問い合わせて内容を突き合わせられるため、単一のベクトル検索でたまたま上位に出た情報源だけが返されることはありません。
営業・アカウントリサーチ: 営業担当者は、見込み顧客の全体像(CRMの履歴、最新ニュース、企業属性データ)を求めます。Agentic RAGシステムは、その特定のアカウントに関連する情報源を判断し、付加価値のないものは省きます。
メリットと限界
このアーキテクチャは、適切な根拠を見つけて検証できる可能性の向上と引き換えに、実行時の可動部分が増えるというトレードオフを伴います。
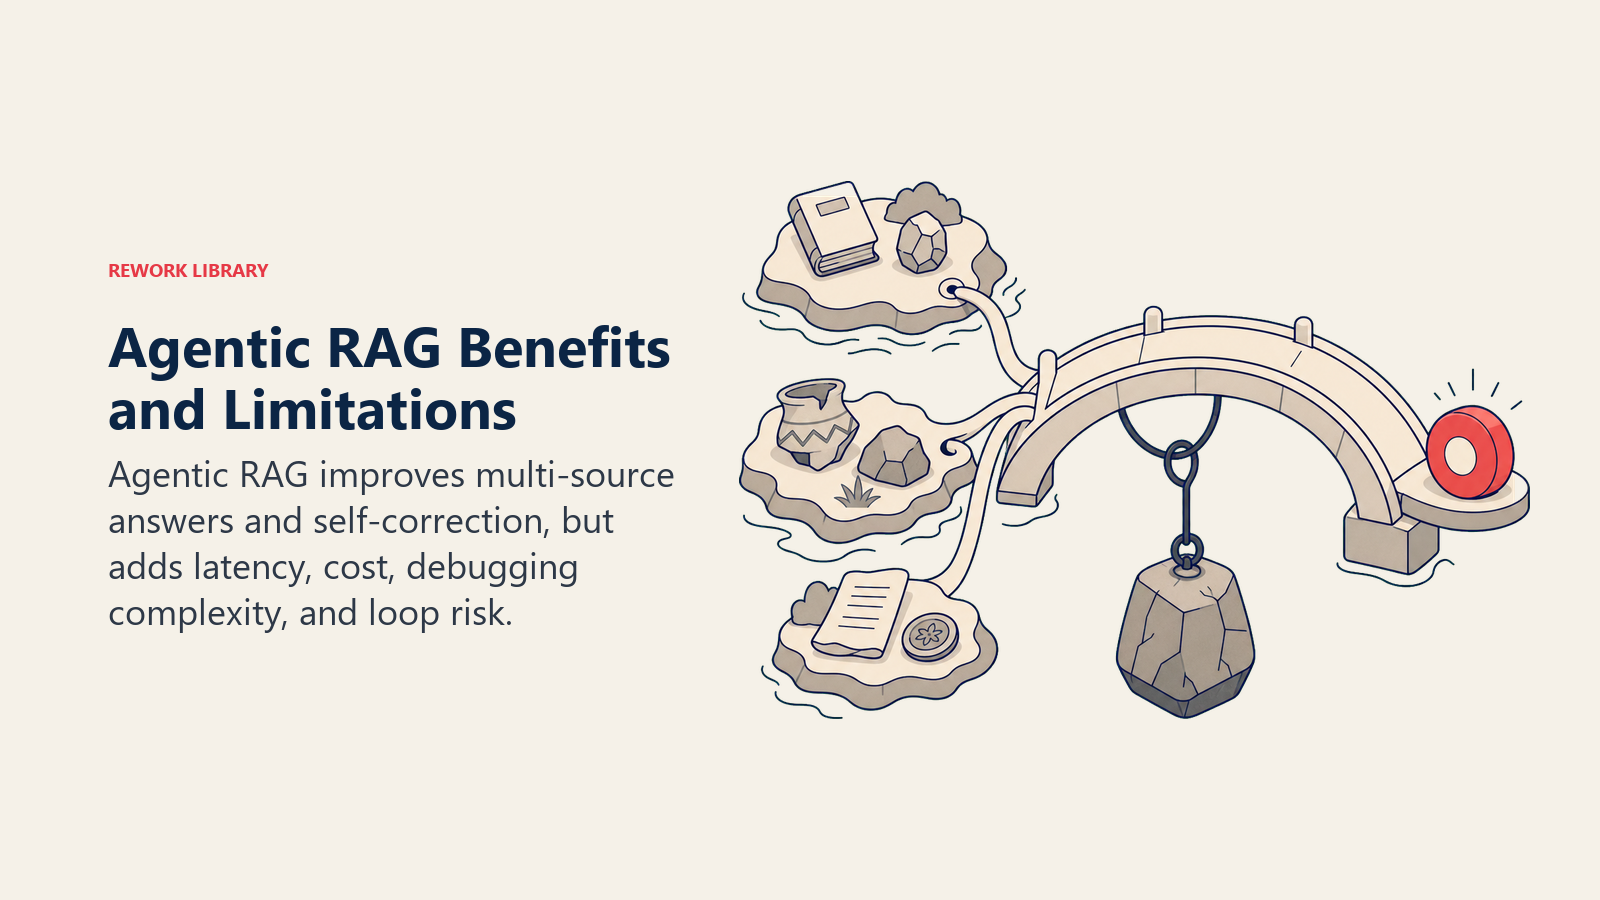
メリット:
- 複数の情報源にまたがる根拠が必要なマルチホップの質問に対応できます。標準RAGでは、部分的な回答や誤った回答しか返せません
- 弱い、あるいは矛盾した検索結果が自信満々の誤答になる前に検出でき、ハルシネーションのリスクを低減します
- 常に同じ固定のナレッジベースを参照するのではなく、質問ごとに問い合わせ先を適応させます
- ナレッジソースが増えても自然にスケールします。ルーターに選択肢が1つ増えるだけで、パイプラインを作り直す必要はありません
限界:
- レイテンシとコスト: 複数回の検索と推論を行うため、1回で済むRAGの検索よりもクエリあたりの時間とコストが増えます。すべてのユースケースがこれを許容できるわけではありません。
- デバッグが難しい: 静的なRAGの回答が誤っている場合、修正はたいてい1つの不適切なチャンクで済みます。Agentic RAGの回答が誤っている場合、原因はルーター、検索、批評ステップ、最終生成のいずれにもあり得るため、追跡にはより多くの計測が必要です。
- 検索ループの暴走: 検索回数に厳格な上限がないと、本当に答えようのない質問に対して、根拠が足りないと示すことなく自己修正ループが再クエリを繰り返し続けることがあります。
- 情報源の品質への依存: 1つではなく3つの質の低い情報源に問い合わせても、返ってくるのは質の低い回答です。Agentic RAGが改善するのは検索に関する判断のしかたであり、基盤となるデータ品質ではありません。
- 単純な検索には過剰: 整ったドキュメント群に対する単一事実の質問には、ルーターも批評ループもマルチソースのオーケストレーションも不要です。その場合は標準RAGの方が適しています。
特にコンプライアンスや法務のように、誤った回答が現実の結果を招くユースケースでは、Human-in-the-loopのチェックポイントが、重要度の高いAgentic RAG導入における主要な安全策であり続けます。
重要な事実
- generative AIを利用する企業の**70%**が、既製の言語モデルだけに頼るのではなく、ツール、検索システム、ベクトルデータベースを組み合わせています。Databricks
- ベクトルデータベースの導入は前年比**377%**成長し、追跡対象のLLM関連技術のなかで最も成長の速いカテゴリとなりました。Databricks
- 企業は単一のチャットボットから、連携して動くマルチエージェントシステムへと移行し、その数は4か月足らずで**327%**増加しました。Databricks
- 正式なAIガバナンスを整備している企業は、そうでない企業と比べて12倍以上のAIプロジェクトを本番稼働させています。Databricks
- 計画、実行、フィードバックの観察、適応を行う真のエージェントに該当する企業のAI導入は、わずか16%(スタートアップでは27%)にとどまり、大半は依然として固定シーケンスまたはルーティング型のワークフローです。Menlo Ventures
- 2026年末までに、企業アプリケーションの**40%**がタスク特化型のAIエージェントを搭載する見込みです(2025年は5%未満)。Gartner
- エージェント型AIプロジェクトの40%超が、コストの増大、不明確なビジネス価値、不十分なリスク管理を理由に2027年末までに中止される見込みです。これは、野心的なAgentic RAGの展開をつまずかせるのと同じ、規律の欠如によるものです。Gartner
Agentic RAGに関するよくある質問
Agentic RAGとは、簡単に言うと何ですか?
Agentic RAGは、固定されたスクリプトではなくAIエージェントが、いつ検索するか、どの情報源を検索するか、得られた根拠が回答前に十分かを判断するretrieval-augmented generationです。最初の検索で不十分だった場合、エージェントは弱い根拠から生成するのではなく、もう一度試みます。
Agentic RAGは従来のRAGとどう違いますか?
従来のRAGは、クエリごとに単一のナレッジベースに対して1回だけ検索を行い、取得した根拠の質にかかわらず回答を生成します。Agentic RAGは、複数の情報源に問い合わせ、質問をサブクエスチョンに分解し、返ってきた根拠を評価し、必要に応じて再検索できます。
Agentic RAGは複数のナレッジソースを使いますか?
はい、それが中核的な強みの1つです。クエリルーターが質問の各部分を、ドキュメントストア、データベース、ライブAPIなど異なる情報源に振り分け、返ってきた内容を統合できます。標準RAGのように1つの固定されたナレッジベースに縛られることはありません。
Agentic RAGにおける自己修正とは何ですか?
回答を生成する前に、取得した根拠が本当に回答を裏付けているかをシステムが確認するステップです。根拠が乏しい、または矛盾している場合、エージェントは弱い情報で答えるのではなく、クエリを練り直して再度検索します。
Agentic RAGは標準RAGより遅く、コストも高いですか?
一般的にはそのとおりです。複数回の検索と推論を行うため、1回で済む検索よりもクエリあたりの時間とコストがかかります。このトレードオフは、マルチホップや重要度の高い質問では見合いますが、単純な単一事実の検索ではたいてい見合いません。
Agentic RAGはどのようなビジネス課題に最も適していますか?
複数の情報源からの根拠が必要な質問です。たとえば、複数の開示資料にまたがる金融リサーチ、複数のポリシーを照合するコンプライアンスチェック、製品ドキュメントとアカウントデータを併せて確認する必要があるサポートチケット、コードベースとそのドキュメントにまたがる技術検索などです。
Agentic RAGの主なリスクは何ですか?
本当に答えようのない質問での検索ループの暴走、誤った回答の原因がルーター、検索、批評ステップのいずれにもあり得るためデバッグが難しいこと、そしてより多くの情報源に問い合わせても、もとの情報源データの問題は解決されないことです。
Agentic RAGは必要ですか、それとも標準RAGで十分ですか?
質問が限定的で、範囲の明確な1つのドキュメント群から答えられるなら、標準RAGの方が高速で、低コストで、保守も簡単です。回答を信頼できるまでに、複数回の検索や複数の情報源との照合が日常的に必要な質問が多い場合に、Agentic RAGを選んでください。
関連するAIの概念
- Retrieval-Augmented Generation - Agentic RAGが土台とする、検索と生成の基盤
- Agentic AIとは? - Agentic RAGが一つの応用例である、より広範な自律的・目標指向のアプローチ
- AIエージェント - Agentic RAGで検索に関する判断を行う自律システム
- エージェント型ワークフロー - 複数ステップのエージェントプロセスをエンドツーエンドで調整する方法
- AIオーケストレーション - 複数の検索エージェントとツールを順に連携させる調整
- ベクトルデータベース - 多くの検索エージェントが問い合わせる保存レイヤー
- AIメモリ - Agentic RAGシステムが検索ラウンドをまたいでコンテキストを追跡する方法
- AIハルシネーション - Agentic RAGの自己修正ループが検出するために作られた失敗モード
外部リソース
- Databricks: State of AI Enterprise Adoption and Growth Trends - RAGとベクトルデータベースの導入データ
- Databricks: 2026 State of AI Agents - マルチエージェントシステムの成長と、ガバナンスが本番導入に与える影響
- Menlo Ventures: 2025 State of Generative AI in the Enterprise - 企業とスタートアップにおける真のエージェント導入率
- Gartner: 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026 - 企業におけるエージェント導入の予測
- Gartner: Agentic AI Project Cancellations - エージェント型導入のリスクとガバナンスの背景
AI用語コレクションの一部。最終更新:2026-07-16

Co-Founder, Rework.com