テストタイム計算(Test-Time Compute)とは?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
2026年7月更新
テストタイム計算(推論時計算とも呼ばれます)とは、モデルが学習時に組み込まれた知識だけに頼るのではなく、クエリを受け取った後に問題を推論するために追加で費やす計算量のことです。モデルは即座に回答するのではなく、中間的な推論ステップを生成し、複数のアプローチを試し、自らの作業を検証します。こうして1つのクエリあたりの計算量を増やすことで、難易度の高い問題の精度を高めます。
Large Language Modelsの歴史のほとんどにおいて、より賢い回答を得るということは、より大きなモデルを学習させることを意味していました。テストタイム計算はこの前提を覆しました。今では、学習済みのパラメータを1つも変更することなく、特定の質問に対してより多くの時間と計算量を与えるだけで、モデルを測定可能なレベルで賢くすることができます。
より大きなモデルから、より長く考えることへ
長年にわたり、AIの進歩は単純なパターンをたどってきました。パラメータを増やし、学習データを増やし、学習時の計算量を増やせば、モデルは良くなるというものです。これはトレーニングタイムスケーリングと呼ばれ、初期のGPTモデルから2020年代半ばのフロンティアモデルのリリースに至るまで、この分野を定義してきました。あらゆる向上は、より大規模で高コストな学習実行から生まれ、その結果として得られたモデルは、質問の難易度にかかわらず、ほぼ同じ時間であらゆるクエリに回答していました。
2024年9月にリリースされたOpenAIのo1は、このパターンを覆しました。o1はモデル自体をスケールする代わりに、回答する前にモデルが「考える」ことを許される時間の長さをスケールし、最終的な回答を確定する前にモデルが取り組む内部的な推論の連鎖を生成しました。この結果は、思考時間がモデルサイズとは別の、独自のレバーであることを明らかにしました。
Stanford AI Index 2025 reportによると、o1は国際数学オリンピック予選試験で74.4%のスコアを記録し、同じ問題に対するGPT-4oの9.3%を大きく上回りました。トレードオフも確かに存在します。レポートによれば、o1はGPT-4oよりもコストが約6倍高く、速度は30倍遅いとされています。このトレードオフ、つまりより多くのコストと時間と引き換えに精度を高めるという考え方こそが、テストタイム計算の前提そのものです。
「長く考える」ことが実際に回答を改善する仕組み
標準的なLarge Language Modelは、単一のフォワードパスでトークンごとに応答を生成し、回答が完成する前に立ち止まったり、考え直したり、自らのロジックを検証したりする仕組みを持ちません。だからこそ、誤った回答であっても正しい回答と同じ流暢な自信を持って述べてしまうのです。
テストタイム計算のために構築されたReasoning Modelsは、標準的なモデルがデフォルトでは行わない3つの要素を追加します。
拡張された推論トレース。 モデルは、最終的な回答を出す前に、サブ問題に取り組み、制約を確認し、自らのロジックを語りながら、内部で長い一連の中間ステップを生成します。これはChain-of-Thought推論の仕組みを拡張したもので、多くの場合ユーザーには見えないところで実行されます。
サンプリングと選択。 モデルは1つの回答を生成する代わりに、複数の候補解を生成し、多数決(最も多くの候補が一致する回答)、あるいは正解の可能性によって候補をランク付けする学習済みスコアリング関数のいずれかを用いて、最も良いものを選ぶことができます。
自己検証。 モデルは問題の制約に照らして自らの推論を確認し、あるステップが成立しない場合には別のアプローチを試すために後戻りすることができます。これは、人が提出前に自分の作業を二重チェックする様子に近いものです。
OpenAI自身による2024年のAIME数学試験の結果は、これらのレバーそれぞれがどれほどの価値を持つかを示しています。OpenAIのo1に関するリリースノートによると、同一の基盤モデルを用いた場合、1問あたり1サンプルでは平均74%の精度、64サンプルの多数決を使うと83%まで上昇し、1,000サンプルを学習済みスコアリング関数で再ランク付けすると93%に達しました。テストタイム推論を行わないGPT-4oは、同じ問題のうちわずか12%しか解けませんでした。この3つのスコアの間で、モデルのパラメータは何一つ変わっていません。変わったのは、テストタイム計算の量だけです。
新しいスケーリング則
2024年より前、AIにおける「スケーリング則」とは1つのことを意味していました。すなわち、学習時の計算量、モデルパラメータ、学習データの関数としての性能です。テストタイム計算は、そこに第2の軸を加えました。UCバークレーとGoogle DeepMindの研究者による2024年の論文Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parametersは、これを定式化しました。すべてのクエリに一律の計算量を費やすのではなく、個々のプロンプトの難易度に推論の労力を合わせる「計算最適」な方法でテストタイム計算を配分することで、単純なbest-of-Nサンプリングのベースラインと比較して効率が4倍以上向上したのです。FLOPS(浮動小数点演算数)を揃えた比較において、この論文はテストタイム計算によって、より小さなモデルが14倍大きなモデルを上回る性能を発揮できることを明らかにしました。
この発見は、フロンティアラボにとって、そしてその先でモデルを購入する企業にとっての「自社開発か購入か」という問いの前提を組み替えます。固定の計算予算に直面するラボには、今や2つの使い道があります。将来のすべての回答をわずかに改善する、より大規模で高コストな学習実行を行うか、あるいは既存モデルが必要な特定のクエリに対してより多くの計算量を費やせるような推論システムを構築するかです。
このトレードオフは規模が大きくなっても消えることはなく、むしろより顕著になります。ARC-AGI-Pubベンチマークで評価されたOpenAIのo3モデルは、この曲線をそのまま示しています。高効率設定ではセミプライベート評価で1タスクあたり26ドルのコストで75.7%のスコアを記録した一方、約172倍多くの計算量を使う低効率設定では、1タスクあたり4,560ドルで87.5%のスコアを記録しました。わずか12ポイントの精度向上のために、170倍以上の計算量が必要だったのです。これがテストタイムスケーリングの実際の姿です。実質的な向上は得られますが、1ポイントを追加するごとに価格が急激に上昇していきます。
テストタイム計算 vs. トレーニングタイム計算
| 項目 | トレーニングタイム計算 | テストタイム計算 |
|---|---|---|
| 発生タイミング | モデル開発中、デプロイ前に1度だけ | 本番環境でモデルがクエリに回答するたびに毎回 |
| 変化するもの | モデルのパラメータ(重み) | モデル自体は変わらず、1つのクエリに費やされる推論の労力だけが変わる |
| コストの形態 | 大規模で前払い的な、プロジェクト型の支出 | クエリ単位、利用量ベースで、ボリュームと質問がどれだけ「難しい」と扱われるかに応じてスケールする |
| 得られるもの | 将来のあらゆるクエリに対して、全般的により高性能なモデル | その特定のクエリに対するより良い回答。ただしそのクエリのみレイテンシとコストが高くなる |
| 主なレバー | より多くのパラメータ、より多くの学習データ、より長い学習実行 | より長い推論チェーン、より多くのサンプリング候補、自己検証パス |
| 過剰投資時の失敗モード | レシピが誤っていた場合、コストが高いのに平凡な性能のままのモデル | 深い推論を必要としなかった質問に対する、遅くコストの高い回答 |
どちらの軸も、技術的な意味では依然としてスケーリング則です。つまり、性能は費やした計算量のおおよそ予測可能な関数として向上します。違いは、いつ支払い、それによって何を得るかという点です。トレーニングタイム計算はモデル自体への1回限りの投資です。一方、テストタイム計算は、企業、あるいはモデルを呼び出すアプリケーションが毎回下さなければならない、クエリ単位の意思決定です。
コストとレイテンシのトレードオフ
テストタイム計算は無料ではなく、その代償はお金と時間という2つの形で同時に現れます。
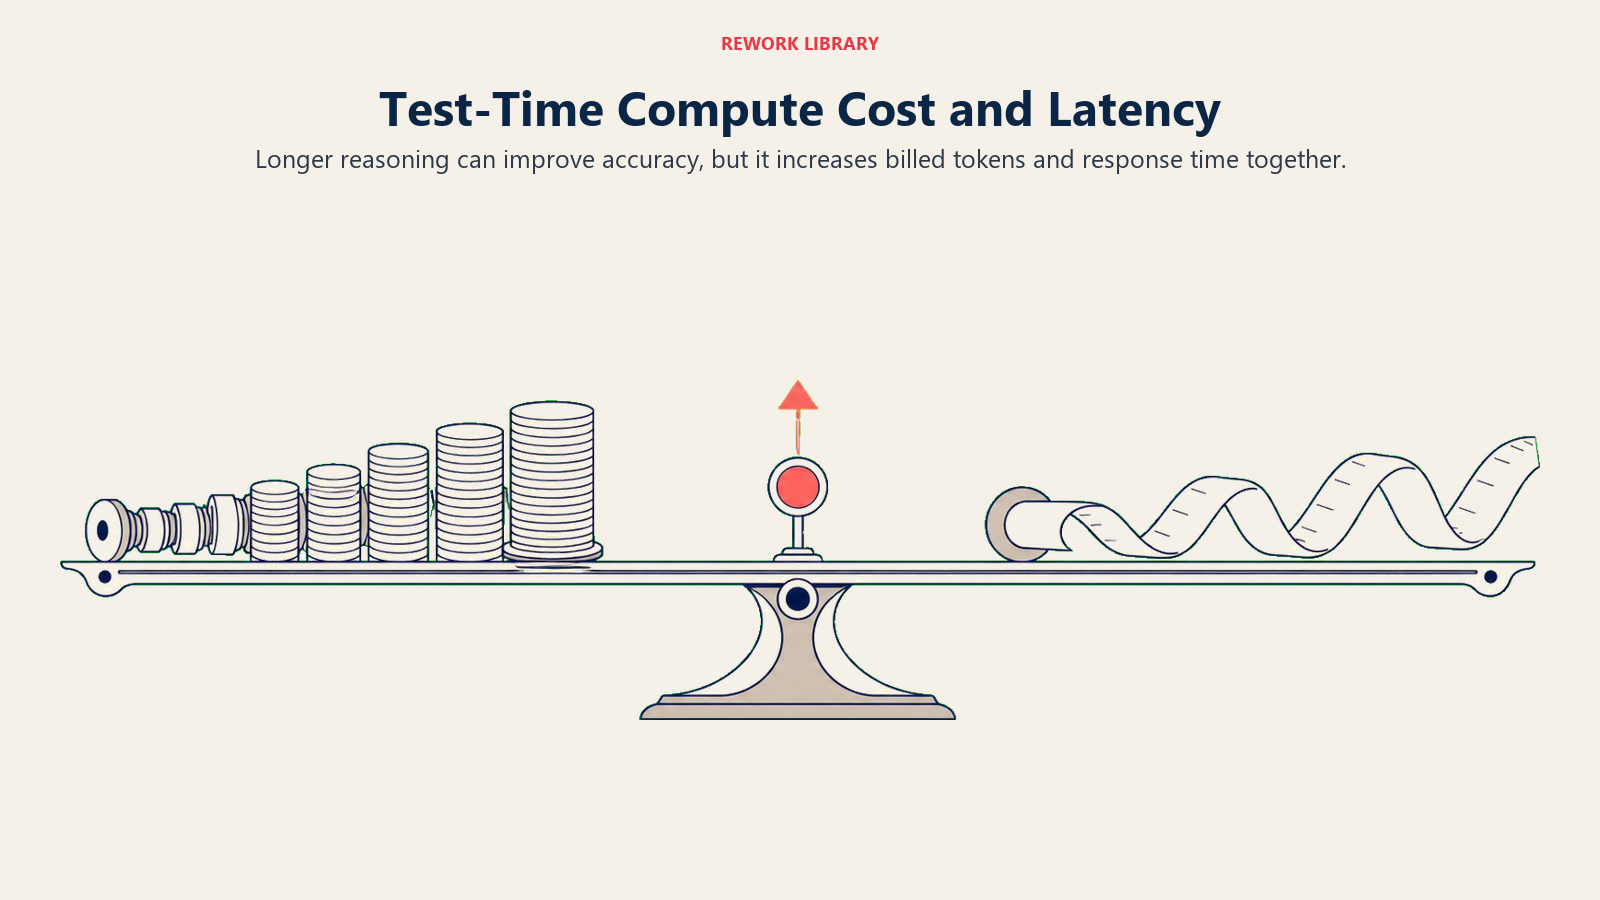
レイテンシ。 標準的なモデルは数分の1秒から数秒で応答します。一方、拡張された思考の連鎖に取り組むReasoning Modelは、目に見える回答を生成する前にどれだけ内部推論を生成するかによって、数秒から数分かかることもあります。インタラクティブなユースケースでは、この差がすべてを左右します。サポート担当者が回答を2秒ではなく20秒待たされるとしたら、回避策を見つけるか、そのツールを使うのをやめてしまうでしょう。応答時間が機能の実際の定着をどう左右するかについては、AIレイテンシを参照してください。
コスト。 推論トークンも無料ではなく、そのほとんどはユーザーの目に見えません。Artificial Analysisによると、OpenAIのo3は入力トークン100万件あたり2.00ドル、出力トークン100万件あたり8.00ドルの価格設定になっており、モデルの「思考」プロセス中に生成される内部推論トークンは、ユーザーには決して見えないにもかかわらず出力トークンとして課金されます。短い、目に見える回答の裏に、はるかに大きな課金対象の推論トレースが隠れていることがあります。これは、目に見えるトークン数がほぼ支払うトークン数に一致する標準的なモデルとは、構造的に異なるコストプロファイルです。
実務上の結果として、テストタイム計算は「モデルがこれについてどれだけ深く考えるべきか」という問いを、品質だけでなくコスト管理の意思決定にも変えます。推論の長さに上限を設ける、簡単なクエリは高速なモデルに振り分けて難しいものだけをReasoning Modelにエスカレーションする、繰り返されるクエリをキャッシュするといったInference Optimizationの手法は、クエリの相当な割合が変動する、時には多額になる推論トークンの請求を伴うようになった時点で、その価値がより一層高まります。
ビジネスへの影響:Reasoning Modelの価格が見合う場面
すべてのAI機能がテストタイム計算を必要とするわけではなく、すべてのクエリをそうであるかのように扱うことは、有望なパイロットプロジェクトを高コストなものに変えてしまう最も早い方法です。この判断は、かなり単純な問いに行き着きます。誤った回答のコストと、遅い、あるいは高コストな回答のコストを比べると、どちらが高くつくのかということです。
標準的で高速なモデルを使うべき場面: タスクの量が多く、回答が明らかに正しいか簡単に確認でき、待っている人にとって速度が重要な場合です。顧客向けFAQの回答、基本的な分類、コンテンツの初稿生成、定型的なデータ抽出は、いずれもこのパターンに当てはまります。これらすべてをReasoning Modelに通すことは、タスクが必要としていなかった精度のために予算を浪費することになります。
テストタイム計算を取っておくべき場面: 事後に誤りを発見するとコストが高くつく多段階の分析、モデルが複数の選択肢を検討することで利益を得られる解決策の幅が広いタスク、そして財務モデリング、契約分析、技術的なデバッグのように、人が独自に再検証することなく出力に基づいて行動するワークフローです。これらは、Stanford AI Indexが指摘する「コストが約6倍、速度が30倍遅い」というトレードオフを支払う価値があるケースです。
AI関連の取り組みを推進するリーダーにとっての予算上の意味合いは次の通りです。Reasoning Model機能の1クエリあたりのコストは、標準的なモデルでよくあったような固定の数字ではありません。モデル自体がどれだけ推論する必要があるかを判断するため、コストは個々のクエリの難易度によって変動します。そのため、利用状況の監視やルーティングロジック(深い推論を必要とするクエリだけを高コストなモデルに送ること)は、請求が届いてから考える後付けの対応ではなく、初日から組み込んでおくべきコスト管理計画の一部となります。複数のモデル呼び出しを連鎖させるAI Agentsは、多段階のエージェントワークフローが1つのタスクの中で何度もテストタイム推論を呼び出す可能性があるため、この問題をさらに複雑にします。
重要なポイント
- Stanford AI Index 2025 reportによると、OpenAIのo1は国際数学オリンピック予選試験で74.4%のスコアを記録し、GPT-4oの9.3%を上回りましたが、o1はGPT-4oよりコストが約6倍高く、速度は30倍遅いとされています。
- OpenAIの公式o1リリースノートによると、2024年のAIME数学試験において、o1は1問あたり1サンプルで平均74%、64サンプルの多数決で83%、1,000サンプルの再ランク付けで93%の精度を記録しました。同じ問題に対するGPT-4oの精度は12%でした。
- バークレーとDeepMindの論文Scaling LLM Test-Time Compute Optimallyによると、計算最適なテストタイムスケーリング戦略は、単純なbest-of-Nベースラインと比較して効率を4倍以上向上させることができ、FLOPSを揃えた比較では、テストタイム計算によってより小さなモデルが14倍大きなモデルを上回る性能を発揮しました。
- ARC Prizeの公式結果によると、ARC-AGI-PubベンチマークにおいてOpenAIのo3の高効率設定は1タスクあたり26ドルで75.7%のスコアを記録した一方、低効率設定は1タスクあたり4,560ドルで87.5%のスコアを記録しており、12ポイントの精度向上のために約172倍多くの計算量を必要としています。
- Artificial Analysisによると、OpenAIのo3は入力トークン100万件あたり2.00ドル、出力トークン100万件あたり8.00ドルの価格設定であり、内部推論トークンは目に見える回答には決して表示されないにもかかわらず、出力トークンとして課金されます。
関連するAIコンセプト
- Reasoning Models - テストタイム計算を活用するために特別に構築されたモデルカテゴリ
- AI推論 - テストタイム計算が変動コスト型の一形態である、より広範な本番運用フェーズ
- Chain-of-Thought - テストタイム計算が拡張する、段階的な推論手法
- Large Language Models - Reasoning Modelsが拡張するベースとなるモデルカテゴリ
- Inference Optimization - 推論時のコストとレイテンシを制御するための手法
- AIレイテンシ - テストタイム計算における追加の思考時間が導入に影響する理由
- AI Agents - テストタイム推論のコストが積み重なりうる、多段階のシステム
- Foundation Models - 推論能力の土台となるベースモデル
外部リソース
- Stanford AI Index 2025, Technical Performance - o1のGPT-4oに対する精度、コスト、レイテンシに関する独立系ベンチマークデータ
- OpenAI: Learning to Reason with LLMs - OpenAI自身によるo1のリリースノートおよびベンチマークデータ
- Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parameters - テストタイム計算をスケーリング則として定式化したバークレー/DeepMindの論文
- ARC Prize: o3 ARC-AGI-Pub Results - 各計算量設定における1タスクあたりの公式コストデータ
テストタイム計算に関するよくある質問
テストタイム計算とは何ですか?
テストタイム計算(推論時計算とも呼ばれます)とは、モデルが学習中に得た知識だけに頼るのではなく、クエリを受け取った際に問題を推論するために追加で費やす計算量のことです。これには、拡張された推論チェーンの生成、複数の候補回答のサンプリング、回答前の自己確認が含まれます。
テストタイム計算はトレーニング時の計算量とどう違いますか?
トレーニング時の計算量は、モデルのパラメータを設定するために、デプロイ前に1度だけ費やされます。一方、テストタイム計算はモデルがクエリに回答するたびに費やされるもので、モデル自体は一切変わらず、その1つの回答にどれだけの推論の労力を注ぐかだけが変わります。
なぜOpenAIのo1によってテストタイム計算が注目されるようになったのですか?
2024年9月にリリースされたo1は、モデルサイズや学習内容を一切変えなくても、推論時により多くの思考時間を与えるだけで、難易度の高い問題において大きな精度向上が得られることを示しました。Stanford AI Index 2025 reportによると、o1は国際数学オリンピック予選試験で74.4%のスコアを記録し、GPT-4oの9.3%を上回りましたが、コストは約6倍、レイテンシは30倍でした。
テストタイム計算を増やせば、常により良い回答が得られるのですか?
多段階の推論から恩恵を受ける問題では精度が向上しますが、計算量が増えるほど、その向上幅は小さくなっていきます。ARC-AGI-PubにおけるOpenAIのo3の結果では、効率設定と高計算量設定の間で、約172倍多くの計算量に対して12ポイントの精度向上にとどまっています。単純で明確に定義されたタスクでは、追加の推論が意味のある精度向上をもたらさないまま、コストとレイテンシだけを増やしてしまうことがよくあります。
テストタイム計算はAPIコストにどのような影響を与えますか?
Reasoning Modelは、内部の「思考」トークンを、目に見える回答には決して表示されないにもかかわらず、出力トークンとして課金します。つまり、同じように見える回答であっても、標準的なモデルよりもはるかに大きなトークン料金がかかる可能性があり、モデル自体がどれだけ推論する必要があるかを判断するため、合計コストはクエリごとに変動します。
どのようなタスクがテストタイム計算から最も恩恵を受けますか?
多段階の分析、解決策の幅が広いタスク、そして財務モデリング、契約分析、技術的なデバッグのように、誤った回答を後から発見するとコストが高くつくワークフローが最も恩恵を受けます。FAQ対応や基本的な分類のように、量が多く重要度の低いタスクには、通常テストタイム計算は必要ありません。
テストタイム計算はChain-of-Thoughtプロンプティングと同じものですか?
両者は関連していますが、同一のものではありません。Chain-of-Thoughtは、回答の前に段階的な推論を生成する手法です。テストタイム計算はより広いカテゴリであり、Chain-of-Thoughtに加えて、複数候補のサンプリングや自己検証といった、いずれも推論時に適用される他の手法も含みます。
テストタイムスケーリングは、より大きなモデルを学習させることに取って代わるのでしょうか?
いいえ、両者は互いに取って代わるものではなく、補完し合う関係にあります。Scaling LLM Test-Time Compute Optimallyのような研究は、特定のタスクにおいてテストタイム計算がより小さなモデルをはるかに大きなモデルと同等、あるいはそれ以上にできることを示していますが、フロンティアラボは、より大規模な学習実行とより優れたテストタイム推論の両方に投資を続けています。それぞれが異なる価値をもたらすからです。
AI用語集の一部。最終更新日:2026年7月16日
