¿Qué es LoRA (Low-Rank Adaptation)?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Si se ha preguntado "qué es LoRA en IA" al leer sobre los costos del fine-tuning, esta es la respuesta corta: LoRA (Low-Rank Adaptation) es una técnica de fine-tuning eficiente en parámetros que congela los pesos originales de un modelo preentrenado y entrena, en paralelo, pequeñas matrices "adaptadoras". En lugar de actualizar miles de millones de parámetros, LoRA actualiza una fracción diminuta, a menudo menos del 1%, y logra una calidad igual o cercana a la del fine-tuning completo con una fracción del costo de cómputo y almacenamiento.
Cómo funciona LoRA
Cada capa de una red neuronal grande contiene matrices de pesos que se actualizan durante el entrenamiento. El fine-tuning completo modifica cada uno de esos números. LoRA adopta otro enfoque: congela por completo la matriz de pesos original y añade a su lado una segunda vía, mucho más pequeña, construida a partir de dos matrices delgadas multiplicadas entre sí (una "descomposición de bajo rango"). Durante el entrenamiento, solo aprenden esas dos matrices pequeñas. El modelo original nunca cambia.
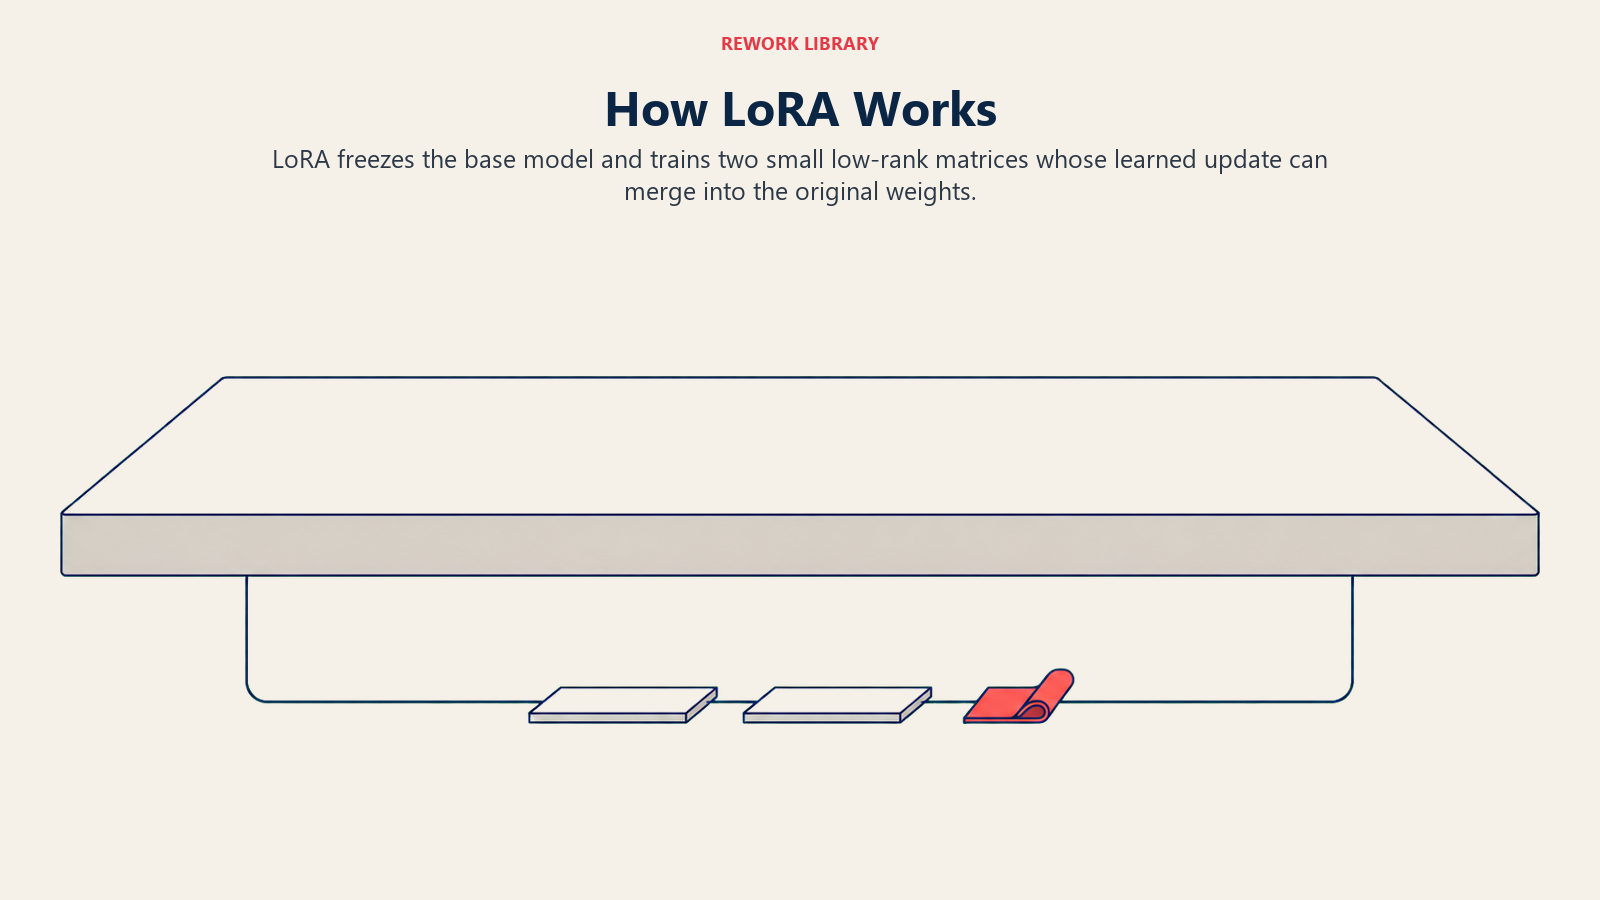
La intuición es más sencilla de lo que sugieren las matemáticas. Una matriz de pesos grande puede tener millones de parámetros, pero el cambio necesario para adaptar un modelo a una nueva tarea o a un nuevo estilo de redacción suele vivir en un subespacio mucho más pequeño. LoRA apuesta a que ese "delta", la diferencia entre el modelo de propósito general y el especializado que usted desea, puede capturarse con dos matrices pequeñas en lugar de una enorme. La técnica surgió de investigaciones anteriores sobre transfer learning, que establecieron que adaptar un modelo preentrenado a una nueva tarea rara vez exige reentrenarlo desde cero.
En el momento de la inferencia, las dos matrices pequeñas pueden fusionarse matemáticamente con los pesos originales, de modo que un modelo adaptado con LoRA se ejecuta exactamente igual de rápido que el modelo base. No hay capas adicionales ni latencia añadida, porque el adaptador prácticamente desaparece dentro de los pesos una vez terminado el entrenamiento.
Datos clave: LoRA (Low-Rank Adaptation)
- LoRA reduce el número de parámetros entrenables 10.000 veces y los requisitos de memoria de GPU 3 veces frente al fine-tuning completo de GPT-3 175B con Adam, según el artículo original de LoRA (Hu et al., 2021, arXiv:2106.09685).
- Un checkpoint de LoRA para GPT-3 175B ocupa unos 35 MB, frente a aproximadamente 350 GB de una copia con fine-tuning completo, una reducción de cerca de 10.000 veces con rango r=4 (Hu et al., 2021).
- QLoRA, una variante de LoRA que añade cuantización de 4 bits, hace fine-tuning de un modelo de 65.000 millones de parámetros en una sola GPU de 48 GB con la misma calidad que el fine-tuning completo de 16 bits (Dettmers et al., 2023, arXiv:2305.14314).
Por qué LoRA importa para la IA empresarial
Para los líderes de negocio, LoRA significa que se puede personalizar un foundation model grande según el tono, la terminología o la tarea de su empresa sin pagar el cómputo, el almacenamiento y las horas de ingeniería que exige el fine-tuning completo. Piense en ello como acoplar un accesorio pequeño y hecho a medida a una herramienta de uso general en lugar de reconstruir toda la herramienta desde cero.
Esa diferencia de costos no es marginal. Según Hu et al. (2021), LoRA reduce el número de parámetros entrenables de GPT-3 175B en 10.000 veces y su requisito de memoria de GPU en 3 veces frente al fine-tuning completo, con un rendimiento igual o mejor que el fine-tuning completo en tareas de referencia con RoBERTa, DeBERTa, GPT-2 y GPT-3. Esa combinación, calidad casi igual con una fracción del costo en recursos, es la razón por la que LoRA se convirtió en el enfoque de fine-tuning por defecto para la mayoría de los equipos que trabajan con modelos de lenguaje grandes y no en la excepción.
El almacenamiento se suma de la misma manera. Una copia de GPT-3 175B con fine-tuning completo requiere aproximadamente 350 GB. Un adaptador LoRA para el mismo modelo requiere unos 35 MB (Hu et al., 2021). Eso significa que una empresa puede mantener decenas de adaptadores específicos por tarea, uno para la revisión de documentos legales, otro para el tono de atención al cliente, otro para una línea de producto concreta, sobre un modelo base compartido, sin duplicar cientos de gigabytes por cada variante. Hu et al. señalan que alojar 100 modelos adaptados de esta forma cuesta aproximadamente 354 GB en total, en lugar de unos 35 TB para 100 copias completas independientes.
LoRA también hizo posible un segundo avance: QLoRA. Presentado por Dettmers et al. (2023), QLoRA combina LoRA con la cuantización de 4 bits del modelo base congelado, y reduce las necesidades de memoria lo suficiente como para hacer fine-tuning de un modelo de 65.000 millones de parámetros en una sola GPU de 48 GB conservando el rendimiento del fine-tuning completo de 16 bits. La familia de modelos resultante del artículo, Guanaco, alcanzó el 99,3% del nivel de rendimiento de ChatGPT en el benchmark Vicuna tras solo 24 horas de fine-tuning en una GPU. Ese resultado llevó la personalización de modelos grandes, para muchos equipos, de clústeres de servidores con varias GPU a la GPU de una sola estación de trabajo.
Casos de uso comunes de LoRA
LoRA aparece dondequiera que los equipos necesitan muchas versiones especializadas de un mismo modelo base sin el costo de reentrenar por completo cada una.
- Adaptación a un dominio. Enseñar a un LLM de propósito general el vocabulario de su sector, como terminología legal, médica o financiera, sin tocar el modelo base.
- Voz y tono de marca. Adaptar el estilo de redacción de un modelo para que coincida con los guiones de soporte o la voz de marketing de una empresa.
- Productos de IA multi-tenant. Las plataformas SaaS que atienden a muchos clientes pueden mantener un modelo base compartido e intercambiar un adaptador LoRA ligero por cliente, evitando el costo de almacenamiento y servicio de cientos de copias completas del modelo.
- Experimentación rápida. Como el entrenamiento con LoRA se ejecuta en horas en lugar de días y necesita mucha menos memoria de GPU, los equipos pueden probar más ideas de fine-tuning con el mismo presupuesto.
- Personalización de modelos de imagen y de difusión. LoRA también se usa ampliamente fuera de los modelos de texto, y permite a artistas y equipos de producto adaptar modelos de generación de imágenes a un estilo artístico o una línea de producto específicos con un pequeño archivo adaptador en lugar de un modelo reentrenado de varios gigabytes.
- Despliegue en el edge y en entornos con recursos limitados. Combinados con técnicas de optimización de modelos, los adaptadores LoRA mantienen disponible la capacidad especializada incluso donde no existe infraestructura para un reentrenamiento completo.
LoRA vs. fine-tuning completo vs. RAG
Estos tres enfoques resuelven problemas relacionados pero distintos, y los equipos a menudo combinan más de uno.
| Enfoque | Qué cambia | Mejor para | Costo de cómputo/almacenamiento | Velocidad de actualización |
|---|---|---|---|---|
| Fine-tuning completo | Todos los pesos del modelo | Máxima personalización cuando se cuenta con presupuesto y un conjunto de datos grande y de alta calidad | El más alto (clúster completo de GPU, almacenamiento del modelo completo por versión) | Lento de reentrenar |
| LoRA (y QLoRA) | Un pequeño conjunto de matrices adaptadoras de bajo rango añadidas, los pesos base permanecen congelados | Enseñar con eficiencia un nuevo tono, terminología o comportamiento específico de una tarea | Bajo (viable con una sola GPU, adaptadores medidos en MB) | Rápido de reentrenar, fácil de intercambiar adaptadores |
| Retrieval-augmented generation | Nada en el modelo, recupera documentos relevantes en el momento de la consulta y los incorpora al prompt | Mantener las respuestas al día con hechos que cambian rápido, o citar documentos fuente específicos | Bajo (no requiere entrenamiento, solo una base de conocimiento indexada) | Instantáneo, basta actualizar los documentos fuente |
La regla práctica: use RAG cuando necesite que el modelo conozca hechos actuales o propietarios, use LoRA cuando necesite que el modelo se comporte o escriba de otra manera, y reserve el fine-tuning completo para los pocos casos en que el menor presupuesto de parámetros de LoRA realmente no pueda capturar el cambio necesario. Muchos sistemas en producción combinan modelos adaptados con LoRA y RAG para la recuperación, ya que ambos resuelven problemas distintos.
Limitaciones de LoRA
LoRA no es un reemplazo universal del fine-tuning completo, y tiene contrapartidas reales.
- La elección del rango importa. Un rango demasiado bajo puede subajustar tareas complejas, mientras que uno demasiado alto empieza a erosionar la ventaja de eficiencia de LoRA. Hu et al. (2021) encontraron que un rango tan pequeño como uno solía bastar para las tareas de GPT-3 que probaron, pero esto depende de la tarea y requiere validación para cada caso de uso.
- No es ideal para enseñar conocimiento genuinamente nuevo. LoRA adapta bien el comportamiento y el estilo, pero no es la herramienta adecuada para inyectar grandes cantidades de conocimiento factual nuevo que el modelo base nunca vio. La retrieval-augmented generation o el preentrenamiento continuo suelen manejar eso mejor.
- Sigue requiriendo un modelo base capaz. LoRA adapta lo que un foundation model ya sabe; no puede compensar un modelo base que carece por completo de la capacidad subyacente.
- Sobrecarga de gestión de adaptadores. Operar muchos adaptadores LoRA en producción requiere infraestructura para cargarlos, intercambiarlos y versionarlos correctamente, un problema menor que el versionado de modelos completos, pero no inexistente.
- Distinto de las técnicas de compresión. LoRA reduce el costo de entrenamiento, no necesariamente el costo de inferencia ni el tamaño del modelo al servirlo (una vez fusionado, el modelo tiene el mismo tamaño que el modelo base). Los equipos que buscan reducir el modelo desplegado suelen combinar LoRA con trabajo aparte de compresión de modelos o de knowledge distillation.
Más información
- Fine-tuning - la categoría más amplia de técnicas a la que pertenece LoRA
- Foundation Models - los modelos base sobre los que se entrenan los adaptadores LoRA
- Large Language Models - la clase de modelos para la que se creó originalmente LoRA
- Cuantización - la técnica que QLoRA combina con LoRA
- Transfer Learning - la base de investigación sobre la que se construye LoRA
- Knowledge Distillation - un enfoque alternativo para reducir modelos en lugar de adaptarlos
Preguntas frecuentes sobre LoRA
¿Qué es LoRA en IA, en una frase?
LoRA (Low-Rank Adaptation) es un método de fine-tuning eficiente en parámetros que congela los pesos de un modelo preentrenado y entrena en su lugar pequeñas matrices adaptadoras añadidas, y logra gran parte de la calidad del fine-tuning completo con una fracción del costo de cómputo y almacenamiento.
¿LoRA es un tipo de fine-tuning?
Sí. LoRA es una técnica de fine-tuning eficiente en parámetros (PEFT), una categoría de métodos que adaptan un modelo preentrenado actualizando solo un pequeño subconjunto de parámetros en lugar del modelo completo, a diferencia del fine-tuning completo, que actualiza todos los pesos.
¿Cuánto más barato es LoRA que el fine-tuning completo?
Según el artículo original de LoRA (Hu et al., 2021), LoRA reduce los parámetros entrenables 10.000 veces y los requisitos de memoria de GPU 3 veces frente al fine-tuning completo de GPT-3 175B con Adam, con una calidad igual o superior a la del fine-tuning completo en los benchmarks probados.
¿Qué es QLoRA y en qué se diferencia de LoRA?
QLoRA añade a LoRA estándar la cuantización de 4 bits del modelo base congelado, lo que reduce aún más las necesidades de memoria. Dettmers et al. (2023) demostraron que QLoRA puede hacer fine-tuning de un modelo de 65.000 millones de parámetros en una sola GPU de 48 GB conservando el rendimiento del fine-tuning completo de 16 bits.
¿LoRA hace más lento el modelo en el momento de la inferencia?
No. Una vez terminado el entrenamiento, las pequeñas matrices de LoRA pueden fusionarse matemáticamente con los pesos originales, de modo que el modelo adaptado se ejecuta a la misma velocidad que el modelo base, sin latencia de inferencia adicional.
¿Cuándo debo usar LoRA en lugar de RAG?
Use LoRA cuando necesite que el modelo escriba con otro tono, siga un formato específico o maneje una tarea especializada. Use retrieval-augmented generation cuando necesite que el modelo consulte hechos actuales o propietarios, ya que RAG actualiza lo que el modelo ve en el momento de la consulta y no lo que ha aprendido.
¿Puede LoRA enseñar a un modelo conocimiento completamente nuevo?
No de forma eficiente. LoRA es más adecuado para adaptar comportamiento y estilo existentes que para inyectar grandes cantidades de conocimiento factual nuevo. Para conocimiento nuevo, suelen encajar mejor la retrieval-augmented generation o el preentrenamiento continuo.
¿LoRA solo se usa en modelos de lenguaje?
No. LoRA se usa ampliamente también en modelos de imagen y de difusión, y permite a los equipos adaptar generadores de imágenes a un estilo artístico o una línea de producto específicos con un pequeño archivo adaptador en lugar de reentrenar el modelo completo.
Parte de la Colección de términos de IA. Última actualización: julio de 2026
