Apakah LoRA (Low-Rank Adaptation)?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Jika anda tertanya-tanya "apakah LoRA dalam AI" semasa membaca tentang kos fine-tuning, inilah jawapan ringkasnya: LoRA (Low-Rank Adaptation) ialah teknik fine-tuning cekap parameter yang membekukan berat asal model pra-latihan dan melatih matriks "adapter" kecil di sampingnya. Daripada mengemas kini berbilion parameter, LoRA mengemas kini sebahagian kecil sahaja, selalunya kurang daripada 1%, sambil menyamai atau menghampiri kualiti fine-tuning penuh pada sebahagian kecil kos pengiraan dan storan.
Cara LoRA Berfungsi
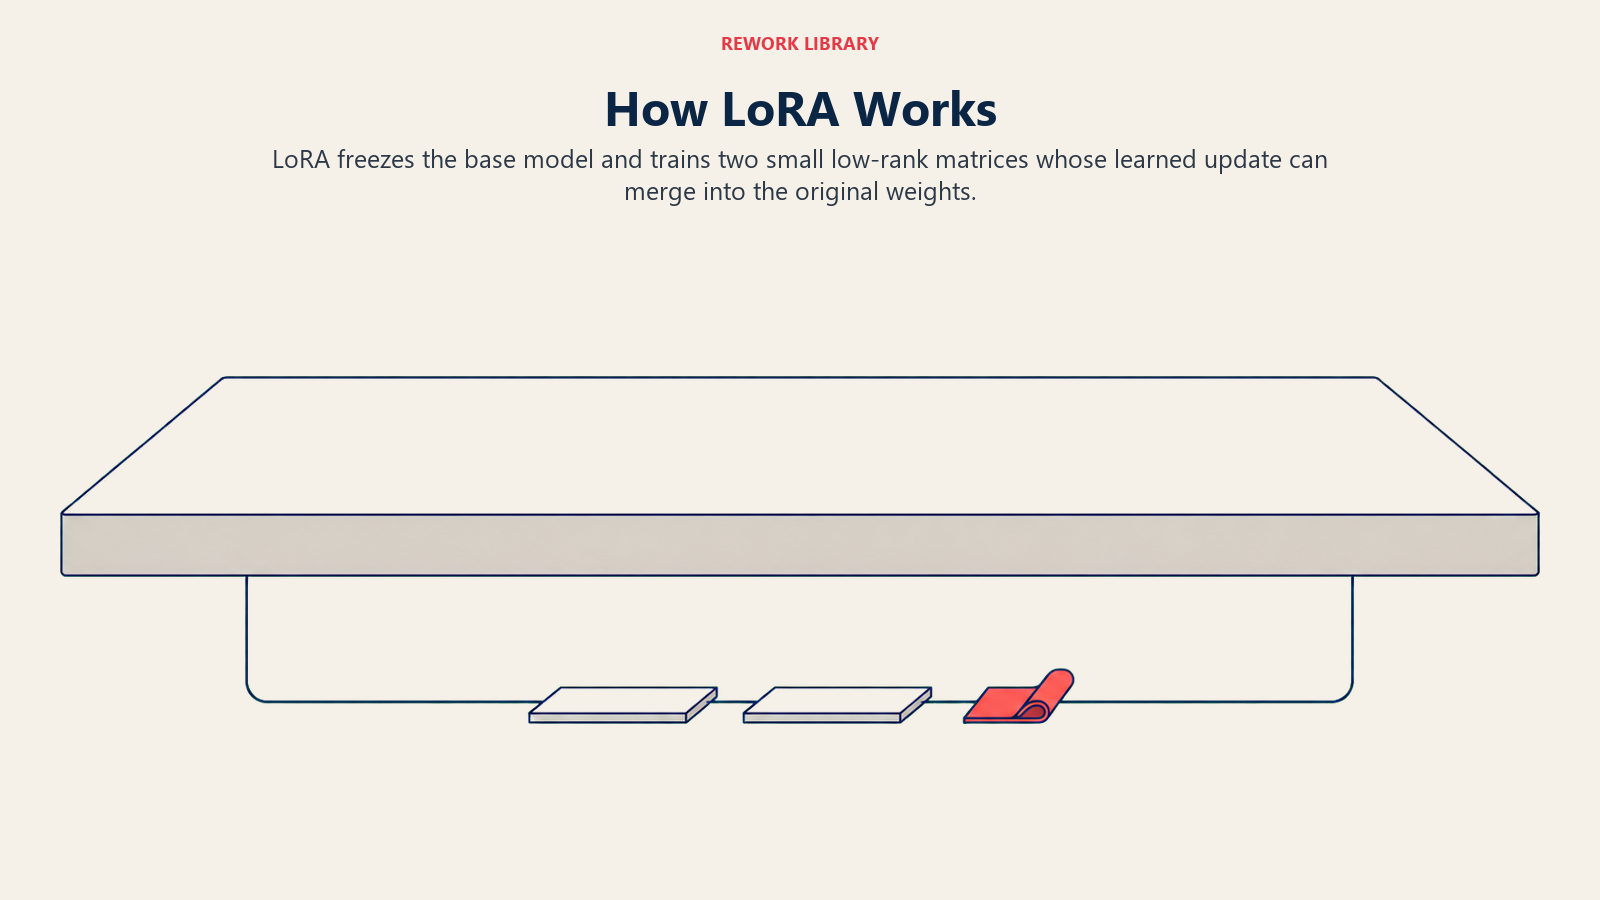
Setiap lapisan rangkaian neural yang besar mengandungi matriks berat yang dikemas kini semasa latihan. Fine-tuning penuh menyentuh setiap nombor tersebut. LoRA mengambil pendekatan lain: ia membekukan sepenuhnya matriks berat asal dan menambah laluan kedua yang jauh lebih kecil di sebelahnya, dibina daripada dua matriks nipis yang didarabkan (satu "penguraian pangkat rendah"). Semasa latihan, hanya dua matriks kecil itu yang belajar. Model asal tidak pernah berubah.
Gambaran asasnya lebih mudah daripada bunyi matematiknya. Matriks berat yang besar mungkin mempunyai berjuta parameter, tetapi perubahan yang diperlukan untuk menyesuaikan model kepada tugas baharu atau gaya penulisan baharu selalunya berada dalam subruang yang jauh lebih kecil. LoRA bertaruh bahawa "delta" ini, iaitu perbezaan antara model serba guna dan model khusus yang anda mahukan, boleh ditangkap oleh dua matriks kecil dan bukannya satu matriks yang amat besar. Teknik ini berkembang daripada penyelidikan transfer learning terdahulu, yang menunjukkan bahawa menyesuaikan model pra-latihan kepada tugas baharu jarang memerlukan latihan semula dari awal.
Semasa inferens, kedua-dua matriks kecil itu boleh digabungkan secara matematik semula ke dalam berat asal, jadi model yang disesuaikan dengan LoRA berjalan sama pantas dengan model asas. Tiada lapisan tambahan, tiada kependaman tambahan, kerana adapter pada dasarnya hilang ke dalam berat sebaik sahaja latihan selesai.
Fakta Utama: LoRA (Low-Rank Adaptation)
- LoRA mengurangkan bilangan parameter yang boleh dilatih sebanyak 10,000 kali ganda dan keperluan memori GPU sebanyak 3 kali ganda berbanding fine-tuning penuh GPT-3 175B dengan Adam, menurut kertas LoRA asal (Hu et al., 2021, arXiv:2106.09685).
- Checkpoint LoRA untuk GPT-3 175B bersaiz kira-kira 35MB, berbanding lebih kurang 350GB untuk salinan yang di-fine-tune sepenuhnya, pengurangan kira-kira 10,000x pada rank r=4 (Hu et al., 2021).
- QLoRA, varian LoRA yang menambah kuantisasi 4-bit, menala model 65 bilion parameter pada satu GPU 48GB sambil menyamai kualiti fine-tuning 16-bit penuh (Dettmers et al., 2023, arXiv:2305.14314).
Mengapa LoRA Penting untuk AI Perniagaan
Bagi pemimpin perniagaan, LoRA bermakna anda boleh menyesuaikan foundation model yang besar kepada nada, terminologi, atau tugas syarikat anda tanpa membayar kos pengiraan, storan, dan masa kejuruteraan yang dituntut oleh fine-tuning penuh. Anggaplah ia seperti memasang lampiran kecil yang dibina khas pada alat serba guna dan bukannya membina semula keseluruhan alat dari awal.
Jurang kos itu bukan kecil. Menurut Hu et al. (2021), LoRA mengurangkan bilangan parameter boleh latih GPT-3 175B sebanyak 10,000 kali ganda dan keperluan memori GPU sebanyak 3 kali ganda berbanding fine-tuning penuh, sambil berprestasi setara atau lebih baik daripada fine-tuning penuh pada tugas penanda aras merentasi RoBERTa, DeBERTa, GPT-2, dan GPT-3. Gabungan itu, kualiti hampir sama pada sebahagian kecil kos sumber, ialah sebab LoRA menjadi pendekatan fine-tuning lalai bagi kebanyakan pasukan yang bekerja dengan large language models dan bukannya pengecualian.
Storan bertambah dengan cara yang sama. Salinan GPT-3 175B yang di-fine-tune sepenuhnya memerlukan kira-kira 350GB. Adapter LoRA untuk model yang sama memerlukan kira-kira 35MB (Hu et al., 2021). Ini bermakna syarikat boleh menyimpan berpuluh adapter khusus tugas, satu untuk semakan dokumen undang-undang, satu untuk nada sokongan pelanggan, satu untuk barisan produk tertentu, pada satu model asas yang dikongsi tanpa menduplikasi ratusan gigabait bagi setiap varian. Hu et al. menyatakan bahawa menempatkan 100 model yang disesuaikan dengan cara ini memerlukan kira-kira 354GB keseluruhan berbanding lebih kurang 35TB untuk 100 salinan penuh yang berasingan.
LoRA juga memungkinkan kejayaan kedua: QLoRA. Diperkenalkan oleh Dettmers et al. (2023), QLoRA menggabungkan LoRA dengan kuantisasi 4-bit pada model asas yang beku, mengecilkan keperluan memori cukup untuk menala model 65 bilion parameter pada satu GPU 48GB sambil mengekalkan prestasi tugas fine-tuning 16-bit penuh. Keluarga model hasil kertas itu, Guanaco, mencapai 99.3% tahap prestasi ChatGPT pada penanda aras Vicuna selepas hanya 24 jam fine-tuning pada satu GPU. Hasil itu memindahkan penyesuaian model besar daripada kluster pelayan berbilang GPU kepada satu GPU stesen kerja bagi banyak pasukan.
Kes Penggunaan Lazim untuk LoRA
LoRA muncul di mana-mana pasukan memerlukan banyak versi khusus bagi satu model asas tanpa kos melatih semula setiap satu sepenuhnya.
- Penyesuaian domain. Mengajar LLM serba guna kosa kata industri anda, seperti terminologi undang-undang, perubatan, atau kewangan, tanpa menyentuh model asas.
- Suara dan nada jenama. Menyesuaikan gaya penulisan model agar sepadan dengan skrip sokongan atau suara pemasaran syarikat.
- Produk AI berbilang penyewa. Platform SaaS yang melayani ramai pelanggan boleh mengekalkan satu model asas yang dikongsi dan menukar adapter LoRA ringan bagi setiap pelanggan, mengelakkan kos storan dan penyajian ratusan salinan model penuh.
- Eksperimen pantas. Oleh kerana latihan LoRA berjalan dalam beberapa jam dan bukannya beberapa hari serta memerlukan memori GPU yang jauh lebih sedikit, pasukan boleh menguji lebih banyak idea fine-tuning dalam bajet yang sama.
- Penyesuaian model imej dan diffusion. LoRA digunakan secara meluas di luar model teks juga, membolehkan artis dan pasukan produk menyesuaikan model penjanaan imej kepada gaya seni atau barisan produk tertentu dengan fail adapter kecil dan bukannya model terlatih semula berbilang gigabait.
- Pelaksanaan di edge dan persekitaran terhad sumber. Digabungkan dengan teknik model optimization, adapter LoRA mengekalkan keupayaan khusus walaupun di tempat yang tiada infrastruktur latihan semula penuh.
LoRA lwn Fine-tuning Penuh lwn RAG
Ketiga-tiga pendekatan ini menyelesaikan masalah yang berkaitan tetapi berbeza, dan pasukan sering menggabungkan lebih daripada satu.
| Pendekatan | Apa yang diubah | Paling sesuai untuk | Kos pengiraan/storan | Kelajuan kemas kini |
|---|---|---|---|---|
| Fine-tuning penuh | Setiap berat model | Penyesuaian maksimum apabila anda mempunyai bajet dan set data yang besar serta berkualiti tinggi | Tertinggi (kluster GPU penuh, storan model penuh bagi setiap versi) | Perlahan untuk dilatih semula |
| LoRA (dan QLoRA) | Set kecil matriks adapter pangkat rendah yang ditambah, berat asas kekal beku | Mengajar nada, terminologi, atau tingkah laku khusus tugas dengan cekap | Rendah (satu GPU memadai, adapter diukur dalam MB) | Pantas untuk dilatih semula, adapter mudah ditukar |
| Retrieval-augmented generation | Tiada apa-apa dalam model, ia mendapatkan dokumen relevan semasa pertanyaan dan memasukkannya ke dalam prompt | Memastikan jawapan kekal terkini dengan fakta yang cepat berubah, atau memetik dokumen sumber tertentu | Rendah (tiada latihan diperlukan, hanya pangkalan pengetahuan yang diindeks) | Serta-merta, kemas kini dokumen sumber |
Petua praktikalnya: gunakan RAG apabila anda perlu model mengetahui fakta semasa atau proprietari, gunakan LoRA apabila anda perlu model berkelakuan atau menulis secara berbeza, dan simpan fine-tuning penuh untuk kes jarang apabila bajet parameter LoRA yang lebih kecil benar-benar tidak mampu menangkap perubahan yang diperlukan. Banyak sistem pengeluaran menggabungkan model yang disesuaikan dengan LoRA bersama RAG untuk pencarian, kerana kedua-duanya menyelesaikan masalah yang berasingan.
Batasan LoRA
LoRA bukan pengganti universal untuk fine-tuning penuh, dan ia disertai pertukaran yang nyata.
- Pilihan rank penting. Rank yang terlalu rendah boleh mengakibatkan underfitting pada tugas kompleks, manakala rank yang terlalu tinggi mula menghakis kelebihan kecekapan LoRA. Hu et al. (2021) mendapati rank sekecil satu selalunya mencukupi untuk tugas GPT-3 yang mereka uji, tetapi ini bergantung pada tugas dan perlu disahkan bagi setiap kes penggunaan.
- Kurang sesuai untuk mengajar pengetahuan yang benar-benar baharu. LoRA menyesuaikan tingkah laku dan gaya dengan baik tetapi bukan alat yang tepat untuk memasukkan sejumlah besar pengetahuan fakta baharu yang tidak pernah dilihat model asas. Retrieval-augmented generation atau pra-latihan berterusan umumnya menanganinya dengan lebih baik.
- Masih memerlukan model asas yang berkebolehan. LoRA menyesuaikan apa yang sudah diketahui oleh foundation model; ia tidak dapat menampung model asas yang langsung tidak mempunyai keupayaan asasnya.
- Overhead pengurusan adapter. Menjalankan banyak adapter LoRA dalam pengeluaran memerlukan infrastruktur untuk memuat, menukar, dan memberi versi dengan betul, yang merupakan masalah lebih kecil daripada pemberian versi model penuh tetapi bukan sifar.
- Berbeza daripada teknik pemampatan. LoRA mengurangkan kos latihan, bukan semestinya kos inferens atau saiz model semasa penyajian (setelah digabungkan, model sama saiz dengan model asas). Pasukan yang ingin mengecilkan model yang dilaksanakan lazimnya menggandingkan LoRA dengan kerja model compression atau knowledge distillation yang berasingan.
Ketahui Lebih Lanjut
- Fine-tuning - kategori teknik lebih luas yang menjadi tempat LoRA berada
- Foundation Models - model asas yang menjadi tapak latihan adapter LoRA
- Large Language Models - kelas model yang asalnya LoRA dibina untuknya
- Quantization - teknik yang digabungkan QLoRA dengan LoRA
- Transfer Learning - asas penyelidikan yang menjadi pijakan LoRA
- Knowledge Distillation - pendekatan alternatif untuk mengecilkan model dan bukannya menyesuaikannya
Soalan Lazim tentang LoRA
Apakah LoRA dalam AI, dalam satu ayat?
LoRA (Low-Rank Adaptation) ialah kaedah fine-tuning cekap parameter yang membekukan berat model pra-latihan dan melatih matriks adapter kecil yang ditambah, menyamai sebahagian besar kualiti fine-tuning penuh pada sebahagian kecil kos pengiraan dan storan.
Adakah LoRA sejenis fine-tuning?
Ya. LoRA ialah teknik parameter-efficient fine-tuning (PEFT), kategori kaedah yang menyesuaikan model pra-latihan dengan mengemas kini hanya subset kecil parameter dan bukannya keseluruhan model, tidak seperti fine-tuning penuh yang mengemas kini setiap berat.
Berapa murahnya LoRA berbanding fine-tuning penuh?
Menurut kertas LoRA asal (Hu et al., 2021), LoRA mengurangkan parameter boleh latih sebanyak 10,000 kali ganda dan keperluan memori GPU sebanyak 3 kali ganda berbanding fine-tuning penuh GPT-3 175B dengan Adam, sambil menyamai atau melebihi kualiti fine-tuning penuh pada penanda aras yang diuji.
Apakah QLoRA dan bagaimana ia berbeza daripada LoRA?
QLoRA menambah kuantisasi 4-bit pada model asas yang beku kepada LoRA standard, mengurangkan keperluan memori dengan lebih lanjut. Dettmers et al. (2023) menunjukkan QLoRA boleh menala model 65 bilion parameter pada satu GPU 48GB sambil mengekalkan prestasi fine-tuning 16-bit penuh.
Adakah LoRA memperlahankan model semasa inferens?
Tidak. Setelah latihan selesai, matriks LoRA yang kecil boleh digabungkan secara matematik semula ke dalam berat asal, jadi model yang disesuaikan berjalan pada kelajuan yang sama dengan model asas tanpa kependaman inferens tambahan.
Bilakah saya patut menggunakan LoRA dan bukannya RAG?
Gunakan LoRA apabila anda perlu model menulis dengan nada yang berbeza, mengikut format tertentu, atau menangani tugas khusus. Gunakan retrieval-augmented generation apabila anda perlu model merujuk fakta semasa atau proprietari, kerana RAG mengemas kini apa yang dilihat model semasa pertanyaan dan bukannya apa yang telah dipelajarinya.
Bolehkah LoRA mengajar model pengetahuan yang sepenuhnya baharu?
Tidak dengan cekap. LoRA lebih sesuai untuk menyesuaikan tingkah laku dan gaya sedia ada daripada memasukkan sejumlah besar pengetahuan fakta baharu. Untuk pengetahuan baharu, retrieval-augmented generation atau pra-latihan berterusan lazimnya lebih sesuai.
Adakah LoRA hanya digunakan untuk model bahasa?
Tidak. LoRA digunakan secara meluas untuk model imej dan diffusion juga, membolehkan pasukan menyesuaikan penjana imej kepada gaya seni atau barisan produk tertentu dengan fail adapter kecil dan bukannya melatih semula model penuh.
Sebahagian daripada AI Terms Collection. Kemaskini terakhir: Julai 2026
