AIデータセンターとは?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
2026年7月更新
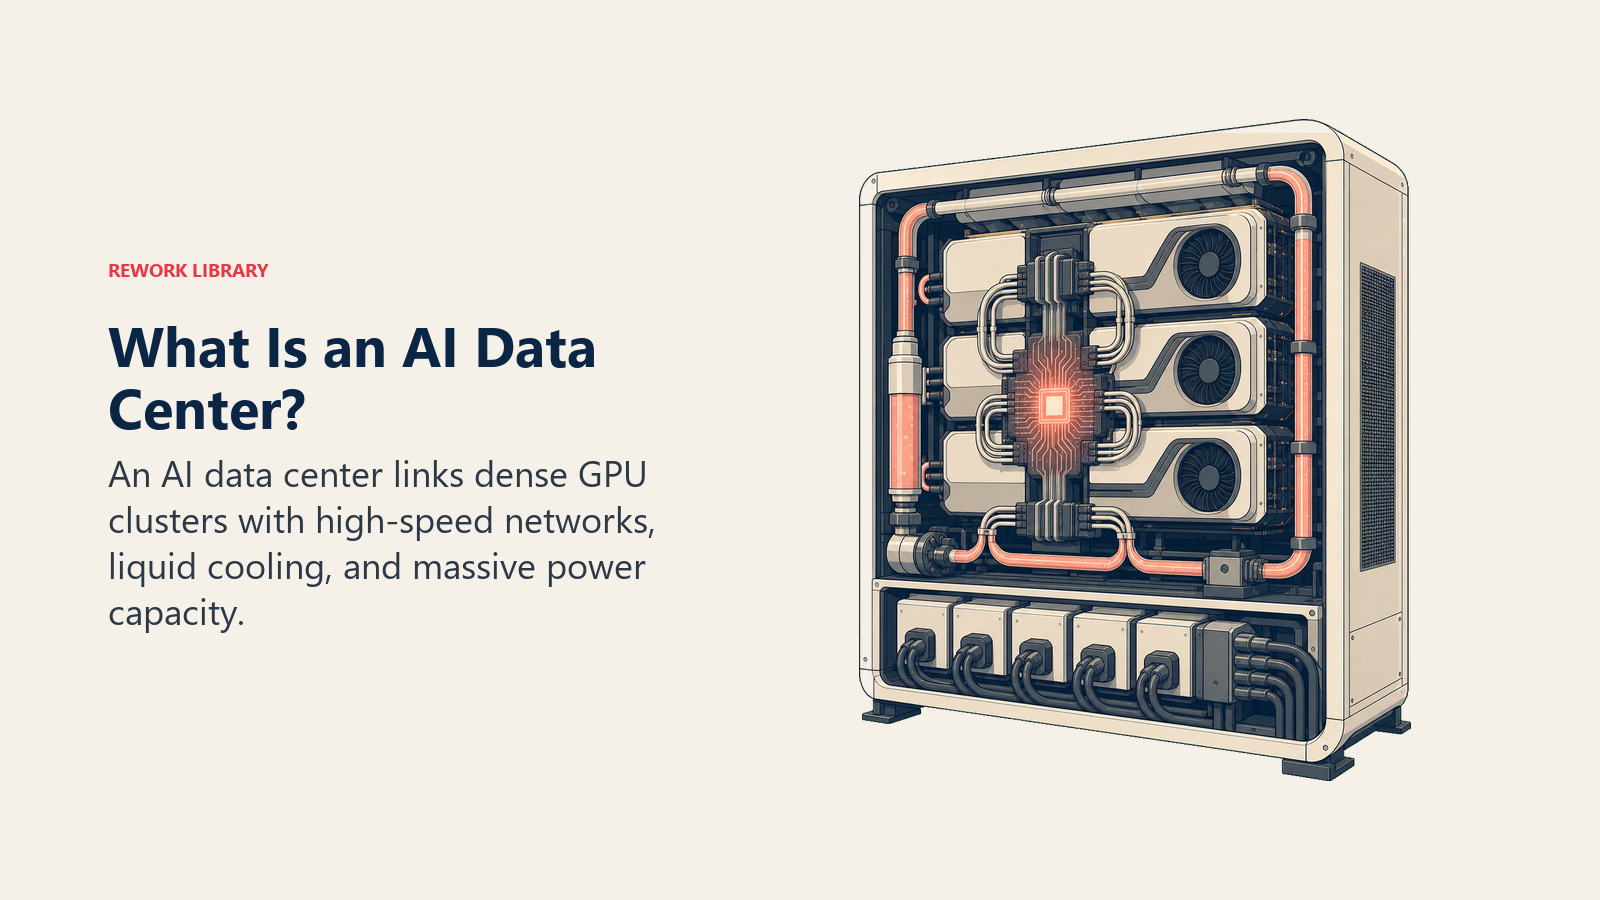
AIデータセンターとは、GPUなどのAIアクセラレータを大量に搭載し、AIモデルを大規模に学習・実行するために特化して構築された専用施設です。汎用のデータセンターとは異なり、極めて高い電力密度、チップ間の高速ネットワーク、そして大容量の冷却設備を中心に設計されています。これらはいずれも、メールサーバーやウェブサイトを運用する従来型施設がそもそも想定していなかった要件です。
ビジネスリーダーにとってこの違いが重要なのは、なぜAIが高額で、なぜ供給能力が逼迫しているのかを説明してくれるからです。 チャットボットの応答一つひとつ、AIが生成する予測一つひとつ、そして貴社のチームがファインチューニングするモデルはすべて、この20年間インターネットを支えてきたデータセンターよりも、建設・給電・冷却にはるかに多くのコストがかかるインフラの上で動いています。AIデータセンターの内部で実際に何が起きているのかを理解しておけば、ベンダーの価格設定や、クラウドプロバイダーの容量待機リスト、あるいは100億ドル規模の新キャンパスに関するニュースの見出しを読み解き、その数字の裏にある実態をつかむことがずっと容易になります。
AIデータセンターと従来型データセンターの違い
従来型データセンターは、ウェブサイトのホスティング、データベースの運用、ファイルの保存、そして単一のサーバーチップがほとんどの処理を単独でこなすアプリケーションの提供といった、まったく異なる用途のために構築されてきました。一方AIデータセンターは、数千個のチップの間で膨大な量のデータを同時にやり取りするために存在しており、そのため設計上の選択肢のほぼすべてが変わってきます。
| 項目 | 従来型データセンター | AIデータセンター |
|---|---|---|
| ラックあたりの電力密度 | 概ね5〜10キロワット | 多くの場合40〜130キロワット以上、最新のGPUラックでは120キロワットを超えることも |
| 冷却方式 | 高床とCRACユニットによる空冷 | チップ直付け液冷または液浸冷却(空冷だけでは熱を十分な速さで除去できないため) |
| ネットワーク | 多数の独立したリクエストに合わせて調整された標準的なイーサネット | NVLinkやInfiniBandのような高帯域・低レイテンシのファブリック(数千台のGPUを1台のマシンのように動作させるために調整) |
| 演算ハードウェア | 汎用CPU | GPUなどのアクセラレータ(1クラスターあたり数千個に及ぶことも多く、1つのジョブを並列処理) |
| 主なワークロード | 多数の小規模で独立したリクエストの処理 | すべてのチップが常に他のすべてのチップと通信し合う必要がある大規模モデルの学習と実行 |
| メガワットあたりの建設コスト | 低め、標準的な建設 | 電源インフラ、液冷プラント、専用ネットワークにより大幅に高い |
実務上の要点はこうです。従来型データセンターは、多数の小さく独立したジョブを安価に処理することに最適化されています。一方AIデータセンターは、数千個もの高価なチップを一つの巨大なジョブのために連携させることに最適化されており、この目的の違いこそが設計上のあらゆる違いを生み出しています。
AIデータセンターを構成する主要コンポーネント
マーケティング的な装飾を取り除けば、どのAIデータセンターも一握りの中核要素から構成されています。
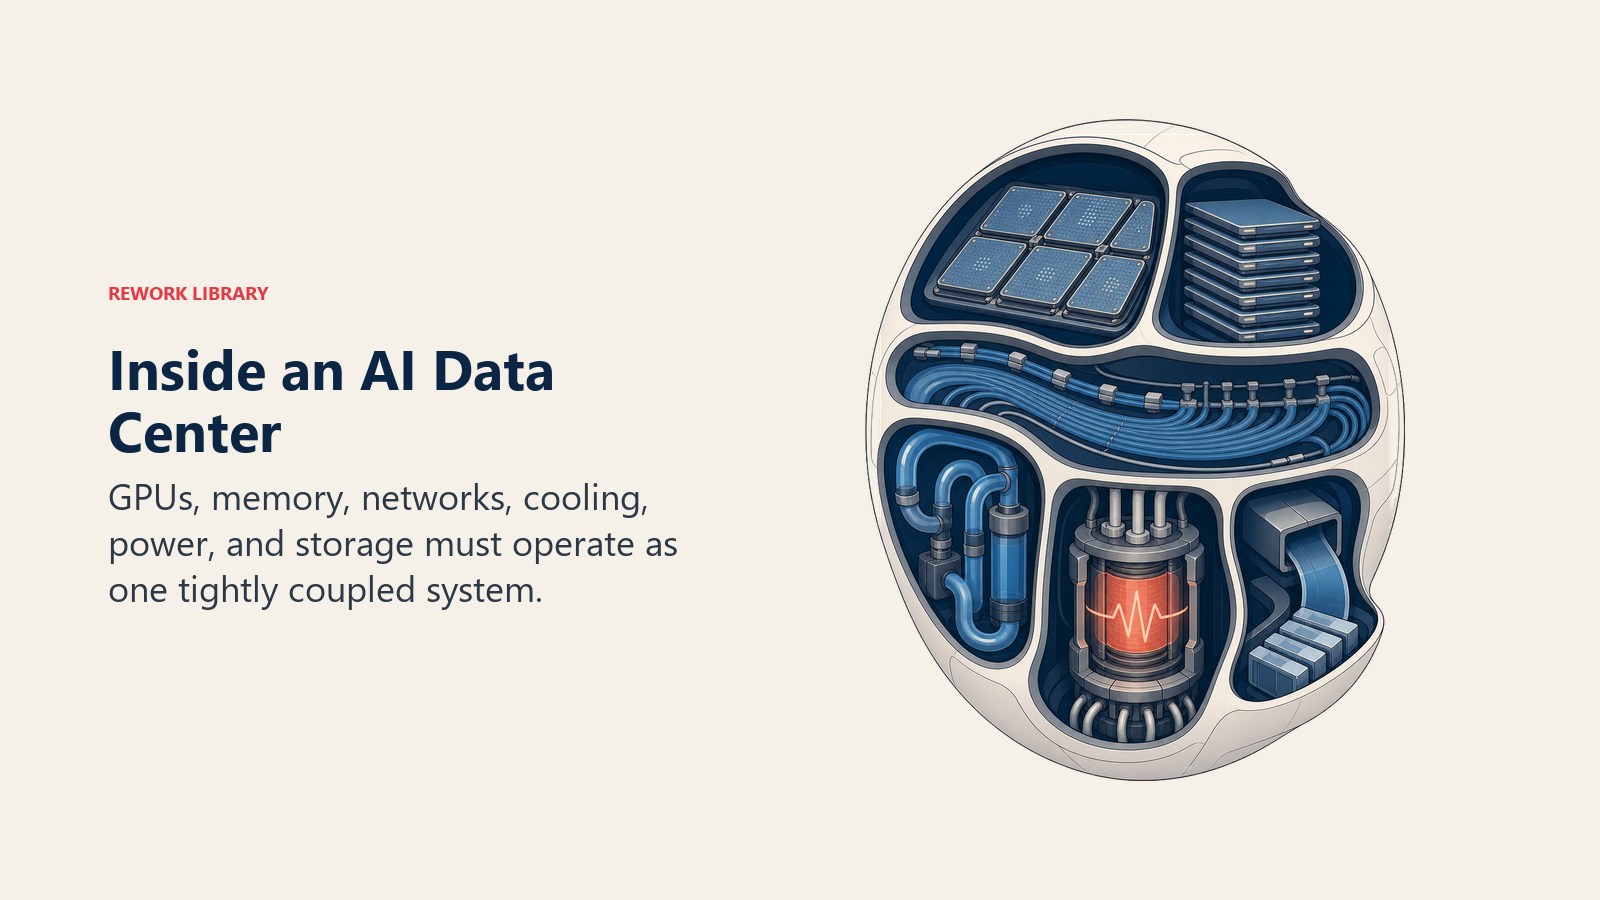
- GPUとAIアクセラレータ: 実際の演算を担う処理エンジンです。NvidiaのH100、H200、Blackwell世代のGPU、AMDのMIシリーズアクセラレータ、GoogleのTPU、そしてハイパースケーラー自身が開発するカスタムシリコンの波が広がっています。大規模言語モデルをはじめとする基盤モデルが実際に学習・実行される場所です。
- 高帯域幅メモリ(HBM): GPUダイのすぐ隣に積層配置されたメモリで、チップを常時稼働させ続けられるだけの速さでデータを供給します。モデルのサイズや速度は、計算の速さだけでなく、チップがどれだけのHBMを搭載しているかによって制約を受けることが少なくありません。
- インターコネクトとネットワークファブリック: チップ間およびラック間の接続(サーバー内はNVLink、サーバー間はInfiniBandや高速イーサネット)であり、数千台のGPUを、ばらばらの機械としてではなく1台の巨大なコンピューターとして機能させます。多くの人が軽視しがちな要素ですが、クラスターの速度は最も遅い接続によって決まります。
- 液冷システム: チップ直付けのコールドプレートや完全液浸タンクにより、従来型施設が想定していたどの水準よりもはるかに高温で稼働するラックから熱を除去します。
- 電源インフラ: 専用変電所、施設内のバックアップ発電、そして近年ではバッテリー蓄電も増えています。単一のAIキャンパスが、小都市に匹敵する電力を消費する場合もあるためです。
- ストレージとデータパイプライン: 学習データがボトルネックになることなくGPUへ流れ続けるようにする高速ストレージシステムに加え、モデルの学習が完了し本番トラフィックへ対応できる状態になった後のモデルサービングを管理するシステムです。
2025年から2026年にかけてのAIデータセンター建設ラッシュ
現在進行している建設の規模は、テック業界史上最速のインフラ整備といえます。米国最大手のハイパースケーラー4社、Amazon、Alphabet(Google)、Microsoft、Metaは、決算ガイダンスの報道によれば、2026年の設備投資見通しとして合計でおよそ7,250億ドルを示しており、これはすでに過去最高だった2025年の4,100億ドルから約77パーセントの増加です。内訳を見ると、Amazonが約2,000億ドル、Alphabetが1,850億〜1,900億ドル、Metaが1,250億〜1,450億ドル、Microsoftが約1,200億ドルとなっており、そのほとんどがAIインフラへの投資です。
この支出を後押ししているのは3つの要因です。第一に、フロンティアモデルの学習コストは利用可能な計算資源に比例して拡大し続けており、最も多くのGPUを持つ企業が最も高性能なモデルを構築できます。第二に、推論需要、つまりAI製品を実際に本番稼働させるために必要な計算資源は、ユーザーからのクエリ一つひとつ、AIエージェントのタスク一つひとつ、テストタイムコンピュートにおける推論ステップ一つひとつがGPU時間を消費するため、ほとんどのプロバイダーが供給能力を追加できるペースを上回って増加しています。そして各ハイパースケーラーは、Nvidiaへの依存を減らしAI出力単位あたりのコストを下げるため、独自チップの開発を競っており、既存ハードウェアからより多くの性能を引き出す量子化のような技術も併用しています。
その結果は物理的な世界にも現れており、テキサス州、ルイジアナ州、ウィスコンシン州をはじめとする十数州で数ギガワット規模のキャンパスが建設中であるほか、湾岸諸国、ヨーロッパ、アジアでも各国政府がAI能力を他国のデータセンターに依存させたくないという判断から、並行して国家主導の建設が進んでいます(ソブリンAIを参照)。
電力・水・送電網への影響
この建設ラッシュにおける最大の制約はチップではなく、電力です。IEAの予測によれば、世界のデータセンターの電力消費量は2030年までにおよそ倍増して約945テラワット時に達し、これは世界の総電力消費量の約3パーセントに相当します。基本シナリオでは、AI向けに最適化された「アクセラレーテッド」サーバーの電力使用量が年率約30パーセントで増加する一方、従来型サーバーは年率約9パーセントの増加にとどまるとされています。米国に限れば、今後2030年までの電力需要増加の実に半分近くをデータセンターが占めると見込まれています。
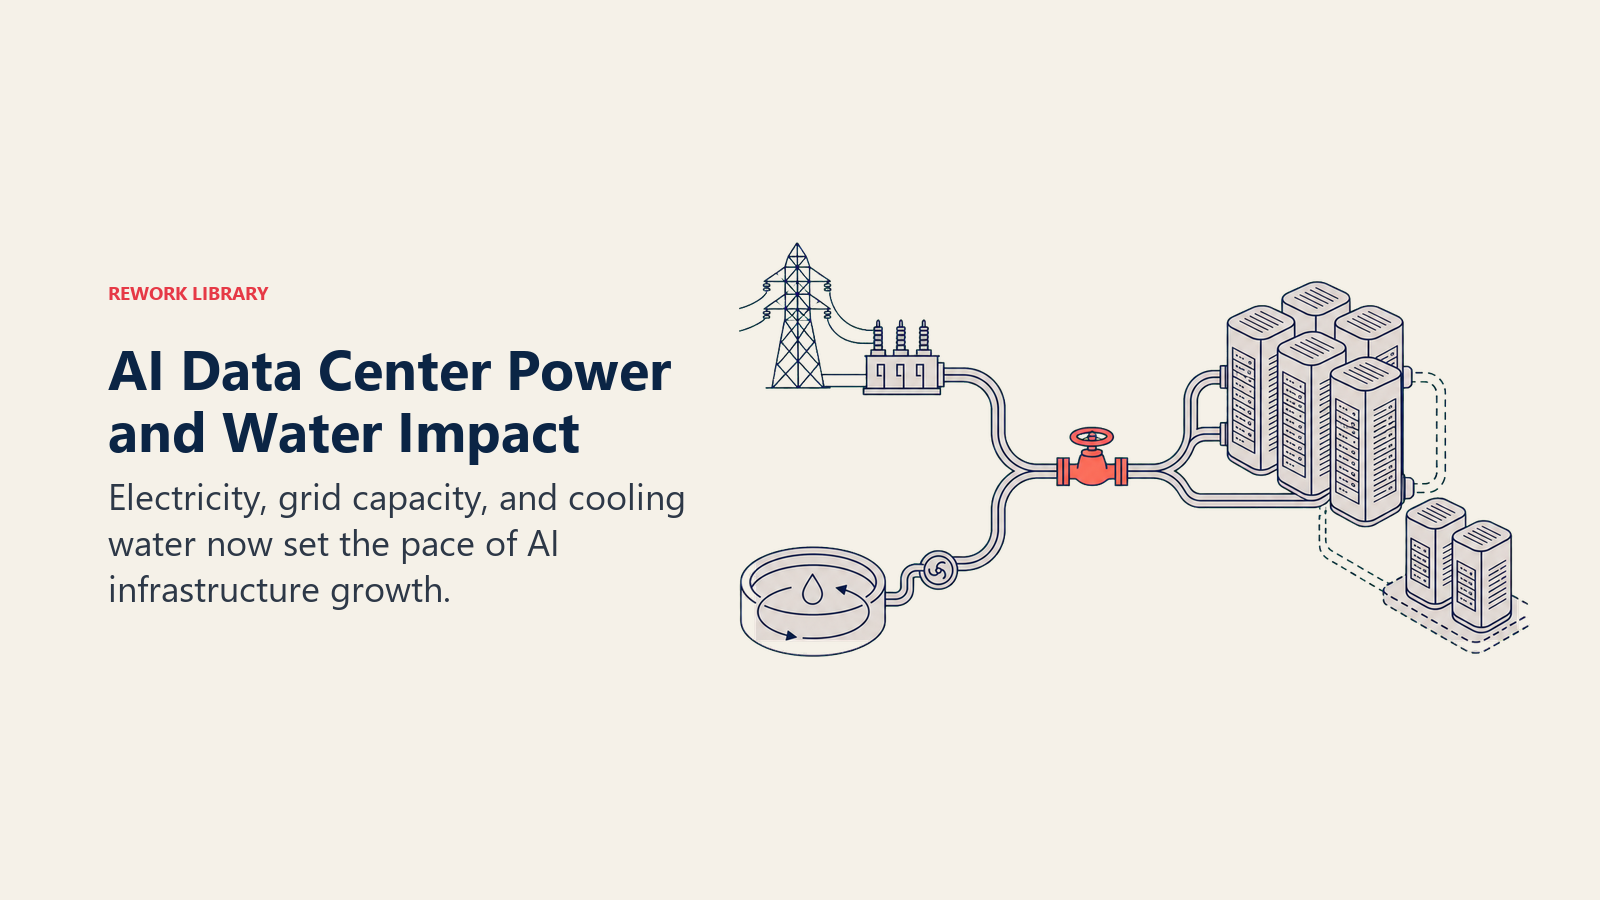
Goldman Sachs Researchも同様の傾向を示しています。世界のデータセンター電力需要は、2023年比で2030年までに約165パーセント増加すると予測されており、データセンターが世界の電力使用量に占める割合は現在の1〜2パーセントから2030年には3〜4パーセントへと拡大するとしています。米国では、その割合が2030年までに国内電力消費量の8パーセントに達する可能性があり、2022年時点の約3パーセントから上昇する見込みです。Goldmanは、この電力を供給し続けられるだけの電力システムを維持するためだけに、2030年までにおよそ7,200億ドルの送電網投資が必要になると試算しています。
McKinseyは資本面についてさらに厳しい見方を示しており、データセンターが計算需要に対応するためには、世界全体で2030年までに約6.7兆ドルの設備投資が必要になると予測しています。そのうち5.2兆ドルは、AI対応施設に特化した投資です。データセンターの総容量需要は、2030年までにほぼ3倍の219ギガワットに達する可能性があり、その新規需要のおよそ70パーセントはAIワークロードから直接生じるものです。
冷却は、電力に加えてもう一つの資源上の制約となります。高密度なGPUラックの過熱を防ぐ液冷や気化冷却システムは、大量の水を消費することがあり、これが干ばつリスクの高い地域で新しいAIキャンパスが地元の反発に直面するケースが増えている理由であり、ハイパースケーラーが水を消費するのではなく再利用する閉ループ型冷却設計に投資している理由でもあります。どれだけ資金があっても、公共料金交渉、水利権、送電網の接続待ち行列こそが、新しいAI能力が実際にどれだけ早く稼働できるかを左右する実務上のボトルネックであり続けると見ておくべきでしょう。
ビジネスリーダーにとって重要な理由
貴社がAIを購入・構築しているのであれば、これらは決して抽象的な話ではありません。データセンターの経済性は、AIツールに支払う金額、カスタムプロジェクト向けにGPU能力をどれだけ早く確保できるか、そしてどのベンダーが実際にロードマップ通り提供でき、どのベンダーが能力不足に陥っているかに直結します。押さえておくべき実務上の含意をいくつか挙げます。
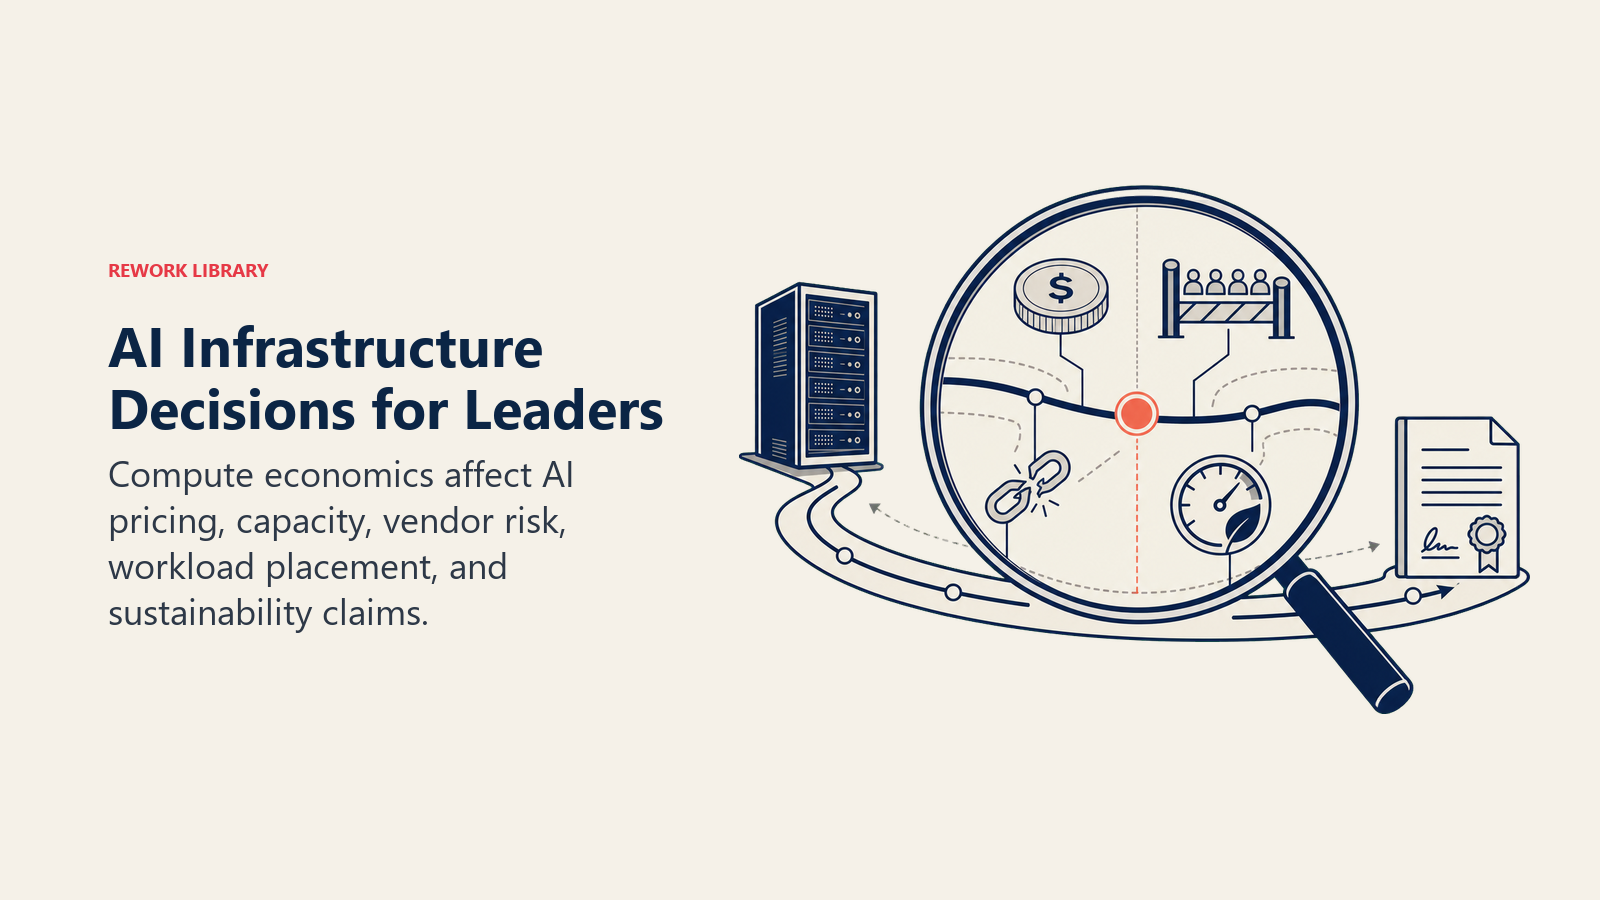
- 価格への圧力は両方向に働きます。 GPUの供給不足は当面計算資源を高価なままにしますが、同時に設備投資競争は効率向上(より優れたチップ、冷却、稼働率)も促しており、それが時間とともにAI出力単位あたりのコストを押し下げます。AIの総所有コストを試算する際は、目先の表示価格だけでなく、この両方の傾向を織り込んでください。
- ワークロードをどこで実行するかが、以前にも増して重要になっています。 レイテンシに敏感なアプリケーションは、エッジAIを通じて計算をユーザーの近くに寄せる傾向が強まっている一方、負荷の高いトレーニングやバッチ推論処理は大規模キャンパスに集中したままです。この違いを理解しておけば、「当社はAIインフラ上で稼働しています」という説明を鵜呑みにせず、ベンダーのアーキテクチャに関する主張を評価できます。
- 供給能力の制約は、現実のベンダーリスク要因です。 プロバイダーのロードマップが、自社ではコントロールできないGPUや電力の供給可能性に依存しているのであれば、それは重要なベンダー関係における他の単一障害点と同様に、直接確認する価値があります。
- サステナビリティへのコミットメントが、成長目標と衝突しています。 複数の大手プロバイダーは、データセンターの電力需要が再生可能エネルギーの整備ペースを上回ったことを受け、ネットゼロの達成時期を公式に後退あるいは緩和させています。この緊張関係は、貴社自身のレポーティングでベンダーのESGに関する主張に依拠する際に考慮する価値があります。
重要なポイント
- 世界のデータセンターの電力消費量は、2030年までにおよそ倍増して945テラワット時に達すると予測されており、これは世界の総電力消費量の約**3%**に相当します。AI向けに最適化されたサーバーの電力使用量は年率約30%で増加しています。IEA
- 米国では、今後2030年までの電力需要増加のうちほぼ半分をデータセンターが占めると見込まれています。IEA
- AIは、2023年比で2030年までに世界のデータセンター電力需要を**165%押し上げると予測されており、データセンターが世界の電力使用量に占める割合は現在の1〜2%から2030年には3〜4%へ、米国の電力消費量に占める割合は2022年の約3%から2030年には約8%**へと拡大する見込みです。Goldman Sachs
- AI主導のデータセンター電力需要を支えるためには、2030年までにおよそ7,200億ドルの送電網投資が必要になると試算されています。Goldman Sachs
- 世界全体のデータセンターは、計算需要に対応するために2030年までに約6.7兆ドルの設備投資が必要になると予測されており、そのうち5.2兆ドルはAI対応施設に特化した投資です。McKinsey
- 世界のデータセンター容量需要は、2030年までにほぼ3倍の219ギガワットに達する可能性があり、新規需要の約**70%**はAIワークロードから生じています。McKinsey
- Amazon、Alphabet、Microsoft、Metaは、2026年の設備投資見通しとして合計でおよそ7,250億ドルを示しており、これは過去最高だった2025年の4,100億ドルから約**77%**の増加です。その大部分がAIインフラに充てられています。CNBC
AIデータセンターに関するよくある質問
AIデータセンターとは、簡単に言うと何ですか。
AIデータセンターとは、GPUなどのAIアクセラレータの大規模なクラスターを中心に構築された施設であり、AIモデルを大規模に学習・実行するために特化して設計されています。通常のデータセンターとの主な違いは、電力密度、冷却方式、そして数千個のチップを一つのジョブのために連携させるネットワークにあります。
AIデータセンターは通常のデータセンターとどう違うのですか。
通常のデータセンターは、標準的なサーバーと空冷を用いて、多数の小規模で独立したリクエストを処理するために構築されています。AIデータセンターは、ラックあたりの電力をはるかに集中させ、熱を管理するために液冷や液浸冷却を用い、GPUがばらばらの機械としてではなく一つの大規模なシステムとして動作できるよう高速インターコネクトに依存しています。
なぜAIデータセンターはこれほど多くの電力を必要とするのですか。
大規模なAIモデルの学習と実行には、数千台のGPUが同時にフル稼働することが必要であり、各GPUは従来型のサーバーチップよりもはるかに多くの電力を消費します。IEAは、主にこうしたAI向けに最適化された計算資源によって、世界のデータセンターの電力需要が2030年までにおよそ倍増すると予測しています。
AIデータセンターの内部にはどのようなハードウェアがありますか。
中核となる要素は、GPUなどのAIアクセラレータ、それらのチップに隣接して積層される高帯域幅メモリ、NVLinkやInfiniBandといった高速インターコネクト、熱を管理する液冷システム、専用の電源インフラ、そしてボトルネックにならずにチップへデータを供給し続ける高速ストレージです。
現在、最も多くAIデータセンターを建設しているのはどこですか。
Amazon、Alphabet(Google)、Microsoft、Metaが最大の建設主体であり、合わせて2026年の設備投資見通しとしておよそ7,250億ドルを示しており、その大部分がAIインフラ向けです。独立系のクラウドおよびコロケーションプロバイダー、さらに湾岸諸国やヨーロッパなどにおける国家主導の取り組みも、供給能力を拡大しています。
AIデータセンターに関する環境上の懸念は何ですか。
最大の懸念は2つあります。一つは電力需要で、AI向けに最適化されたデータセンターは世界の電力消費において最も急速に伸びている要因です。もう一つは冷却のための水使用量で、液冷や気化冷却システムは、水資源が逼迫した地域にある施設において大量の水を消費する可能性があります。
AIデータセンターはAIツールのコストにどう影響しますか。
データセンターの建設、電力、冷却にかかるコストは、クラウドプロバイダーがAI計算資源に対して請求する価格の大きな要因です。GPU供給能力の不足は当面価格を高止まりさせますが、チップと冷却の効率向上が時間とともにAI出力単位あたりのコストを徐々に押し下げていきます。
AIデータセンターにおけるトレーニングと推論の違いは何ですか。
トレーニングは、モデルをゼロから構築するプロセスであり、通常は大規模なハイパースケールキャンパスで実行される極めて計算負荷の高い作業です。推論は、その学習済みモデルを実際のユーザーリクエストに応答させるために実行するもので、継続的に発生し、規模が大きくなるとトレーニング以上の総計算量を消費することもあります。
企業が独自のAIデータセンターを構築すべき場合はありますか。
ほとんどすべての企業にとって、答えは「いいえ」です。AI水準のインフラを構築・運用するには、ハイパースケーラーや専門プロバイダーだけが正当化できるほどの資本、電力アクセス、技術的専門知識が必要です。ほとんどの企業にとっては、クラウドプロバイダーから容量をレンタルし、自社の投資はその上に構築するAIアプリケーションに集中させる方が得策です。
関連するAIコンセプト
- AI推論とは? - AIデータセンターを24時間稼働させ続ける本番ワークロード
- 大規模言語モデル - これらの施設内で実際に学習される対象
- 基盤モデル - 大規模学習実行を価値あるものにする事前学習済みモデル
- モデルサービング - 学習完了後に学習済みモデルが大規模に展開される仕組み
- エッジAI - レイテンシに敏感なワークロード向けの、集中型データセンターに代わる選択肢
- 量子化 - 既存のデータセンターハードウェアからより多くの性能を引き出す重要な技術
- ソブリンAI - 各国が独自のAIデータセンター能力を構築している理由
- AIの総所有コスト - データセンターの経済性が、企業が実際にAIに支払う金額へとどうつながるか
外部リソース
- IEA: Energy and AI, Executive Summary - 2030年までの世界のデータセンター電力需要予測
- IEA: AI is set to drive surging electricity demand from data centres - 需要増加の地域別内訳
- Goldman Sachs: AI to Drive 165% Increase in Data Center Power Demand by 2030 - 電力需要、送電網投資、米国のシェアに関する予測
- McKinsey: The Cost of Compute, a $7 Trillion Race to Scale Data Centers - 設備投資と容量需要の予測
- CNBC: Tech AI spending approaches $700 billion in 2026 - ハイパースケーラー各社の2026年設備投資見通し
AI用語集の一部です。最終更新日: 2026-07-20
