AI 推論とは?本番環境でモデルを動かす
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
あるリテール企業が 6 か月かけて需要予測モデルをトレーニングします。データサイエンティストが検証し、経営陣が承認し、モデルは準備完了となります。そして本番環境に投入され、1 日に何千ものクエリを処理し、それぞれ 200 ミリ秒以内で応答し続けることを、数か月から数年にわたって求められます。それが推論です。学習済みモデルを実際のデータで継続的かつリアルタイムに動かし、実際の出力を生成するプロセスです。
AI の話題ではトレーニングが多くの注目を集めます。しかし、ビジネス価値が生まれるのは推論の場面です。そして 2026 年には、AI 予算の大半が使われる場面でもあります。トークンあたりの推論価格は 2022 年以降、桁違いに下落しましたが、利用量はそれ以上の速さで増加しているため、単価が下がり続けても推論の総支出は増え続けています。
トレーニング vs. 推論:根本的な違い
推論を理解するには、それが何でないかを理解する必要があります。トレーニングは、大量のデータにモデルをさらし、正確な出力が得られるまでパラメータを調整することでモデルを学習させるプロセスです。計算コストが高く、費用もかかり、比較的まれに実施されます。
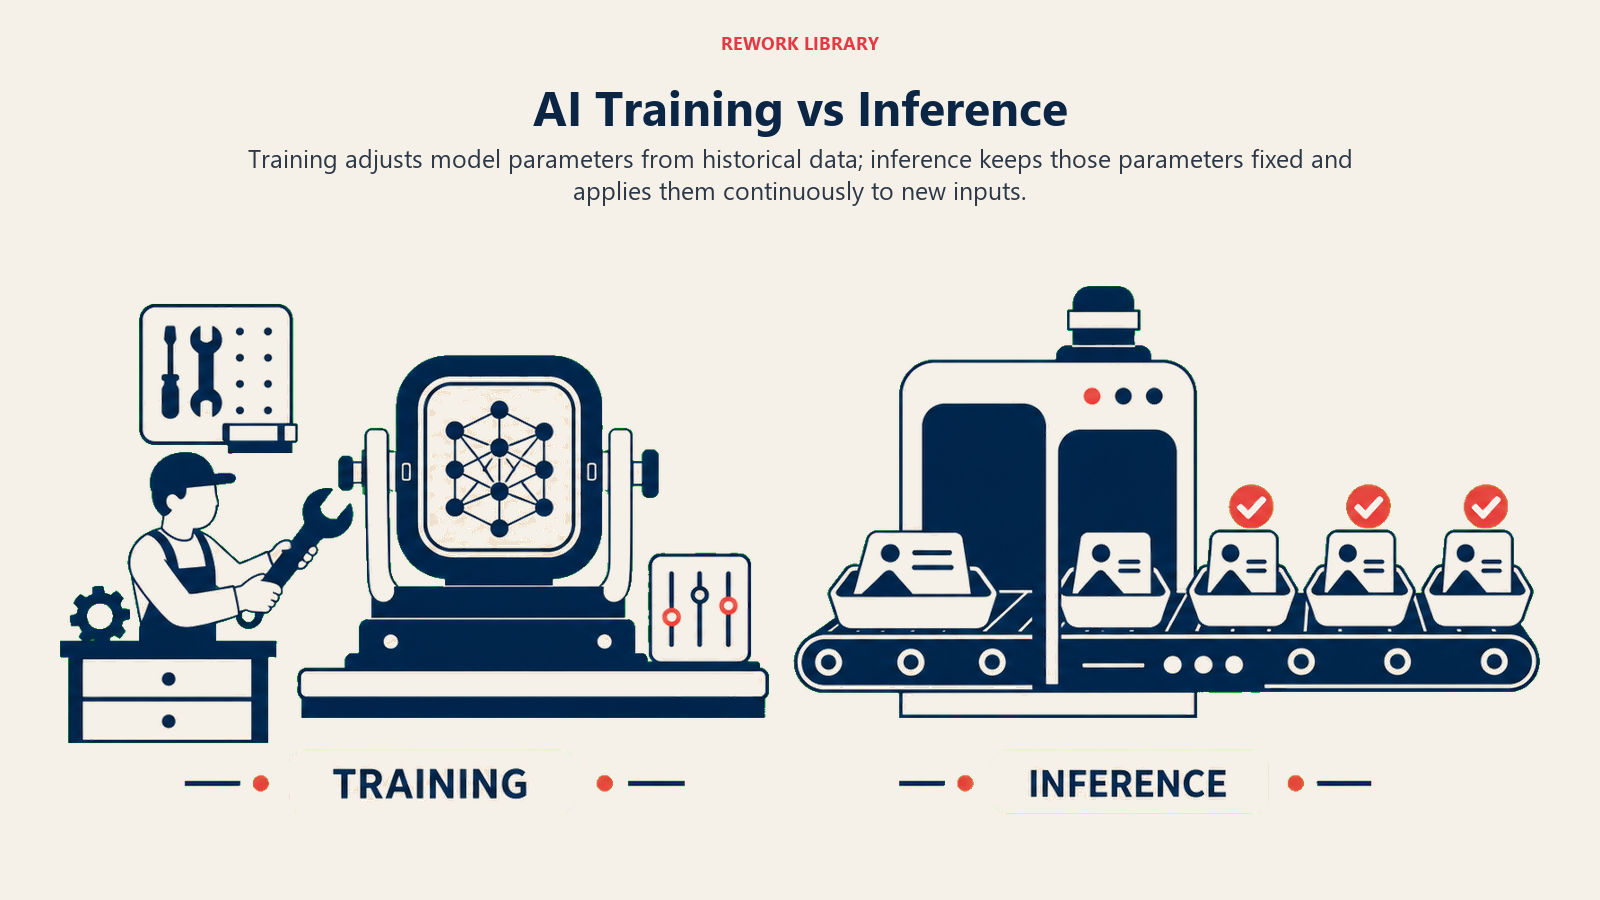
推論はその逆です。パラメータがすでに確定したモデルを新しい入力に対して実行し、予測を生成するプロセスです。推論は次のような場面で発生します。
- 顧客がチャットボットに質問を入力して回答を受け取るとき
- 不正検知システムがリアルタイムでトランザクションを評価するとき
- ドキュメント処理パイプラインがアップロードされた請求書からデータを抽出するとき
- レコメンデーションエンジンがユーザーに次に表示するコンテンツを決定するとき
トレーニングは一度(または定期的に)実施されます。推論は本番システムが求めるボリュームで継続的に実行されます。多くの企業にとって、本番環境における AI の継続的な計算コストのほぼすべてが推論から生じています。
| 観点 | トレーニング | 推論 |
|---|---|---|
| 目的 | 過去のデータでパラメータを調整し、モデルを学習させる | モデルの固定されたパラメータを、新しい未知の入力に適用する |
| 頻度 | 一度実施し、その後は再トレーニングやファインチューニングのために定期的に実施する | ユーザーやシステムがモデルに問い合わせるたびに、継続的に発生する |
| 計算パターン | 数日から数週間にわたる、持続的で大規模な並列計算 | リクエストごとの短時間のバースト。数千回から数十億回繰り返される |
| コストの形 | 大規模で初期に集中する、プロジェクト型の支出 | 継続的で、導入の拡大に応じて増える従量課金型の支出 |
トレーニングは安価でも、大規模に運用すると高価になるモデルは、ビジネス判断として誤りになりえます。トレーニングは高価でも、高ボリュームでの運用が安価なモデルは、何倍もの元が取れることがあります。実際にどのモデルが採用されるかを決めるのは、トレーニングのベンチマークではなく、たいてい推論の経済性です。
推論の仕組み
推論の際、学習済みモデルは入力(テキスト、画像、構造化データ、または音声)を受け取り、学習したパラメータを通じて処理して出力を生成します。大規模言語モデルの場合、入力はトークンに変換され、モデルは学習したアテンション機構を使用してTransformer アーキテクチャでそれらを処理し、応答が完成するまで出力トークンが逐次生成されます。応答が長いほど生成に時間がかかるのはこのためです。出力トークンごとに、モデルを通る完全な処理がもう一度必要になります。
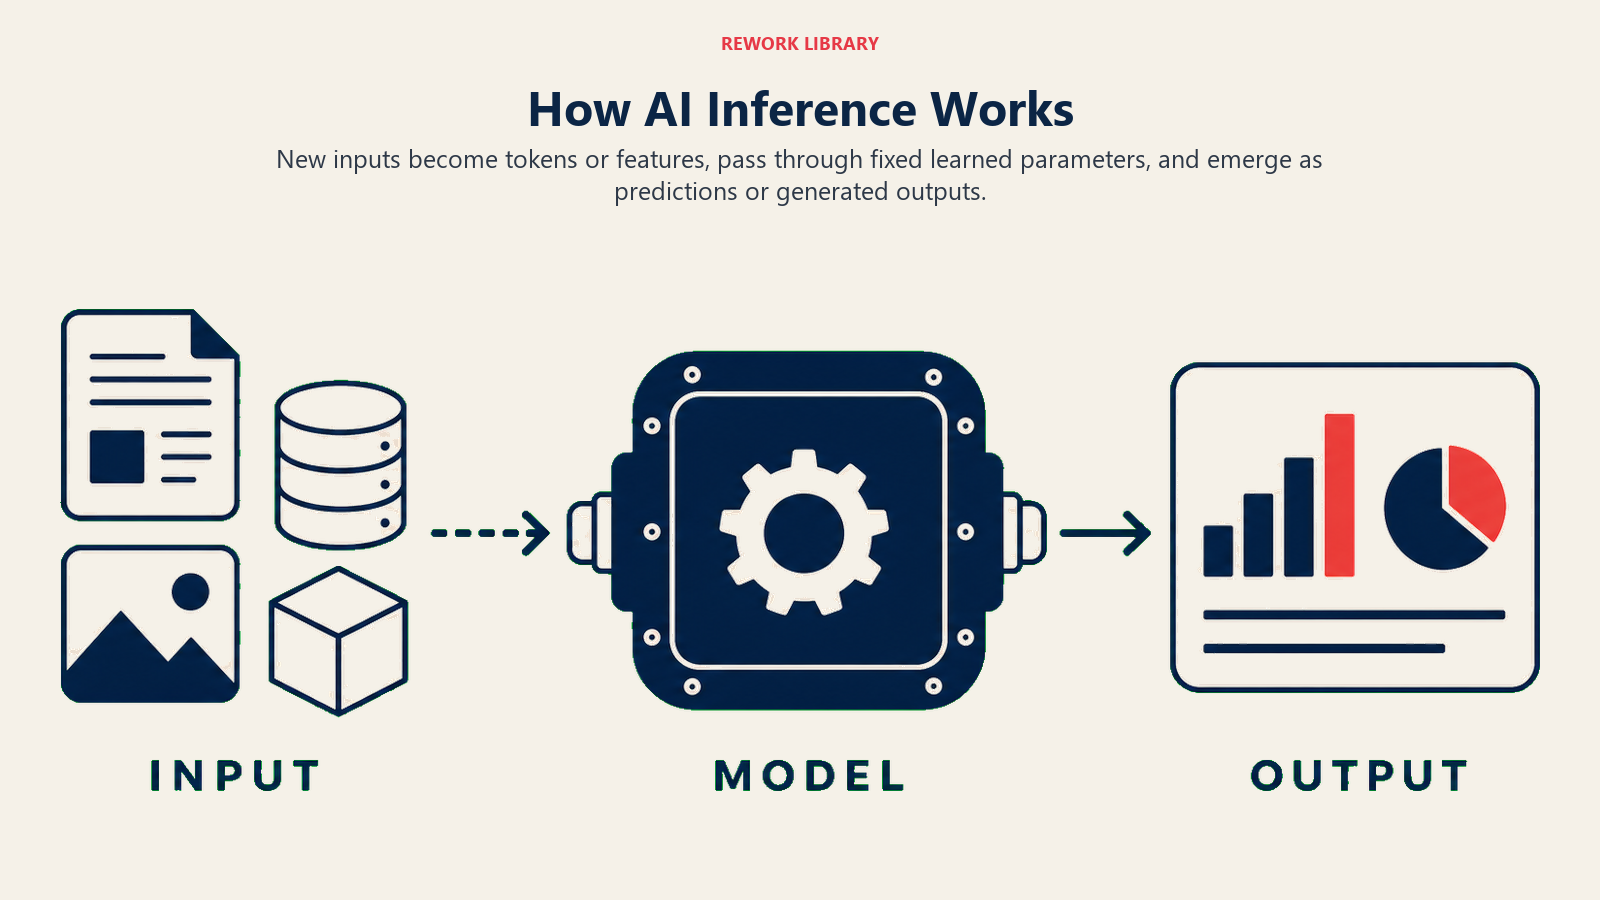
推論の間、モデルのパラメータは変化しません。モデルはクエリから学習しているのではなく、すでに学習したことを新しい入力に適用しています。この違いは実用上重要です。同じモデルが何千もの同時ユーザーを処理しても、あるユーザーが他のユーザーに影響を与えることはないのです。
推論のコストは、数十億または数千億のパラメータを持つ可能性のあるモデルを通じて入力を処理するために必要な計算から生じます。パラメータが多いほど一般的に能力が高まり、推論呼び出しごとの計算量も増えます。
パフォーマンスの 2 つの重要な次元
レイテンシは、入力から出力までの 1 回の推論呼び出しにかかる時間です。最初のトークンが出るまでの時間と、その後の各トークンを生成する時間を含みます。チャットボットの応答を待っているユーザーはレイテンシを体験しています。放射線科医が読影を待っている医療画像 AI には低レイテンシが必要です。夜間にバッチで実行されるドキュメント処理はより高いレイテンシを許容できます。
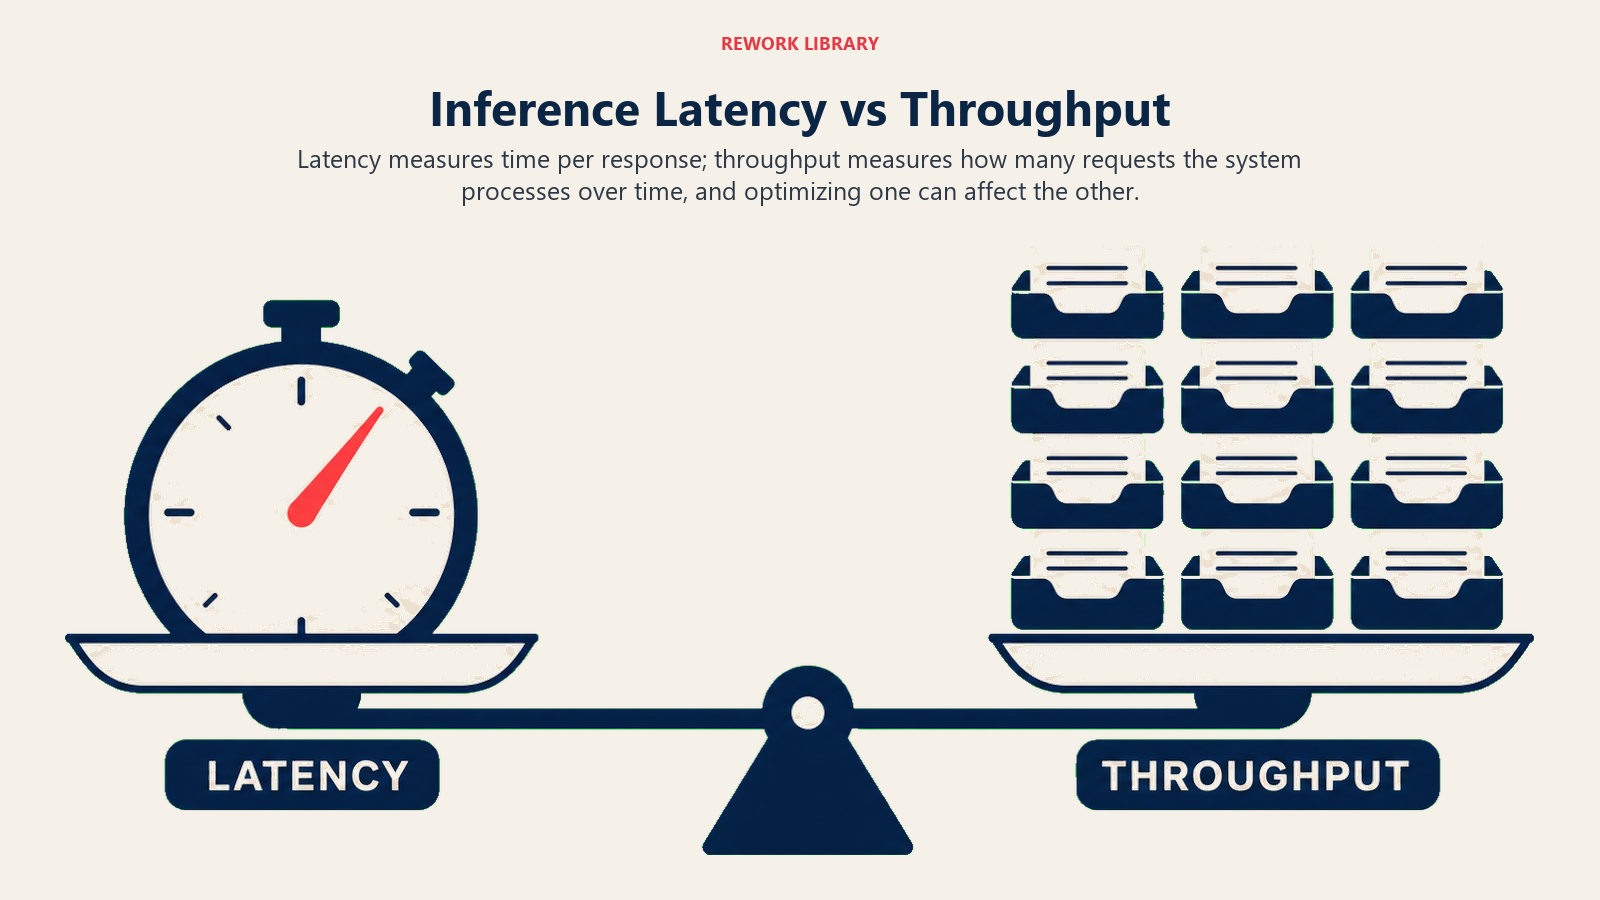
スループットは、システムが単位時間あたりに処理できる推論呼び出し数です。数百万人の買い物客を対象とする e コマースのレコメンデーションエンジンには高いスループットが必要です。20 人のアナリストチームが使用する法的ドキュメント分析ツールのスループット要件ははるかに低いです。
この 2 つの次元はしばしばトレードオフの関係にあります。例えば複数の推論リクエストをまとめてバッチ処理すると、ハードウェアが多くの入力を並列処理するためスループットは向上しますが、個々のリクエストはバッチが埋まるのを待つためレイテンシは増加します。適切なバランスはユースケースによって異なります。
推論最適化は、品質を犠牲にせずにモデルをより速く、より安価に動かすことに特化した技術分野です。
推論はどこで動くか:クラウド、エッジ、オンデバイス
推論は AI スタックの最上位に位置します。基盤モデルは AI ラボが大規模な計算クラスターを使って一度トレーニングします。企業はこれらのモデルを API 経由で呼び出すか、自社のインフラにモデルをデプロイします。その推論が実際にどこで動くかは、インフラチームに任せてよい細部ではなく、アーキテクチャ上の重要な判断です。
クラウド推論。 モデルはプロバイダーのサーバー上で動き、通常は API 経由でアクセスします。主要ラボの基盤モデルを使う多くの企業にとって、これが標準です。導入が簡単で、需要に応じて自動的にスケールし、コストが使用量に直結します。トレードオフは、呼び出しごとの継続的な課金、プロバイダーの稼働状況と価格決定への依存、そしてリクエストとデータセンターの間のネットワークレイテンシです。
セルフホスト推論。 企業が自社の GPU インフラ上で、プライベートクラウドのアカウントまたはオンプレミスでモデルを動かします。データプライバシーをより細かく制御でき、非常に高く安定したボリュームでは API 料金より安くなることがあり、ファインチューニングによるより深いカスタマイズも可能です。一方で、GPU の調達、稼働の管理、プロバイダーのような柔軟性なしでのスパイク対応といった運用負担も自社で負うことになります。
エッジおよびオンデバイス推論。 モデルはスマートフォン、ブラウザ、店舗のキオスク、産業用センサーなどローカルで動き、ネットワークの往復がまったくありません。最もレイテンシが低い選択肢であり、データがデバイスの外に出ないため、プライバシーが重要なユースケースで意味を持ちます。トレードオフは能力です。エッジデバイスはメモリと計算資源が限られるため、エッジへのデプロイでは通常、最先端規模のモデルではなく、より小さく圧縮されたモデルを使うことになります。
これらのどれかが常に正解というわけではありません。カスタマーサポートのチャットボットは、品質を重視してクラウド推論を使うかもしれません。接続が不安定な現場点検アプリは、動作させるためだけでもエッジ推論が必要かもしれません。規制の厳しいヘルスケアのワークフローは、データレジデンシーのためだけにセルフホスト推論を求めるかもしれません。
MLOpsの実践により、本番環境での推論管理が規定されます。モデルのバージョン管理とデプロイ、パフォーマンスの監視、モデルが予期せぬ動作をした際のロールバック、再トレーニングのタイミングなどです。モデル監視は、ビジネスへの影響が出る前に性能低下を検知するために、推論の出力とパフォーマンス指標を継続的に観察する実践です。
2026 年に何が変わったか
長年、AI をめぐる議論はトレーニングが中心でした。より大きなモデル、より大きなトレーニング、より大きな見出しです。しかし、もはやお金やリスクの所在はそこではありません。推論は、本番環境における AI の運用面と財務面の重心になっています。その理由は、相互に関連する 3 つです。
利用量は、呼び出しあたりのコストが下がる速さを上回って増え続けています。推論価格は 2022 年後半以降、劇的に下がりましたが、導入はそれ以上の速さで拡大しているため、単価が縮小しても推論の総支出は増え続けています。
推論は継続的に発生しますが、トレーニングはそうではありません。トレーニングは始まりと終わりのあるプロジェクトです。推論は、デプロイされた機能が存続する限り続き、成功した製品であれば何年にもなります。1 回あたりは小さく見えるコストも、毎日数百万件のリクエストが無期限に続けば、無視できない額になります。
インフラプロバイダーはすでに、それを前提に作り替えています。アナリストは、今後数年のうちに推論ワークロードが AI データセンターの主要な需要としてトレーニングを上回ると予測しており、ハイパースケーラーはその結果として、キャパシティを構築する方法と場所を変えています。トレーニング用クラスターは遠隔の電力密度の高い拠点へ、推論用キャパシティはネットワークレイテンシを減らすため、ユーザーの実際の所在地により近い場所へ移りつつあります。
AI の取り組みを後押しするリーダーにとっての実際的な帰結はこうです。トレーニングのベンチマークで勝つモデルが、そのまま出荷すべきモデルとは限りません。AI 機能が持続可能な製品になるか、高価なパイロットで終わるかを決めるのは、実際の本番ボリュームで推論の経済性が成り立つモデルです。
Key Facts
- GPT-3.5 レベルの性能を持つモデルへの問い合わせコストは、2022 年 11 月から 2024 年 10 月の間に、100 万トークンあたり 20.00 ドルから 0.07 ドルに下がりました。約 18 か月で 280 倍以上の低下であり、Stanford AI Index 2025 レポートによるものです。
- 一定の性能水準における LLM の推論価格は、年間およそ 50 倍の中央値で低下しており、2024 年 1 月以降のデータでは年間約 200 倍に加速しています。Epoch AI による推論価格の動向分析に基づきます。
- 推論は 2030 年までに AI の主要な計算ワークロードとしてトレーニングを上回り、AI 計算全体の半分超、データセンター需要全体の 30〜40% を占めると予測されています。McKinsey による AI ワークロードの変化の分析によるものです。
- 大企業の 49% が、2025 年にはコンピューティングの大半またはほぼすべてが推論主導だと回答し、前年の 29% から上昇しました。Menlo Ventures の 2025 年中間 LLM 市場アップデートによるものです。
- Anthropic の 2025 年の支出には、総費用 97 億ドルのうち、推論の計算に約 27 億ドル、R&D(トレーニング)の計算に 41 億ドルが含まれていました。The Information の報道に基づく、Epoch AI による AI 企業の支出分析によるものです。
- 世界の AI 推論市場は、2025 年の 1,061.5 億ドルから 2030 年には 2,549.8 億ドルに成長し、企業 AI における主要な費用区分としてトレーニングを上回ると予測されています。Forbes が引用した MarketsandMarkets の調査によるものです。
推論のビジネスコスト
AI を大規模に活用する組織にとって、推論コストは重要な予算項目です。コストの主な要因は以下の通りです。
モデルサイズ。モデルが大きいほど推論呼び出しごとの計算量が増えます。700 億パラメータのモデルは 70 億パラメータのモデルの約 10 倍のコストがかかりますが、ユースケースによっては品質の違いがコストを正当化することもあります。
リクエスト量。推論コストは使用量に比例してスケールします。1 日 1,000 万回の推論を処理するシステムは、1 万回処理するシステムに比べて比例的に高いコストがかかります。
ハードウェア。GPU 推論は CPU 推論より高速ですが高コストです。特化した推論チップ(Google の TPU や AWS Inferentia など)は特定のワークロードのコスト効率を向上させることができます。
コンテキストウィンドウのサイズ。言語モデルでは、推論コストがトークン数に比例するため、長い入力ほど処理コストが高くなります。各呼び出しで大量のコンテキストを渡すシステムは比例的に高いコストに直面します。
推論コストは使用量に直接比例してスケールするため、製品の範囲に手を加えずに AI の支出を削減できる、最もレバレッジの高い領域です。主な最適化技術は次のとおりです。
量子化。 モデルの重みの数値精度を、たとえば 32 ビット浮動小数点から 8 ビットや 4 ビットの整数に下げることで、モデルのメモリ使用量が縮小し、計算が高速になります。通常、精度の低下はわずかです。仕組みは量子化をご覧ください。
蒸留。 大きな「教師」モデルの出力を模倣するよう、より小さな「生徒」モデルをトレーニングします。結果として、蒸留の対象としたタスクでは教師の能力の大部分を保ちながら、より速く、より安価に動きます。
バッチ処理。 複数の推論リクエストをまとめ、ハードウェアが 1 件ずつではなく並列で処理できるようにします。個々のリクエストはバッチが埋まるのを待つため、レイテンシはやや増えますが、スループットは大幅に向上します。
キャッシング。 よくある、または繰り返されるクエリの出力を保存し、モデルが同じ入力を二度処理しなくて済むようにします。繰り返しのトラフィックが多いアプリケーションでは、キャッシングによって推論呼び出しの大部分をそもそも不要にできます。
投機的デコーディング。 小さく高速な「ドラフト」モデルが数トークン先を予測し、大きなモデルが 1 回の処理でそれを検証します。大きなモデルが 1 トークンずつ単独で生成する必要はありません。ドラフトモデルの予測が当たれば、応答の生成に必要な高コストの全モデル処理の回数が減ります。
本番システムの多くは、これらの技術を複数同時に組み合わせます。どれも、根本的に異なるモデルや品質の低いモデルへの切り替えを必要としません。既存のモデルをどれだけ効率よく提供するかを変えるものです。これらを体系的に適用している組織では、最適化していない構成と比べて、50〜90% のコスト削減が一般的に報告されています。
リアルタイム推論 vs. バッチ推論
すべての推論がリアルタイムで行われるわけではありません。多くの価値ある AI アプリケーションは、ライブリクエストへの応答ではなくバッチスケジュールで実行されます。
リアルタイム推論はリクエストが届いた瞬間に処理し、ミリ秒から秒単位のレイテンシで応答します。チャットボット、不正検知、リアルタイムパーソナライゼーション、音声アシスタントはすべてこのモードを必要とします。
バッチ推論は大規模なデータセットをスケジュールに従って処理します。多くは夜間またはオンデマンドで実行されます。毎晩すべてのリードをスコアリングする CRM エンリッチメント、アップロードされたファイルのキューを処理するドキュメント処理、週次レポートを生成する分析ワークロードはいずれもバッチパターンに当てはまります。バッチ推論は一般的に推論呼び出しあたりの費用が安く、ユーザー向けのレイテンシ要件という制約なしに効率的なバッチ戦略を活用できます。
モード間の選択は技術的な問題だけでなく、製品とアーキテクチャの判断です。当初はリアルタイム推論が必要に見える多くのユースケースが、ビジネス価値を大きく失わずに準リアルタイムやバッチとして再設計でき、コストを大幅に削減できることがあります。
ビジネスリーダーが理解すべきこと
最も注目される AI 用語、トレーニングデータ、モデルアーキテクチャ、ベンチマークスコア、はすべてモデルの潜在能力に関するものです。推論は、その潜在能力がビジネス成果に結びつくかどうかが決まる場面です。推論の仕組みから直接導かれる 3 つの実務上の帰結があり、いずれも AI のデプロイを承認した後ではなく、承認する前に、リーダーのチェックリストに入れておくべきものです。
コストは成功に比例して増え、それは両刃の剣です。トレーニングコストは、プロジェクトが終われば概ね固定されます。推論コストは導入に直接比例して上がります。機能が役に立つほど利用され、運用コストも増えます。50 人のユーザーでのパイロットなら手頃に見える機能も、5 万人のユーザーになれば、無視できない予算項目になりえます。
レイテンシは、人々が実際にその機能を使うかどうかを決めます。ユーザーは AI 機能の応答速度に合わせて行動を変えます。数秒以上かかる対話型ツールは、利用が減っていくのが通例で、遅い機能を避けることを覚えたユーザーは、改善された後でも戻ってこないことがよくあります。
推論がどこで動くかは、誰がデータを見られるかに影響します。サードパーティの API を通じたクラウド推論では、リクエストと、そこに含まれるあらゆるコンテキストが自社の環境の外に出ます。規制の厳しいワークロードや機密性の高いワークロードでは、それが受け入れられないこともあります。運用コストが高くなっても、セルフホストやエッジ推論という代替手段が存在するのはそのためです。
AI ベンダーや開発オプションを評価する際には、想定ボリュームでの推論呼び出しあたりのコスト、実際の本番負荷でのレイテンシ、使用量に応じた推論コストのスケールの仕方、そしてモデルの実行時にデータが実際にどこへ送られるかについて確認してください。それらが AI ユースケースの経済的持続可能性を決定する数値です。
関連する AI 概念
- 推論最適化 - 推論をより速く安価にする技術
- MLOps - モデルのデプロイと推論パイプラインの管理
- エッジ AI - クラウドの代わりにローカルハードウェアで推論を実行する
- モデル監視 - 時間をかけて推論パフォーマンスを追跡する
- レイテンシ - 応答時間が、AI 機能が本番環境で採用されるかどうかを左右する理由
- コンテキストウィンドウ - 言語モデルの推論コストの主要な要因
- Transformer アーキテクチャ - 現代の多くのモデルが推論を計算する仕組み
- 量子化 - モデルサイズを削減して推論コストを下げる
- 大規模言語モデル - 推論に関する議論の多くが中心とするモデルカテゴリ
- 基盤モデル - 企業が API やセルフホストを通じて推論を実行するベースモデル
外部リソース
- NVIDIA Inference Platform - 大規模モデル推論の業界標準インフラ
- Hugging Face Inference Endpoints - 本番モデルサービングと推論トレードオフのガイド
- Google AI Inference Best Practices - 推論アーキテクチャと最適化の実践ガイド
AI 推論についてよくある質問
AI 推論とは何ですか?
AI 推論とは、学習済みの機械学習モデルを新しい入力に対して実行し、予測や出力を生成するプロセスです。AI の本番フェーズであり、過去のデータでトレーニングされたモデルをライブデータに適用して価値を創出します。顧客の質問への回答、リードのスコアリング、不正検知、文書生成などがその例です。
トレーニングと推論の違いは何ですか?
トレーニングは大規模なデータセットにモデルをさらしてパラメータを調整することでモデルを学習させるプロセスです。推論はそのパラメータを変えずに、学習済みモデルを新しい入力に対して実行することです。トレーニングはまれに実施され、大規模な計算を必要とします。推論は本番ボリュームで継続的に発生し、継続的な AI インフラコストのほとんどを占めます。
多くの企業で、推論の管理がトレーニングより負担になっているのはなぜですか?
トレーニングは一度きり、または時折発生するプロジェクトコストです。推論は、機能を何人が、どれだけの頻度で使うかに直接比例して増える継続的なコストです。導入が進むにつれて、1 回あたりのコストが下がり続けていても、推論への支出は増えていきます。2025 年の複数の業界レポートでは、大企業でも AI ネイティブのスタートアップでも、推論が継続的な AI 計算支出の大半を占めるようになっていることが分かっています。
推論のレイテンシがビジネスにとって重要なのはなぜですか?
レイテンシは AI を活用したエクスペリエンスがユーザーにとってどれほど応答性が高いかを決定します。チャットボット、リアルタイムレコメンデーション、音声アシスタントなど顧客向けアプリケーションは、ユーザーを苛立たせないために低レイテンシが必要です。従業員が使用する社内ツールは一般的にレイテンシへの許容度が高いです。レイテンシ要件を正確に定義することは、推論アーキテクチャの意思決定において重要な部分です。
推論はクラウドで動かすべきですか、それともオンデバイスですか?
レイテンシの要件、データの機密性、ボリュームによって異なります。クラウド推論は導入が最も簡単で自動的にスケールするため、多くのビジネスアプリケーションに適しています。オンデバイスやエッジ推論はネットワークレイテンシをなくし、データをローカルに保つため、プライバシーが重要なユースケースや接続が限られたユースケースで意味を持ちますが、通常は、より小さく能力の低いモデルが必要になります。
AI 推論は常にリアルタイムですか?
いいえ。リアルタイム推論は、チャットボット、不正検知、ライブのパーソナライゼーションが必要とする、リクエストが届いた瞬間に応答する方式です。バッチ推論は大量のデータをスケジュールに従って、多くは夜間に処理し、ライブのレイテンシ要件を満たす必要がないため、通常は 1 回あたりが安くなります。リアルタイム推論が必要に見える多くのワークロードは、ビジネス価値を実質的に失うことなく、バッチや準リアルタイムで実行できます。
組織はどのように推論コストを削減できますか?
主な手段は、品質が許す範囲で小さいモデルを使用すること、量子化によりモデルサイズを削減すること、大きなモデルから小さなモデルを蒸留すること、レイテンシの制約が許す範囲でリクエストをバッチ処理すること、一般的な応答をキャッシングすること、そして言語モデルに投機的デコーディングを使うことです。推論最適化は独自の技術分野であり、多くの組織は基盤モデルを変えることなく体系的な最適化によって 50〜90% のコスト削減を実現しています。
