LLMOpsとは?大規模言語モデルを本番環境で運用するために
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
LLMOpsとは、大規模言語モデル(LLM)アプリケーションを本番環境で展開、監視、保守するための運用手法の総称です。プロンプト管理、評価、検索パイプライン、コストとレイテンシの監視、安全ガードレールを含み、デモでうまく動くときだけでなく、リリース後もLLM機能を安定して動かし続けるための作業を指します。
金曜日のデモで正しく質問に答えるプロトタイプと、1日5万人のユーザーに耐える機能とでは、エンジニアリング上の課題がまったく異なります。モデルは同じでも、その周辺、つまりプロンプトをどうバージョン管理するか、品質をどう測定するか、不適切な回答を顧客の目に触れる前にどう捕捉するかは同じではありません。この周辺の規律がLLMOpsです。
LLMOpsが独立した分野として存在する理由
すでにMLOpsを運用しているチームから、なぜLLMには別のプレイブックが必要なのかと聞かれることがあります。答えは、LLMアプリケーションは従来のMLモデルとは異なる壊れ方をし、従来のMLツールはそれを検出するようには作られていないからです。
チャーン予測や不正スコアリングのような古典的なMLモデルは、構造化された入力を受け取り、数値を返します。ユニットテストも書けます。入力Xに対して、出力はYに近いはず、というように。一方LLMは、非構造化テキスト(プロンプト)を受け取り、非構造化テキスト(回答)を返します。照合できる唯一の正解はありません。同じ質問を2回しても、どちらも妥当な2つの異なる回答が返ってくることがあります。品質はバイナリではなく確率的です。
LLMアプリケーションには、古典的なMLには存在しない障害モードもあります。ベンダーがモデルを更新した途端に静かに壊れるプロンプトテンプレート、誤ったドキュメントを返したのにモデルがそれをもとに自信満々に答えてしまう検索ステップ、すべてのリクエストで実行されるシステムプロンプトに誰かが1段落足したことによるコストの急増などです。これらは学習時の指標には現れません。本番環境で、しかもたいてい静かに現れます。まさにAIオブザーバビリティが検出するために存在する種類の問題です。
LLMOpsのライフサイクル
LLMOpsは1つのツールでも1つのステップでもありません。LLM機能がリリースされた後、継続的に回り続ける、互いにつながった一連の手法です。
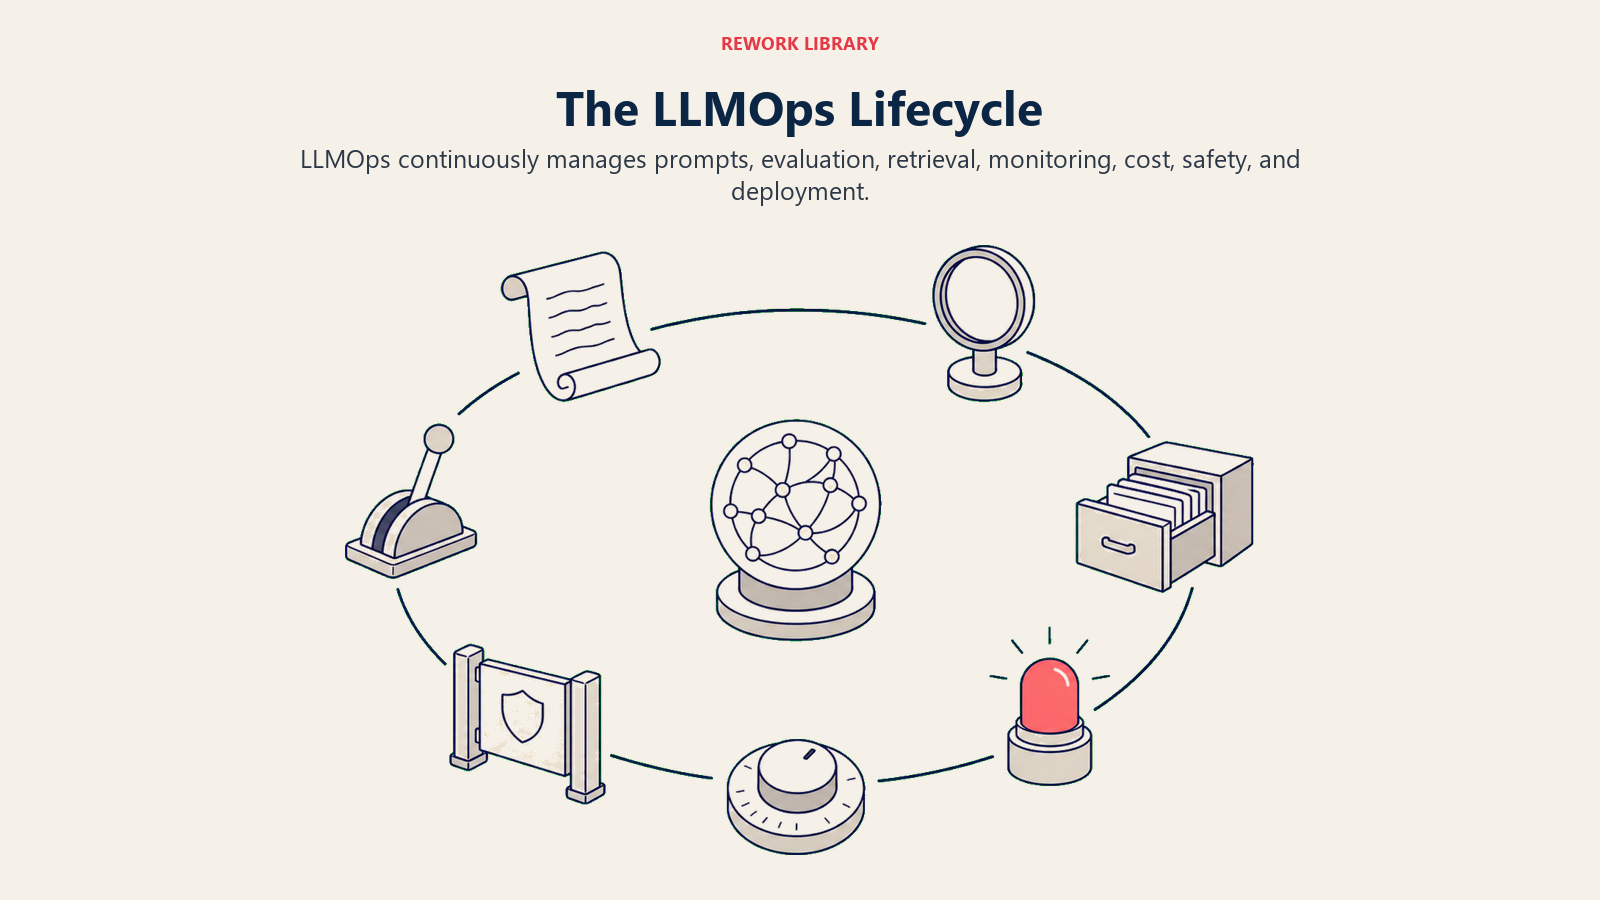
プロンプト管理。 プロンプトはアプリケーションとモデルの接点であり、コードと同じ規律が必要です。バージョン管理、変更レビュー、ロールバックです。あるモデルバージョンでうまく動くプロンプトが、次のバージョンでは劣化することがあります。どのプロンプトバージョンがどのモデルバージョンとともにリリースされ、どちらかが変わったときに出力品質がどうなったかを誰かが追跡していなければ、劣化は静かに進みます。
評価。 LLMの出力は単純なアサーションでは確認できないため、チームは評価セットを作ります。代表的な入力と、採点された期待動作を組み合わせたもので、自動スコアラー、リファレンスモデル、人間の評価者が採点します。評価は、プロンプトやモデルの変更をリリースする前(リグレッションの検出)と、本番環境で継続的に(ドリフトの検出)実行されます。評価セットがなければ、「この変更でプロダクトは良くなったのか悪くなったのか」は推測にすぎません。
RAGパイプライン管理。 ビジネス向けのLLMアプリケーションの多くは、モデルが学習中に記憶した内容に頼るのではなく、retrieval-augmented generationを使って回答を社内データに基づかせています。LLMOpsは、そのパイプラインの検索側も対象とします。ナレッジベースを最新に保つこと、検索品質(単に何かのドキュメントではなく、正しいドキュメントを見つけているか)を監視すること、検索には成功したのにモデルが取得したコンテキストを無視するケースを捕捉することです。
モニタリングとオブザーバビリティ。 本番のLLMシステムには、すべてのプロンプトと回答のログ、複数ステップのチェーンのトレース、レイテンシ、エラー率、出力品質の経時的な指標が必要です。これはAIオブザーバビリティ全般で使われる3本柱の規律を、プロンプト、トークン、モデル呼び出しに特化して適用したものです。
コストとレイテンシの管理。 すべてのLLM呼び出しにはトークン単位のコストと応答時間のコストがあり、どちらも利用量に応じて直接増えます。LLMOpsは、リクエストあたりのコスト、機能あたりのコスト、レイテンシのパーセンタイルを追跡し、キャッシュ、プロンプトの圧縮、モデルルーティング(簡単なクエリは安価なモデルへ、難しいクエリは最先端モデルへ振り分ける)といった手法で、トラフィックが増えても両方を抑制します。
ガードレールと安全性。 本番のLLMアプリケーションには、回答がユーザーに届く前に実行されるチェックが必要です。有害なコンテンツのフィルタリング、プロンプトインジェクションの試みの検出、機密データを漏えいする出力のブロック、想定された用途からモデルが逸脱しないようにする制御などです。ガードレールは、モデルの生の出力と、それを読む人との間にある最後の防衛線です。
デプロイとバージョニング。 新しいプロンプト、新しいモデルバージョン、新しい検索インデックスの展開には、他の本番ソフトウェア変更と同じ段階的なロールアウトの規律が必要です。カナリアリリース、現行バージョンとのA/B比較、評価スコアやユーザー向け指標が悪化した際の迅速なロールバック経路です。
LLMOpsとMLOpsの違い
LLMOpsはMLOpsから生まれたもので、両者は多くの共通点を持っています。どちらもバージョニング、監視、信頼性の高いデプロイを重視します。しかし運用対象が大きく異なるため、実践は特定の点で分かれます。
| 観点 | MLOps | LLMOps |
|---|---|---|
| 中心となる成果物 | 出力が固定された数値である学習済みモデル | プロンプトとモデルの組み合わせ(多くは自社で学習したものではなく、サードパーティのAPI) |
| 品質チェック | ラベル付きテストセットに対する精度、適合率、再現率 | 自動スコアラー、リファレンスモデル、人間の評価者が採点する評価セット |
| 主な障害モード | データドリフト、モデルの劣化、経時的な精度低下 | ハルシネーション、プロンプトのリグレッション、検索の失敗、ベンダーによる静かなモデル変更 |
| バージョン管理の対象 | モデルの重み、学習データ、特徴量パイプライン | プロンプトテンプレート、検索インデックス、モデルバージョン、そして3つの組み合わせ |
| コストの要因 | 学習用の計算資源(大部分が先行投資で、その後は定期的な再学習) | 推論(継続的に発生し、利用量とAPI呼び出し数に直接比例) |
| 典型的な展開形態 | 自社でモデルを学習して所有する | 他社のモデルをAPI経由で呼び出し、その周辺をすべて運用する |
実務上のポイントは次のとおりです。すでにMLOpsを運用しているチームなら、ゼロからのスタートではありません。ただし、チャーンモデル向けに作られたMLOpsパイプラインでは、プロンプトのリグレッションや検索の失敗は検出できません。そもそもそれらを探すようには作られていないからです。
LLMOpsツールの全体像
このツールカテゴリはまだ若く、統合が進行中ですが、本番のLLMスタックでは数種類のツールが一般的になっています。
オブザーバビリティとトレーシングのプラットフォーム(LangSmithやLangfuseなど)は、プロンプト、検索呼び出し、モデルの回答を通過するリクエストの全トレースを記録します。これにより、システムが見たものと返したものをそのまま再生して、特定の不適切な出力をデバッグできます。
評価とモニタリングのプラットフォーム(Arizeなど)は、オフライン評価(変更のリリース前)と本番モニタリング(ドリフト、品質スコア、ライブトラフィックの異常検知)の両方を扱い、同じプラットフォームで従来のMLとLLMのワークロードを両方カバーすることも多くあります。
実験管理ツール(Weights and Biasesなど)は、もともと古典的なMLの学習実行向けに作られましたが、プロンプトやLLMの実験管理にも拡張されており、ログされた指標とともにプロンプトのバリエーションやモデルバージョンを並べて比較できます。
ほとんどのチームは、これらすべてを一度に導入するわけではありません。よくある出発点は、すべてのLLM呼び出し(プロンプト、回答、モデルバージョン、トークン数、レイテンシ)の構造化ログです。次に、本番トラフィックの量が手動レビューを非現実的にした段階で専用のオブザーバビリティプラットフォームを重ね、さらに代表的な評価セットを作れるだけのログデータが溜まったら、体系的な評価を加えます。LLMオブザーバビリティプラットフォームの比較では、12のプラットフォームを実際のトレース量で価格比較しています。
重要な事実
- Gartnerは、AIを導入する組織の40%が2028年までに、モデルの性能、バイアス、出力を監視するための専用のAIオブザーバビリティツールを利用するようになると予測しています(AIオブザーバビリティ導入に関するGartnerのプレスリリースによる)。
- Gartnerは、generative AIプロジェクトの少なくとも30%が、データ品質の低さ、不十分なリスク管理、コストの増大、不明確なビジネス価値を理由に、2025年末までにプルーフ・オブ・コンセプト後に断念されると予測しています。
- 経営幹部の74%がAI導入による初年度のROIを報告している一方、企業レベルでEBITへの影響を報告しているのは39%にとどまります(AIのパイロットと拡大の間のギャップに関するMcKinseyのState of AI調査による)。
- 企業のgenerative AIソフトウェア支出は2025年に370億ドルに達し、2024年の115億ドルから3.2倍に増加しました(Menlo Venturesの2025 State of Generative AI in the Enterpriseレポートによる)。
- 真の自律型エージェントに該当する企業のAI導入はわずか16%で、本番システムの大半は依然として、単一のモデル呼び出しを中心とした固定シーケンスまたはルーティング型のワークフローです(同じMenlo Venturesのレポートによる)。
- 現在、企業の37%が本番環境で5つ以上のモデルを使用しており、前年の29%から増加しています(a16zの2025年企業AIレポートによる)。これは、LLMOpsがますます管理を求められるマルチモデルのオーケストレーションの兆候です。
LLMOpsが企業のAIに重要な理由
動くデモと本番グレードのLLM機能との間のギャップは、企業のAIの取り組みの多くが停滞するまさにその場所です。generative AIプロジェクトの30%がプルーフ・オブ・コンセプトの後に断念されるというGartnerの予測と、導入の大半が成熟したエージェント型システムではなく依然として単純な単一モデルのワークフローであるというMenlo Venturesの調査結果は、どちらも同じ根本的な問題を指しています。モデル呼び出しを作ること自体は簡単な部分です。それを、予測可能なコストと許容できるリスクで、大規模かつ確実に運用することが、パイロットとプロダクトを分ける部分なのです。
McKinseyが示すROIのギャップが現れるのもここです。経営幹部の74%が初年度に何らかのリターンを報告する一方、企業レベルでの影響を実感しているのは39%にすぎません。これは、運用レイヤーなしにLLM機能をリリースしたチームに起こることと一致しています。最初の数百人のユーザーまでは動きますが、その後プロンプトの更新で静かに壊れたり、利用拡大とともにコストが急増したり、顧客から苦情が来るまで誰も出力品質の低下に気づかなかったりします。LLMOpsは、実際の利用に耐えるAI機能と、半年後にひっそりと撤回せざるを得なくなる機能との違いです。
マルチモデル化の流れはさらに別のレイヤーを加えます。a16zは、企業が1つのモデルに賭けるのではなく、本番環境で5つ以上のモデルを稼働させる傾向が強まっていることを明らかにしました。日常的なタスクは安価なモデルへ、より難しい推論には最先端モデルを充てる使い分けです。このルーティングの判断と、それに必要なコストと品質の追跡は、それ自体がLLMOpsの機能です。LLMアプリケーションが単一のプロンプトからRAGパイプライン、そして複数ステップのエージェント型ワークフローへと複雑になるにつれ、運用の対象範囲も広がります。LLMOpsを後回しにするチームは、問題をユーザーから知らされることになりがちです。最初から組み込むチームは、サポートチケットになる前に、自分たちのモニタリングで気づくことができます。
LLMOpsに関するよくある質問
LLMOpsとは何ですか?
LLMOpsは、大規模言語モデルアプリケーションを本番環境で展開、監視、保守するための運用手法の総称です。プロンプト管理、評価、RAGパイプライン管理、オブザーバビリティ、コストとレイテンシの制御、安全ガードレールを含み、LLM機能をリリース後も安定して動かし続けるために必要な作業を指します。
LLMOpsはMLOpsとどう違いますか?
MLOpsは、数値で確認できる出力を持つ学習済みモデルを対象とし、データドリフトとモデルの劣化に重点を置きます。LLMOpsは、プロンプトとモデルの組み合わせ(多くは自社学習ではなくAPI経由で利用)を対象とし、プロンプトのリグレッション、ハルシネーション、検索の失敗に重点を置きます。LLMOpsはMLOpsのバージョニングと監視に関する規律を借りながら、異なる障害モードに適用します。
始めるのに専用のLLMOpsツールは必要ですか?
初日から必要というわけではありません。多くのチームは、既存のシステムで、すべてのLLM呼び出し(プロンプト、回答、モデルバージョン、トークン数、レイテンシ)の構造化ログから始めます。LangSmith、Langfuse、Arize、Weights and Biasesなどの専用プラットフォームは、本番トラフィックの量が手動レビューを非現実的にしたとき、あるいは大規模な体系的評価が必要になったときに価値を発揮します。
プロンプトの評価セットとは何で、なぜ重要ですか?
評価セットとは、代表的な入力と、採点された期待動作を組み合わせたもので、自動スコアラー、リファレンスモデル、人間の評価者が採点します。LLMの出力は、従来のソフトウェアのように単純な合否のアサーションでは確認できないため、プロンプトやモデルの変更がプロダクトを良くしたのか悪くしたのかを、リリース前に確認する手段が評価セットです。
RAGはLLMOpsにどう関わりますか?
Retrieval-augmented generationは、モデルが回答を生成する前に検索ステップを加え、回答を社内データに基づかせます。LLMOpsは、その検索パイプラインを健全に保つことを担います。システムが正しいドキュメントを見つけているかの監視、モデルが良好な検索コンテキストを無視するケースの捕捉、基盤となるナレッジベースの最新性の維持です。
実際のユーザーに届いた後、LLMアプリケーションが失敗する主な原因は何ですか?
よくある原因は、ベンダーのモデル更新後のプロンプトのリグレッション、誤ったコンテキストを返す検索パイプライン、監視されていないトークン使用量によるコストの急増、継続的な評価がないために気づかれない品質ドリフトです。これらの障害は通常、静かに起こります。エラーを出さず、ただ黙って出力を悪化させます。だからこそ、オブザーバビリティと評価は、あれば便利なオプションではなく、LLMOpsの中核機能なのです。
LLMOpsにおけるガードレールとは何ですか?
ガードレールとは、LLMの出力がユーザーに届く前に実行されるチェックです。有害なコンテンツのフィルタリング、プロンプトインジェクションの試みの検出、機密データの漏えいのブロック、回答を話題から逸脱させないことなどを行います。モデルの生の出力と、それを読む人との間にある、最後の運用レイヤーです。
LLMOpsは、自社でモデルを構築するチームだけに関係するものですか?
いいえ。企業のLLMアプリケーションの大半は、モデルを学習するのではなく、サードパーティのモデルをAPI経由で呼び出しています。つまり、プロンプト管理、評価、RAGの監視、コスト追跡、ガードレールといったLLMOpsの手法は、基盤モデルを自社で学習したかどうかにかかわらず、チームにとってまさに必要なものです。
関連するAIの概念
- MLOps - LLMOpsが拡張した、機械学習のライフサイクル全体を扱うより広い分野
- AIオブザーバビリティ - LLMOpsがLLM呼び出しに特化して適用する、ログ、トレース、指標の規律
- 大規模言語モデル - LLMOpsが安定して運用するために存在するモデルカテゴリ
- Retrieval-Augmented Generation - LLMOpsがモデルとあわせて健全に保つ必要がある検索パイプライン
- AIハルシネーション - LLMOpsの評価とガードレールが捕捉するために作られた中核的な障害モード
- 推論 - LLMOpsのコストとレイテンシの手法が適用される本番フェーズ
- プロンプトエンジニアリング - LLMOpsが本番環境でバージョン管理し監視する、上流の実践
- モデルモニタリング - LLMOpsがデプロイ済みのLLMの挙動に適用する継続的な追跡の規律
外部リソース
- LangSmith - LLMアプリケーション向けのオブザーバビリティと評価のプラットフォーム
- Langfuse - オープンソースのLLMオブザーバビリティとトレーシングのプラットフォーム
- Arize AI - MLとLLMのオブザーバビリティと評価のプラットフォーム
- Weights and Biases - LLMのプロンプトとモデルの比較に拡張された実験管理

Co-Founder, Rework.com