AIインフラとは?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
AIインフラとは、企業がAIモデルを構築、導入、運用するために必要な技術スタック全体です。コンピューティングを供給するGPUとクラウド容量、データを取り込むパイプライン、推論を担うモデルレイヤー、そして実際のユーザーがそれに依存するようになった後もシステムを安定稼働させ続けるオーケストレーションとオブザーバビリティのツール群から成り立っています。
多くの経営層は、このスタックをクラウド利用料の明細やベンダーのキャパシティ待機リストといった形でしか間接的に目にすることがありません。しかし、チャットボット、需要予測モデル、CRMに組み込まれたコパイロットなど、自社が利用するあらゆるAI機能は、どこかでこのスタックの何らかのバージョンの上で動いています。実際に何がその中身なのかを知っておけば、ベンダーの価格設定を読み解いたり、内製か外部調達かの提案を判断したり、社内のAIプロジェクトが行き詰まったときに適切な質問をしたりすることがずっと容易になります。
AIインフラスタックの各レイヤー
AIインフラは1つの製品として購入できるものではありません。互いに積み重なった複数のレイヤーの集合体であり、そのうちのどれか1つが弱ければ、その上に乗るすべてのレイヤーの動作が遅くなったり、壊れたりします。
| レイヤー | 役割 | 代表的な例 |
|---|---|---|
| コンピューティング/ハードウェア | モデルの学習と実行を支える行列演算を実際に処理する | Nvidia H100、H200、Blackwell世代のGPU、AMD MIシリーズアクセラレータ、Google TPU、ハイパースケーラー各社の独自シリコン |
| クラウドとネットワーキング | GPU容量を提供し、数千個のチップを1つの稼働クラスタに接続する | AWS、Azure、Google Cloud、CoreWeaveのような専門GPUクラウド、NVLinkやInfiniBandのような高速ファブリック |
| データパイプライン | モデルが学習したり、回答時に参照したりできるようデータを収集、クレンジング、移動する | ETLおよびデータパイプラインツール、フィーチャーストア、ベクトルデータベース |
| モデルレイヤー | 入力に対して実際に推論を行う学習済みモデル | 基盤モデル、大規模言語モデル、ファインチューニング済みまたはオープンウェイトのバリエーション |
| モデルサービング | 学習済みモデルを本番規模の実際のリクエストに応答できるよう展開する | モデルサービングプラットフォーム、APIゲートウェイ、簡単なクエリを安価なモデルに、難しいクエリをフロンティアモデルに振り分けるモデルルーター |
| オーケストレーション | 複数ステップのワークフロー、ツール呼び出し、そしてモデルの変更を安全に展開するパイプラインを調整する | MLOpsとLLMOpsのパイプライン、ワークフローおよびエージェントフレームワーク |
| オブザーバビリティ | モデルが稼働開始した後のコスト、レイテンシ、品質、ドリフトを追跡する | AIオブザーバビリティとモデルモニタリングプラットフォーム、ロギングおよびトレーシングツール |
実務上のポイントは、たとえ世界最高水準のGPUを持っていても、データパイプラインがモデルに古い情報を渡していたり、トラフィックが増加した際に誰もレイテンシやコストを監視していなかったりすれば、AI機能は壊れた状態でリリースされてしまうということです。上のレイヤーが機能するためには、すべてのレイヤーが土台として持ちこたえる必要があります。
AIインフラとAIデータセンターの違い
この2つの用語は同じ意味で使われがちですが、実際には異なるものです。AIデータセンターは、GPUを収容する建物、変電設備、液冷プラントといった物理施設そのものを指します。一方、AIインフラはより広い概念で、そのハードウェアレイヤーに加えて、クラウドサービス、データパイプライン、モデルレイヤー、オーケストレーション、そしてどこで稼働していようと関係なくその上に乗るオブザーバビリティツールまでを含みます。
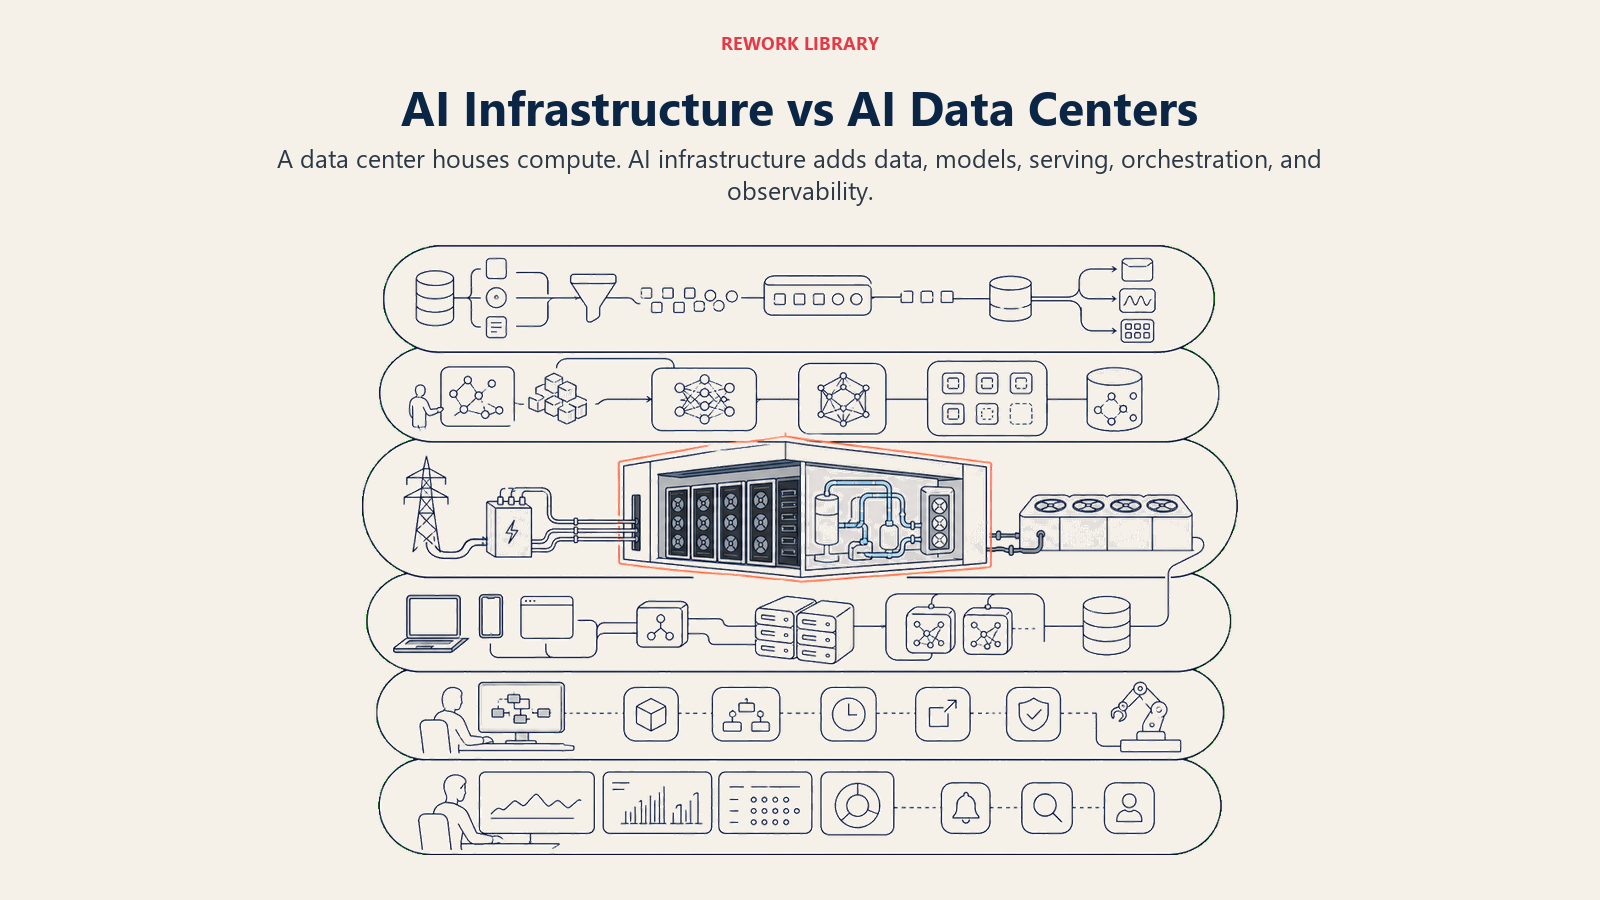
簡単に言えば、AIデータセンターはより大きなAIインフラスタックの中の1つのレイヤー(コンピューティングとハードウェア)にすぎません。企業は他社のデータセンターからGPU容量を借りながらも、データパイプライン、モデルの選定、サービングとオーケストレーションの構成といったAIインフラの他のすべてのレイヤーを、自社施設を一切建設することなく所有できます。この違いは、あるベンダーが「AIインフラの上で動いている」と主張するときに重要になります。ハードウェアは指し示しやすい部分にすぎず、より難しく差別化につながる作業はその周辺にすべて存在するからです。
内製か外部調達か: 企業は実際にどうスタックを組み立てているか
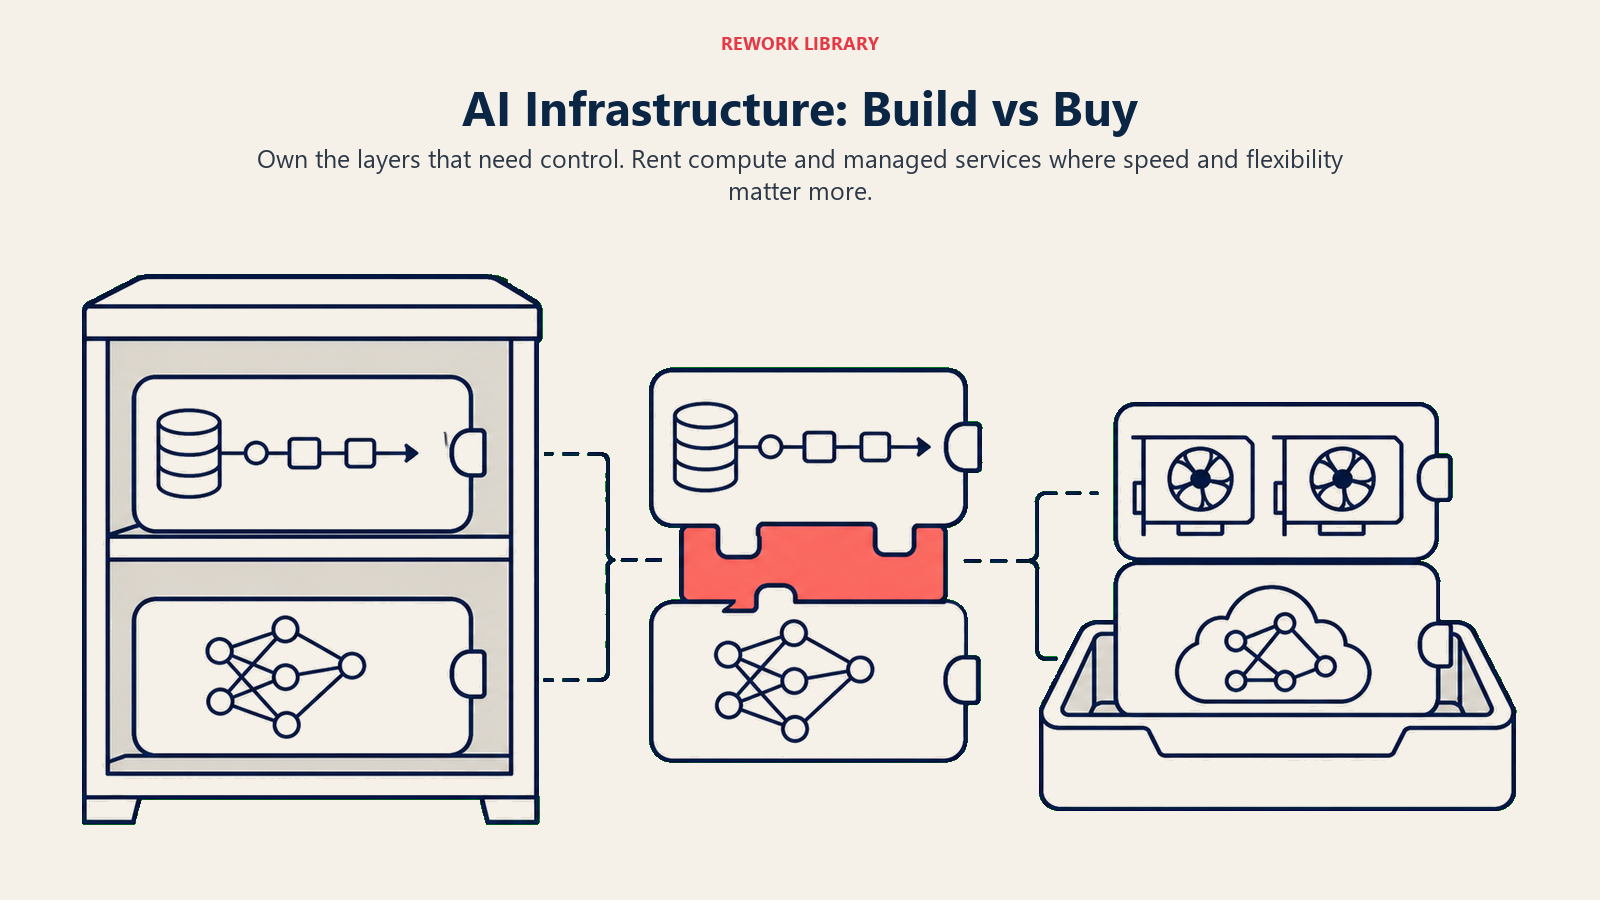
すべてのレイヤーをゼロから自社構築する企業はほとんどありません。本当の意思決定は、どのレイヤーを所有し、どのレイヤーを借りるかであり、その選択はスタックの各レイヤーによって異なります。
| アプローチ | 所有するもの | 最適な対象 |
|---|---|---|
| フルマネージドAPI(モデルプロバイダー) | モデル呼び出し自体より下のレイヤーは何も所有しない | 今すぐ機能が必要で、ウェイトやハードウェアに触れる必要のないスピード重視のチーム |
| マネージドクラウドGPU | 自社のデータパイプライン、モデルの選定、サービング構成、レンタルするコンピューティング | ハードウェアを所有せずにオープンウェイトモデルをファインチューニングまたはセルフホストするチーム |
| コロケーションまたはオンプレミス | 物理ハードウェアを含むすべて | 規制業界、レイテンシに敏感なワークロード、または所有する方がレンタルより有利になるほど利用量が持続的に多い場合 |
クラウドプロバイダーからコンピューティングをレンタルする、あるいはモデルAPIを呼び出すことは、ほぼすべての企業にとって適切な既定の選択肢です。設備投資、AIデータセンターの建設コスト、そしてハードウェア保有に必要な専門スタッフを回避できるからです。AIの内製か外部調達かの判断は、通常「データセンターを建設するかしないか」ではなく、「スタックのどのレイヤーに対して直接的なコントロールが必要で、どのレイヤーなら安全にレンタルできるか」という判断になります。どのベンダーと契約するにしても有効な確認方法は、そのベンダーが価格設定やロードマップを変更した場合、自社のデータパイプラインとモデルの選定がどうなるかを問う、適切なベンダー評価を実施することです。
AIインフラのコストを左右する要因
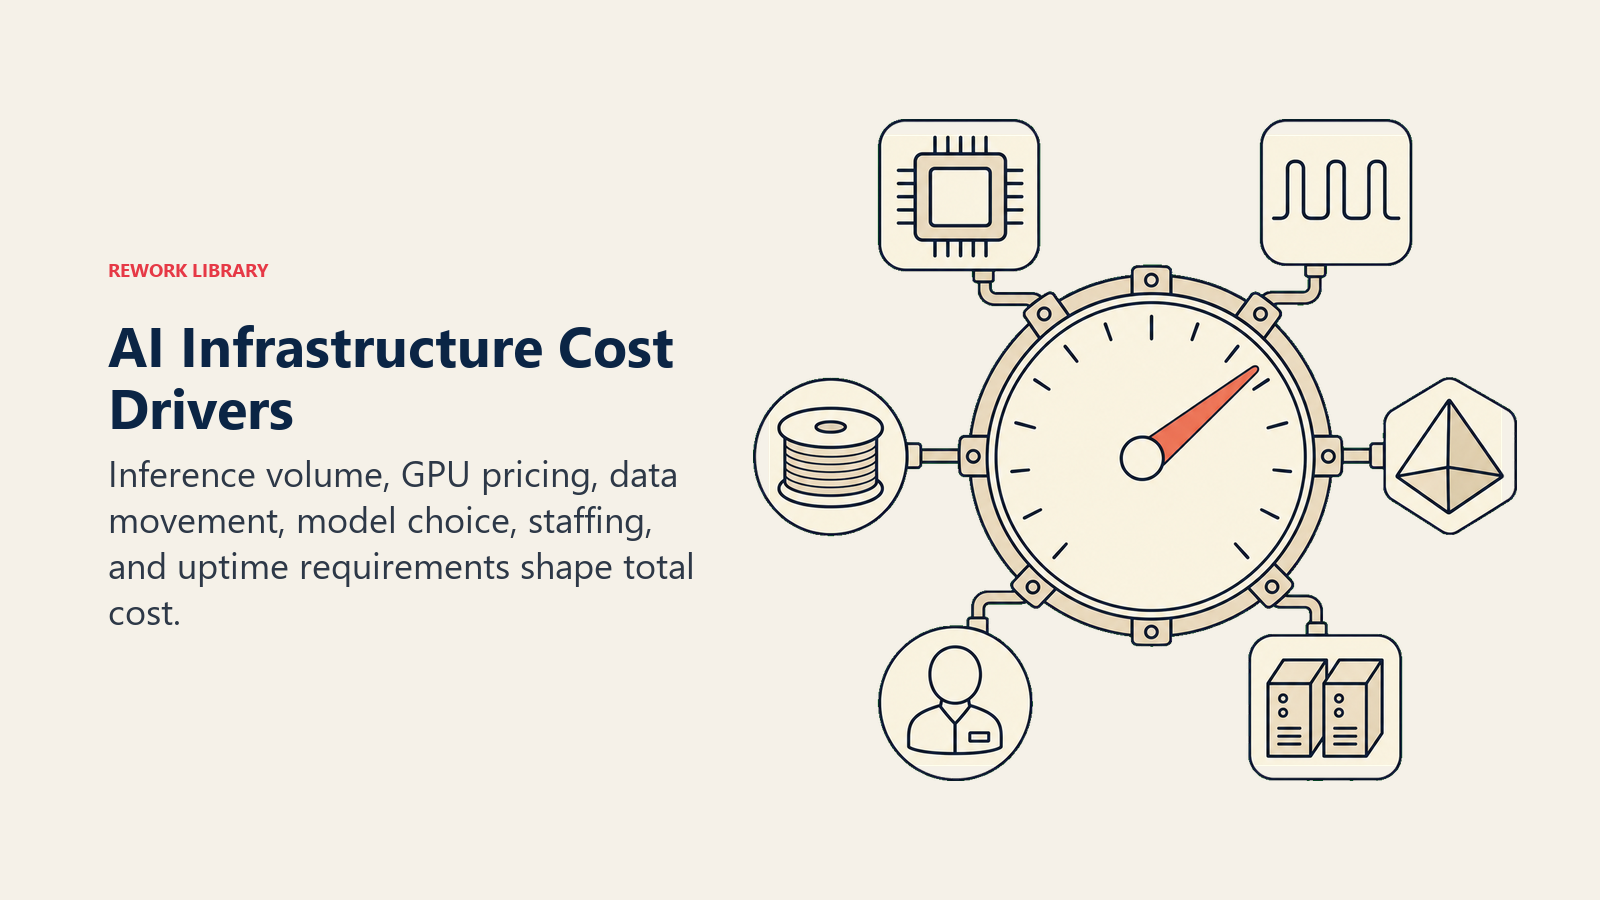
無駄のないAIインフラのコストと、際限なく膨らんでいくコストとの差の大部分は、いくつかの要因で説明できます。
- GPUの希少性と価格。 フロンティア級GPUへの需要は依然として供給を常に上回っており、この希少性がそのままクラウドプロバイダーのコンピューティング料金に反映されます。
- 学習ではなく推論の量。 ほとんどの企業はモデルをゼロから学習させることはありません。コストを左右するのは推論、すなわち稼働中のモデルが応答するすべてのクエリにかかる継続的なコストであり、これは一度きりのコストとしてではなく、利用量に応じて直接スケールしていきます。
- データの移動と保存。 モデルに、特に自社データに対する検索を行うモデルにデータを与えるには、データを繰り返し保存・移動する必要があり、クラウドのエグレス料金は規模が大きくなるほど急速に積み上がります。
- モデルの選定。 フロンティアモデルは、同じ仕事をより安く行えるよう最適化された、より小型で、蒸留された、あるいは量子化圧縮されたモデルよりも、トークンあたりのコストが高くなります。
- 人材。 オーケストレーションとオブザーバビリティのレイヤーは誰かが責任を持たなければなりません。MLOpsとLLMOpsの人材は希少であり、AIインフラを確実に運用するための人員コストは、多くの内製か外部調達かの比較で過小評価されがちな、実在する継続的なコスト項目です。
- 冗長性と稼働率の要件。 停止が許されない顧客向けのAI機能は、たまの障害を許容できる社内向けツールよりも運用コストが高くなります。冗長性を確保するということは、常に使うわけではない容量に対しても料金を支払うことを意味するからです。
信頼できるAIの総所有コストモデルは、GPU時間あたりの表示価格だけでなく、これら6つすべてを考慮に入れる必要があります。
2026年のAIインフラの現状
現在のAIインフラ支出については3つの事実があり、そのすべてが自社のAIにかかるコストに影響します。
支出は依然として急速に伸び続けています。Gartnerは、世界のIT支出が2026年に前年比で約11%増の6兆1,500億ドルに達すると予測しており、データセンターシステム支出だけでも前年の5,000億ドル弱から6,500億ドルを超える見込みです。米国の大手ハイパースケーラー4社、Amazon、Alphabet、Microsoft、Metaは、2026年の設備投資額として合計約7,250億ドルを見込んでおり、これは2025年の過去最高だった4,100億ドルから約77%の増加で、その圧倒的大部分がAIインフラに充てられます。
重心は学習から推論へとシフトしています。Deloitteは、2026年にはAI向けコンピューティング全体のおよそ3分の2を推論が占めるようになると予測しており、これは2023年の3分の1、2025年の2分の1から上昇したものです。また、推論最適化チップの市場は今年中に500億ドルを超える規模に成長するとも見込んでいます。この変化はコスト計画において重要です。学習は前払い型の支出である一方、推論のコストはユーザーとのやり取りのたびに、無期限にスケールしていくからです。
そして企業は本番ワークロードをパブリッククラウドから引き揚げつつあります。本番AI推論の主要な環境としてパブリッククラウドを利用する企業の割合は、1年間で56%から41%へと15ポイント低下した一方、56%の企業がコストの予測可能性とデータ管理を主な理由として、プライベートクラウドで本番推論を運用している、または運用を計画しています。一方でハードウェアレイヤーは依然として集中しています。Nvidiaのデータセンター部門だけで2026会計年度に前年比68%増の1,937億ドルの売上を上げており、ワークロードが推論とハイブリッド展開へとシフトする中でも、コンピューティング市場の基盤は依然として少数のチップ・クラウドプロバイダーに支配されていることを改めて示しています。
AIインフラがビジネスリーダーにとって重要な理由
自社がAIツールを構築または導入しているなら、このどれも抽象的な話ではありません。AIインフラに関する意思決定の際に持ち帰っておくべき、実践的なポイントをいくつか挙げます。
- 実際に何に対して料金を支払っているのかを確認する。 ベンダーの価格には、コンピューティング、オーケストレーション、オブザーバビリティがまとめて含まれていることが多くあります。各レイヤーを把握しておけば、そのうちのどれかを別のものに置き換えた場合にいくら支払うことになるかを問うことができます。
- モデル化すべき数字は学習コストではなく推論コストです。 自社チームが独自モデルをファインチューニングまたは学習させているなら、それは一度きりの支出です。継続的にかかる費用は推論であり、それは採用が進むにつれてスケールしていきます。機能が成功すれば喜ばしいことですが、誰も予算計画を立てていなければ問題になります。
- ハイブリッドはもはや例外ではなく既定です。 本番推論をプライベートクラウドへ移す動きは、単なる好みではなく、実際のコストとコントロールに関する懸念を反映しています。どのベンダーに対しても、自社のワークロードが実際にどこで動いているのか、そしてその理由を確認してください。
- ベンダーのキャパシティリスクは実在するデューデリジェンスの論点です。 あるプロバイダーのロードマップが、自社ではコントロールできないGPUや資本調達に依存しているなら、それは他の重要なベンダーを評価するのと同じように、直接尋ねる価値のある単一障害点です。
- インフラを自社所有することが最初の一手として正しいケースはめったにありません。 ほとんどすべての企業にとって、コンピューティングをレンタルし、マネージドモデルレイヤーを導入する方が自社構築より優れています。「自社で持つ」という議論は、持続的に大量の利用がある、レイテンシ要件が厳しい、あるいは規制上どうしても必要になるワークロードのために取っておいてください。
重要なポイント
- 世界のIT支出は2026年に前年比でほぼ11%増の6兆1,500億ドルに達すると予測されており、データセンターシステム支出は2025年の5,000億ドル弱から6,500億ドルを超える見込みです。Gartner, via CIO.com
- データセンター向け半導体売上は2026年に4,771億ドルに達すると予測されており、うち「インテリジェント」データセンターセグメント(AIアクセラレータ、GPU、カスタムASIC、ネットワーキング用シリコン)だけで2,810億ドルを占め、非メモリ半導体の中で最大の識別可能なカテゴリーとなっています。IDC
- Nvidiaのデータセンター部門は2026会計年度に前年比68%増の1,937億ドルの売上を上げ、第4四半期単体でも前年比75%増の過去最高623億ドルを記録しました。Nvidia
- 推論は2026年にAI向けコンピューティング全体のおよそ3分の2を占めると予測されており、これは2023年の3分の1、2025年の2分の1から上昇したもので、推論最適化チップ市場は今年500億ドルを超える見込みです。Deloitte
- 本番AI推論の主要な環境としてパブリッククラウドを利用する企業の割合は、1年間で56%から41%へと15ポイント低下した一方、**56%**の企業がプライベートクラウドで本番推論を運用している、または運用を計画しています。Broadcom
- 米国の大手ハイパースケーラー4社は、2026年の設備投資額として合計約7,250億ドルを見込んでおり、これは2025年の過去最高4,100億ドルから約**77%**の増加で、その大部分がAIインフラに充てられる予定です。CNBC
- Gartnerは、2028年までにAIを導入する組織の**40%**が、モデルの性能、バイアス、出力を監視するために専用のAIオブザーバビリティツールを利用するようになると予測しています。Gartner
AIインフラに関するよくある質問
AIインフラとは簡単に言うと何ですか?
AIインフラとは、AIモデルを構築、導入、運用するために必要な技術スタック全体です。GPUコンピューティング、それをつなぐクラウドとネットワーキング、モデルにデータを供給するデータパイプライン、モデルレイヤー自体、そして実際のユーザーがそれに依存するようになった後もすべてを確実に稼働させ続けるオーケストレーションとオブザーバビリティのツールから構成されます。
AIインフラの主なレイヤーは何ですか?
中核となるレイヤーは、コンピューティングとハードウェア(GPUとアクセラレータ)、クラウドとネットワーキング(容量と相互接続)、データパイプライン(データの収集と移動)、モデルレイヤー(推論を行う学習済みモデル)、モデルサービング(実際のトラフィック向けにモデルを展開すること)、オーケストレーション(ワークフローと展開の調整)、そしてオブザーバビリティ(本番環境でのコスト、レイテンシ、品質の監視)です。
AIインフラはAIデータセンターとどう違いますか?
AIデータセンターは、GPUと冷却システムを収容する物理施設であり、スタックの中の1つのレイヤーです。AIインフラはより広い概念で、そのハードウェアレイヤーに加え、その上に構築されたクラウドサービス、データパイプライン、モデルレイヤー、オーケストレーション、オブザーバビリティのツールまでを、物理的にどのデータセンターで稼働していようと含みます。
企業はAIインフラを自社構築すべきですか、それとも購入すべきですか?
ほぼすべての企業にとって、コンピューティングをレンタルし、マネージドモデルレイヤーを導入することが適切な既定の選択肢です。自社構築が理にかなうのは、規制業界、レイテンシに敏感なワークロード、あるいは長期的に見て自社所有がレンタルを上回るほど利用量が多い場合に限られます。
AIインフラのコストを左右する要因は何ですか?
最大の要因は、GPUの希少性と価格、継続的な推論の量(通常は一度きりのコストである学習ではなく)、データの移動と保存、選定するモデル、MLOpsとLLMOpsの人材、そして稼働率に敏感なワークロードに必要な冗長性です。
MLOpsとAIインフラの違いは何ですか?
AIインフラは、ハードウェアからオブザーバビリティまでを含むスタック全体です。MLOpsは、そのスタックの上で動作し、モデルを確実にデプロイ、監視、維持するための運用上の規律とツール群です。MLOpsはAIインフラが存在することを前提としており、そのどのレイヤーの代わりにもなりません。
中小企業も自社のAIインフラを必要としますか?
自社ハードウェアが必要になることはほぼありません。ほとんどの中小企業は、SaaS製品やモデルAPIを通じて間接的にAIインフラを消費しており、コンピューティング、データパイプライン、サービングの各レイヤーに直接触れることはありません。彼らにとって重要なインフラ上の判断は、通常どのチップを買うかではなく、どのベンダーを信頼するかです。
2026年、AIインフラで何が変化していますか?
際立った変化は2つあります。1つは支出が学習から推論へと移行していることです。推論は今やAI向けコンピューティングのおよそ3分の2を占め、一度きりのコストではなく利用量に応じてスケールします。もう1つは、企業がコストの予測可能性とデータ管理を理由に、本番ワークロードをパブリッククラウドからプライベートクラウドやハイブリッド構成へと引き揚げつつあることです。
関連するAIコンセプト
- AIデータセンターとは? - より広いAIインフラスタックの中にある物理施設レイヤー
- MLOps - AIインフラの上で動作し、モデルの信頼性を保つ運用上の規律
- LLMOpsとは? - 大規模言語モデルのアプリケーションに特化して適用されるMLOps
- モデルサービング - 学習済みモデルが実際の本番トラフィックに応答できるよう展開される仕組み
- AIオブザーバビリティ - 本番環境でのコスト、レイテンシ、品質の問題を捉える監視レイヤー
- AIの総所有コスト - インフラの経済性が、企業が実際にAIに支払う金額にどうつながるか
- AIの内製か外部調達か - どのインフラレイヤーを所有し、どのレイヤーをレンタルするかを判断するフレームワーク
- エッジAI - レイテンシに敏感なワークロードのための、集中型インフラに代わる選択肢
- 基盤モデル - スタックのモデルレイヤーに位置する事前学習済みモデル
- 推論 - 現在AIインフラのコストの大部分を左右している本番ワークロード
外部リソース
- Gartner: IT Spending to Exceed $6 Trillion by 2026 (via CIO.com) - 世界のITおよびデータセンター支出予測
- IDC: Semiconductor Market Forecast, the AI Supercycle - データセンター向け半導体と「インテリジェント」データセンターの予測
- Nvidia: Fourth Quarter and Fiscal 2026 Financial Results - データセンター部門の売上と成長率
- Deloitte: Compute Power for AI, 2026 TMT Predictions - コンピューティングに占める推論の割合と推論チップ市場の予測
- Broadcom: The AI Tipping Point, Private Cloud Outlook 2026 - 本番AI推論におけるパブリッククラウドからプライベートクラウドへの企業のシフト
AI用語集コレクションの一部。最終更新日: 2026-07-20
