O que é LoRA (Low-Rank Adaptation)?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Se você se perguntou "o que é LoRA em AI" ao ler sobre os custos de fine-tuning, esta é a resposta curta: LoRA (Low-Rank Adaptation) é uma técnica de fine-tuning eficiente em parâmetros que congela os pesos originais de um modelo pré-treinado e treina, ao lado deles, pequenas matrizes "adaptadoras". Em vez de atualizar bilhões de parâmetros, o LoRA atualiza uma fração minúscula, muitas vezes menos de 1%, igualando ou se aproximando da qualidade do fine-tuning completo por uma fração do custo de computação e armazenamento.
Como o LoRA funciona
Toda camada de uma rede neural grande contém matrizes de pesos que são atualizadas durante o treinamento. O fine-tuning completo mexe em todos esses números. O LoRA adota outra abordagem: congela totalmente a matriz de pesos original e adiciona, ao lado dela, um segundo caminho bem menor, formado por duas matrizes finas multiplicadas entre si (uma "decomposição de baixo posto"). Durante o treinamento, só essas duas matrizes pequenas aprendem. O modelo original nunca muda.
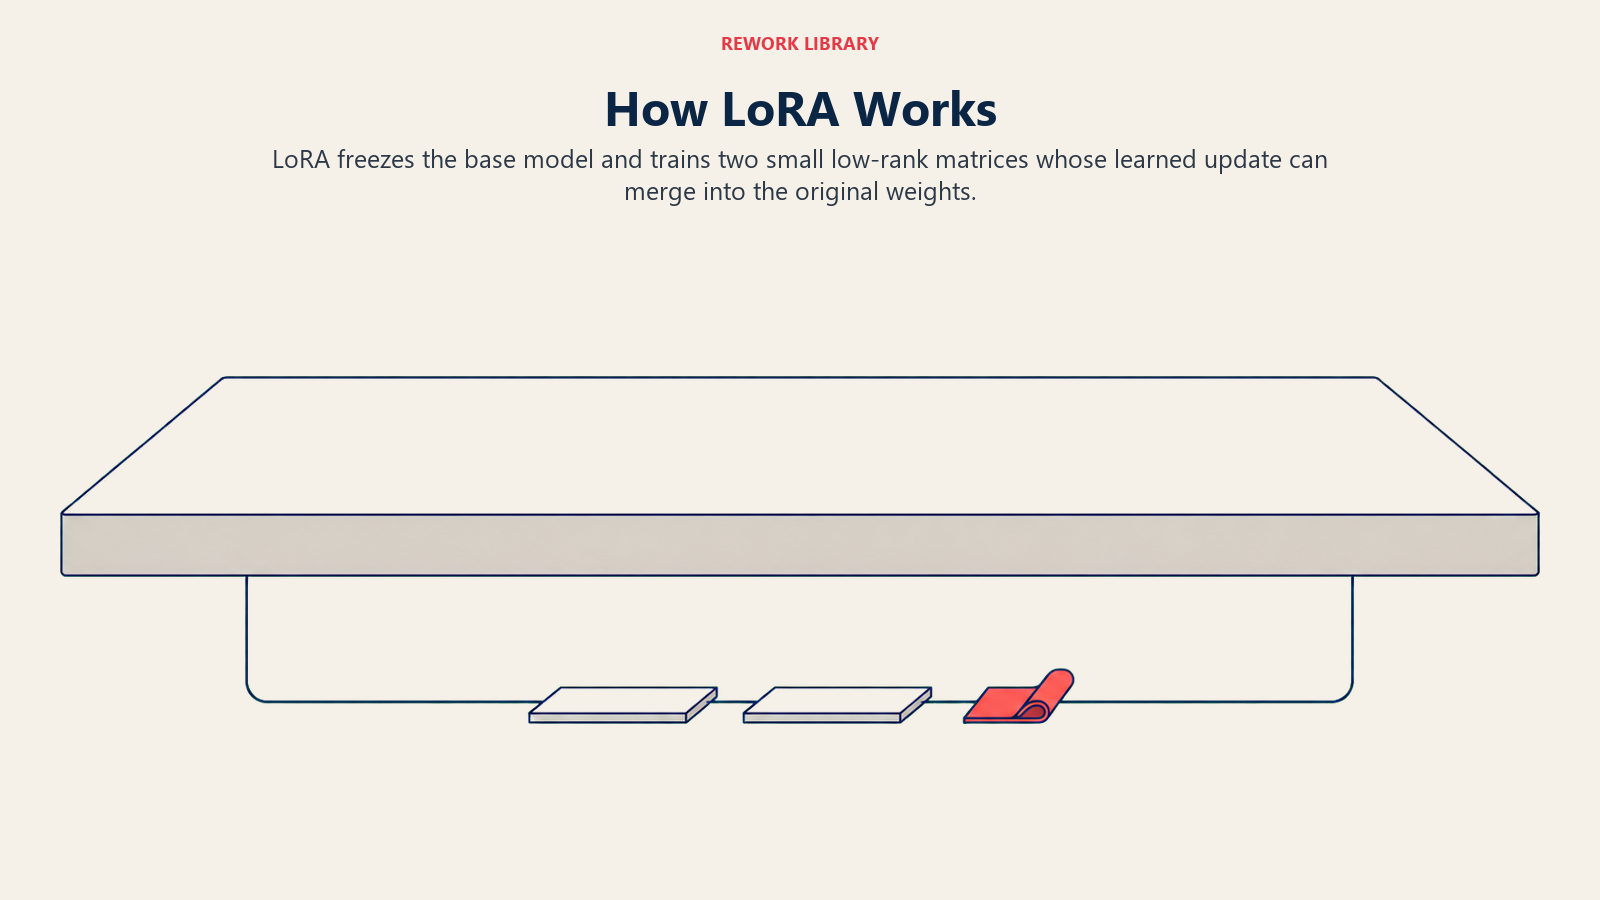
A intuição é mais simples do que a matemática sugere. Uma matriz de pesos grande pode ter milhões de parâmetros, mas a mudança necessária para adaptar um modelo a uma nova tarefa ou a um novo estilo de escrita muitas vezes está em um subespaço bem menor. O LoRA aposta que esse "delta", a diferença entre o modelo de uso geral e o especializado que você deseja, pode ser capturado por duas matrizes pequenas em vez de uma enorme. A técnica surgiu de pesquisas anteriores sobre transfer learning, que estabeleceram que adaptar um modelo pré-treinado a uma nova tarefa raramente exige treiná-lo do zero.
Na inferência, as duas matrizes pequenas podem ser matematicamente incorporadas de volta aos pesos originais, de modo que um modelo adaptado com LoRA roda exatamente tão rápido quanto o modelo base. Sem camadas extras e sem latência adicional, porque o adaptador praticamente desaparece dentro dos pesos quando o treinamento termina.
Fatos principais: LoRA (Low-Rank Adaptation)
- O LoRA reduz o número de parâmetros treináveis em 10.000 vezes e a necessidade de memória de GPU em 3 vezes em comparação com o fine-tuning completo do GPT-3 175B com Adam, segundo o artigo original do LoRA (Hu et al., 2021, arXiv:2106.09685).
- Um checkpoint de LoRA para o GPT-3 175B ocupa cerca de 35 MB, contra aproximadamente 350 GB de uma cópia totalmente ajustada, uma redução de cerca de 10.000 vezes com posto r=4 (Hu et al., 2021).
- O QLoRA, uma variante do LoRA que adiciona quantização de 4 bits, faz o fine-tuning de um modelo de 65 bilhões de parâmetros em uma única GPU de 48 GB, igualando a qualidade do fine-tuning completo em 16 bits (Dettmers et al., 2023, arXiv:2305.14314).
Por que o LoRA importa para a AI nos negócios
Para os líderes de negócios, o LoRA significa poder personalizar um foundation model grande com o tom, a terminologia ou a tarefa da sua empresa, sem pagar a computação, o armazenamento e as horas de engenharia que o fine-tuning completo exige. Pense nisso como encaixar um acessório pequeno e feito sob medida em uma ferramenta de uso geral, em vez de reconstruir a ferramenta inteira do zero.
Essa diferença de custo não é pequena. Segundo Hu et al. (2021), o LoRA reduz em 10.000 vezes a contagem de parâmetros treináveis do GPT-3 175B e em 3 vezes sua necessidade de memória de GPU em comparação com o fine-tuning completo, com desempenho igual ou melhor que o do fine-tuning completo em tarefas de benchmark com RoBERTa, DeBERTa, GPT-2 e GPT-3. Essa combinação, qualidade quase igual por uma fração do custo de recursos, é o motivo pelo qual o LoRA se tornou a abordagem de fine-tuning padrão para a maioria das equipes que trabalham com large language models, e não a exceção.
O armazenamento segue a mesma lógica. Uma cópia totalmente ajustada do GPT-3 175B precisa de cerca de 350 GB. Um adaptador LoRA para o mesmo modelo precisa de cerca de 35 MB (Hu et al., 2021). Isso significa que uma empresa pode manter dezenas de adaptadores específicos para cada tarefa, um para revisão de documentos jurídicos, um para o tom do suporte ao cliente, um para uma linha de produtos específica, sobre um modelo base compartilhado, sem duplicar centenas de gigabytes para cada variante. Hu et al. observam que hospedar 100 modelos adaptados dessa forma custa cerca de 354 GB no total, em vez de aproximadamente 35 TB para 100 cópias completas separadas.
O LoRA também possibilitou um segundo avanço: o QLoRA. Introduzido por Dettmers et al. (2023), o QLoRA combina o LoRA com a quantização de 4 bits do modelo base congelado, reduzindo a necessidade de memória o bastante para fazer o fine-tuning de um modelo de 65 bilhões de parâmetros em uma única GPU de 48 GB, preservando o desempenho do fine-tuning completo em 16 bits. A família de modelos resultante do artigo, Guanaco, alcançou 99,3% do nível de desempenho do ChatGPT no benchmark Vicuna após apenas 24 horas de fine-tuning em uma única GPU. Esse resultado levou a personalização de grandes modelos de clusters de servidores com várias GPUs para uma única GPU de estação de trabalho em muitas equipes.
Casos de uso comuns do LoRA
O LoRA aparece sempre que as equipes precisam de muitas versões especializadas de um modelo base sem o custo de retreinar cada uma por completo.
- Adaptação de domínio. Ensinar a um LLM de uso geral o vocabulário do seu setor, como a terminologia jurídica, médica ou financeira, sem mexer no modelo base.
- Voz e tom da marca. Adaptar o estilo de escrita de um modelo para combinar com os scripts de suporte ou com a voz de marketing de uma empresa.
- Produtos de AI multi-tenant. Plataformas SaaS que atendem muitos clientes podem manter um único modelo base compartilhado e trocar um adaptador LoRA leve por cliente, evitando o custo de armazenamento e de serviço de centenas de cópias completas do modelo.
- Experimentação rápida. Como o treinamento com LoRA leva horas em vez de dias e exige bem menos memória de GPU, as equipes podem testar mais ideias de fine-tuning com o mesmo orçamento.
- Personalização de modelos de imagem e difusão. O LoRA também é muito usado fora dos modelos de texto, permitindo que artistas e equipes de produto adaptem modelos de geração de imagens a um estilo artístico ou a uma linha de produtos específica com um pequeno arquivo adaptador, em vez de um modelo retreinado de vários gigabytes.
- Implantação em edge e em ambientes com recursos limitados. Combinados com técnicas de otimização de modelos, os adaptadores LoRA mantêm a capacidade especializada disponível até onde não há infraestrutura de retreinamento completo.
LoRA vs. fine-tuning completo vs. RAG
Essas três abordagens resolvem problemas relacionados, mas diferentes, e as equipes costumam combinar mais de uma.
| Abordagem | O que altera | Melhor para | Custo de computação/armazenamento | Velocidade de atualização |
|---|---|---|---|---|
| Fine-tuning completo | Todos os pesos do modelo | Máxima personalização quando há orçamento e um conjunto de dados grande e de alta qualidade | Mais alto (cluster completo de GPUs, armazenamento do modelo inteiro por versão) | Lento para retreinar |
| LoRA (e QLoRA) | Um pequeno conjunto de matrizes adaptadoras de baixo posto adicionadas, com os pesos base congelados | Ensinar novo tom, terminologia ou comportamento específico de uma tarefa de forma eficiente | Baixo (viável em uma única GPU, adaptadores medidos em MB) | Rápido para retreinar, fácil de trocar adaptadores |
| Retrieval-augmented generation | Nada no modelo: recupera documentos relevantes no momento da consulta e os insere no prompt | Manter as respostas atualizadas com fatos que mudam rápido ou citar documentos-fonte específicos | Baixo (sem treinamento, apenas uma base de conhecimento indexada) | Instantâneo, basta atualizar os documentos-fonte |
A regra prática: use RAG quando o modelo precisar conhecer fatos atuais ou proprietários, use LoRA quando o modelo precisar se comportar ou escrever de outra forma e reserve o fine-tuning completo para os raros casos em que o orçamento menor de parâmetros do LoRA realmente não consegue capturar a mudança necessária. Muitos sistemas em produção combinam modelos adaptados com LoRA e RAG para a recuperação, já que os dois resolvem problemas distintos.
Limitações do LoRA
O LoRA não substitui universalmente o fine-tuning completo e traz compromissos reais.
- A escolha do posto importa. Um posto baixo demais pode subajustar tarefas complexas, enquanto um posto alto demais começa a corroer a vantagem de eficiência do LoRA. Hu et al. (2021) constataram que um posto de apenas um muitas vezes bastava nas tarefas testadas com o GPT-3, mas isso depende da tarefa e precisa ser validado em cada caso de uso.
- Não é ideal para ensinar conhecimentos realmente novos. O LoRA adapta bem comportamento e estilo, mas não é a ferramenta certa para injetar grandes volumes de conhecimento factual novo que o modelo base nunca viu. O retrieval-augmented generation ou o pré-treinamento contínuo geralmente lidam melhor com isso.
- Ainda exige um modelo base capaz. O LoRA adapta o que um foundation model já sabe; não compensa um modelo base que não tem a capacidade de fundo.
- Sobrecarga de gestão de adaptadores. Rodar muitos adaptadores LoRA em produção exige infraestrutura para carregá-los, trocá-los e versioná-los corretamente, um problema menor que o versionamento de modelos completos, mas não nulo.
- Diferente das técnicas de compressão. O LoRA reduz o custo de treinamento, não necessariamente o custo de inferência nem o tamanho do modelo na hora de servir (depois de incorporado, o modelo tem o mesmo tamanho do modelo base). Equipes que querem reduzir o próprio modelo implantado costumam combinar o LoRA com trabalho separado de compressão de modelos ou de knowledge distillation.
Saiba mais
- Fine-tuning - a categoria mais ampla de técnicas à qual o LoRA pertence
- Foundation Models - os modelos base sobre os quais os adaptadores LoRA são treinados
- Large Language Models - a classe de modelos para a qual o LoRA foi originalmente criado
- Quantização - a técnica que o QLoRA combina com o LoRA
- Transfer Learning - a base de pesquisa sobre a qual o LoRA se apoia
- Knowledge Distillation - uma abordagem alternativa para reduzir modelos em vez de adaptá-los
Perguntas frequentes sobre LoRA
O que é LoRA em AI, em uma frase?
LoRA (Low-Rank Adaptation) é um método de fine-tuning eficiente em parâmetros que congela os pesos de um modelo pré-treinado e treina, em vez disso, pequenas matrizes adaptadoras adicionadas, alcançando boa parte da qualidade do fine-tuning completo por uma fração do custo de computação e armazenamento.
O LoRA é um tipo de fine-tuning?
Sim. O LoRA é uma técnica de fine-tuning eficiente em parâmetros (PEFT), uma categoria de métodos que adaptam um modelo pré-treinado atualizando apenas um pequeno subconjunto de parâmetros em vez do modelo inteiro, ao contrário do fine-tuning completo, que atualiza todos os pesos.
Quanto o LoRA é mais barato que o fine-tuning completo?
Segundo o artigo original do LoRA (Hu et al., 2021), o LoRA reduz os parâmetros treináveis em 10.000 vezes e a necessidade de memória de GPU em 3 vezes em comparação com o fine-tuning completo do GPT-3 175B com Adam, igualando ou superando a qualidade do fine-tuning completo nos benchmarks testados.
O que é o QLoRA e qual a diferença em relação ao LoRA?
O QLoRA acrescenta ao LoRA padrão a quantização de 4 bits do modelo base congelado, reduzindo ainda mais a necessidade de memória. Dettmers et al. (2023) mostraram que o QLoRA consegue fazer o fine-tuning de um modelo de 65 bilhões de parâmetros em uma única GPU de 48 GB, preservando o desempenho do fine-tuning completo em 16 bits.
O LoRA deixa o modelo mais lento na inferência?
Não. Quando o treinamento termina, as pequenas matrizes do LoRA podem ser matematicamente incorporadas de volta aos pesos originais, de modo que o modelo adaptado roda na mesma velocidade do modelo base, sem latência adicional de inferência.
Quando devo usar LoRA em vez de RAG?
Use LoRA quando precisar que o modelo escreva em outro tom, siga um formato específico ou execute uma tarefa especializada. Use o retrieval-augmented generation quando precisar que o modelo consulte fatos atuais ou proprietários, já que o RAG atualiza o que o modelo vê no momento da consulta, e não o que ele aprendeu.
O LoRA consegue ensinar conhecimentos totalmente novos a um modelo?
Não com eficiência. O LoRA é mais indicado para adaptar comportamento e estilo existentes do que para injetar grandes volumes de conhecimento factual novo. Para conhecimento novo, o retrieval-augmented generation ou o pré-treinamento contínuo costumam ser mais adequados.
O LoRA é usado só em modelos de linguagem?
Não. O LoRA também é muito usado em modelos de imagem e de difusão, permitindo que as equipes adaptem geradores de imagens a um estilo artístico ou a uma linha de produtos específica com um pequeno arquivo adaptador, em vez de retreinar o modelo completo.
Parte da Coleção AI Terms. Última atualização: julho de 2026
