Large Language Modelsとは?人間の言語におけるAI革命
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
ChatGPTは2023年に、わずか2ヶ月で1億ユーザーに到達しました。2026年半ばには、その初期の好奇心は日常的なインフラへと変わり、Claude、GPT-5.6、Gemini 3.2 Proが毎日数百万件のビジネス文書、契約書、コードベースを処理しています。これらのLarge Language Modelsは単なるチャットボットではありません。ビジネスの運営方法、コミュニケーション、価値創造を根本的に変えています。モデルの顔ぶれ自体も急速に変化し、少数の汎用チャットアシスタントから、推論に特化したモデル、低コストの主力モデル、最先端に匹敵するオープンウェイトの代替モデルが混在する状況になりました。しかし、何が彼らをそれほど強力にしているのか、そしてここに至るまでに何が変わったのでしょうか?
話題の背後にある技術
Large Language Modelsは数十年にわたる自然言語処理研究から生まれましたが、画期的な進歩は2017年のトランスフォーマーアーキテクチャで実現しました。「大規模」という用語は、数十億のパラメータ(言語理解をエンコードする調整可能な値)を指します。
スタンフォードのAI研究所によると、LLMsは「大量のテキストデータでトレーニングされたニューラルネットワークモデルであり、シーケンス内の次の単語を予測することで人間の言語を理解し生成し、単純なテキスト補完をはるかに超える創発的な能力を開発する」と定義されています。
革命は2020年のOpenAIのGPT-3で始まり、十分に大型のモデルが明示的にトレーニングされていないタスクを実行できることを実証しました。コードの記述から契約の分析まで。
ビジネス向けの解説
ビジネスリーダーにとって、LLMsは人間の専門知識に近いレベルで人間の言語を読み、書き、分析し、推論できるAIシステムですが、コンピュータの速度とスケールを備えています。
LLMを、事実上すべての書かれたものを読んだ高学歴のアシスタントを持つことと考えてください。24時間365日働き、決して忘れず、同時に数千の会話を持つことができます。スクリプトに従う従来のソフトウェアとは異なり、LLMsはコンテキスト、ニュアンス、意図を理解します。
実際には、これは、メールの下書き、契約の分析、顧客の質問への回答、コードの記述、さらには戦略立案を支援できるAIを意味し、すべて自然言語で行われます。
理解のアーキテクチャ
LLMsは以下の重要な要素で構成されています。
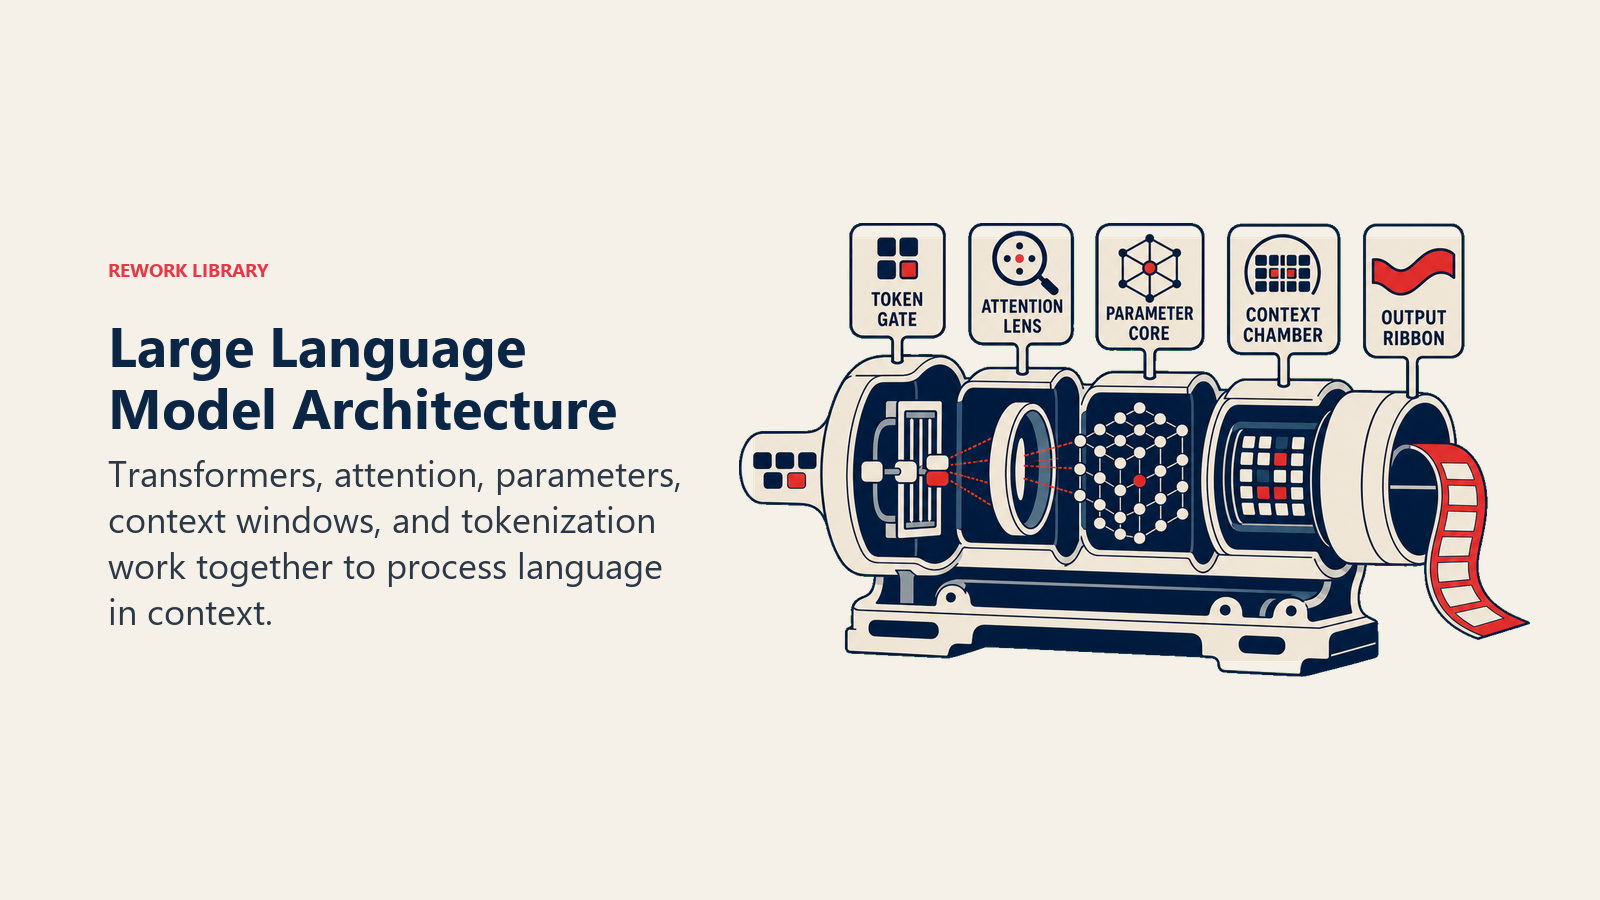
• トランスフォーマーアーキテクチャ: コンテキスト内で単語を処理するニューラルネットワーク設計で、「bank」が「river bank」と「investment bank」で異なる意味を持つことを理解します
• アテンションメカニズム: 文中のどの単語が互いに関連しているかを判断するシステムで、複雑な関係と依存関係を把握します
• 数十億のパラメータ: トレーニングデータから学習したパターンを表す数値の重みにエンコードされた「知識」
• コンテキストウィンドウ: モデルが一度に考慮できるテキストの量です。GPT-3世代の初期モデルは約4,000トークンが上限でしたが、2026年半ばには、Gemini 3.2 Proのような最先端モデルが最大200万トークンを扱い、100万トークンのウィンドウ(Claude Opus 4.8、GPT-5.6 Sol)も最上位帯では一般的になっています
• トークン化システム: テキストが処理可能な単位に分割される方法で、任意の言語やコードさえも理解できます
LLMsが言語を処理する方法
LLMプロセスは次のステップに従います。
入力トークン化: テキストがトークン(単語の一部)に変換され、各トークンにモデルが処理できる数値表現が割り当てられます
コンテキスト分析: トランスフォーマーアーキテクチャがすべてのトークンを同時に検査し、アテンションメカニズムを通じて関係と意味を理解します
予測生成: トレーニング中に学習したパターンに基づいて、モデルは最も可能性の高い次のトークンを予測し、一貫性のあるコンテキストに沿った応答を生成します
これは1秒あたり数十億回発生し、流暢で関連性のあるテキストを作成し、人間の執筆と区別がつかないことがよくあります。
Large Language Modelsのカテゴリー
LLMsは一般的に4つの主要なタイプに分類されます。
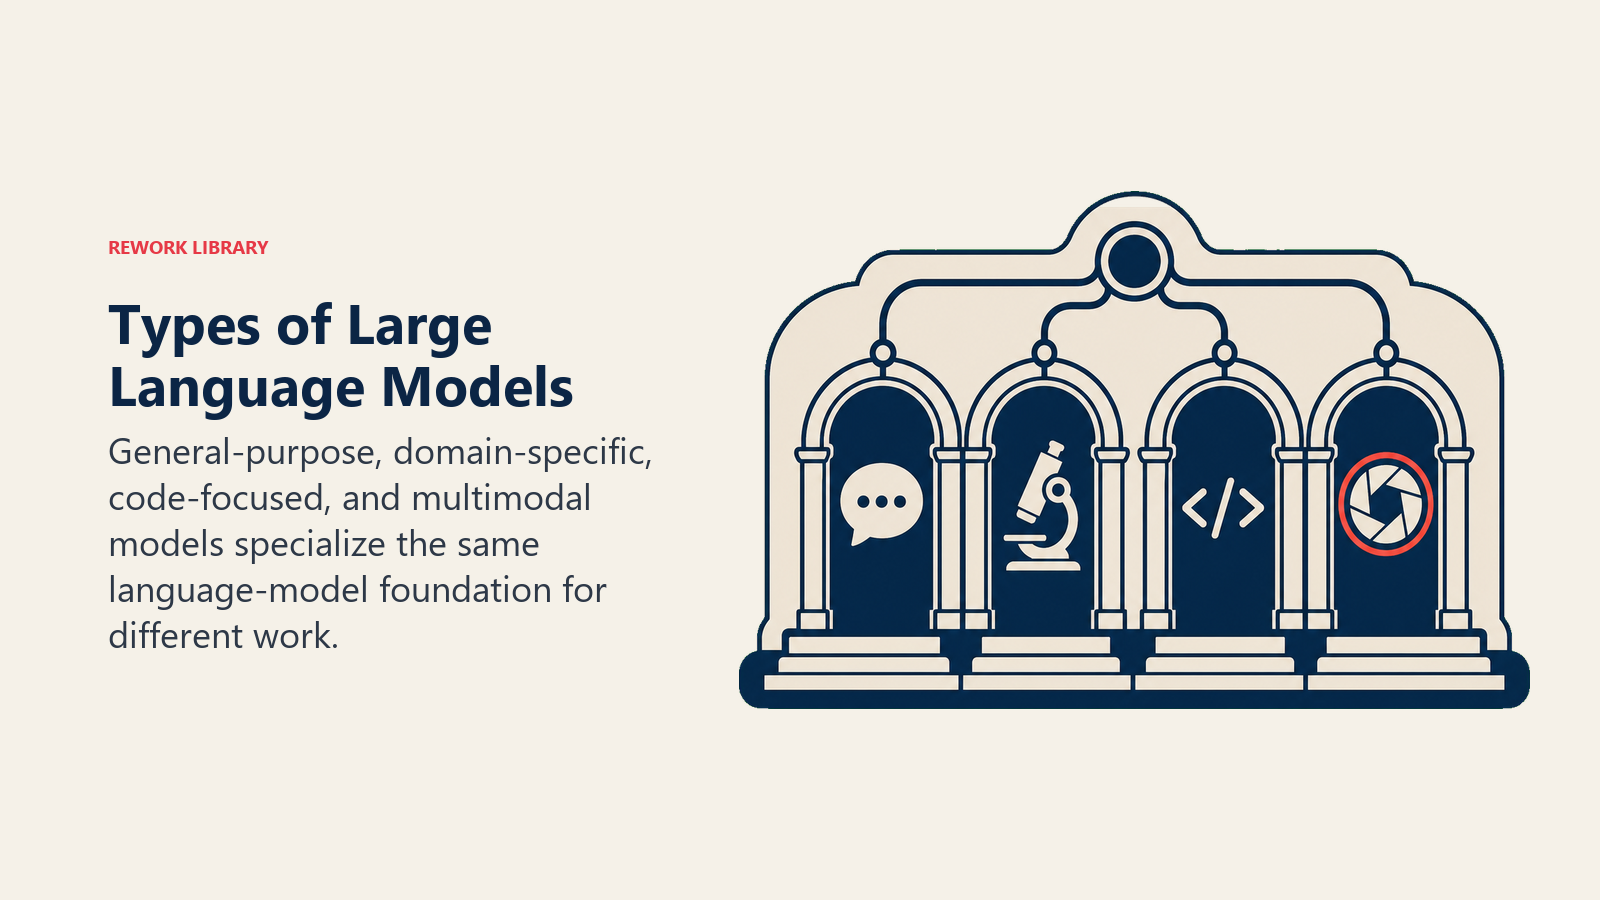
タイプ1:汎用モデル 最適な用途:執筆から分析まで幅広いタスク 主な特徴:広範な知識と機能 例:GPT-5.6、Claude Opus 4.8、Gemini 3.2 Pro
タイプ2:専門ドメインモデル 最適な用途:業界固有のアプリケーション 主な特徴:専門データでファインチューニング 例:金融のBloombergGPT、医療のMed-PaLM
タイプ3:コード重視モデル 最適な用途:ソフトウェア開発と技術タスク 主な特徴:プログラミング言語でトレーニング 例:GitHub Copilot、Claude Code、Qwen3-Coderのようなオープンウェイトのコード特化モデル
タイプ4:マルチモーダルモデル 最適な用途:テキスト、画像、その他のメディアを含むタスク 主な特徴:複数のフォーマットを理解し生成 例:GPT-5.6(ネイティブのビジョン)、Gemini 3.2 Pro(ネイティブの動画推論)
カテゴリーのラベルよりも重要なのは、2つの横断的な変化です。1つ目に、2026年の最先端モデルの多くは推論モード(「extended thinking」や「deep think」と呼ばれることもあります)を備えており、推論は別のモデルタイプではなく、速度と引き換えに数学、コード、複数ステップのビジネスロジックを段階的に解く機能になっています。2つ目に、オープンウェイトモデル(Llama、Qwen、DeepSeek、Mistral)は、独自の最先端モデルとの性能差をほぼ埋めながら、わずかなコストで動作します。そのため、購買の判断は「どのラボか」だけでなく、「クローズドな最先端モデルか、オープンウェイトモデルか、タスクに十分な小型で低コストのモデルか」へと変わっています。
Key Facts
- 2025年の世界の企業によるAI投資は5,817億ドル(うち3,447億ドルが民間資本)に達し、米国だけで2,859億ドルを投資しました。これは中国の124億ドルの23倍にあたります。Stanford HAI AI Index 2026
- 生成AIは、ChatGPTの登場から3年以内に人口の53%に普及しました。これはパーソナルコンピュータやインターネットよりも速い普及曲線です。Stanford HAI AI Index 2026
- 最高性能のクローズドモデルと最高性能のオープンウェイトモデルの差は、2026年初頭時点で約3ポイントまで縮まり、1年前よりはるかに小さくなっています。Stanford HAI AI Index 2026
- 2025年の企業の生成AI支出は370億ドルに達し、2024年の115億ドルから3.2倍になりました。現在ではアプリケーションがその支出の半分以上を占めています。Menlo Ventures, 2025 State of Generative AI in the Enterprise
- Anthropicは企業のLLM API支出の約40%(2023年は12%)を占める一方、OpenAIのシェアは、購入企業がより多くのプロバイダーにワークロードを分散させたことで27%(以前は50%)に低下しました。Menlo Ventures, 2025 State of Generative AI in the Enterprise
- 一定のLLM性能水準に到達するための価格は、ベンチマークによって年間9倍から900倍の幅で低下しており、2024年1月以降の中央値の低下ペースは年間約200倍に加速しています。Epoch AI, LLM inference price trends
- 88%の組織が少なくとも1つの事業部門でAIを定常的に利用していると回答しており(1年前は78%)、ただし大半はまだ全社的な「大きな」価値を得られていないと述べています。McKinsey, The State of AI
ビジネスを変革するLLMs
企業が実際にLLMsをどのように使用しているかを、過去2年間の厳しい教訓も含めて見てみましょう。
カスタマーサービスの例: Klarnaは2023年に、約700人のサポート担当者をLLMアシスタントに置き換え、問い合わせの3分の2を処理させる実験を行い、これは業界の教訓的な事例となりました。2025年には、複雑な問題での満足度が低下したため、同社は人間の担当者を再雇用し、CEOは「効率とコストに偏りすぎていた」と認めました。Klarnaの現在のモデルであり、2026年に多くの企業が行き着いたのはハイブリッド型です。定型的な依頼はLLMが即座に解決し、共感や判断が必要なものは人間が対応します。
法律の例: A&O Shearman(2024年にAllen & OveryとShearman & Sterlingが合併して誕生)は、HarveyおよびMicrosoftと構築したContractMatrix Analyzeモジュールを、43の法域にまたがる4,000人以上の弁護士に展開しています。早期導入企業は、プレイブックに基づくレビューで95%を超える精度、契約レビュー時間の30%削減、弁護士1人あたり週に約2〜3時間の節約を報告しています。
ソフトウェア開発の例: AI生成コードはもはや目新しいものではありません。GitHubは、Copilotがプラットフォーム上で書かれるコードの約46%を生成していると報告しており、2026年には新規コードの41〜46%がAI支援によるものだという業界の推定とも一致します。Replitだけでも、50万人以上のビジネスユーザーを抱え、Fortune 500の85%に導入されています。
What changed in 2026
今日のLLMの状況は、わずか1年前と比べても、いくつかの点で異なります。
- 推論は別製品ではなく標準機能になりました。 最先端モデルの多く(Claude Opus 4.8、GPT-5.6 Sol、Gemini 3.2 Pro)には、難しい問題向けにオンにできる推論(「thinking」)モードがあり、推論専用のモデルを別に用意する必要はなくなりました。
- オープンウェイトモデルは無視できない水準に近づきました。 最高性能のオープンウェイトモデルは、能力ベンチマークで最高性能のクローズドモデルに約3ポイント差まで迫り、1年前から大幅に縮まっています。そのため、タスクごとに最先端モデルとオープンウェイトモデルを使い分ける企業が増えています。
- トークンコストは下がり続けました。 同じ性能水準に到達するコストは2024年の何分の一かになり、いくつかのベンチマークでは価格性能比が年間で3桁の改善を見せています。これにより、主力のユースケースだけでなく、あらゆるワークフローでLLMを動かすことが経済的に成り立つようになりました。
- コンテキストウィンドウはボトルネックではなくなりました。 100万トークンを超えるコンテキストウィンドウにより、コードベース全体、契約書一式、数四半期分の財務開示書類を一度に取り込めるようになりました。
- 市場はハイプを修正しました。 Klarnaが全面AIのカスタマーサービスを公に撤回したことや、大半の企業が生成AIから「大きな」価値をまだ得られていないというMcKinseyの調査結果によって、議論は「人を置き換える」から「LLMと適切な人間による監督を組み合わせる」へと移りました。
LLMジャーニーの開始
ビジネスでLLMsを活用する準備はできていますか?
- プロンプトエンジニアリング技術で対話をマスター
- AIハルシネーションのような制限を理解
- AI API経由で統合を探索
- 責任あるデプロイのためのAIガバナンスフレームワークを検討
関連リソース
理解を深めるために、これらの関連AI概念を探索してください。
- Generative AI - 新しいコンテンツを作成するAIシステムのより広いカテゴリー
- Deep Learning - 最新のLLMsを動かす基盤技術
- Foundation Models - 専門アプリケーションのベースとして機能する事前トレーニング済みモデル
- Conversational AI - LLMsが自然な人間-コンピュータ対話を可能にする方法
外部リソース
- OpenAI GPT Research Papers - 大規模言語モデル開発に関する技術文書
- Anthropic's Claude Technical Documentation - 最新のLLMsの安全性と機能
- Google DeepMind LLM Research - 言語モデルアーキテクチャに関する学術的視点
Large Language Modelsに関するよくある質問
Large Language Models (LLMs)とは何ですか?
LLMsは、膨大なテキストデータでトレーニングされた数十億のパラメータを持つAIシステムで、人間の言語を理解し生成し、執筆から分析、推論までのタスクが可能です。
LLMsとチャットボットの違いは何ですか?
従来のチャットボットはスクリプト化された応答に従います。LLMsはコンテキストを理解し、オリジナルのコンテンツを生成し、会話を超えて、コーディングから分析、クリエイティブライティングまで多様なタスクを実行できます。
LLMsの4つのタイプは何ですか?
汎用モデル(GPT-5.6、Claude Opus 4.8、Gemini 3.2 Pro)、専門ドメインモデル(金融のBloombergGPT)、コード重視モデル(GitHub Copilot、Claude Code)、マルチモーダルモデル(テキスト、画像、動画を処理)があります。
「推論モデル」とは何ですか?必要ですか?
推論モデルは、回答する前に追加の計算を使って問題を段階的に解くモデルで、数学、コード、複数ステップのビジネスロジックに効果があります。2026年の最先端モデルの多くは、別製品ではなく切り替え機能としてこれを提供しています。難しい問題にはオンにし、単純な検索では使わないことで、コストとレイテンシーを抑えられます。
オープンウェイトのLLMは、独自モデルの代わりになるほど優れていますか?
多くのタスクではその通りです。最高性能のオープンウェイトモデルは、能力ベンチマークで最高性能のクローズドモデルとの差が数ポイントにとどまり、運用コストもはるかに低いことが多いため、1つのモデルに統一するのではなく、ワークロードごとにオープンウェイトモデルと最先端モデルを組み合わせる企業が増えています。
LLMsのパラメータとは何ですか?
パラメータは、モデルの学習した知識をエンコードする調整可能な数値です。通常、パラメータが多いほど、複雑な言語パターンと関係を理解する能力が高くなりますが、より新しい小型モデルは、優れたトレーニングによって旧来の大型モデルに匹敵することが増えています。
[AI用語集]の一部。最終更新:2026-01-10
