Was ist LoRA (Low-Rank Adaptation)?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Wenn Sie sich beim Lesen über Fine-Tuning-Kosten gefragt haben, was LoRA in der AI ist, hier die Kurzantwort: LoRA (Low-Rank Adaptation) ist eine parametereffiziente Fine-Tuning-Technik, die die ursprünglichen Gewichte eines vortrainierten Modells einfriert und stattdessen kleine „Adapter“-Matrizen daneben trainiert. Statt Milliarden von Parametern zu aktualisieren, passt LoRA nur einen winzigen Bruchteil an, oft unter 1 %, und erreicht dabei die Qualität von Full Fine-Tuning oder kommt ihr nahe, bei einem Bruchteil der Compute- und Speicherkosten.
So funktioniert LoRA
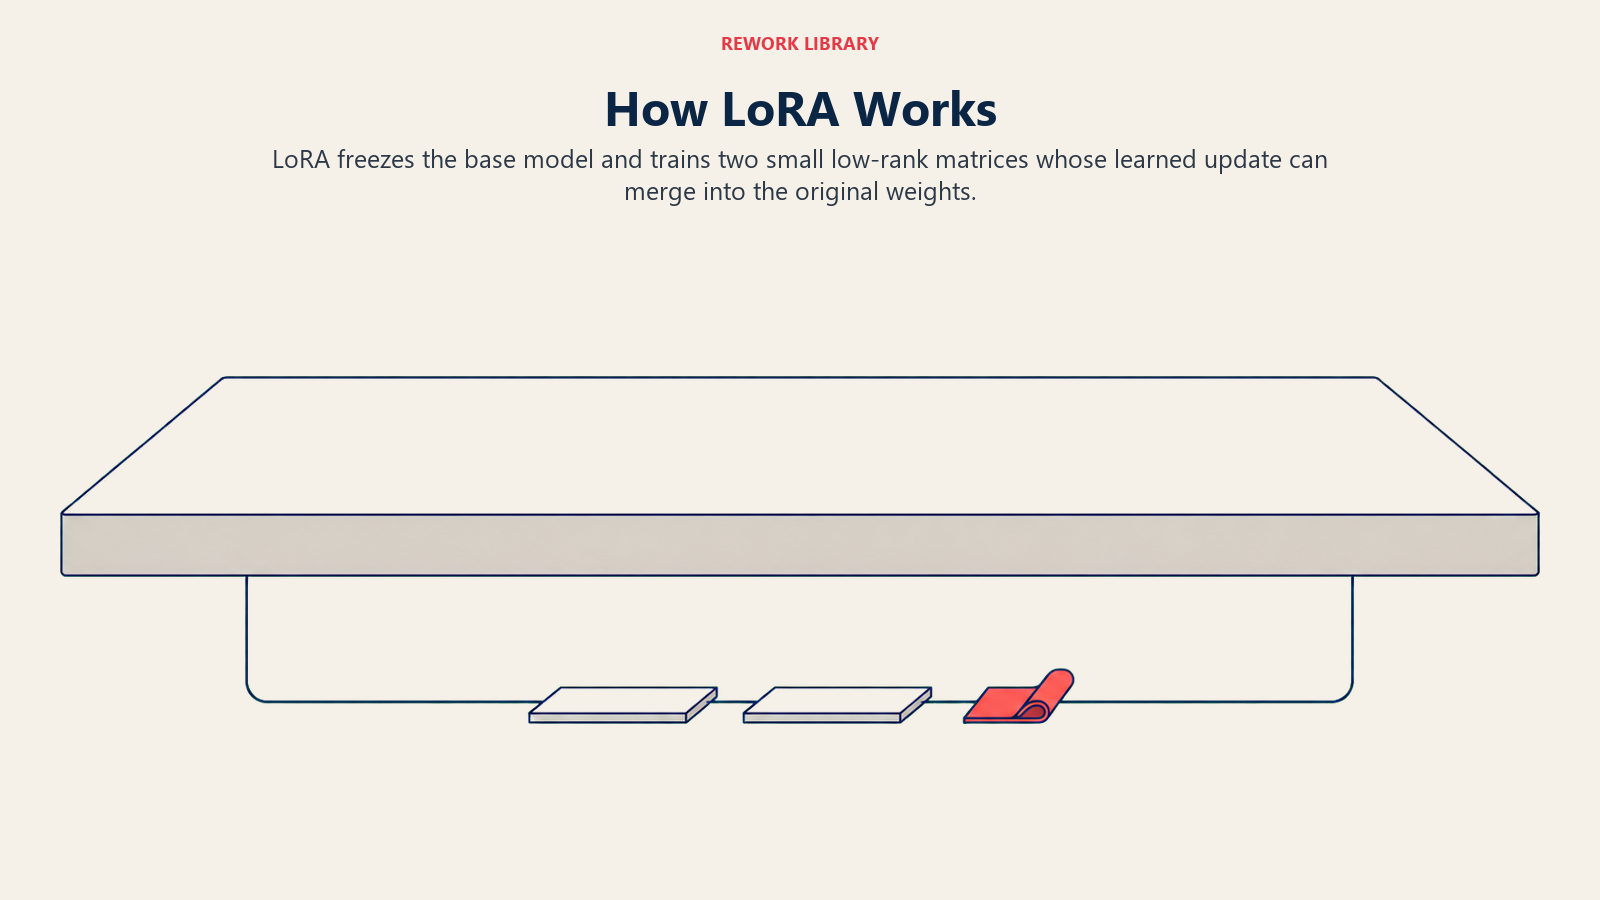
Jede Schicht eines großen neuronalen Netzes enthält Gewichtsmatrizen, die beim Training aktualisiert werden. Full Fine-Tuning verändert jede dieser Zahlen. LoRA geht anders vor: Es friert die ursprüngliche Gewichtsmatrix vollständig ein und fügt daneben einen zweiten, viel kleineren Pfad hinzu, der aus zwei dünnen, miteinander multiplizierten Matrizen besteht (eine „Low-Rank-Zerlegung“). Beim Training lernen nur diese beiden kleinen Matrizen. Das Originalmodell ändert sich nie.
Die Intuition ist einfacher, als die Mathematik klingt. Eine große Gewichtsmatrix kann Millionen von Parametern haben, aber die Änderung, die nötig ist, um ein Modell an eine neue Aufgabe oder einen neuen Schreibstil anzupassen, liegt oft in einem viel kleineren Unterraum. LoRA setzt darauf, dass dieses „Delta“, der Unterschied zwischen dem Allzweckmodell und dem spezialisierten, das Sie wollen, durch zwei kleine statt einer riesigen Matrix erfasst werden kann. Die Technik entstand aus früherer Forschung zu Transfer Learning, die gezeigt hatte, dass die Anpassung eines vortrainierten Modells an eine neue Aufgabe selten ein Training von Grund auf erfordert.
Zur Inferenzzeit lassen sich die beiden kleinen Matrizen mathematisch wieder mit den ursprünglichen Gewichten verschmelzen, sodass ein LoRA-angepasstes Modell genauso schnell läuft wie das Basismodell. Keine zusätzlichen Schichten, keine zusätzliche Latenz, denn der Adapter verschwindet nach dem Training praktisch in den Gewichten.
Wichtige Fakten: LoRA (Low-Rank Adaptation)
- LoRA senkt die Zahl der trainierbaren Parameter um das 10.000-Fache und den GPU-Speicherbedarf um das 3-Fache gegenüber Full Fine-Tuning von GPT-3 175B mit Adam, laut dem ursprünglichen LoRA-Paper (Hu et al., 2021, arXiv:2106.09685).
- Ein LoRA-Checkpoint für GPT-3 175B umfasst etwa 35 MB, gegenüber rund 350 GB für eine vollständig feinabgestimmte Kopie, eine Reduktion um etwa das 10.000-Fache bei Rang r=4 (Hu et al., 2021).
- QLoRA, eine LoRA-Variante mit 4-Bit-Quantisierung, stimmt ein Modell mit 65 Milliarden Parametern auf einer einzelnen 48-GB-GPU fein ab und erreicht dabei die Qualität von vollem 16-Bit-Fine-Tuning (Dettmers et al., 2023, arXiv:2305.14314).
Warum LoRA für Business-AI wichtig ist
Für Führungskräfte bedeutet LoRA, dass Sie ein großes Foundation Model an Tonalität, Terminologie oder Aufgaben Ihres Unternehmens anpassen können, ohne die Compute-, Speicher- und Engineering-Kosten zu tragen, die Full Fine-Tuning verlangt. Stellen Sie es sich so vor, als würden Sie einen kleinen, speziell gebauten Aufsatz auf ein Allzweckwerkzeug stecken, statt das ganze Werkzeug neu zu bauen.
Dieser Kostenunterschied ist nicht marginal. Laut Hu et al. (2021) reduziert LoRA die Zahl der trainierbaren Parameter von GPT-3 175B um das 10.000-Fache und den GPU-Speicherbedarf um das 3-Fache gegenüber Full Fine-Tuning und erreicht bei Benchmark-Aufgaben mit RoBERTa, DeBERTa, GPT-2 und GPT-3 gleichwertige oder bessere Ergebnisse. Diese Kombination, nahezu gleiche Qualität bei einem Bruchteil des Ressourcenaufwands, ist der Grund, warum LoRA für die meisten Teams, die mit Large Language Models arbeiten, zum Standardansatz wurde statt zur Ausnahme.
Beim Speicher summiert es sich genauso. Eine vollständig feinabgestimmte Kopie von GPT-3 175B braucht rund 350 GB. Ein LoRA-Adapter für dasselbe Modell braucht etwa 35 MB (Hu et al., 2021). Ein Unternehmen kann also Dutzende aufgabenspezifischer Adapter auf einem gemeinsamen Basismodell vorhalten, einen für die Prüfung juristischer Dokumente, einen für den Ton im Kundensupport, einen für eine bestimmte Produktlinie, ohne für jede Variante Hunderte Gigabyte zu duplizieren. Hu et al. weisen darauf hin, dass das Hosting von 100 angepassten Modellen auf diese Weise insgesamt rund 354 GB kostet statt etwa 35 TB für 100 separate vollständige Kopien.
LoRA machte außerdem einen zweiten Durchbruch möglich: QLoRA. Eingeführt von Dettmers et al. (2023), kombiniert QLoRA LoRA mit 4-Bit-Quantisierung des eingefrorenen Basismodells und senkt den Speicherbedarf so weit, dass sich ein Modell mit 65 Milliarden Parametern auf einer einzelnen 48-GB-GPU feinabstimmen lässt, bei gleichbleibender Aufgabenleistung wie beim vollen 16-Bit-Fine-Tuning. Die daraus entstandene Modellfamilie des Papers, Guanaco, erreichte nach nur 24 Stunden Fine-Tuning auf einer GPU 99,3 % des Leistungsniveaus von ChatGPT im Vicuna-Benchmark. Dieses Ergebnis verlagerte die Anpassung großer Modelle für viele Teams von Multi-GPU-Serverclustern auf eine einzelne Workstation-GPU.
Typische Use Cases für LoRA
LoRA kommt überall dort zum Einsatz, wo Teams viele spezialisierte Versionen eines Basismodells brauchen, ohne jede einzelne vollständig neu zu trainieren.
- Domänenanpassung. Einem universellen LLM das Vokabular Ihrer Branche beibringen, etwa juristische, medizinische oder finanzielle Terminologie, ohne das Basismodell anzutasten.
- Markenstimme und Tonalität. Den Schreibstil eines Modells an die Support-Skripte oder die Marketing-Stimme eines Unternehmens anpassen.
- Multi-Tenant-AI-Produkte. SaaS-Plattformen mit vielen Kunden können ein gemeinsames Basismodell behalten und pro Kunde einen leichtgewichtigen LoRA-Adapter einsetzen, und sparen so Speicher- und Betriebskosten für Hunderte vollständiger Modellkopien.
- Schnelles Experimentieren. Weil LoRA-Training in Stunden statt Tagen läuft und deutlich weniger GPU-Speicher braucht, können Teams im selben Budget mehr Fine-Tuning-Ideen testen.
- Anpassung von Bild- und Diffusionsmodellen. LoRA wird auch außerhalb von Textmodellen breit genutzt und erlaubt Kreativen und Produktteams, Bildgenerierungsmodelle mit einer kleinen Adapter-Datei statt eines mehrere Gigabyte großen neu trainierten Modells an einen bestimmten Kunststil oder eine Produktlinie anzupassen.
- Edge- und ressourcenbeschränkte Bereitstellung. In Kombination mit Techniken der Modelloptimierung halten LoRA-Adapter spezialisierte Fähigkeiten auch dort verfügbar, wo keine Infrastruktur für vollständiges Retraining existiert.
LoRA vs. Full Fine-Tuning vs. RAG
Diese drei Ansätze lösen verwandte, aber unterschiedliche Probleme, und Teams kombinieren oft mehr als einen.
| Ansatz | Was sich ändert | Am besten für | Compute-/Speicherkosten | Aktualisierungsgeschwindigkeit |
|---|---|---|---|---|
| Full Fine-Tuning | Jedes Modellgewicht | Maximale Anpassung, wenn Budget und ein großer, hochwertiger Datensatz vorhanden sind | Am höchsten (voller GPU-Cluster, volle Modellspeicherung pro Version) | Langsames Retraining |
| LoRA (und QLoRA) | Eine kleine Menge hinzugefügter Low-Rank-Adapter-Matrizen, Basisgewichte bleiben eingefroren | Effizientes Antrainieren neuer Tonalität, Terminologie oder aufgabenspezifischen Verhaltens | Niedrig (einzelne GPU genügt, Adapter im MB-Bereich) | Schnelles Retraining, Adapter leicht austauschbar |
| Retrieval-Augmented Generation | Nichts im Modell, es ruft zur Abfragezeit relevante Dokumente ab und speist sie in den Prompt ein | Antworten bei sich schnell ändernden Fakten aktuell halten oder bestimmte Quelldokumente zitieren | Niedrig (kein Training nötig, nur eine indexierte Wissensbasis) | Sofort, einfach die Quelldokumente aktualisieren |
Die praktische Faustregel: Nutzen Sie RAG, wenn das Modell aktuelle oder proprietäre Fakten kennen soll, nutzen Sie LoRA, wenn das Modell sich anders verhalten oder anders schreiben soll, und reservieren Sie Full Fine-Tuning für die seltenen Fälle, in denen das kleinere Parameterbudget von LoRA die nötige Änderung wirklich nicht abbilden kann. Viele Produktivsysteme kombinieren LoRA-angepasste Modelle mit RAG für das Retrieval, da beide unterschiedliche Probleme lösen.
Grenzen von LoRA
LoRA ist kein universeller Ersatz für Full Fine-Tuning und bringt echte Zielkonflikte mit sich.
- Die Wahl des Rangs zählt. Ein zu niedriger Rang kann bei komplexen Aufgaben zu Underfitting führen, ein zu hoher Rang beginnt, den Effizienzvorteil von LoRA aufzuzehren. Hu et al. (2021) stellten fest, dass bei ihren getesteten GPT-3-Aufgaben oft schon ein Rang von eins genügte, doch das hängt von der Aufgabe ab und muss für jeden Use Case validiert werden.
- Nicht ideal, um wirklich neues Wissen beizubringen. LoRA passt Verhalten und Stil gut an, ist aber nicht das richtige Werkzeug, um große Mengen neuen Faktenwissens einzubringen, das das Basismodell nie gesehen hat. Retrieval-Augmented Generation oder fortgesetztes Pre-Training eignen sich dafür in der Regel besser.
- Erfordert weiterhin ein leistungsfähiges Basismodell. LoRA passt an, was ein Foundation Model bereits weiß; es kann nicht ausgleichen, wenn dem Basismodell die zugrunde liegende Fähigkeit ganz fehlt.
- Aufwand für das Adapter-Management. Viele LoRA-Adapter im Produktivbetrieb zu betreiben erfordert Infrastruktur, um sie korrekt zu laden, auszutauschen und zu versionieren. Das ist ein kleineres Problem als die Versionierung ganzer Modelle, aber nicht null.
- Anders als Kompressionstechniken. LoRA senkt die Trainingskosten, nicht zwingend die Inferenzkosten oder die Modellgröße im Betrieb (nach dem Verschmelzen ist das Modell so groß wie das Basismodell). Teams, die das bereitgestellte Modell selbst verkleinern wollen, kombinieren LoRA üblicherweise mit separater Modellkompression oder Knowledge Distillation.
Mehr erfahren
- Fine-Tuning - die übergeordnete Kategorie von Techniken, zu der LoRA gehört
- Foundation Models - die Basismodelle, auf denen LoRA-Adapter trainiert werden
- Large Language Models - die Modellklasse, für die LoRA ursprünglich entwickelt wurde
- Quantisierung - die Technik, die QLoRA mit LoRA kombiniert
- Transfer Learning - das Forschungsfundament, auf dem LoRA aufbaut
- Knowledge Distillation - ein alternativer Ansatz, um Modelle zu verkleinern statt anzupassen
Häufig gestellte Fragen zu LoRA
Was ist LoRA in der AI, in einem Satz?
LoRA (Low-Rank Adaptation) ist eine parametereffiziente Fine-Tuning-Methode, die die Gewichte eines vortrainierten Modells einfriert und stattdessen kleine hinzugefügte Adapter-Matrizen trainiert und so einen Großteil der Qualität von Full Fine-Tuning bei einem Bruchteil der Compute- und Speicherkosten erreicht.
Ist LoRA eine Art von Fine-Tuning?
Ja. LoRA ist eine Technik des Parameter-Efficient Fine-Tuning (PEFT), einer Kategorie von Methoden, die ein vortrainiertes Modell anpassen, indem sie nur eine kleine Teilmenge der Parameter aktualisieren statt des gesamten Modells, anders als Full Fine-Tuning, das jedes Gewicht aktualisiert.
Wie viel günstiger ist LoRA als Full Fine-Tuning?
Laut dem ursprünglichen LoRA-Paper (Hu et al., 2021) senkt LoRA die trainierbaren Parameter um das 10.000-Fache und den GPU-Speicherbedarf um das 3-Fache gegenüber Full Fine-Tuning von GPT-3 175B mit Adam und erreicht oder übertrifft dabei die Qualität von Full Fine-Tuning bei den getesteten Benchmarks.
Was ist QLoRA und wie unterscheidet es sich von LoRA?
QLoRA ergänzt Standard-LoRA um eine 4-Bit-Quantisierung des eingefrorenen Basismodells und senkt den Speicherbedarf weiter. Dettmers et al. (2023) zeigten, dass QLoRA ein Modell mit 65 Milliarden Parametern auf einer einzelnen 48-GB-GPU feinabstimmen kann und dabei die Leistung des vollen 16-Bit-Fine-Tunings erhält.
Verlangsamt LoRA das Modell zur Inferenzzeit?
Nein. Nach dem Training lassen sich die kleinen LoRA-Matrizen mathematisch wieder mit den ursprünglichen Gewichten verschmelzen, sodass das angepasste Modell mit derselben Geschwindigkeit läuft wie das Basismodell, ohne zusätzliche Inferenz-Latenz.
Wann sollte ich LoRA statt RAG nutzen?
Nutzen Sie LoRA, wenn das Modell in einem anderen Ton schreiben, ein bestimmtes Format einhalten oder eine spezialisierte Aufgabe bewältigen soll. Nutzen Sie Retrieval-Augmented Generation, wenn das Modell auf aktuelle oder proprietäre Fakten zugreifen soll, denn RAG aktualisiert, was das Modell zur Abfragezeit sieht, nicht, was es gelernt hat.
Kann LoRA einem Modell völlig neues Wissen beibringen?
Nicht effizient. LoRA eignet sich besser dafür, bestehendes Verhalten und bestehenden Stil anzupassen, als große Mengen neuen Faktenwissens einzubringen. Für neues Wissen passen Retrieval-Augmented Generation oder fortgesetztes Pre-Training in der Regel besser.
Wird LoRA nur für Sprachmodelle verwendet?
Nein. LoRA wird auch für Bild- und Diffusionsmodelle breit eingesetzt und erlaubt Teams, Bildgeneratoren mit einer kleinen Adapter-Datei an einen bestimmten Kunststil oder eine Produktlinie anzupassen, statt das ganze Modell neu zu trainieren.
Teil der AI-Terms-Sammlung. Zuletzt aktualisiert: Juli 2026
