Bahasa Indonesia
Apa itu LoRA (Low-Rank Adaptation)?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Jika Anda bertanya "apa itu LoRA di AI" saat membaca soal biaya fine-tuning, jawaban singkatnya begini: LoRA (Low-Rank Adaptation) adalah teknik fine-tuning hemat parameter yang membekukan bobot asli model pre-trained dan melatih "adapter" matriks kecil di sampingnya. Alih-alih memperbarui miliaran parameter, LoRA memperbarui sebagian kecil saja, sering kali di bawah 1%, sambil menyamai atau mendekati kualitas full fine-tuning dengan sebagian kecil biaya compute dan penyimpanan.
Cara Kerja LoRA
Setiap lapisan neural network besar berisi matriks bobot yang diperbarui selama training. Full fine-tuning menyentuh setiap angka di dalamnya. LoRA mengambil pendekatan berbeda: ia membekukan matriks bobot asli sepenuhnya dan menambahkan jalur kedua yang jauh lebih kecil di sampingnya, dibangun dari dua matriks tipis yang dikalikan (sebuah "low-rank decomposition"). Selama training, hanya kedua matriks kecil itu yang belajar. Model aslinya tidak pernah berubah.
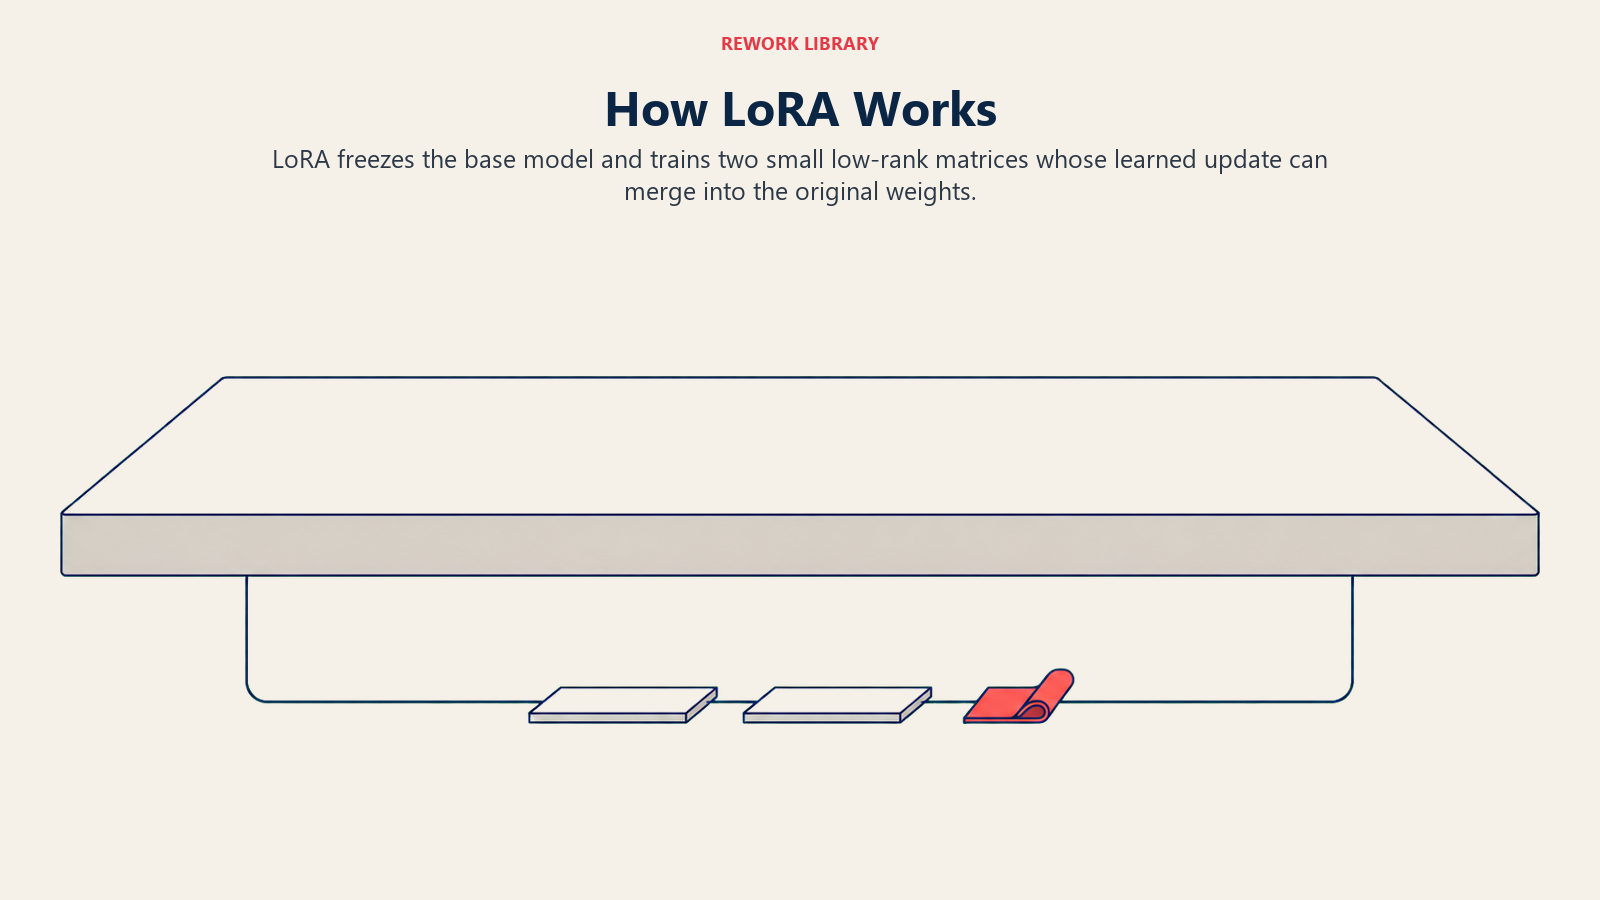
Intuisinya lebih sederhana daripada kedengarannya. Matriks bobot besar mungkin memiliki jutaan parameter, tetapi perubahan yang dibutuhkan untuk mengadaptasi model ke tugas baru atau gaya penulisan baru sering berada dalam subruang yang jauh lebih kecil. LoRA bertaruh bahwa "delta" ini, selisih antara model serbaguna dan model terspesialisasi yang Anda inginkan, dapat ditangkap oleh dua matriks kecil, bukan satu matriks raksasa. Teknik ini tumbuh dari riset transfer learning sebelumnya, yang menetapkan bahwa mengadaptasi model pre-trained ke tugas baru jarang membutuhkan training ulang dari nol.
Pada saat inference, kedua matriks kecil dapat digabungkan kembali secara matematis ke bobot asli, sehingga model yang diadaptasi dengan LoRA berjalan secepat model dasarnya. Tidak ada lapisan tambahan, tidak ada latensi tambahan, karena adapter pada dasarnya melebur ke dalam bobot setelah training selesai.
Fakta Utama: LoRA (Low-Rank Adaptation)
- LoRA memangkas jumlah parameter yang dapat dilatih sebanyak 10.000 kali dan kebutuhan memori GPU sebanyak 3 kali dibanding full fine-tuning GPT-3 175B dengan Adam, menurut makalah LoRA asli (Hu et al., 2021, arXiv:2106.09685).
- Checkpoint LoRA untuk GPT-3 175B berukuran sekitar 35MB, dibanding sekitar 350GB untuk salinan yang di-fine-tune penuh, pengurangan sekitar 10.000x pada rank r=4 (Hu et al., 2021).
- QLoRA, varian LoRA yang menambahkan kuantisasi 4-bit, men-fine-tune model 65 miliar parameter pada satu GPU 48GB sambil menyamai kualitas full fine-tuning 16-bit (Dettmers et al., 2023, arXiv:2305.14314).
Mengapa LoRA Penting untuk AI Bisnis
Bagi pemimpin bisnis, LoRA berarti Anda dapat menyesuaikan foundation model besar dengan gaya bahasa, terminologi, atau tugas perusahaan tanpa membayar compute, penyimpanan, dan waktu engineering yang dituntut full fine-tuning. Bayangkan seperti memasang attachment kecil yang dibuat khusus pada alat serbaguna, alih-alih membangun ulang seluruh alatnya dari awal.
Selisih biaya itu tidak kecil. Menurut Hu et al. (2021), LoRA mengurangi jumlah parameter yang dapat dilatih pada GPT-3 175B sebanyak 10.000 kali dan kebutuhan memori GPU sebanyak 3 kali dibanding full fine-tuning, sambil berkinerja setara atau lebih baik daripada full fine-tuning pada tugas benchmark di RoBERTa, DeBERTa, GPT-2, dan GPT-3. Kombinasi itu, kualitas hampir setara dengan sebagian kecil biaya sumber daya, adalah alasan LoRA menjadi pendekatan fine-tuning default bagi sebagian besar tim yang bekerja dengan large language model, bukan pengecualian.
Penyimpanan pun berlaku sama. Salinan GPT-3 175B yang di-fine-tune penuh membutuhkan sekitar 350GB. Adapter LoRA untuk model yang sama hanya membutuhkan sekitar 35MB (Hu et al., 2021). Artinya perusahaan dapat menyimpan puluhan adapter khusus tugas, satu untuk peninjauan dokumen hukum, satu untuk gaya bahasa customer support, satu untuk lini produk tertentu, di atas satu model dasar bersama tanpa menduplikasi ratusan gigabyte untuk tiap varian. Hu et al. mencatat bahwa menampung 100 model hasil adaptasi dengan cara ini memakan total sekitar 354GB, bukan sekitar 35TB untuk 100 salinan penuh yang terpisah.
LoRA juga memungkinkan terobosan kedua: QLoRA. Diperkenalkan oleh Dettmers et al. (2023), QLoRA menggabungkan LoRA dengan kuantisasi 4-bit pada model dasar yang dibekukan, menyusutkan kebutuhan memori hingga cukup untuk men-fine-tune model 65 miliar parameter pada satu GPU 48GB sambil mempertahankan performa tugas full fine-tuning 16-bit. Keluarga model hasil makalah itu, Guanaco, mencapai 99,3% tingkat performa ChatGPT pada benchmark Vicuna hanya setelah 24 jam fine-tuning pada satu GPU. Hasil itu memindahkan kustomisasi model besar dari cluster server multi-GPU ke satu GPU workstation bagi banyak tim.
Use Case Umum LoRA
LoRA muncul di mana saja tim membutuhkan banyak versi khusus dari satu model dasar tanpa biaya melatih ulang masing-masing secara penuh.
- Adaptasi domain. Mengajarkan LLM serbaguna kosakata industri Anda, seperti terminologi hukum, medis, atau keuangan, tanpa menyentuh model dasarnya.
- Brand voice dan tone. Menyesuaikan gaya penulisan model agar cocok dengan skrip support atau suara marketing perusahaan.
- Produk AI multi-tenant. Platform SaaS yang melayani banyak pelanggan dapat menyimpan satu model dasar bersama dan menukar adapter LoRA ringan per pelanggan, menghindari biaya penyimpanan dan serving ratusan salinan model penuh.
- Eksperimen cepat. Karena training LoRA berjalan dalam hitungan jam, bukan hari, dan membutuhkan memori GPU jauh lebih sedikit, tim dapat menguji lebih banyak ide fine-tuning dengan budget yang sama.
- Kustomisasi model gambar dan diffusion. LoRA juga banyak dipakai di luar model teks, memungkinkan seniman dan tim produk mengadaptasi model pembuat gambar ke gaya seni atau lini produk tertentu dengan file adapter kecil, bukan model hasil retraining berukuran multi-gigabyte.
- Deployment di edge dan lingkungan terbatas sumber daya. Dikombinasikan dengan teknik model optimization, adapter LoRA menjaga kemampuan terspesialisasi tetap tersedia bahkan di tempat yang tidak memiliki infrastruktur retraining penuh.
LoRA vs Full Fine-tuning vs RAG
Ketiga pendekatan ini menyelesaikan masalah yang berkaitan tetapi berbeda, dan tim sering menggabungkan lebih dari satu.
| Pendekatan | Yang diubah | Paling cocok untuk | Biaya compute/penyimpanan | Kecepatan pembaruan |
|---|---|---|---|---|
| Full fine-tuning | Setiap bobot model | Kustomisasi maksimum ketika Anda punya budget dan dataset besar berkualitas tinggi | Tertinggi (cluster GPU penuh, penyimpanan model penuh per versi) | Lambat untuk dilatih ulang |
| LoRA (dan QLoRA) | Sekumpulan kecil matriks adapter low-rank tambahan, bobot dasar tetap beku | Mengajarkan tone, terminologi, atau perilaku khusus tugas secara efisien | Rendah (satu GPU memadai, adapter berukuran MB) | Cepat dilatih ulang, adapter mudah ditukar |
| Retrieval-augmented generation | Tidak ada yang berubah di model, ia mengambil dokumen relevan saat query dan memasukkannya ke prompt | Menjaga jawaban tetap terkini untuk fakta yang cepat berubah, atau mengutip dokumen sumber tertentu | Rendah (tanpa training, hanya knowledge base terindeks) | Instan, cukup perbarui dokumen sumber |
Aturan praktisnya: gunakan RAG ketika model perlu mengetahui fakta terkini atau milik perusahaan, gunakan LoRA ketika model perlu berperilaku atau menulis secara berbeda, dan sisakan full fine-tuning untuk kasus langka ketika anggaran parameter LoRA yang lebih kecil benar-benar tidak dapat menangkap perubahan yang dibutuhkan. Banyak sistem production menggabungkan model hasil adaptasi LoRA dengan RAG untuk retrieval, karena keduanya menyelesaikan masalah yang terpisah.
Keterbatasan LoRA
LoRA bukan pengganti universal full fine-tuning, dan ada trade-off nyata.
- Pilihan rank penting. Rank yang terlalu rendah dapat underfit pada tugas kompleks, sedangkan rank yang terlalu tinggi mulai mengikis keunggulan efisiensi LoRA. Hu et al. (2021) menemukan bahwa rank sekecil satu sering kali sudah cukup untuk tugas GPT-3 yang mereka uji, tetapi ini bergantung pada tugas dan perlu divalidasi untuk setiap use case.
- Kurang ideal untuk mengajarkan pengetahuan yang benar-benar baru. LoRA baik dalam mengadaptasi perilaku dan gaya, tetapi bukan alat yang tepat untuk menyuntikkan banyak pengetahuan faktual baru yang tidak pernah dilihat model dasar. Retrieval-augmented generation atau continued pre-training umumnya menangani hal itu dengan lebih baik.
- Tetap membutuhkan model dasar yang mumpuni. LoRA mengadaptasi apa yang sudah diketahui foundation model; ia tidak dapat menutupi model dasar yang sama sekali tidak memiliki kemampuan yang mendasarinya.
- Overhead pengelolaan adapter. Menjalankan banyak adapter LoRA di production membutuhkan infrastruktur untuk memuat, menukar, dan memberi versi dengan benar, yang merupakan masalah lebih kecil daripada versioning model penuh tetapi bukan nol.
- Berbeda dari teknik kompresi. LoRA mengurangi biaya training, belum tentu biaya inference atau ukuran model saat serving (setelah digabungkan, ukuran model sama dengan model dasar). Tim yang ingin memperkecil model yang di-deploy biasanya memasangkan LoRA dengan pekerjaan model compression atau knowledge distillation yang terpisah.
Pelajari Lebih Lanjut
- Fine-tuning - kategori teknik yang lebih luas tempat LoRA berada
- Foundation Models - model dasar tempat adapter LoRA dilatih
- Large Language Models - kelas model yang menjadi target awal LoRA
- Quantization - teknik yang digabungkan QLoRA dengan LoRA
- Transfer Learning - fondasi riset yang menjadi dasar LoRA
- Knowledge Distillation - pendekatan alternatif untuk memperkecil model, bukan mengadaptasinya
Frequently Asked Questions about LoRA
Apa itu LoRA di AI, dalam satu kalimat?
LoRA (Low-Rank Adaptation) adalah metode fine-tuning hemat parameter yang membekukan bobot model pre-trained dan melatih matriks adapter kecil tambahan, menyamai sebagian besar kualitas full fine-tuning dengan sebagian kecil biaya compute dan penyimpanan.
Apakah LoRA termasuk jenis fine-tuning?
Ya. LoRA adalah teknik parameter-efficient fine-tuning (PEFT), yaitu kategori metode yang mengadaptasi model pre-trained dengan hanya memperbarui sebagian kecil parameter alih-alih seluruh model, berbeda dari full fine-tuning yang memperbarui setiap bobot.
Seberapa lebih murah LoRA dibanding full fine-tuning?
Menurut makalah LoRA asli (Hu et al., 2021), LoRA mengurangi parameter yang dapat dilatih sebanyak 10.000 kali dan kebutuhan memori GPU sebanyak 3 kali dibanding full fine-tuning GPT-3 175B dengan Adam, sambil menyamai atau melampaui kualitas full fine-tuning pada benchmark yang diuji.
Apa itu QLoRA dan apa bedanya dengan LoRA?
QLoRA menambahkan kuantisasi 4-bit pada model dasar yang dibekukan ke LoRA standar, sehingga kebutuhan memori turun lebih jauh. Dettmers et al. (2023) menunjukkan QLoRA dapat men-fine-tune model 65 miliar parameter pada satu GPU 48GB sambil mempertahankan performa full fine-tuning 16-bit.
Apakah LoRA memperlambat model saat inference?
Tidak. Setelah training selesai, matriks LoRA kecil dapat digabungkan kembali secara matematis ke bobot asli, sehingga model hasil adaptasi berjalan secepat model dasar tanpa latensi inference tambahan.
Kapan sebaiknya saya memakai LoRA, bukan RAG?
Gunakan LoRA ketika Anda ingin model menulis dengan tone berbeda, mengikuti format tertentu, atau menangani tugas khusus. Gunakan retrieval-augmented generation ketika Anda ingin model merujuk fakta terkini atau milik perusahaan, karena RAG memperbarui apa yang dilihat model saat query, bukan apa yang telah dipelajarinya.
Bisakah LoRA mengajarkan pengetahuan yang sepenuhnya baru kepada model?
Kurang efisien. LoRA lebih cocok untuk mengadaptasi perilaku dan gaya yang sudah ada daripada menyuntikkan banyak pengetahuan faktual baru. Untuk pengetahuan baru, retrieval-augmented generation atau continued pre-training biasanya lebih tepat.
Apakah LoRA hanya dipakai untuk language model?
Tidak. LoRA juga banyak dipakai untuk model gambar dan diffusion, memungkinkan tim mengadaptasi generator gambar ke gaya seni atau lini produk tertentu dengan file adapter kecil, tanpa melatih ulang model secara penuh.
Bagian dari AI Terms Collection. Terakhir diperbarui: Juli 2026
