Was ist LLMOps? Large Language Models im Produktivbetrieb
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
LLMOps ist die Gesamtheit der operativen Praktiken, um Anwendungen auf Basis von Large Language Models (LLM) im Produktivbetrieb bereitzustellen, zu überwachen und zu pflegen. Dazu gehören Prompt-Management, Evaluierung, Retrieval-Pipelines, Überwachung von Kosten und Latenz sowie Sicherheits-Guardrails, also die Arbeit, die ein LLM-Feature nach dem Launch zuverlässig hält, und nicht nur dann, wenn es in der Demo gut aussieht.
Ein Prototyp, der in einer Freitagsdemo Fragen korrekt beantwortet, und ein Feature, das täglich 50.000 Nutzern standhält, sind unterschiedliche Engineering-Probleme. Das Modell ist dasselbe. Alles drumherum ist es nicht: wie Prompts versioniert werden, wie Qualität gemessen wird, wie eine schlechte Antwort abgefangen wird, bevor ein Kunde sie sieht. Diese umgebende Disziplin ist LLMOps.
Warum LLMOps eine eigene Disziplin ist
Teams, die bereits MLOps betreiben, fragen manchmal, warum LLMs ein eigenes Playbook brauchen. Die Antwort: LLM-Anwendungen scheitern auf Arten, wie es klassische ML-Modelle nicht tun, und klassisches ML-Tooling wurde nicht dafür gebaut, sie zu erkennen.
Ein klassisches ML-Modell, etwa ein Churn-Prädiktor oder ein Betrugs-Scoring, nimmt strukturierte Eingaben entgegen und gibt eine Zahl zurück. Dafür lässt sich ein Unit-Test schreiben: Eingabe X sollte eine Ausgabe nahe Y erzeugen. Ein LLM nimmt unstrukturierten Text, einen Prompt, und liefert unstrukturierten Text, eine Antwort, und es gibt keine einzelne korrekte Antwort, gegen die man prüfen könnte. Dieselbe Frage zweimal gestellt kann zwei unterschiedliche, jeweils vertretbare Antworten liefern. Qualität ist probabilistisch, nicht binär.
LLM-Anwendungen bringen außerdem Fehlermodi mit, die es im klassischen ML nicht gibt: ein Prompt-Template, das stillschweigend bricht, wenn ein Anbieter sein Modell aktualisiert; ein Retrieval-Schritt, der das falsche Dokument liefert, während das Modell trotzdem selbstbewusst daraus antwortet; ein Kostenanstieg, weil jemand dem System-Prompt, der bei jeder Anfrage läuft, einen weiteren Absatz hinzugefügt hat. Nichts davon erscheint in einer Trainingsmetrik. Es zeigt sich im Produktivbetrieb, oft unbemerkt, und genau solche Probleme soll AI Observability erkennen.
Der LLMOps-Lebenszyklus
LLMOps ist nicht ein Tool oder ein Schritt. Es ist ein Satz verbundener Praktiken, die kontinuierlich laufen, sobald ein LLM-Feature live ist.
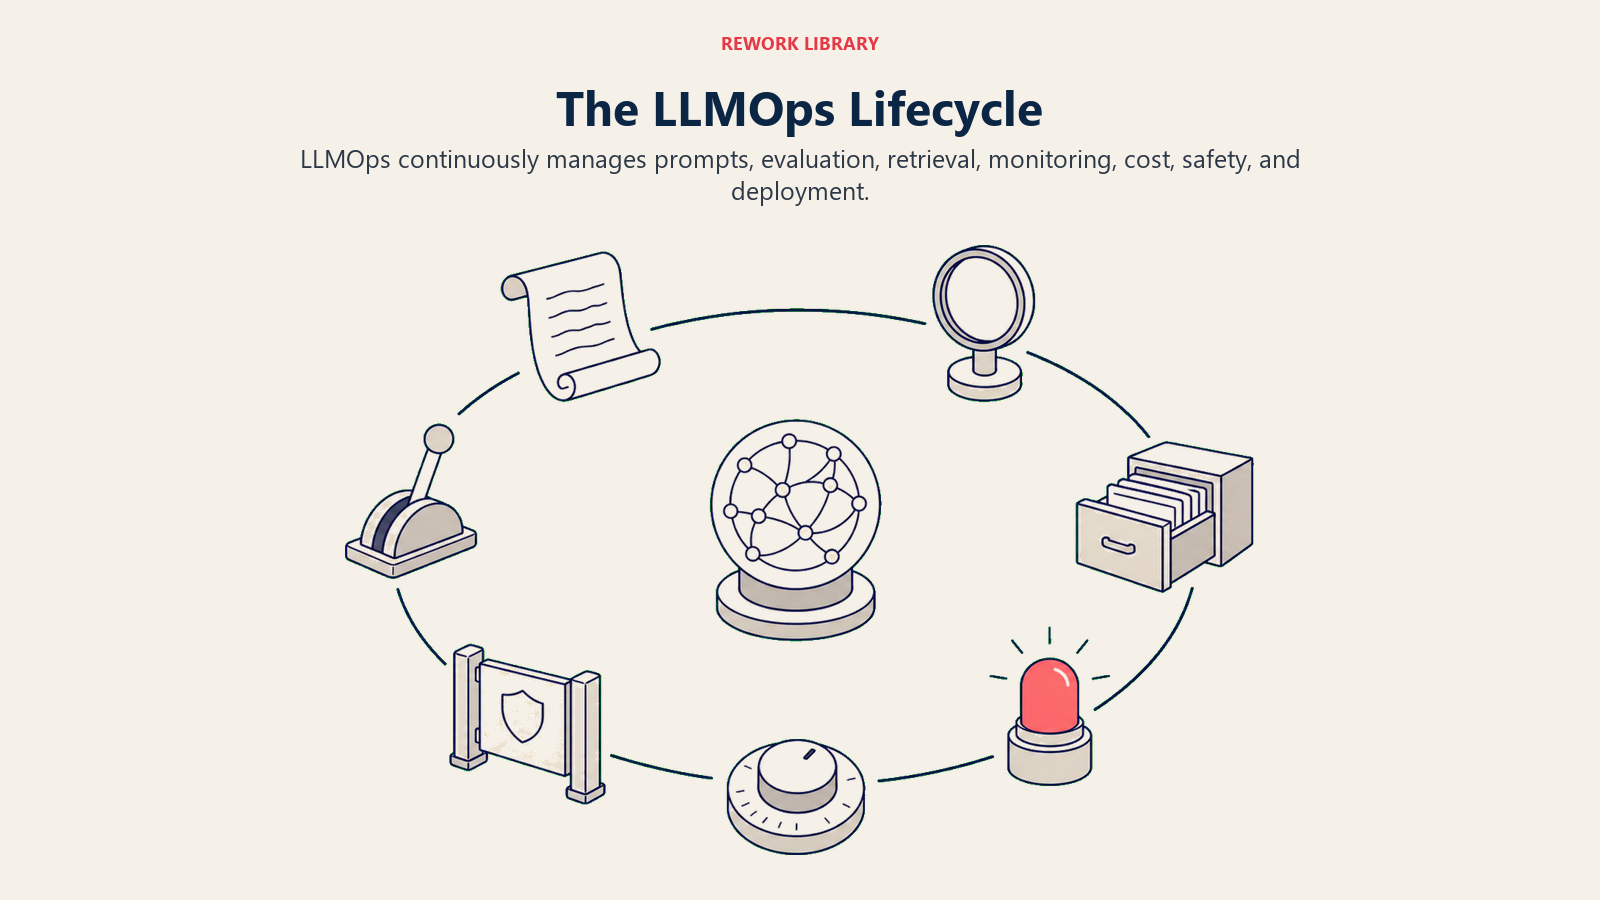
Prompt-Management. Prompts sind die Schnittstelle zwischen Ihrer Anwendung und dem Modell und brauchen dieselbe Disziplin wie Code: Versionskontrolle, Change Review und Rollback. Ein Prompt, der mit einer Modellversion gut funktioniert, kann mit der nächsten schleichend schlechter werden, sofern niemand nachverfolgt, welche Prompt-Version mit welcher Modellversion ausgeliefert wurde und was mit der Ausgabequalität passierte, als sich eines von beiden änderte.
Evaluierung. Weil sich LLM-Ausgaben nicht mit einer einfachen Assertion prüfen lassen, bauen Teams Evaluierungssets: repräsentative Eingaben mit bewertetem Soll-Verhalten, bewertet durch automatisierte Scorer, Referenzmodelle oder menschliche Rater. Evals laufen, bevor eine Prompt- oder Modelländerung ausgeliefert wird (um Regressionen zu finden), und kontinuierlich im Produktivbetrieb (um Drift zu finden). Ohne Eval-Set ist die Frage, ob eine Änderung das Produkt besser oder schlechter gemacht hat, reine Vermutung.
Verwaltung der RAG-Pipeline. Die meisten LLM-Anwendungen in Unternehmen nutzen Retrieval-Augmented Generation, um Antworten in Unternehmensdaten zu verankern, statt sich auf das beim Training Gelernte zu verlassen. LLMOps deckt auch die Retrieval-Hälfte dieser Pipeline ab: die Wissensbasis aktuell halten, die Retrieval-Qualität überwachen (findet das System das richtige Dokument, nicht nur irgendein Dokument) und den Fall erkennen, in dem das Retrieval gelingt, das Modell den abgerufenen Kontext aber trotzdem ignoriert.
Monitoring und Observability. Produktive LLM-Systeme brauchen Logs jedes Prompts und jeder Antwort, Traces mehrstufiger Ketten und Metriken zu Latenz, Fehlerrate und Ausgabequalität im Zeitverlauf. Das ist dieselbe Drei-Säulen-Disziplin, die allgemein bei AI Observability gilt, hier speziell auf Prompts, Tokens und Modellaufrufe angewandt.
Management von Kosten und Latenz. Jeder LLM-Aufruf verursacht Kosten pro Token und Kosten durch Antwortzeit, und beide skalieren direkt mit der Nutzung. LLMOps verfolgt Kosten pro Anfrage, Kosten pro Feature und Latenz-Perzentile und setzt Techniken wie Caching, Prompt-Kürzung und Model Routing ein (einfache Anfragen an ein günstigeres Modell, schwierige an ein Frontier-Modell), um beides bei wachsendem Traffic im Griff zu behalten.
Guardrails und Sicherheit. Produktive LLM-Anwendungen brauchen Prüfungen, die laufen, bevor eine Antwort den Nutzer erreicht: Filter für schädliche Inhalte, Erkennung von Prompt-Injection-Versuchen, Blockieren von Ausgaben, die sensible Daten preisgeben, und die Durchsetzung, dass das Modell beim vorgesehenen Thema bleibt. Guardrails sind die letzte Verteidigungslinie zwischen der Rohausgabe eines Modells und der Person, die sie liest.
Deployment und Versionierung. Der Rollout eines neuen Prompts, einer neuen Modellversion oder eines neuen Retrieval-Index braucht dieselbe gestufte Rollout-Disziplin wie jede Änderung an produktiver Software: Canary Releases, A/B-Vergleich mit der aktuellen Version und einen schnellen Rollback-Pfad, wenn ein Eval-Score oder eine nutzerseitige Metrik in die falsche Richtung läuft.
LLMOps vs. MLOps
LLMOps ist aus MLOps hervorgegangen, und beide teilen viel DNA: Beide legen Wert auf Versionierung, Monitoring und zuverlässiges Deployment. Aber das betriebene Objekt unterscheidet sich so stark, dass die Praktiken an bestimmten Stellen auseinanderlaufen.
| Dimension | MLOps | LLMOps |
|---|---|---|
| Zentrales Artefakt | Ein trainiertes Modell mit festen, numerischen Ausgaben | Ein Prompt plus ein Modell (oft eine API eines Drittanbieters, nichts, was Sie selbst trainiert haben) |
| Qualitätsprüfung | Accuracy, Precision, Recall gegen ein gelabeltes Testset | Evaluierungssets, bewertet durch automatisierte Scorer, Referenzmodelle oder menschliche Rater |
| Wichtigster Fehlermodus | Data Drift, Modellverfall, nachlassende Accuracy im Zeitverlauf | Halluzination, Prompt-Regression, Retrieval-Fehler, stille Modelländerungen des Anbieters |
| Was versioniert wird | Modellgewichte, Trainingsdaten, Feature-Pipelines | Prompt-Templates, Retrieval-Indizes, Modellversion und die Kombination aller drei |
| Kostentreiber | Trainings-Compute (überwiegend vorab, danach periodisches Retraining) | Inferenz (laufend, skaliert direkt mit der Nutzung, pro API-Aufruf) |
| Typisches Deployment | Sie trainieren und besitzen das Modell | Sie rufen häufig das Modell eines anderen per API auf und betreiben alles drumherum |
Die praktische Erkenntnis: Betreibt Ihr Team bereits MLOps, starten Sie nicht bei null. Aber eine MLOps-Pipeline, die für ein Churn-Modell gebaut wurde, erkennt weder eine Prompt-Regression noch einen Retrieval-Fehler, weil sie nie dafür ausgelegt war.
Die LLMOps-Tool-Landschaft
Die Tool-Kategorie ist jung und konsolidiert sich noch, aber einige Tool-Typen sind in produktiven LLM-Stacks üblich geworden.
Observability- und Tracing-Plattformen wie LangSmith und Langfuse erfassen den vollständigen Trace einer Anfrage durch Prompts, Retrieval-Aufrufe und Modellantworten, sodass Teams eine bestimmte schlechte Ausgabe debuggen können, indem sie genau wiedergeben, was das System gesehen und zurückgegeben hat.
Evaluierungs- und Monitoring-Plattformen wie Arize übernehmen sowohl Offline-Evals (bevor eine Änderung ausgeliefert wird) als auch Produktiv-Monitoring (Drift, Qualitätsscores und Anomalieerkennung auf Live-Traffic), oft für klassische ML- und LLM-Workloads auf derselben Plattform.
Tools für Experiment-Tracking wie Weights and Biases, ursprünglich für klassische ML-Trainingsläufe gebaut, wurden um Prompt- und LLM-Experiment-Tracking erweitert und erlauben Teams, Prompt-Varianten und Modellversionen mit protokollierten Metriken nebeneinander zu vergleichen.
Die meisten Teams führen nicht alles auf einmal ein. Ein üblicher Start ist strukturiertes Logging jedes LLM-Aufrufs (Prompt, Antwort, Modellversion, Token-Anzahl, Latenz), dann eine dedizierte Observability-Plattform, sobald das Volumen des Produktiv-Traffics manuelle Prüfung unpraktikabel macht, und schließlich systematische Evaluierung, sobald genug protokollierte Daten für ein repräsentatives Eval-Set vorliegen. Unser Vergleich von LLM-Observability-Plattformen bepreist 12 davon bei realem Trace-Volumen.
Wichtige Fakten
- Gartner prognostiziert, dass bis 2028 40 % der Organisationen, die AI einsetzen, dedizierte AI-Observability-Tools nutzen werden, um Modellleistung, Bias und Ausgaben zu überwachen, laut einer Gartner-Pressemitteilung zur Verbreitung von AI Observability.
- Gartner prognostiziert, dass mindestens 30 % der Generative-AI-Projekte bis Ende 2025 nach dem Proof of Concept aufgegeben werden, aufgrund schlechter Datenqualität, unzureichender Risikokontrollen, steigender Kosten oder unklaren Geschäftsnutzens.
- 74 % der Führungskräfte berichten von einem ROI im ersten Jahr durch AI-Deployments, aber nur 39 % von einem Effekt auf das EBIT auf Unternehmensebene, laut der McKinsey-Studie State of AI zur Lücke zwischen Pilotierung und Skalierung von AI.
- Die Ausgaben für Generative-AI-Software in Unternehmen erreichten 2025 37 Milliarden US-Dollar, nach 11,5 Milliarden US-Dollar im Jahr 2024, das 3,2-Fache im Jahresvergleich, laut dem Bericht 2025 State of Generative AI in the Enterprise von Menlo Ventures.
- Nur 16 % der Enterprise-AI-Deployments sind echte autonome Agents; die meisten Produktivsysteme basieren weiterhin auf Workflows mit fester Abfolge oder Routing rund um einen einzelnen Modellaufruf, laut demselben Bericht von Menlo Ventures.
- 37 % der Unternehmen nutzen inzwischen fünf oder mehr Modelle im Produktivbetrieb, gegenüber 29 % im Vorjahr, laut dem Enterprise-AI-Bericht 2025 von a16z, ein Zeichen für die Multi-Modell-Orchestrierung, die LLMOps zunehmend verwalten muss.
Warum LLMOps für Enterprise AI wichtig ist
Die Lücke zwischen einer funktionierenden Demo und einem produktionsreifen LLM-Feature ist genau die Stelle, an der die meisten Enterprise-AI-Initiativen ins Stocken geraten. Gartners Prognose, dass 30 % der Generative-AI-Projekte nach dem Proof of Concept aufgegeben werden, und der Befund von Menlo Ventures, dass die meisten Deployments weiterhin einfache Single-Model-Workflows statt reifer agentischer Systeme sind, deuten auf dasselbe zugrunde liegende Problem: Den Modellaufruf zu bauen ist der einfache Teil. Ihn zuverlässig, skaliert, mit vorhersehbaren Kosten und vertretbarem Risiko zu betreiben, trennt einen Piloten von einem Produkt.
Hier zeigt sich auch die ROI-Lücke von McKinsey. 74 % der Führungskräfte berichten von einem gewissen Ertrag im ersten Jahr, aber nur 39 % sehen Effekte auf Unternehmensebene, was dazu passt, was geschieht, wenn ein Team ein LLM-Feature ohne die operative Schicht darum herum ausliefert. Es funktioniert für die ersten paar hundert Nutzer, dann bricht ein Prompt-Update es stillschweigend, oder die Kosten steigen mit der Nutzung, oder niemand bemerkt, wie die Ausgabequalität sinkt, bis sich ein Kunde beschwert. LLMOps ist der Unterschied zwischen einem AI-Feature, das den Kontakt mit echter Nutzung übersteht, und einem, das sechs Monate später leise zurückgenommen werden muss.
Der Multi-Modell-Trend fügt eine weitere Ebene hinzu: a16z stellte fest, dass Unternehmen zunehmend fünf oder mehr Modelle im Produktivbetrieb laufen lassen, statt auf eines zu setzen, und Routineaufgaben an günstigere Modelle leiten, während Frontier-Modelle für anspruchsvolleres Reasoning reserviert bleiben. Diese Routing-Entscheidung und das dafür nötige Kosten- und Qualitätstracking ist selbst eine LLMOps-Funktion. Mit der wachsenden Komplexität von LLM-Anwendungen, von einzelnen Prompts über RAG-Pipelines bis zu mehrstufigen agentischen Workflows, wächst auch die operative Angriffsfläche. Teams, die LLMOps als Nachgedanken behandeln, erfahren von Problemen meist durch ihre Nutzer. Teams, die es von Anfang an einbauen, erfahren davon durch ihr eigenes Monitoring, bevor es zu einem Support-Ticket wird.
Häufig gestellte Fragen zu LLMOps
Was ist LLMOps?
LLMOps ist die Gesamtheit der operativen Praktiken, um Anwendungen auf Basis von Large Language Models im Produktivbetrieb bereitzustellen, zu überwachen und zu pflegen. Dazu gehören Prompt-Management, Evaluierung, Verwaltung der RAG-Pipeline, Observability, Kosten- und Latenzkontrolle sowie Sicherheits-Guardrails, also die Arbeit, die ein LLM-Feature nach dem Launch zuverlässig hält.
Wie unterscheidet sich LLMOps von MLOps?
MLOps arbeitet mit einem trainierten Modell mit numerischen, prüfbaren Ausgaben und konzentriert sich auf Data Drift und Modellverfall. LLMOps arbeitet mit einem Prompt plus einem Modell, auf das oft per API zugegriffen wird, statt es intern zu trainieren, und konzentriert sich auf Prompt-Regressionen, Halluzination und Retrieval-Fehler. LLMOps übernimmt die Disziplin von MLOps bei Versionierung und Monitoring, wendet sie aber auf andere Fehlermodi an.
Braucht man spezialisierte LLMOps-Tools, um anzufangen?
Nicht am ersten Tag. Viele Teams beginnen mit strukturiertem Logging jedes LLM-Aufrufs (Prompt, Antwort, Modellversion, Tokens, Latenz) in ihren bestehenden Systemen. Dedizierte Plattformen wie LangSmith, Langfuse, Arize oder Weights and Biases bringen Mehrwert, sobald das Volumen des Produktiv-Traffics manuelle Prüfung unpraktikabel macht oder sobald Sie systematische Evaluierung im großen Maßstab brauchen.
Was ist ein Prompt-Evaluierungsset und warum ist es wichtig?
Ein Evaluierungsset ist eine Sammlung repräsentativer Eingaben mit bewertetem Soll-Verhalten, bewertet durch automatisierte Scorer, Referenzmodelle oder menschliche Rater. Da sich LLM-Ausgaben nicht wie bei klassischer Software mit einer einfachen Bestanden/Nicht-bestanden-Assertion prüfen lassen, ist ein Eval-Set der Weg, mit dem Teams erkennen, ob eine Prompt- oder Modelländerung das Produkt besser oder schlechter gemacht hat, bevor sie ausgeliefert wird.
Welche Rolle spielt RAG in LLMOps?
Retrieval-Augmented Generation fügt vor der Antwortgenerierung des Modells einen Retrieval-Schritt hinzu, der die Antwort in Unternehmensdaten verankert. LLMOps sorgt dafür, dass diese Retrieval-Pipeline gesund bleibt: überwachen, ob das System die richtigen Dokumente findet, Fälle erkennen, in denen das Modell guten abgerufenen Kontext ignoriert, und die zugrunde liegende Wissensbasis aktuell halten.
Woran scheitern die meisten LLM-Anwendungen, sobald sie echte Nutzer erreichen?
Häufige Ursachen sind Prompt-Regressionen, nachdem ein Anbieter ein Modell aktualisiert hat, Retrieval-Pipelines, die den falschen Kontext liefern, Kostenspitzen durch unüberwachten Token-Verbrauch und Qualitätsdrift, die ohne laufende Evaluierung unbemerkt bleibt. Diese Fehler sind in der Regel still: Sie lösen keine Fehlermeldungen aus, sondern liefern leise schlechtere Ausgaben. Deshalb sind Observability und Evaluierung zentrale LLMOps-Funktionen und keine optionalen Extras.
Was sind Guardrails in LLMOps?
Guardrails sind Prüfungen, die laufen, bevor die Ausgabe eines LLM den Nutzer erreicht: Filter für schädliche Inhalte, Erkennung von Prompt-Injection-Versuchen, Blockieren von Datenlecks bei sensiblen Daten und Sicherstellen, dass Antworten beim Thema bleiben. Sie sind die letzte operative Schicht zwischen der Rohausgabe eines Modells und der Person, die sie liest.
Ist LLMOps nur für Teams relevant, die eigene Modelle bauen?
Nein. Die meisten LLM-Anwendungen in Unternehmen rufen ein Modell eines Drittanbieters per API auf, statt eines zu trainieren. Das heißt, LLMOps-Praktiken wie Prompt-Management, Evaluierung, RAG-Monitoring, Kostentracking und Guardrails sind genau das, was ein Team braucht, unabhängig davon, ob es das zugrunde liegende Modell selbst trainiert hat.
Verwandte AI-Konzepte
- MLOps - Die übergeordnete Disziplin, die LLMOps erweitert und die den gesamten Machine-Learning-Lebenszyklus abdeckt
- AI Observability - Die Disziplin aus Logs, Traces und Metriken, die LLMOps speziell auf LLM-Aufrufe anwendet
- Large Language Models - Die Modellkategorie, die LLMOps zuverlässig betreiben soll
- Retrieval-Augmented Generation - Die Retrieval-Pipelines, die LLMOps neben dem Modell gesund halten muss
- AI Hallucination - Ein zentraler Fehlermodus, den Evaluierung und Guardrails in LLMOps abfangen sollen
- Inferenz - Die Produktivphase, in der die Kosten- und Latenzpraktiken von LLMOps greifen
- Prompt Engineering - Die vorgelagerte Praxis, die LLMOps im Produktivbetrieb versioniert und überwacht
- Model Monitoring - Die laufende Überwachungsdisziplin, die LLMOps auf das Verhalten produktiver LLMs anwendet
Externe Ressourcen
- LangSmith - Observability- und Evaluierungsplattform für LLM-Anwendungen
- Langfuse - Open-Source-Plattform für LLM-Observability und Tracing
- Arize AI - Plattform für ML- und LLM-Observability und Evaluierung
- Weights and Biases - Experiment-Tracking, erweitert um den Vergleich von LLM-Prompts und Modellen
