Apakah LLMOps? Menjalankan Large Language Models dalam Pengeluaran
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
LLMOps ialah set amalan operasi untuk melancar, memantau, dan menyelenggara aplikasi large language model (LLM) dalam pengeluaran. Ia merangkumi pengurusan prompt, penilaian, saluran pencarian, pemantauan kos dan kependaman, serta pagar keselamatan, iaitu kerja yang memastikan ciri LLM kekal boleh dipercayai selepas dilancarkan, bukan hanya ketika demo berjalan lancar.
Prototaip yang menjawab soalan dengan betul dalam demo hari Jumaat dan ciri yang bertahan untuk 50,000 pengguna sehari ialah dua masalah kejuruteraan yang berbeza. Modelnya sama. Segala yang mengelilinginya tidak sama: cara prompt diberi versi, cara kualiti diukur, cara respons yang buruk dikesan sebelum pelanggan melihatnya. Disiplin sekeliling itulah LLMOps.
Mengapa LLMOps Wujud Sebagai Disiplin Tersendiri
Pasukan yang sudah menjalankan MLOps kadangkala bertanya mengapa LLM memerlukan buku panduan yang berasingan. Jawapannya ialah aplikasi LLM gagal dengan cara yang tidak berlaku pada model ML tradisional, dan perkakasan ML tradisional tidak dibina untuk mengesannya.
Model ML klasik, seperti peramal churn atau penskor fraud, menerima input berstruktur dan memulangkan satu nombor. Anda boleh menulis ujian unit untuknya: input X sepatutnya menghasilkan output hampir Y. LLM menerima teks tidak berstruktur, iaitu prompt, dan memulangkan teks tidak berstruktur, iaitu respons, dan tiada satu jawapan betul untuk disemak. Soalan yang sama ditanya dua kali boleh menghasilkan dua respons yang berbeza tetapi kedua-duanya boleh dipertahankan. Kualiti bersifat probabilistik, bukan binari.
Aplikasi LLM juga membawa mod kegagalan yang tidak wujud dalam ML klasik: templat prompt yang rosak secara senyap apabila vendor mengemas kini model mereka, langkah pencarian yang memulangkan dokumen yang salah lalu model menjawab daripadanya dengan penuh keyakinan, lonjakan kos kerana seseorang menambah satu perenggan lagi pada system prompt yang dijalankan pada setiap permintaan. Tiada satu pun daripadanya muncul sebagai metrik latihan. Ia muncul dalam pengeluaran, selalunya secara senyap, dan itulah jenis masalah yang AI observability wujud untuk mengesan.
Kitaran Hayat LLMOps
LLMOps bukan satu tool atau satu langkah. Ia ialah set amalan yang saling berkaitan dan berjalan secara berterusan sebaik sahaja ciri LLM dilancarkan.
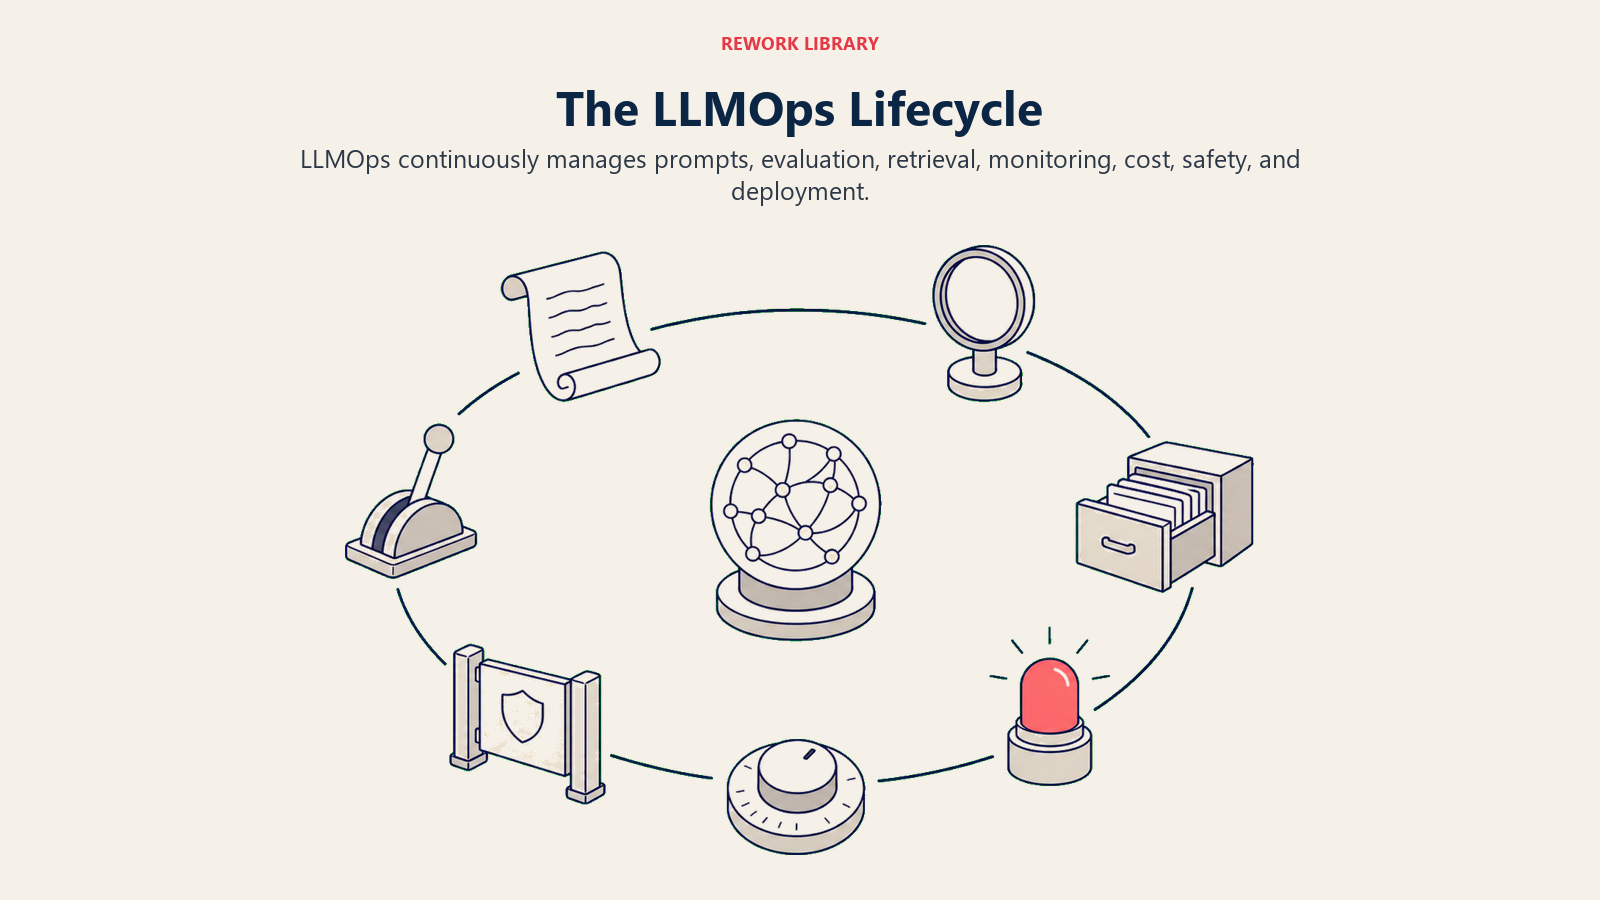
Pengurusan prompt. Prompt ialah antara muka antara aplikasi anda dan model, dan ia memerlukan disiplin yang sama seperti kod: kawalan versi, semakan perubahan, dan rollback. Prompt yang berfungsi baik pada satu versi model boleh merosot pada versi seterusnya, secara senyap, kecuali ada yang menjejaki versi prompt mana yang dilancarkan bersama versi model mana dan apa yang berlaku pada kualiti output apabila salah satunya berubah.
Penilaian. Oleh kerana output LLM tidak boleh disemak dengan penegasan mudah, pasukan membina set penilaian: input yang mewakili dipasangkan dengan tingkah laku jangkaan yang digredkan, dan dinilai oleh penskor automatik, model rujukan, atau penilai manusia. Eval dijalankan sebelum perubahan prompt atau model dilancarkan (untuk mengesan regresi) dan secara berterusan dalam pengeluaran (untuk mengesan drift). Tanpa set eval, "adakah perubahan ini menjadikan produk lebih baik atau lebih teruk" hanyalah satu tekaan.
Pengurusan saluran RAG. Kebanyakan aplikasi LLM perniagaan menggunakan retrieval-augmented generation untuk mengukuhkan respons dengan data syarikat dan bukannya bergantung pada apa yang model hafal semasa latihan. LLMOps turut meliputi separuh pencarian daripada saluran itu: memastikan pangkalan pengetahuan sentiasa terkini, memantau kualiti pencarian (adakah sistem menemui dokumen yang betul, bukan sekadar mana-mana dokumen), dan mengesan kes apabila pencarian berjaya tetapi model tetap mengabaikan konteks yang diperoleh.
Pemantauan dan observability. Sistem LLM pengeluaran memerlukan log bagi setiap prompt dan respons, jejak bagi rantaian berbilang langkah, dan metrik kependaman, kadar ralat, serta kualiti output dari semasa ke semasa. Ini ialah disiplin tiga tonggak yang sama yang digunakan dalam AI observability secara amnya, dikenakan khusus pada prompt, token, dan panggilan model.
Pengurusan kos dan kependaman. Setiap panggilan LLM mempunyai kos per token dan kos masa respons, dan kedua-duanya berskala terus dengan penggunaan. LLMOps menjejaki kos per permintaan, kos per ciri, dan persentil kependaman, serta menerapkan teknik seperti caching, pemangkasan prompt, dan penghalaan model (menghantar pertanyaan mudah ke model yang lebih murah dan yang sukar ke model frontier) untuk mengawal kedua-duanya apabila trafik meningkat.
Guardrails dan keselamatan. Aplikasi LLM pengeluaran memerlukan semakan yang berjalan sebelum respons sampai kepada pengguna: menapis kandungan berbahaya, mengesan percubaan prompt injection, menyekat output yang membocorkan data sensitif, dan memastikan model kekal pada topik untuk kes penggunaan yang dimaksudkan. Guardrails ialah benteng pertahanan terakhir antara output mentah model dan orang yang membacanya.
Pelancaran dan pemberian versi. Melancarkan prompt baharu, versi model baharu, atau indeks pencarian baharu memerlukan disiplin pelancaran berperingkat yang sama seperti mana-mana perubahan perisian pengeluaran: canary release, perbandingan A/B dengan versi semasa, dan laluan rollback yang pantas apabila skor eval atau metrik yang dilihat pengguna bergerak ke arah yang salah.
LLMOps lwn MLOps
LLMOps berkembang daripada MLOps, dan kedua-duanya berkongsi banyak asas: kedua-duanya mementingkan pemberian versi, pemantauan, dan pelancaran yang boleh dipercayai. Tetapi objek yang dikendalikan cukup berbeza sehingga amalannya menyimpang dalam cara tertentu.
| Dimensi | MLOps | LLMOps |
|---|---|---|
| Artifak teras | Model terlatih dengan output berangka yang tetap | Prompt ditambah model (selalunya API pihak ketiga, bukan sesuatu yang anda latih) |
| Semakan kualiti | Ketepatan, precision, recall berbanding set ujian berlabel | Set penilaian yang dinilai oleh penskor automatik, model rujukan, atau penilai manusia |
| Mod kegagalan utama | Data drift, kemerosotan model, ketepatan merosot dari semasa ke semasa | Halusinasi, regresi prompt, kegagalan pencarian, perubahan model vendor secara senyap |
| Apa yang diberi versi | Berat model, data latihan, saluran ciri | Templat prompt, indeks pencarian, versi model, dan gabungan ketiga-tiganya |
| Pemacu kos | Pengiraan latihan (kebanyakannya di awal, kemudian latihan semula berkala) | Inferens (berterusan, berskala terus dengan penggunaan, bagi setiap panggilan API) |
| Pelancaran lazim | Anda melatih dan memiliki model | Anda selalunya memanggil model orang lain melalui API dan mengendalikan segala yang mengelilinginya |
Kesimpulan praktikalnya: jika pasukan anda sudah menjalankan MLOps, anda tidak bermula dari sifar. Tetapi saluran MLOps yang dibina untuk model churn tidak akan mengesan regresi prompt atau kegagalan pencarian, kerana ia tidak pernah dibina untuk mencari perkara itu.
Landskap Tool LLMOps
Kategori perkakasan ini masih muda dan masih menyatu, tetapi beberapa jenis tool sudah menjadi lazim dalam stack LLM pengeluaran.
Platform observability dan tracing seperti LangSmith dan Langfuse merakam jejak penuh sesuatu permintaan melalui prompt, panggilan pencarian, dan respons model, supaya pasukan boleh menyahpepijat output buruk tertentu dengan memainkan semula apa yang dilihat dan dipulangkan oleh sistem.
Platform penilaian dan pemantauan seperti Arize mengendalikan eval luar talian (sebelum perubahan dilancarkan) dan pemantauan pengeluaran (drift, skor kualiti, dan pengesanan anomali pada trafik langsung), selalunya merentasi beban kerja ML tradisional dan LLM dalam satu platform.
Tool penjejakan eksperimen seperti Weights and Biases, yang asalnya dibina untuk larian latihan ML klasik, telah berkembang ke penjejakan eksperimen prompt dan LLM, membolehkan pasukan membandingkan varian prompt dan versi model bersebelahan dengan metrik yang direkodkan.
Kebanyakan pasukan tidak menggunakan semuanya sekaligus. Titik permulaan yang lazim ialah pengelogan berstruktur bagi setiap panggilan LLM (prompt, respons, versi model, bilangan token, kependaman), kemudian menambah platform observability khusus sebaik sahaja jumlah trafik pengeluaran menjadikan semakan manual tidak praktikal, kemudian menambah penilaian sistematik apabila terdapat cukup data log untuk membina set eval yang mewakili. Perbandingan platform LLM observability kami meletakkan harga 12 daripadanya pada volum trace sebenar.
Fakta Utama
- Gartner meramalkan bahawa 40% organisasi yang melaksanakan AI akan menggunakan tool AI observability khusus untuk memantau prestasi model, bias, dan output menjelang 2028, menurut kenyataan akhbar Gartner mengenai penggunaan AI observability.
- Gartner meramalkan sekurang-kurangnya 30% projek generative AI akan ditinggalkan selepas proof of concept menjelang akhir 2025, dengan menyebut kualiti data yang lemah, kawalan risiko yang tidak memadai, kos yang meningkat, atau nilai perniagaan yang tidak jelas.
- 74% eksekutif melaporkan ROI tahun pertama daripada pelaksanaan AI, tetapi hanya 39% melaporkan kesan EBIT di peringkat enterprise, menurut kajian State of AI McKinsey mengenai jurang antara perintis dan penskalaan AI.
- Perbelanjaan perisian generative AI enterprise mencecah $37 bilion pada 2025, meningkat daripada $11.5 bilion pada 2024, iaitu peningkatan 3.2x tahun ke tahun, menurut laporan 2025 State of Generative AI in the Enterprise daripada Menlo Ventures.
- Hanya 16% pelaksanaan AI enterprise layak sebagai agent autonomi sebenar, dengan kebanyakan sistem pengeluaran masih dibina di sekitar aliran kerja berurutan tetap atau berasaskan penghalaan di sekeliling satu panggilan model, menurut laporan Menlo Ventures yang sama.
- 37% enterprise kini menggunakan lima atau lebih model dalam pengeluaran, meningkat daripada 29% tahun sebelumnya, menurut laporan AI enterprise 2025 a16z, tanda orkestrasi berbilang model yang semakin perlu diurus oleh LLMOps.
Mengapa LLMOps Penting untuk Enterprise AI
Jurang antara demo yang berfungsi dan ciri LLM bertaraf pengeluaran ialah tempat kebanyakan inisiatif AI enterprise tersekat. Ramalan Gartner bahawa 30% projek generative AI ditinggalkan selepas proof of concept, dan penemuan Menlo Ventures bahawa kebanyakan pelaksanaan masih aliran kerja model tunggal yang mudah dan bukannya sistem agentic yang matang, kedua-duanya menunjuk kepada masalah asas yang sama: membina panggilan model ialah bahagian yang mudah. Mengendalikannya dengan boleh dipercayai, pada skala besar, dengan kos yang boleh diramal dan risiko yang boleh diterima, ialah bahagian yang memisahkan perintis daripada produk.
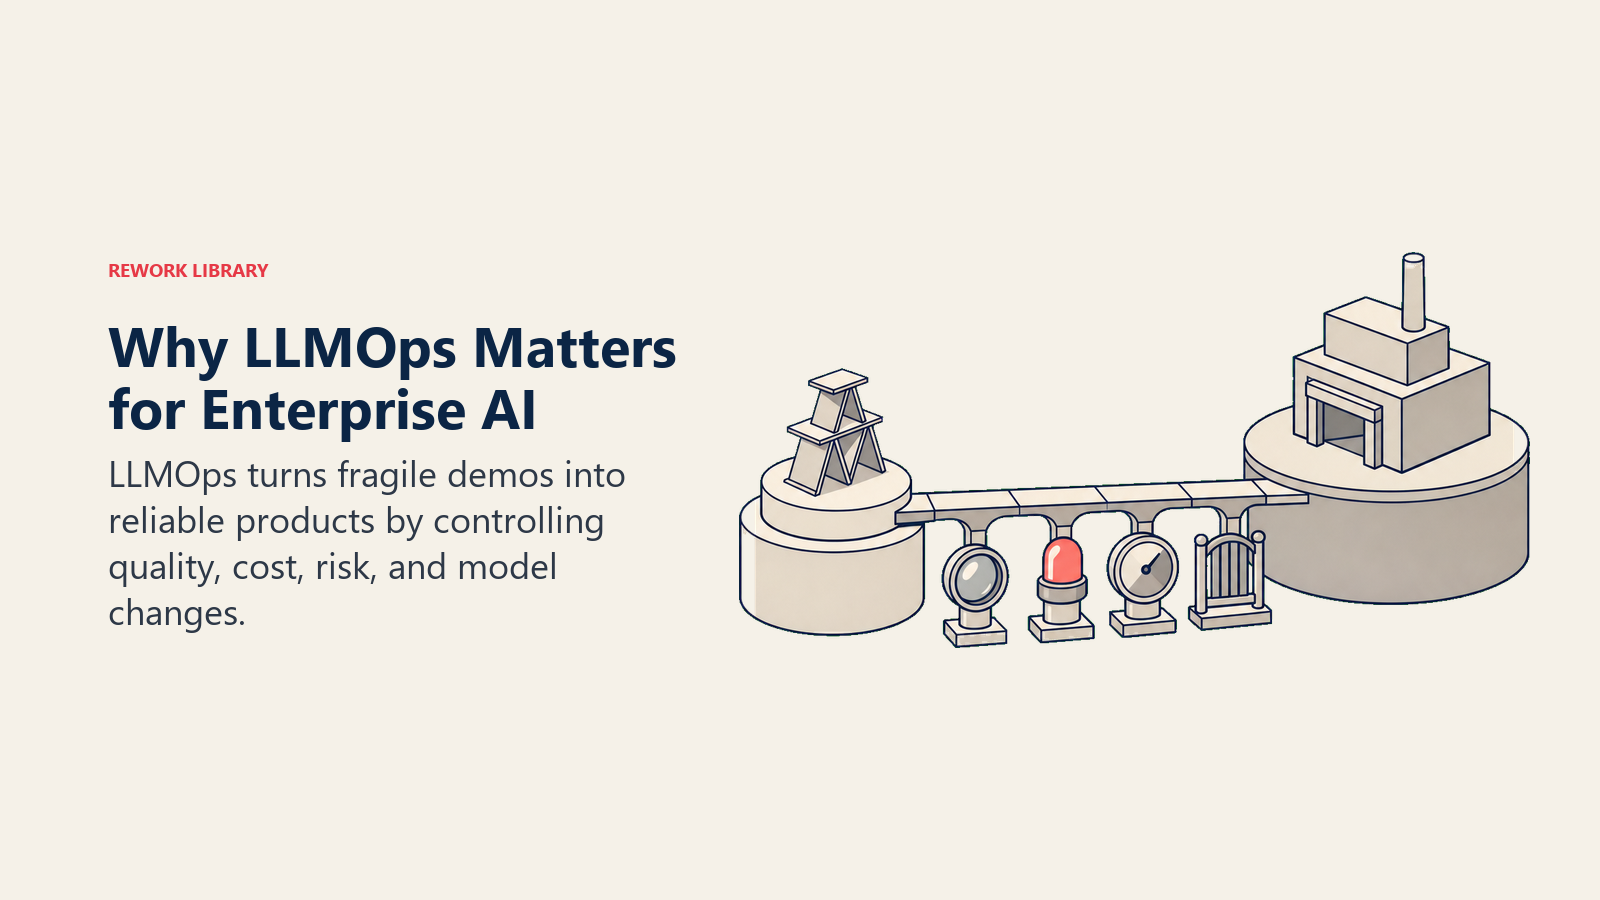
Di situlah jurang ROI McKinsey muncul. 74% eksekutif melaporkan sedikit pulangan tahun pertama, tetapi hanya 39% melihat kesan di peringkat enterprise, yang sejajar dengan apa yang berlaku apabila pasukan melancarkan ciri LLM tanpa lapisan operasi di sekelilingnya. Ia berfungsi untuk beberapa ratus pengguna pertama, kemudian kemas kini prompt merosakkannya secara senyap, atau kos melonjak apabila penggunaan meningkat, atau tiada siapa perasan kualiti output merosot sehingga pelanggan mengadu. LLMOps ialah perbezaan antara ciri AI yang bertahan menghadapi penggunaan sebenar dan yang terpaksa ditarik balik secara senyap enam bulan kemudian.
Trend berbilang model menambah satu lagi lapisan: a16z mendapati enterprise semakin menjalankan lima atau lebih model dalam pengeluaran dan bukannya bertaruh pada satu, menghalakan tugas rutin ke model yang lebih murah dan mengekalkan model frontier untuk penaakulan yang lebih sukar. Keputusan penghalaan itu, serta penjejakan kos dan kualiti yang diperlukannya, sendiri ialah fungsi LLMOps. Apabila aplikasi LLM menjadi lebih kompleks, daripada prompt tunggal kepada saluran RAG hingga aliran kerja agentic berbilang langkah, permukaan operasi turut berkembang bersamanya. Pasukan yang menganggap LLMOps sebagai perkara susulan lazimnya mengetahui masalah daripada pengguna. Pasukan yang membinanya sejak awal mengetahuinya daripada pemantauan mereka sendiri, sebelum ia menjadi tiket sokongan.
Soalan Lazim tentang LLMOps
Apakah LLMOps?
LLMOps ialah set amalan operasi untuk melancar, memantau, dan menyelenggara aplikasi large language model dalam pengeluaran. Ia merangkumi pengurusan prompt, penilaian, pengurusan saluran RAG, observability, kawalan kos dan kependaman, serta pagar keselamatan, iaitu kerja yang diperlukan untuk memastikan ciri LLM kekal boleh dipercayai selepas pelancaran.
Bagaimanakah LLMOps berbeza daripada MLOps?
MLOps mengendalikan model terlatih dengan output berangka yang boleh disemak dan menumpukan pada data drift serta kemerosotan model. LLMOps mengendalikan prompt ditambah model, yang selalunya diakses melalui API dan bukannya dilatih sendiri, dan menumpukan pada regresi prompt, halusinasi, dan kegagalan pencarian. LLMOps meminjam disiplin MLOps tentang pemberian versi dan pemantauan tetapi menerapkannya pada set mod kegagalan yang berbeza.
Adakah anda memerlukan tool LLMOps khusus untuk bermula?
Tidak pada hari pertama. Banyak pasukan bermula dengan pengelogan berstruktur bagi setiap panggilan LLM (prompt, respons, versi model, token, kependaman) dalam sistem sedia ada mereka. Platform khusus seperti LangSmith, Langfuse, Arize, atau Weights and Biases menambah nilai apabila jumlah trafik pengeluaran menjadikan semakan manual tidak praktikal atau apabila anda memerlukan penilaian sistematik pada skala besar.
Apakah set penilaian prompt dan mengapa ia penting?
Set penilaian ialah koleksi input yang mewakili, dipasangkan dengan tingkah laku jangkaan yang digredkan, dan dinilai oleh penskor automatik, model rujukan, atau penilai manusia. Oleh kerana output LLM tidak boleh disemak dengan penegasan lulus/gagal yang mudah seperti perisian tradisional, set eval ialah cara pasukan mengetahui sama ada perubahan prompt atau model menjadikan produk lebih baik atau lebih teruk sebelum ia dilancarkan.
Bagaimanakah RAG sesuai dalam LLMOps?
Retrieval-augmented generation menambah langkah pencarian sebelum model menjana respons, mengukuhkannya dengan data syarikat. LLMOps meliputi usaha memastikan saluran pencarian itu sihat: memantau sama ada sistem menemui dokumen yang betul, mengesan kes apabila model mengabaikan konteks pencarian yang baik, dan memastikan pangkalan pengetahuan asas sentiasa terkini.
Apakah punca utama kegagalan kebanyakan aplikasi LLM apabila sampai kepada pengguna sebenar?
Punca lazim termasuk regresi prompt selepas vendor mengemas kini model, saluran pencarian yang memulangkan konteks yang salah, lonjakan kos daripada penggunaan token yang tidak dipantau, dan kemerosotan kualiti yang tidak disedari tanpa penilaian berterusan. Kegagalan ini lazimnya senyap, ia tidak mencetuskan ralat, hanya menghasilkan output yang lebih buruk secara diam-diam, itulah sebabnya observability dan penilaian ialah fungsi teras LLMOps dan bukannya tambahan pilihan.
Apakah guardrails dalam LLMOps?
Guardrails ialah semakan yang berjalan sebelum output LLM sampai kepada pengguna: menapis kandungan berbahaya, mengesan percubaan prompt injection, menyekat kebocoran data sensitif, dan memastikan respons kekal pada topik. Ia ialah lapisan operasi terakhir antara output mentah model dan orang yang membacanya.
Adakah LLMOps hanya relevan untuk pasukan yang membina model sendiri?
Tidak. Kebanyakan aplikasi LLM enterprise memanggil model pihak ketiga melalui API dan bukannya melatih sendiri, yang bermakna amalan LLMOps, iaitu pengurusan prompt, penilaian, pemantauan RAG, penjejakan kos, dan guardrails, adalah tepat apa yang diperlukan pasukan tanpa mengira sama ada mereka melatih model asas tersebut.
Konsep AI Berkaitan
- MLOps - Disiplin lebih luas yang diperluas oleh LLMOps, merangkumi kitaran hayat machine learning yang penuh
- AI Observability - Disiplin log, jejak, dan metrik yang dikenakan oleh LLMOps khusus pada panggilan LLM
- Large Language Models - Kategori model yang LLMOps wujud untuk dikendalikan dengan boleh dipercayai
- Retrieval-Augmented Generation - Saluran pencarian yang perlu dijaga LLMOps bersama model
- AI Hallucination - Mod kegagalan teras yang dibina untuk dikesan oleh penilaian dan guardrails LLMOps
- Inference - Fasa pengeluaran tempat amalan kos dan kependaman LLMOps terpakai
- Prompt Engineering - Amalan hulu yang diberi versi dan dipantau oleh LLMOps dalam pengeluaran
- Model Monitoring - Disiplin penjejakan berterusan yang dikenakan LLMOps pada tingkah laku LLM yang dilaksanakan
Sumber Luaran
- LangSmith - Platform observability dan penilaian untuk aplikasi LLM
- Langfuse - Platform observability dan tracing LLM sumber terbuka
- Arize AI - Platform observability dan penilaian ML dan LLM
- Weights and Biases - Penjejakan eksperimen yang diperluas kepada perbandingan prompt dan model LLM
