Bahasa Indonesia
Apa itu LLMOps? Menjalankan Large Language Model di Production
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
LLMOps adalah kumpulan praktik operasional untuk men-deploy, memantau, dan merawat aplikasi large language model (LLM) di production. Cakupannya meliputi manajemen prompt, evaluasi, pipeline retrieval, pemantauan biaya dan latensi, serta guardrail keamanan, yaitu pekerjaan yang menjaga fitur LLM tetap andal setelah dirilis, bukan hanya saat tampil bagus di demo.
Prototipe yang menjawab pertanyaan dengan benar dalam demo hari Jumat dan fitur yang tahan melayani 50.000 pengguna per hari adalah dua masalah engineering yang berbeda. Modelnya sama. Yang berbeda adalah semua hal di sekitarnya: bagaimana prompt diberi versi, bagaimana kualitas diukur, bagaimana respons yang buruk tertangkap sebelum dilihat pelanggan. Disiplin di sekeliling model inilah yang disebut LLMOps.
Mengapa LLMOps Menjadi Disiplin Tersendiri
Tim yang sudah menjalankan MLOps kadang bertanya mengapa LLM membutuhkan playbook terpisah. Jawabannya: aplikasi LLM gagal dengan cara yang tidak dialami model ML tradisional, dan tooling ML tradisional tidak dibuat untuk menangkapnya.
Model ML klasik, seperti prediktor churn atau penilai fraud, menerima input terstruktur dan mengembalikan sebuah angka. Anda bisa menulis unit test untuknya: input X seharusnya menghasilkan output mendekati Y. LLM menerima teks tidak terstruktur, yaitu prompt, dan mengembalikan teks tidak terstruktur, yaitu respons, dan tidak ada satu jawaban benar yang bisa dijadikan acuan. Pertanyaan yang sama diajukan dua kali bisa menghasilkan dua respons berbeda yang sama-sama masuk akal. Kualitasnya probabilistik, bukan biner.
Aplikasi LLM juga membawa pola kegagalan yang tidak ada di ML klasik: template prompt yang rusak diam-diam saat vendor memperbarui modelnya, langkah retrieval yang mengembalikan dokumen yang salah lalu model tetap menjawab dari dokumen itu dengan yakin, atau lonjakan biaya karena seseorang menambahkan satu paragraf lagi ke system prompt yang berjalan di setiap request. Tidak satu pun muncul sebagai metrik training. Semuanya muncul di production, sering kali tanpa suara, dan itulah jenis masalah yang ditangkap oleh AI observability.
Siklus Hidup LLMOps
LLMOps bukan satu tool atau satu langkah. Ia adalah serangkaian praktik yang saling terhubung dan berjalan terus-menerus setelah fitur LLM dirilis.
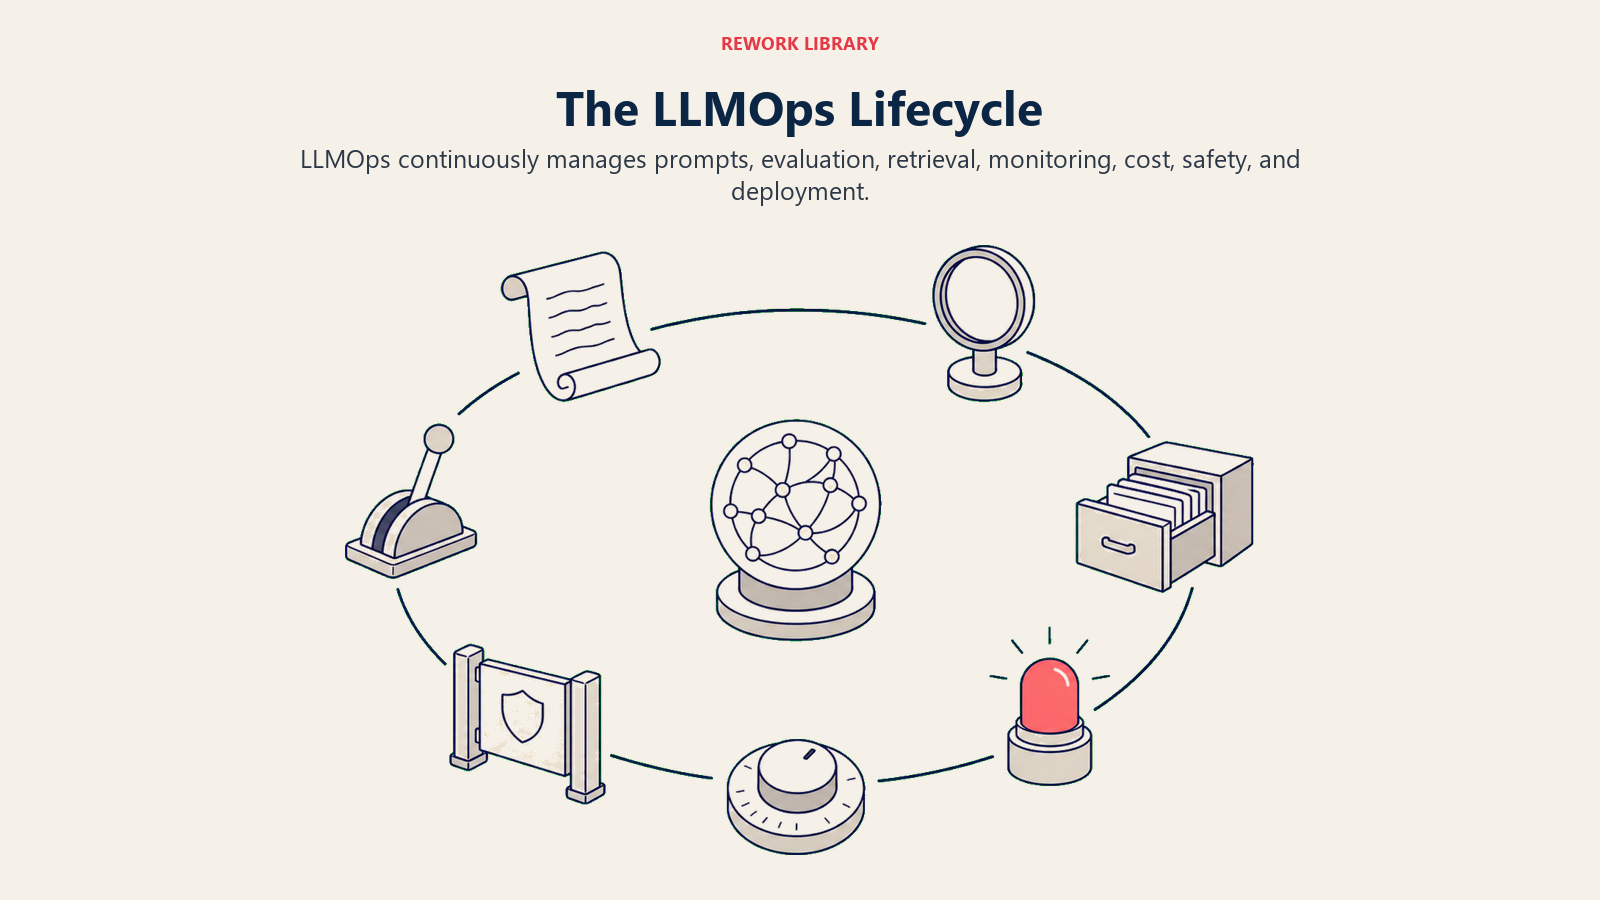
Manajemen prompt. Prompt adalah antarmuka antara aplikasi Anda dan model, dan membutuhkan disiplin yang sama seperti kode: version control, review perubahan, dan rollback. Prompt yang bekerja baik pada satu versi model bisa menurun kualitasnya pada versi berikutnya, secara diam-diam, kecuali ada yang melacak versi prompt mana yang dirilis bersama versi model mana dan apa yang terjadi pada kualitas output ketika salah satunya berubah.
Evaluasi. Karena output LLM tidak bisa diperiksa dengan assertion sederhana, tim membangun evaluation set: input representatif yang dipasangkan dengan perilaku yang diharapkan beserta penilaiannya, dinilai oleh scorer otomatis, model acuan, atau penilai manusia. Eval dijalankan sebelum perubahan prompt atau model dirilis (untuk menangkap regresi) dan terus-menerus di production (untuk menangkap drift). Tanpa eval set, pertanyaan "apakah perubahan ini membuat produk lebih baik atau lebih buruk" hanyalah tebakan.
Manajemen pipeline RAG. Sebagian besar aplikasi LLM bisnis memakai retrieval-augmented generation untuk mendasarkan respons pada data perusahaan, bukan pada apa yang dihafal model saat training. LLMOps mencakup separuh retrieval dari pipeline itu juga: menjaga knowledge base tetap terkini, memantau kualitas retrieval (apakah sistem menemukan dokumen yang tepat, bukan sekadar sebuah dokumen), dan menangkap kasus ketika retrieval berhasil tetapi model tetap mengabaikan konteks yang diambil.
Monitoring dan observability. Sistem LLM di production membutuhkan log setiap prompt dan respons, trace dari chain multi-langkah, serta metrik latensi, tingkat error, dan kualitas output dari waktu ke waktu. Ini disiplin tiga pilar yang sama yang dipakai di seluruh AI observability, diterapkan khusus pada prompt, token, dan panggilan model.
Manajemen biaya dan latensi. Setiap panggilan LLM memiliki biaya per token dan biaya waktu respons, dan keduanya naik langsung seiring penggunaan. LLMOps melacak biaya per request, biaya per fitur, dan persentil latensi, serta menerapkan teknik seperti caching, pemangkasan prompt, dan model routing (mengirim query mudah ke model yang lebih murah dan query sulit ke frontier model) agar keduanya tetap terkendali saat traffic bertambah.
Guardrail dan keamanan. Aplikasi LLM di production membutuhkan pemeriksaan yang berjalan sebelum respons sampai ke pengguna: menyaring konten berbahaya, menangkap upaya prompt injection, memblokir output yang membocorkan data sensitif, dan memastikan model tetap sesuai topik untuk use case yang dituju. Guardrail adalah garis pertahanan terakhir antara output mentah model dan orang yang membacanya.
Deployment dan versioning. Merilis prompt baru, versi model baru, atau indeks retrieval baru membutuhkan disiplin staged rollout yang sama seperti perubahan software production lainnya: canary release, perbandingan A/B terhadap versi saat ini, dan jalur rollback cepat ketika skor eval atau metrik yang dilihat pengguna bergerak ke arah yang salah.
LLMOps vs. MLOps
LLMOps tumbuh dari MLOps, dan keduanya berbagi banyak DNA: sama-sama peduli pada versioning, monitoring, dan deployment yang andal. Namun objek yang dioperasikan cukup berbeda sehingga praktiknya bercabang pada hal-hal tertentu.
| Dimensi | MLOps | LLMOps |
|---|---|---|
| Artefak inti | Model terlatih dengan output numerik yang tetap | Prompt plus model (sering berupa API pihak ketiga, bukan sesuatu yang Anda latih) |
| Pemeriksaan kualitas | Accuracy, precision, recall terhadap test set berlabel | Evaluation set yang dinilai oleh scorer otomatis, model acuan, atau penilai manusia |
| Pola kegagalan utama | Data drift, model decay, penurunan akurasi dari waktu ke waktu | Hallucination, regresi prompt, kegagalan retrieval, perubahan model vendor yang tidak terlihat |
| Yang diberi versi | Bobot model, data training, pipeline fitur | Template prompt, indeks retrieval, versi model, dan kombinasi ketiganya |
| Pendorong biaya | Compute training (sebagian besar di awal, lalu retraining berkala) | Inference (berkelanjutan, naik langsung seiring penggunaan, per panggilan API) |
| Deployment tipikal | Anda melatih dan memiliki modelnya | Anda sering memanggil model milik pihak lain lewat API dan mengoperasikan semua yang ada di sekitarnya |
Kesimpulan praktisnya: jika tim Anda sudah menjalankan MLOps, Anda tidak mulai dari nol. Tetapi pipeline MLOps yang dibuat untuk model churn tidak akan menangkap regresi prompt atau kegagalan retrieval, karena memang tidak pernah dibuat untuk mencarinya.
Lanskap Tool LLMOps
Kategori tooling ini masih muda dan terus berkonsolidasi, tetapi beberapa jenis tool sudah umum dalam stack LLM production.
Platform observability dan tracing seperti LangSmith dan Langfuse merekam trace lengkap sebuah request melalui prompt, panggilan retrieval, dan respons model, sehingga tim dapat men-debug satu output buruk dengan memutar ulang persis apa yang dilihat dan dikembalikan sistem.
Platform evaluasi dan monitoring seperti Arize menangani eval offline (sebelum perubahan dirilis) maupun monitoring production (drift, skor kualitas, dan anomaly detection pada traffic langsung), sering kali untuk beban kerja ML tradisional dan LLM sekaligus dalam satu platform.
Tool experiment tracking seperti Weights and Biases, yang awalnya dibuat untuk training run ML klasik, kini meluas ke pelacakan eksperimen prompt dan LLM, memungkinkan tim membandingkan varian prompt dan versi model berdampingan dengan metrik yang tercatat.
Kebanyakan tim tidak mengadopsi semuanya sekaligus. Titik awal yang umum adalah structured logging untuk setiap panggilan LLM (prompt, respons, versi model, jumlah token, latensi), lalu menambahkan platform observability khusus ketika volume traffic production membuat peninjauan manual tidak praktis, kemudian menambahkan evaluasi sistematis setelah ada cukup data log untuk membangun eval set yang representatif. Perbandingan platform LLM observability kami menghitung harga 12 di antaranya pada volume trace yang nyata.
Fakta Utama
- Gartner memprediksi bahwa 40% organisasi yang men-deploy AI akan menggunakan tool AI observability khusus untuk memantau performa model, bias, dan output pada 2028, menurut siaran pers Gartner tentang adopsi AI observability.
- Gartner memprediksi setidaknya 30% proyek generative AI akan ditinggalkan setelah proof of concept pada akhir 2025, dengan alasan kualitas data yang buruk, kontrol risiko yang tidak memadai, biaya yang membengkak, atau nilai bisnis yang tidak jelas.
- 74% eksekutif melaporkan ROI tahun pertama dari deployment AI, tetapi hanya 39% yang melaporkan dampak EBIT di tingkat enterprise, menurut riset State of AI dari McKinsey tentang kesenjangan antara piloting dan scaling AI.
- Belanja software generative AI enterprise mencapai $37 miliar pada 2025, naik dari $11,5 miliar pada 2024, peningkatan 3,2x year-over-year, menurut laporan 2025 State of Generative AI in the Enterprise dari Menlo Ventures.
- Hanya 16% deployment AI enterprise yang memenuhi syarat sebagai agent otonom sejati, dengan sebagian besar sistem production masih dibangun di sekitar workflow berurutan tetap atau berbasis routing di seputar satu panggilan model, menurut laporan Menlo Ventures yang sama.
- 37% enterprise kini menggunakan lima model atau lebih di production, naik dari 29% tahun sebelumnya, menurut laporan AI enterprise 2025 dari a16z, tanda orkestrasi multi-model yang makin harus dikelola LLMOps.
Mengapa LLMOps Penting untuk Enterprise AI
Kesenjangan antara demo yang berfungsi dan fitur LLM berkelas production adalah tepat di titik di mana sebagian besar inisiatif AI enterprise macet. Prediksi Gartner bahwa 30% proyek generative AI ditinggalkan setelah proof of concept, dan temuan Menlo Ventures bahwa sebagian besar deployment masih berupa workflow satu model yang sederhana, bukan sistem agentic yang matang, sama-sama menunjuk masalah mendasar yang sama: membangun panggilan model adalah bagian yang mudah. Mengoperasikannya dengan andal, pada skala besar, dengan biaya yang dapat diprediksi dan risiko yang dapat diterima, adalah bagian yang membedakan pilot dari produk.
Di situlah kesenjangan ROI McKinsey muncul. 74% eksekutif melaporkan sebagian pengembalian di tahun pertama, tetapi hanya 39% yang melihat dampak di tingkat enterprise, sejalan dengan yang terjadi ketika tim merilis fitur LLM tanpa lapisan operasional di sekelilingnya. Fitur itu berjalan baik untuk beberapa ratus pengguna pertama, lalu pembaruan prompt merusaknya secara diam-diam, atau biaya melonjak seiring pertumbuhan penggunaan, atau tidak ada yang menyadari kualitas output merosot sampai pelanggan mengeluh. LLMOps adalah pembeda antara fitur AI yang bertahan menghadapi penggunaan nyata dan fitur yang harus ditarik kembali diam-diam enam bulan kemudian.
Tren multi-model menambah satu lapisan lagi: a16z menemukan enterprise makin sering menjalankan lima model atau lebih di production alih-alih bertaruh pada satu, mengarahkan tugas rutin ke model yang lebih murah dan menyisakan frontier model untuk penalaran yang lebih sulit. Keputusan routing itu, beserta pelacakan biaya dan kualitas yang dibutuhkannya, adalah fungsi LLMOps itu sendiri. Seiring aplikasi LLM makin kompleks, dari prompt tunggal ke pipeline RAG hingga workflow agentic multi-langkah, permukaan operasionalnya ikut membesar. Tim yang menganggap LLMOps sebagai urusan belakangan cenderung mengetahui masalah dari pengguna. Tim yang membangunnya sejak awal mengetahuinya dari monitoring mereka sendiri, sebelum menjadi tiket support.
Frequently Asked Questions about LLMOps
Apa itu LLMOps?
LLMOps adalah kumpulan praktik operasional untuk men-deploy, memantau, dan merawat aplikasi large language model di production. Cakupannya meliputi manajemen prompt, evaluasi, manajemen pipeline RAG, observability, kontrol biaya dan latensi, serta guardrail keamanan, yaitu pekerjaan yang diperlukan agar fitur LLM tetap andal setelah peluncuran.
Apa bedanya LLMOps dengan MLOps?
MLOps beroperasi pada model terlatih dengan output numerik yang bisa diperiksa dan berfokus pada data drift serta model decay. LLMOps beroperasi pada prompt plus model, yang sering diakses lewat API dan bukan dilatih sendiri, serta berfokus pada regresi prompt, hallucination, dan kegagalan retrieval. LLMOps meminjam disiplin MLOps soal versioning dan monitoring, tetapi menerapkannya pada kumpulan pola kegagalan yang berbeda.
Apakah perlu tool LLMOps khusus untuk memulai?
Tidak di hari pertama. Banyak tim memulai dengan structured logging untuk setiap panggilan LLM (prompt, respons, versi model, token, latensi) di sistem yang sudah ada. Platform khusus seperti LangSmith, Langfuse, Arize, atau Weights and Biases baru memberi nilai tambah ketika volume traffic production membuat peninjauan manual tidak praktis atau ketika Anda butuh evaluasi sistematis pada skala besar.
Apa itu prompt evaluation set dan mengapa penting?
Evaluation set adalah kumpulan input representatif yang dipasangkan dengan perilaku yang diharapkan beserta penilaiannya, dinilai oleh scorer otomatis, model acuan, atau penilai manusia. Karena output LLM tidak bisa diperiksa dengan assertion lulus/gagal sederhana seperti software tradisional, eval set adalah cara tim mengetahui apakah perubahan prompt atau model membuat produk lebih baik atau lebih buruk sebelum dirilis.
Bagaimana RAG masuk ke dalam LLMOps?
Retrieval-augmented generation menambahkan langkah retrieval sebelum model menghasilkan respons, sehingga respons berdasar pada data perusahaan. LLMOps mencakup menjaga pipeline retrieval itu tetap sehat: memantau apakah sistem menemukan dokumen yang tepat, menangkap kasus ketika model mengabaikan konteks hasil retrieval yang baik, dan menjaga knowledge base tetap terkini.
Apa penyebab utama kegagalan aplikasi LLM saat bertemu pengguna nyata?
Penyebab umum meliputi regresi prompt setelah vendor memperbarui model, pipeline retrieval yang mengembalikan konteks yang salah, lonjakan biaya akibat penggunaan token yang tidak dipantau, dan drift kualitas yang tidak disadari tanpa evaluasi berkelanjutan. Kegagalan ini biasanya senyap: tidak memunculkan error, hanya diam-diam menghasilkan output yang lebih buruk, itulah mengapa observability dan evaluasi adalah fungsi inti LLMOps, bukan tambahan opsional.
Apa itu guardrail dalam LLMOps?
Guardrail adalah pemeriksaan yang berjalan sebelum output LLM sampai ke pengguna: menyaring konten berbahaya, menangkap upaya prompt injection, memblokir kebocoran data sensitif, dan menjaga respons tetap sesuai topik. Guardrail adalah lapisan operasional terakhir antara output mentah model dan orang yang membacanya.
Apakah LLMOps hanya relevan untuk tim yang membangun model sendiri?
Tidak. Sebagian besar aplikasi LLM enterprise memanggil model pihak ketiga lewat API alih-alih melatihnya sendiri, artinya praktik LLMOps, yaitu manajemen prompt, evaluasi, monitoring RAG, pelacakan biaya, dan guardrail, justru yang dibutuhkan tim terlepas dari apakah mereka melatih model dasarnya atau tidak.
Konsep AI Terkait
- MLOps - Disiplin yang lebih luas yang diperluas oleh LLMOps, mencakup seluruh siklus hidup machine learning
- AI Observability - Disiplin log, trace, dan metrik yang diterapkan LLMOps secara khusus pada panggilan LLM
- Large Language Models - Kategori model yang dioperasikan secara andal oleh LLMOps
- Retrieval-Augmented Generation - Pipeline retrieval yang harus dijaga tetap sehat oleh LLMOps bersama modelnya
- AI Hallucination - Pola kegagalan inti yang dirancang untuk ditangkap oleh evaluasi dan guardrail LLMOps
- Inference - Fase production tempat praktik biaya dan latensi LLMOps diterapkan
- Prompt Engineering - Praktik hulu yang diberi versi dan dipantau LLMOps di production
- Model Monitoring - Disiplin pelacakan berkelanjutan yang diterapkan LLMOps pada perilaku LLM yang ter-deploy
Sumber Eksternal
- LangSmith - Platform observability dan evaluasi untuk aplikasi LLM
- Langfuse - Platform observability dan tracing LLM open source
- Arize AI - Platform observability dan evaluasi ML dan LLM
- Weights and Biases - Experiment tracking yang diperluas ke perbandingan prompt dan model LLM
