O que é LLMOps? Como operar large language models em produção
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
LLMOps é o conjunto de práticas operacionais para implantar, monitorar e manter aplicações de large language models (LLM) em produção. Abrange gerenciamento de prompts, avaliação, pipelines de recuperação, monitoramento de custo e latência e barreiras de segurança: o trabalho que mantém um recurso de LLM confiável depois do lançamento, e não apenas quando ele brilha na demonstração.
Um protótipo que responde corretamente em uma demo de sexta-feira e um recurso que se sustenta com 50.000 usuários por dia são problemas de engenharia diferentes. O modelo é o mesmo. Tudo ao redor dele não é: como os prompts são versionados, como a qualidade é medida, como uma resposta ruim é interceptada antes de chegar a um cliente. Essa disciplina ao redor do modelo é o LLMOps.
Por que o LLMOps existe como disciplina própria
Equipes que já praticam MLOps às vezes perguntam por que os LLMs precisam de um manual separado. A resposta é que as aplicações de LLM falham de maneiras que os modelos tradicionais de ML não falham, e as ferramentas tradicionais de ML não foram feitas para detectá-las.
Um modelo clássico de ML, como um preditor de churn ou um sistema de pontuação de fraude, recebe dados estruturados e devolve um número. É possível escrever um teste unitário para ele: a entrada X deve produzir uma saída próxima de Y. Um LLM recebe texto não estruturado, um prompt, e devolve texto não estruturado, uma resposta, e não existe uma única resposta correta para conferir. A mesma pergunta feita duas vezes pode gerar duas respostas diferentes, ambas defensáveis. A qualidade é probabilística, não binária.
As aplicações de LLM também trazem modos de falha que não existem no ML clássico: um template de prompt que quebra silenciosamente quando o fornecedor atualiza o modelo, uma etapa de recuperação que devolve o documento errado e o modelo responde com confiança a partir dele mesmo assim, um aumento de custo porque alguém acrescentou mais um parágrafo a um prompt de sistema que roda em toda requisição. Nenhum desses problemas aparece como métrica de treinamento. Eles aparecem em produção, muitas vezes de forma discreta, e é exatamente o tipo de problema que a AI observability existe para detectar.
O ciclo de vida do LLMOps
O LLMOps não é uma ferramenta nem uma etapa isolada. É um conjunto de práticas conectadas que rodam continuamente depois que um recurso de LLM é lançado.
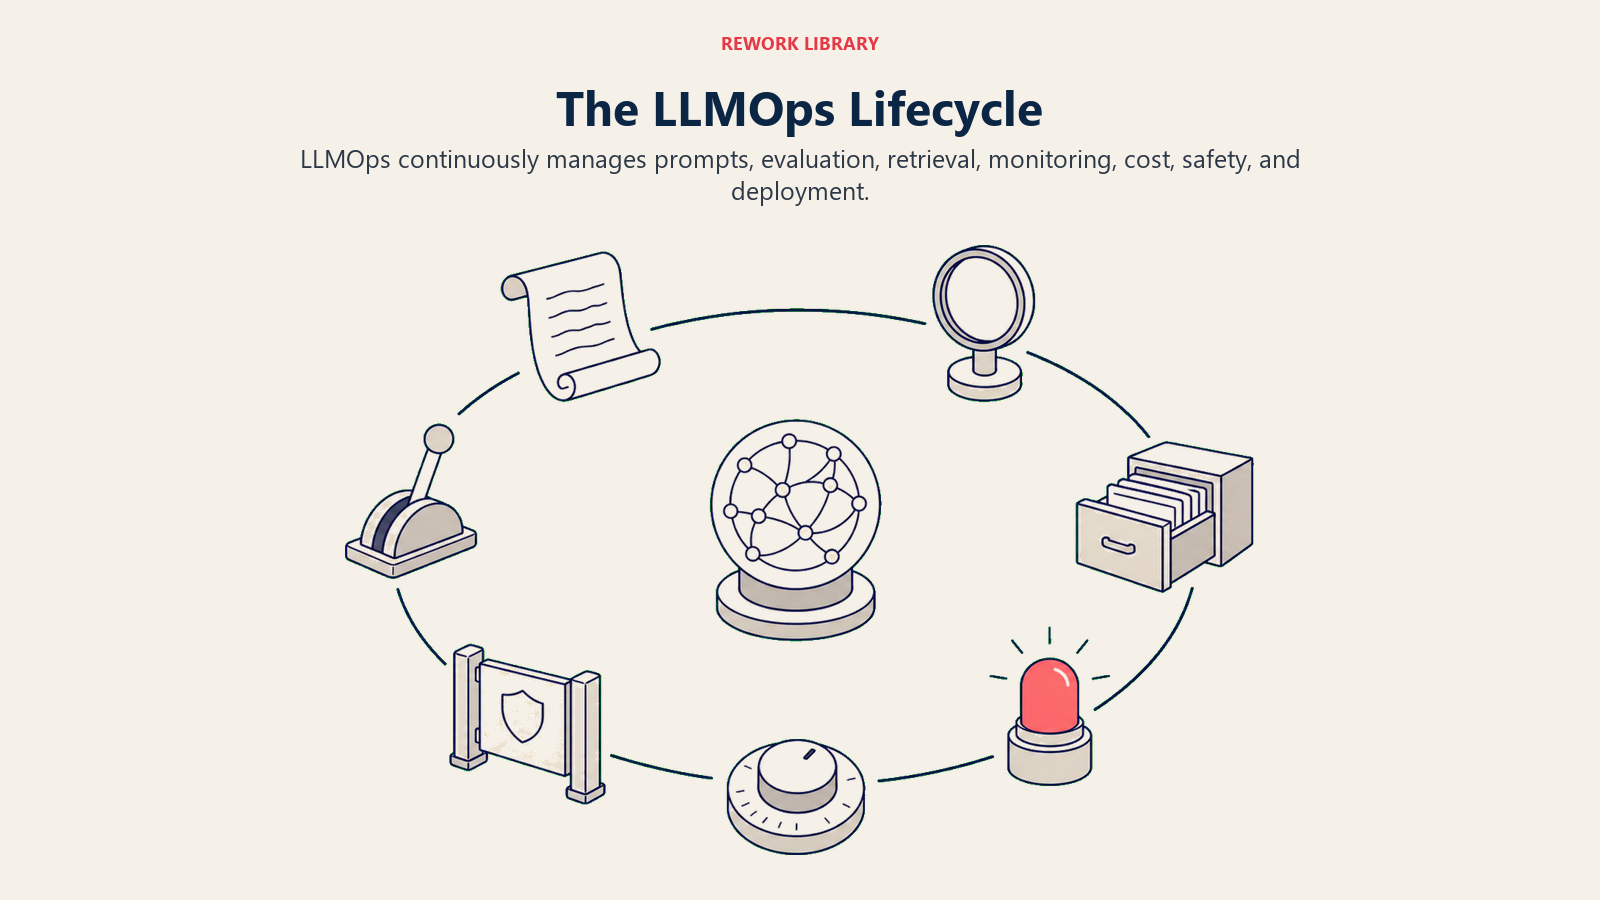
Gerenciamento de prompts. Os prompts são a interface entre sua aplicação e o modelo, e exigem a mesma disciplina do código: controle de versão, revisão de mudanças e rollback. Um prompt que funciona bem em uma versão do modelo pode piorar na versão seguinte, em silêncio, a menos que alguém acompanhe qual versão do prompt foi lançada com qual versão do modelo e o que aconteceu com a qualidade das respostas quando uma das duas mudou.
Avaliação. Como as respostas de um LLM não podem ser verificadas com uma asserção simples, as equipes montam conjuntos de avaliação: entradas representativas associadas a um comportamento esperado, avaliado por scorers automatizados, modelos de referência ou avaliadores humanos. As evals rodam antes de uma mudança de prompt ou de modelo ser lançada (para detectar regressões) e continuamente em produção (para detectar drift). Sem um conjunto de avaliação, saber se uma mudança melhorou ou piorou o produto é um palpite.
Gerenciamento do pipeline de RAG. A maioria das aplicações de LLM corporativas usa retrieval-augmented generation para fundamentar as respostas em dados da empresa, em vez de depender do que o modelo memorizou no treinamento. O LLMOps também cobre a metade de recuperação desse pipeline: manter a base de conhecimento atualizada, monitorar a qualidade da recuperação (o sistema está encontrando o documento certo, e não apenas um documento) e detectar o caso em que a recuperação funciona, mas o modelo ignora o contexto recuperado.
Monitoramento e observability. Sistemas de LLM em produção precisam de logs de cada prompt e resposta, traces de cadeias com várias etapas e métricas de latência, taxa de erro e qualidade das respostas ao longo do tempo. É a mesma disciplina dos três pilares usada na AI observability em geral, aplicada especificamente a prompts, tokens e chamadas de modelo.
Gestão de custo e latência. Cada chamada a um LLM tem um custo por token e um custo em tempo de resposta, e ambos crescem diretamente com o uso. O LLMOps acompanha o custo por requisição, o custo por recurso e os percentis de latência, e aplica técnicas como cache, enxugamento de prompts e roteamento de modelos (enviar consultas fáceis a um modelo mais barato e as difíceis a um modelo de ponta) para manter os dois sob controle conforme o tráfego cresce.
Guardrails e segurança. Aplicações de LLM em produção precisam de verificações que rodam antes de a resposta chegar ao usuário: filtrar conteúdo nocivo, detectar tentativas de prompt injection, bloquear respostas que vazem dados sensíveis e garantir que o modelo permaneça dentro do tema do caso de uso pretendido. Os guardrails são a última linha de defesa entre a saída bruta do modelo e a pessoa que a lê.
Implantação e versionamento. Lançar um novo prompt, uma nova versão de modelo ou um novo índice de recuperação exige a mesma disciplina de lançamento gradual de qualquer mudança de software em produção: canary releases, comparação A/B com a versão atual e um caminho de rollback rápido quando uma nota de eval ou uma métrica voltada ao usuário se move na direção errada.
LLMOps vs. MLOps
O LLMOps nasceu do MLOps, e os dois compartilham muito DNA: ambos se preocupam com versionamento, monitoramento e implantação confiável. Mas o objeto operado é diferente o suficiente para que as práticas se afastem em pontos específicos.
| Dimensão | MLOps | LLMOps |
|---|---|---|
| Artefato central | Um modelo treinado com saídas numéricas fixas | Um prompt mais um modelo (muitas vezes uma API de terceiros, não algo que você treinou) |
| Verificação de qualidade | Accuracy, precision e recall em relação a um conjunto de teste rotulado | Conjuntos de avaliação pontuados por scorers automatizados, modelos de referência ou avaliadores humanos |
| Principal modo de falha | Data drift, degradação do modelo, perda de accuracy ao longo do tempo | Alucinação, regressão de prompt, falha de recuperação, mudanças silenciosas no modelo do fornecedor |
| O que é versionado | Pesos do modelo, dados de treinamento, pipelines de features | Templates de prompt, índices de recuperação, versão do modelo e a combinação dos três |
| Fator de custo | Computação de treinamento (concentrada no início, depois retreinamentos periódicos) | Inferência (contínua, cresce diretamente com o uso, por chamada de API) |
| Implantação típica | Você treina e é dono do modelo | Você costuma chamar o modelo de outra empresa via API e operar tudo ao redor dele |
Na prática: se sua equipe já faz MLOps, você não está começando do zero. Mas um pipeline de MLOps criado para um modelo de churn não detectará uma regressão de prompt nem uma falha de recuperação, porque nunca foi feito para procurar por isso.
O cenário de ferramentas de LLMOps
A categoria de ferramentas é jovem e ainda está se consolidando, mas alguns tipos de ferramenta se tornaram comuns em stacks de LLM em produção.
Plataformas de observability e tracing, como LangSmith e Langfuse, capturam o trace completo de uma requisição por prompts, chamadas de recuperação e respostas do modelo, para que as equipes depurem uma resposta ruim específica reproduzindo exatamente o que o sistema viu e devolveu.
Plataformas de avaliação e monitoramento, como a Arize, cobrem tanto evals offline (antes de uma mudança ser lançada) quanto monitoramento em produção (drift, notas de qualidade e detecção de anomalias no tráfego real), muitas vezes para cargas de trabalho de ML tradicional e de LLM na mesma plataforma.
Ferramentas de rastreamento de experimentos, como Weights and Biases, criadas originalmente para execuções de treinamento de ML clássico, passaram a rastrear experimentos de prompts e de LLM, permitindo comparar lado a lado variantes de prompt e versões de modelo com métricas registradas.
A maioria das equipes não adota tudo de uma vez. Um ponto de partida comum é o logging estruturado de cada chamada a LLM (prompt, resposta, versão do modelo, contagem de tokens, latência); depois, uma plataforma de observability dedicada, quando o volume de tráfego em produção torna inviável a revisão manual; e, por fim, a avaliação sistemática, quando já há dados registrados suficientes para montar um conjunto de avaliação representativo. Nossa comparação de plataformas de LLM observability calcula o preço de 12 delas com um volume real de traces.
Fatos principais
- A Gartner prevê que 40% das organizações que implantam AI usarão ferramentas dedicadas de AI observability para monitorar desempenho, viés e saídas dos modelos até 2028, segundo um comunicado de imprensa da Gartner sobre a adoção de AI observability.
- A Gartner prevê que pelo menos 30% dos projetos de generative AI serão abandonados após a prova de conceito até o fim de 2025, devido à baixa qualidade dos dados, a controles de risco inadequados, a custos crescentes ou a valor de negócio pouco claro.
- 74% dos executivos relatam ROI no primeiro ano com implantações de AI, mas apenas 39% relatam impacto no EBIT em nível corporativo, segundo a pesquisa State of AI da McKinsey sobre a lacuna entre pilotar e escalar AI.
- O gasto corporativo com software de generative AI chegou a US$ 37 bilhões em 2025, contra US$ 11,5 bilhões em 2024, um aumento de 3,2 vezes em relação ao ano anterior, segundo o relatório 2025 State of Generative AI in the Enterprise da Menlo Ventures.
- Apenas 16% das implantações de AI corporativas se qualificam como agentes autônomos de verdade, com a maioria dos sistemas em produção ainda construída em torno de workflows de sequência fixa ou baseados em roteamento ao redor de uma única chamada de modelo, segundo o mesmo relatório da Menlo Ventures.
- 37% das empresas agora usam cinco ou mais modelos em produção, contra 29% no ano anterior, segundo o relatório de AI corporativa de 2025 da a16z, sinal da orquestração multimodelo que o LLMOps precisa cada vez mais gerenciar.
Por que o LLMOps importa para a AI corporativa
A distância entre uma demo que funciona e um recurso de LLM pronto para produção é exatamente onde a maioria das iniciativas de AI corporativas emperra. A previsão da Gartner de que 30% dos projetos de generative AI serão abandonados após a prova de conceito e a constatação da Menlo Ventures de que a maioria das implantações ainda são workflows simples de modelo único, e não sistemas agênticos maduros, apontam para o mesmo problema de fundo: construir a chamada ao modelo é a parte fácil. Operá-la de forma confiável, em escala, com custo previsível e risco aceitável, é o que separa um piloto de um produto.
É também aí que aparece a lacuna de ROI da McKinsey. 74% dos executivos relatam algum retorno no primeiro ano, mas apenas 39% veem impacto em nível corporativo, o que combina com o que acontece quando uma equipe lança um recurso de LLM sem a camada operacional ao redor. Ele funciona para as primeiras centenas de usuários; depois uma atualização de prompt o quebra silenciosamente, ou os custos disparam com o crescimento do uso, ou ninguém percebe a qualidade das respostas caindo até um cliente reclamar. O LLMOps é a diferença entre um recurso de AI que sobrevive ao contato com o uso real e outro que precisa ser retirado discretamente seis meses depois.
A tendência multimodelo acrescenta mais uma camada: a a16z constatou que as empresas estão cada vez mais rodando cinco ou mais modelos em produção, em vez de apostar em um só, roteando tarefas rotineiras para modelos mais baratos e reservando os modelos de ponta para raciocínios mais difíceis. Essa decisão de roteamento, e o acompanhamento de custo e qualidade que ela exige, é em si uma função de LLMOps. À medida que as aplicações de LLM ficam mais complexas, de prompts isolados a pipelines de RAG e workflows agênticos de várias etapas, a superfície operacional cresce junto. As equipes que tratam o LLMOps como algo secundário costumam descobrir os problemas pelos usuários. As que o incorporam desde o início descobrem pelo próprio monitoramento, antes de virar um ticket de suporte.
Perguntas frequentes sobre LLMOps
O que é LLMOps?
LLMOps é o conjunto de práticas operacionais para implantar, monitorar e manter aplicações de large language models em produção. Abrange gerenciamento de prompts, avaliação, gerenciamento de pipelines de RAG, observability, controle de custo e latência e guardrails de segurança: o trabalho necessário para manter um recurso de LLM confiável depois do lançamento.
Qual é a diferença entre LLMOps e MLOps?
O MLOps opera um modelo treinado com saídas numéricas e verificáveis e se concentra em data drift e degradação do modelo. O LLMOps opera um prompt mais um modelo, muitas vezes acessado via API em vez de treinado internamente, e se concentra em regressões de prompt, alucinação e falhas de recuperação. O LLMOps toma emprestada do MLOps a disciplina de versionamento e monitoramento, mas a aplica a outro conjunto de modos de falha.
Preciso de ferramentas especializadas de LLMOps para começar?
Não no primeiro dia. Muitas equipes começam com logging estruturado de cada chamada a LLM (prompt, resposta, versão do modelo, tokens, latência) nos sistemas que já têm. Plataformas dedicadas como LangSmith, Langfuse, Arize ou Weights and Biases agregam valor quando o volume de tráfego em produção torna inviável a revisão manual ou quando você precisa de avaliação sistemática em escala.
O que é um conjunto de avaliação de prompts e por que ele importa?
Um conjunto de avaliação é uma coleção de entradas representativas associadas a um comportamento esperado, avaliado por scorers automatizados, modelos de referência ou avaliadores humanos. Como as respostas de um LLM não podem ser verificadas com uma asserção simples de aprovado/reprovado, como no software tradicional, o conjunto de avaliação é como as equipes descobrem se uma mudança de prompt ou de modelo melhorou ou piorou o produto antes de lançá-la.
Como o RAG se encaixa no LLMOps?
O retrieval-augmented generation acrescenta uma etapa de recuperação antes de o modelo gerar a resposta, fundamentando-a em dados da empresa. O LLMOps cobre a manutenção da saúde desse pipeline de recuperação: monitorar se o sistema encontra os documentos certos, detectar casos em que o modelo ignora um bom contexto recuperado e manter a base de conhecimento atualizada.
O que faz a maioria das aplicações de LLM falhar quando chega aos usuários reais?
Causas comuns incluem regressões de prompt depois que o fornecedor atualiza um modelo, pipelines de recuperação que devolvem o contexto errado, picos de custo por uso de tokens sem monitoramento e deriva de qualidade que passa despercebida sem avaliação contínua. Essas falhas costumam ser silenciosas: não geram erros, apenas produzem respostas piores sem alarde, e é por isso que observability e avaliação são funções centrais do LLMOps, e não extras opcionais.
O que são guardrails no LLMOps?
Guardrails são verificações que rodam antes de a saída de um LLM chegar ao usuário: filtrar conteúdo nocivo, detectar tentativas de prompt injection, bloquear o vazamento de dados sensíveis e manter as respostas dentro do tema. São a última camada operacional entre a saída bruta do modelo e a pessoa que a lê.
O LLMOps só é relevante para equipes que constroem os próprios modelos?
Não. A maioria das aplicações de LLM corporativas chama um modelo de terceiros via API em vez de treinar um, o que significa que as práticas de LLMOps (gerenciamento de prompts, avaliação, monitoramento de RAG, controle de custos e guardrails) são exatamente o que uma equipe precisa, tenha ou não treinado o modelo subjacente.
Conceitos de AI relacionados
- MLOps - A disciplina mais ampla que o LLMOps estende, cobrindo todo o ciclo de vida do machine learning
- AI Observability - A disciplina de logs, traces e métricas que o LLMOps aplica especificamente às chamadas de LLM
- Large Language Models - A categoria de modelos que o LLMOps existe para operar com confiabilidade
- Retrieval-Augmented Generation - Os pipelines de recuperação que o LLMOps precisa manter saudáveis junto com o modelo
- Alucinação de IA - Um modo de falha central que a avaliação e os guardrails do LLMOps foram criados para detectar
- Inferência - A fase de produção em que se aplicam as práticas de custo e latência do LLMOps
- Prompt Engineering - A prática anterior que o LLMOps versiona e monitora em produção
- Model Monitoring - A disciplina de acompanhamento contínuo que o LLMOps aplica ao comportamento dos LLMs implantados
Recursos externos
- LangSmith - Plataforma de observability e avaliação para aplicações de LLM
- Langfuse - Plataforma open source de observability e tracing de LLM
- Arize AI - Plataforma de observability e avaliação de ML e LLM
- Weights and Biases - Rastreamento de experimentos estendido para comparação de prompts e modelos de LLM
