¿Qué es LLMOps? Cómo operar modelos de lenguaje grandes en producción
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
LLMOps es el conjunto de prácticas operativas para desplegar, monitorear y mantener aplicaciones de modelos de lenguaje grandes (LLM) en producción. Abarca la gestión de prompts, la evaluación, los pipelines de recuperación, el monitoreo de costos y latencia y las barreras de seguridad: el trabajo que mantiene fiable una función de LLM después de lanzarla, y no solo cuando luce bien en una demo.
Un prototipo que responde correctamente en una demo del viernes y una función que resiste a 50.000 usuarios al día son problemas de ingeniería distintos. El modelo es el mismo. Todo lo que lo rodea no lo es: cómo se versionan los prompts, cómo se mide la calidad, cómo se detecta una mala respuesta antes de que la vea un cliente. Esa disciplina circundante es LLMOps.
Por qué LLMOps existe como disciplina propia
Los equipos que ya operan MLOps a veces preguntan por qué los LLM necesitan un manual aparte. La respuesta es que las aplicaciones de LLM fallan de maneras en que no fallan los modelos de ML tradicionales, y las herramientas de ML tradicionales no se diseñaron para detectarlas.
Un modelo de ML clásico, un predictor de churn o un evaluador de fraude, recibe datos estructurados y devuelve un número. Se le puede escribir una prueba unitaria: la entrada X debe producir una salida cercana a Y. Un LLM recibe texto no estructurado, un prompt, y devuelve texto no estructurado, una respuesta, y no existe una única respuesta correcta contra la cual comparar. La misma pregunta hecha dos veces puede producir dos respuestas distintas, ambas defendibles. La calidad es probabilística, no binaria.
Las aplicaciones de LLM también introducen modos de fallo que no existen en el ML clásico: una plantilla de prompt que se rompe en silencio cuando un proveedor actualiza su modelo, un paso de recuperación que devuelve el documento equivocado y el modelo responde con seguridad a partir de él, un pico de costos porque alguien añadió un párrafo más a un prompt de sistema que se ejecuta en cada solicitud. Ninguno aparece como una métrica de entrenamiento. Aparecen en producción, a menudo sin hacer ruido, justo el tipo de problema que la observabilidad de IA existe para detectar.
El ciclo de vida de LLMOps
LLMOps no es una herramienta ni un paso. Es un conjunto de prácticas conectadas que se ejecutan de forma continua una vez que una función de LLM entra en producción.
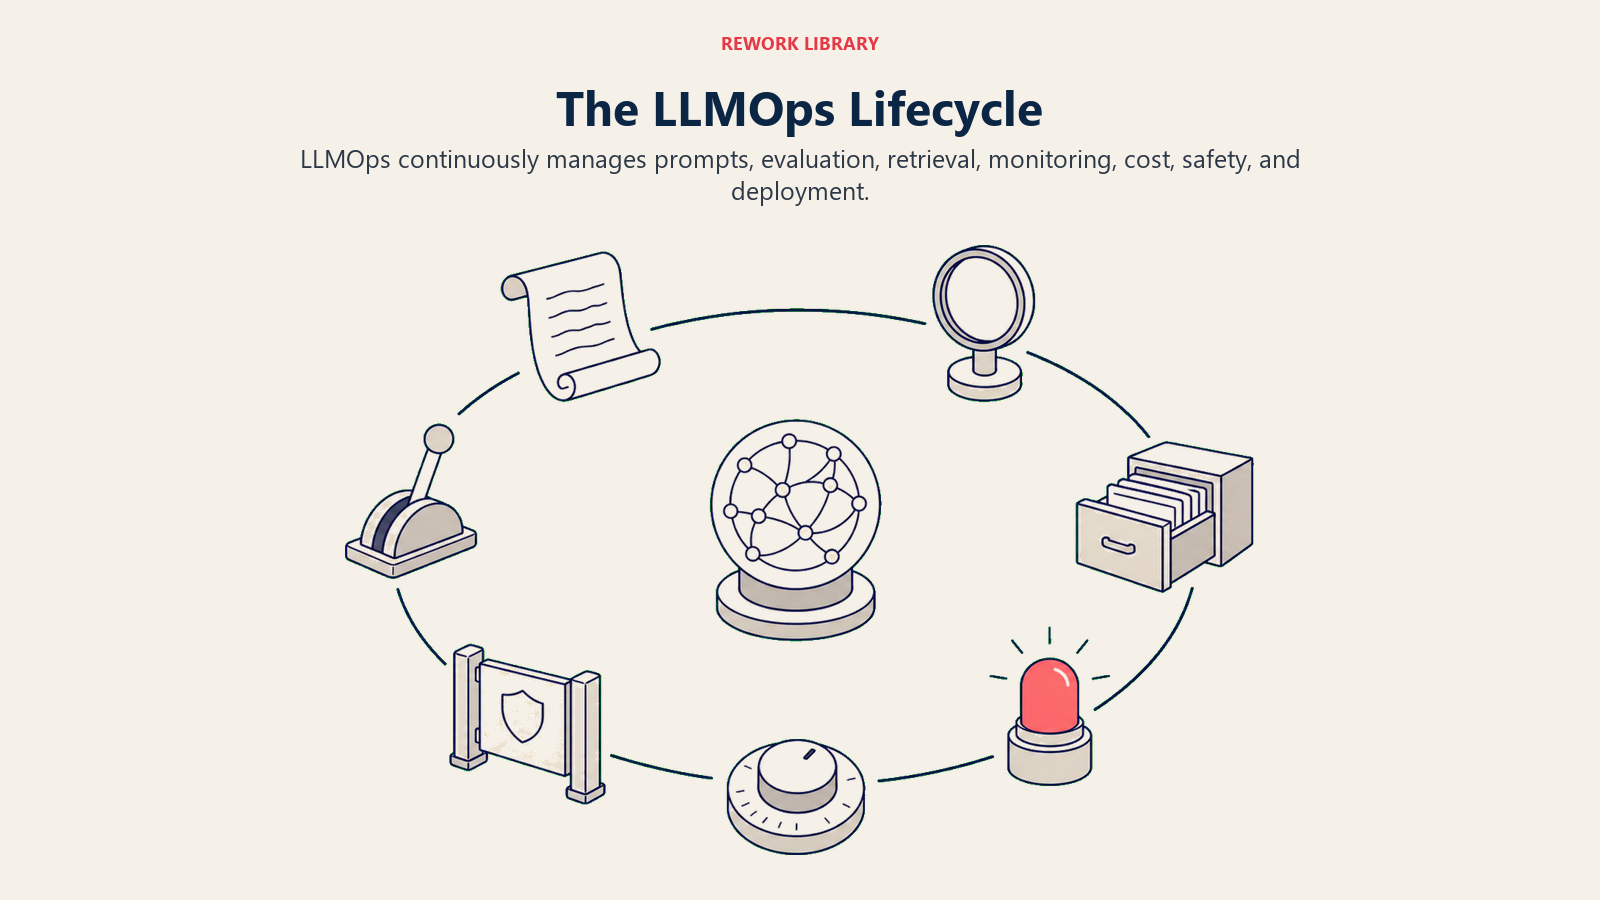
Gestión de prompts. Los prompts son la interfaz entre su aplicación y el modelo, y requieren la misma disciplina que el código: control de versiones, revisión de cambios y reversión. Un prompt que funciona bien con una versión del modelo puede degradarse con la siguiente, en silencio, a menos que alguien lleve el registro de qué versión del prompt se lanzó con qué versión del modelo y qué pasó con la calidad de las salidas cuando cambió cualquiera de las dos.
Evaluación. Como las salidas de un LLM no se pueden verificar con una aserción simple, los equipos construyen conjuntos de evaluación: entradas representativas junto con un comportamiento esperado calificado, puntuadas por evaluadores automáticos, modelos de referencia o evaluadores humanos. Las evals se ejecutan antes de lanzar un cambio de prompt o de modelo (para detectar regresiones) y de forma continua en producción (para detectar deriva). Sin un conjunto de evaluación, saber si un cambio mejoró o empeoró el producto es una conjetura.
Gestión del pipeline de RAG. La mayoría de las aplicaciones de LLM empresariales usan la generación aumentada por recuperación para fundamentar las respuestas en los datos de la empresa en lugar de depender de lo que el modelo memorizó durante el entrenamiento. LLMOps también cubre la mitad de recuperación de ese pipeline: mantener actualizada la base de conocimiento, monitorear la calidad de la recuperación (si el sistema encuentra el documento correcto, y no solo un documento) y detectar el caso en que la recuperación tiene éxito pero el modelo aun así ignora el contexto recuperado.
Monitoreo y observabilidad. Los sistemas de LLM en producción necesitan registros de cada prompt y respuesta, trazas de las cadenas de varios pasos y métricas de latencia, tasa de errores y calidad de las salidas a lo largo del tiempo. Es la misma disciplina de tres pilares que se usa en la observabilidad de IA en general, aplicada específicamente a prompts, tokens y llamadas al modelo.
Gestión de costos y latencia. Cada llamada a un LLM tiene un costo por token y un costo en tiempo de respuesta, y ambos escalan directamente con el uso. LLMOps rastrea el costo por solicitud, el costo por función y los percentiles de latencia, y aplica técnicas como el almacenamiento en caché, el recorte de prompts y el enrutamiento de modelos (enviar las consultas fáciles a un modelo más económico y las difíciles a un modelo de frontera) para mantener ambos bajo control a medida que crece el tráfico.
Barreras de seguridad (guardrails). Las aplicaciones de LLM en producción necesitan controles que se ejecuten antes de que una respuesta llegue al usuario: filtrar contenido dañino, detectar intentos de prompt injection, bloquear salidas que filtren datos sensibles y garantizar que el modelo se mantenga dentro del tema de su caso de uso. Los guardrails son la última línea de defensa entre la salida en bruto de un modelo y la persona que la lee.
Despliegue y versionado. Lanzar un nuevo prompt, una nueva versión del modelo o un nuevo índice de recuperación requiere la misma disciplina de despliegue escalonado que cualquier cambio de software en producción: lanzamientos canary, comparación A/B con la versión actual y una vía rápida de reversión cuando una puntuación de evaluación o una métrica visible para el usuario se mueve en la dirección equivocada.
LLMOps vs. MLOps
LLMOps surgió de MLOps, y ambos comparten mucho ADN: los dos se ocupan del versionado, el monitoreo y el despliegue fiable. Pero el objeto que se opera es lo bastante distinto como para que las prácticas diverjan en aspectos concretos.
| Dimensión | MLOps | LLMOps |
|---|---|---|
| Artefacto central | Un modelo entrenado con salidas numéricas fijas | Un prompt más un modelo (a menudo una API de terceros, no algo que usted entrenó) |
| Control de calidad | Exactitud, precisión y recall frente a un conjunto de prueba etiquetado | Conjuntos de evaluación puntuados por evaluadores automáticos, modelos de referencia o evaluadores humanos |
| Modo de fallo principal | Deriva de datos, deterioro del modelo, pérdida de exactitud con el tiempo | Alucinación, regresión de prompts, fallo de recuperación, cambios silenciosos del modelo del proveedor |
| Qué se versiona | Pesos del modelo, datos de entrenamiento, pipelines de features | Plantillas de prompt, índices de recuperación, versión del modelo y la combinación de los tres |
| Motor de costos | Cómputo de entrenamiento (mayormente concentrado al inicio, luego reentrenamientos periódicos) | Inferencia (continua, escala directamente con el uso, por llamada a la API) |
| Despliegue típico | Usted entrena y es dueño del modelo | A menudo llama al modelo de otra empresa por API y opera todo lo que lo rodea |
La conclusión práctica: si su equipo ya opera MLOps, no parte de cero. Pero un pipeline de MLOps construido para un modelo de churn no detectará una regresión de prompts ni un fallo de recuperación, porque nunca se diseñó para buscarlos.
El panorama de herramientas de LLMOps
La categoría de herramientas es joven y todavía se está consolidando, pero algunos tipos de herramientas se han vuelto comunes en los stacks de LLM en producción.
Plataformas de observabilidad y trazado como LangSmith y Langfuse capturan la traza completa de una solicitud a través de prompts, llamadas de recuperación y respuestas del modelo, de modo que los equipos pueden depurar una mala salida concreta reproduciendo exactamente lo que el sistema vio y devolvió.
Plataformas de evaluación y monitoreo como Arize gestionan tanto las evals offline (antes de lanzar un cambio) como el monitoreo en producción (deriva, puntuaciones de calidad y detección de anomalías sobre el tráfico real), a menudo tanto para cargas de ML tradicional como de LLM en la misma plataforma.
Herramientas de seguimiento de experimentos como Weights and Biases, creadas originalmente para ejecuciones de entrenamiento de ML clásico, se han extendido al seguimiento de experimentos de prompts y LLM, y permiten comparar lado a lado variantes de prompts y versiones de modelos con métricas registradas.
La mayoría de los equipos no adopta todo esto a la vez. Un punto de partida habitual es el registro estructurado de cada llamada a un LLM (prompt, respuesta, versión del modelo, conteo de tokens, latencia); después se incorpora una plataforma de observabilidad dedicada cuando el volumen de tráfico en producción hace impracticable la revisión manual; y luego se añade evaluación sistemática cuando hay suficientes datos registrados para construir un conjunto de evaluación representativo. Nuestra comparativa de plataformas de observabilidad de LLM pone precio a 12 de ellas con un volumen de trazas real.
Datos clave
- Gartner predice que el 40% de las organizaciones que despliegan IA usarán herramientas dedicadas de observabilidad de IA para monitorear el rendimiento, el sesgo y las salidas de los modelos hacia 2028, según un comunicado de prensa de Gartner sobre la adopción de la observabilidad de IA.
- Gartner predice que al menos el 30% de los proyectos de IA generativa se abandonarán tras la prueba de concepto a finales de 2025, por mala calidad de datos, controles de riesgo inadecuados, costos crecientes o valor de negocio poco claro.
- El 74% de los ejecutivos reporta ROI en el primer año de los despliegues de IA, pero solo el 39% reporta impacto en el EBIT a nivel empresarial, según la investigación State of AI de McKinsey sobre la brecha entre pilotar y escalar la IA.
- El gasto empresarial en software de IA generativa alcanzó los 37.000 millones de dólares en 2025, frente a 11.500 millones en 2024, un aumento interanual de 3,2 veces, según el informe 2025 State of Generative AI in the Enterprise de Menlo Ventures.
- Solo el 16% de los despliegues de IA empresariales califica como agentes autónomos verdaderos; la mayoría de los sistemas en producción sigue construida con flujos de trabajo de secuencia fija o basados en enrutamiento alrededor de una sola llamada a un modelo, según el mismo informe de Menlo Ventures.
- El 37% de las empresas ya usa cinco o más modelos en producción, frente al 29% del año anterior, según el informe de IA empresarial 2025 de a16z, señal de la orquestación multimodelo que LLMOps tiene cada vez más que gestionar.
Por qué LLMOps importa para la IA empresarial
La brecha entre una demo que funciona y una función de LLM de nivel productivo es exactamente donde se estancan la mayoría de las iniciativas de IA empresariales. La predicción de Gartner de que el 30% de los proyectos de IA generativa se abandona tras la prueba de concepto, y el hallazgo de Menlo Ventures de que la mayoría de los despliegues sigue siendo flujos de trabajo simples de un solo modelo y no sistemas agénticos maduros, apuntan al mismo problema de fondo: construir la llamada al modelo es la parte fácil. Operarla de forma fiable, a escala, con un costo predecible y un riesgo aceptable, es lo que separa un piloto de un producto.
Ahí es también donde aparece la brecha de ROI de McKinsey. El 74% de los ejecutivos reporta algún retorno en el primer año, pero solo el 39% ve impacto a nivel empresarial, lo que coincide con lo que ocurre cuando un equipo lanza una función de LLM sin la capa operativa que la rodea. Funciona para los primeros cientos de usuarios; luego una actualización de un prompt la rompe en silencio, o los costos se disparan al crecer el uso, o nadie nota que la calidad de las salidas se va deteriorando hasta que un cliente se queja. LLMOps es la diferencia entre una función de IA que sobrevive al contacto con el uso real y una que hay que retirar discretamente seis meses después.
La tendencia multimodelo añade otra capa: a16z encontró que las empresas ejecutan cada vez más cinco o más modelos en producción en lugar de apostar por uno solo, y enrutan las tareas rutinarias a modelos más económicos y reservan los modelos de frontera para el razonamiento más difícil. Esa decisión de enrutamiento, y el seguimiento de costos y calidad que exige, es en sí misma una función de LLMOps. A medida que las aplicaciones de LLM se vuelven más complejas, de prompts individuales a pipelines de RAG y a flujos de trabajo agénticos de varios pasos, la superficie operativa crece con ellas. Los equipos que tratan LLMOps como algo secundario suelen enterarse de los problemas por sus usuarios. Los que lo incorporan desde el inicio se enteran por su propio monitoreo, antes de que se convierta en un ticket de soporte.
Preguntas frecuentes sobre LLMOps
¿Qué es LLMOps?
LLMOps es el conjunto de prácticas operativas para desplegar, monitorear y mantener aplicaciones de modelos de lenguaje grandes en producción. Abarca la gestión de prompts, la evaluación, la gestión del pipeline de RAG, la observabilidad, el control de costos y latencia y las barreras de seguridad: el trabajo necesario para mantener fiable una función de LLM después del lanzamiento.
¿En qué se diferencia LLMOps de MLOps?
MLOps opera sobre un modelo entrenado con salidas numéricas verificables y se centra en la deriva de datos y el deterioro del modelo. LLMOps opera sobre un prompt más un modelo, a menudo accedido por API en lugar de entrenado internamente, y se centra en regresiones de prompts, alucinación y fallos de recuperación. LLMOps toma prestada la disciplina de MLOps en versionado y monitoreo, pero la aplica a un conjunto distinto de modos de fallo.
¿Se necesitan herramientas especializadas de LLMOps para empezar?
No desde el primer día. Muchos equipos empiezan con el registro estructurado de cada llamada a un LLM (prompt, respuesta, versión del modelo, tokens, latencia) en sus sistemas existentes. Las plataformas dedicadas como LangSmith, Langfuse, Arize o Weights and Biases aportan valor cuando el volumen de tráfico en producción hace impracticable la revisión manual o cuando se necesita evaluación sistemática a escala.
¿Qué es un conjunto de evaluación de prompts y por qué importa?
Un conjunto de evaluación es una colección de entradas representativas junto con un comportamiento esperado calificado, puntuadas por evaluadores automáticos, modelos de referencia o evaluadores humanos. Como las salidas de un LLM no se pueden verificar con una simple aserción de aprobado/reprobado como en el software tradicional, un conjunto de evaluación es la forma en que los equipos detectan si un cambio de prompt o de modelo mejoró o empeoró el producto antes de lanzarlo.
¿Cómo encaja RAG en LLMOps?
La generación aumentada por recuperación añade un paso de recuperación antes de que el modelo genere una respuesta, fundamentándola en los datos de la empresa. LLMOps se ocupa de mantener sano ese pipeline de recuperación: monitorear si el sistema encuentra los documentos correctos, detectar los casos en que el modelo ignora un buen contexto recuperado y mantener actualizada la base de conocimiento subyacente.
¿Qué causa que la mayoría de las aplicaciones de LLM fallen al llegar a usuarios reales?
Entre las causas habituales están las regresiones de prompts tras la actualización de un modelo por parte del proveedor, pipelines de recuperación que devuelven el contexto equivocado, picos de costos por uso de tokens sin monitorear y deriva de calidad que pasa inadvertida sin evaluación continua. Estos fallos suelen ser silenciosos, no lanzan errores, simplemente producen salidas peores sin avisar, razón por la cual la observabilidad y la evaluación son funciones centrales de LLMOps y no extras opcionales.
¿Qué son los guardrails en LLMOps?
Los guardrails son controles que se ejecutan antes de que la salida de un LLM llegue al usuario: filtran contenido dañino, detectan intentos de prompt injection, bloquean la filtración de datos sensibles y mantienen las respuestas dentro del tema. Son la última capa operativa entre la salida en bruto de un modelo y la persona que la lee.
¿LLMOps solo es relevante para equipos que construyen sus propios modelos?
No. La mayoría de las aplicaciones de LLM empresariales llama a un modelo de terceros por API en lugar de entrenar uno, lo que significa que las prácticas de LLMOps, gestión de prompts, evaluación, monitoreo de RAG, seguimiento de costos y guardrails, son justamente lo que un equipo necesita, haya entrenado o no el modelo subyacente.
Conceptos de IA relacionados
- MLOps - La disciplina más amplia que LLMOps extiende, que cubre todo el ciclo de vida del machine learning
- Observabilidad de IA - La disciplina de registros, trazas y métricas que LLMOps aplica específicamente a las llamadas a LLM
- Large Language Models - La categoría de modelos que LLMOps existe para operar de forma fiable
- Retrieval-Augmented Generation - Los pipelines de recuperación que LLMOps debe mantener sanos junto con el modelo
- Alucinación de IA - Un modo de fallo central que la evaluación y los guardrails de LLMOps están diseñados para detectar
- Inferencia - La fase de producción donde se aplican las prácticas de costo y latencia de LLMOps
- Prompt Engineering - La práctica previa que LLMOps versiona y monitorea en producción
- Model Monitoring - La disciplina de seguimiento continuo que LLMOps aplica al comportamiento de los LLM desplegados
Recursos externos
- LangSmith - Plataforma de observabilidad y evaluación para aplicaciones de LLM
- Langfuse - Plataforma open source de observabilidad y trazado de LLM
- Arize AI - Plataforma de observabilidad y evaluación de ML y LLM
- Weights and Biases - Seguimiento de experimentos extendido a la comparación de prompts y modelos de LLM
