Qu'est-ce que l'inférence IA ? Exécuter des modèles d'IA en production
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Une enseigne de distribution entraîne pendant six mois un modèle de prévision de la demande. Les data scientists le valident. La direction l'approuve. Le modèle est prêt. Puis il passe en production et doit répondre à des milliers de requêtes par jour, chacune en moins de 200 millisecondes, pendant des mois, voire des années. C'est cela, l'inférence : l'exécution continue, en conditions réelles, d'un modèle entraîné sur des données réelles pour produire des résultats réels.
L'entraînement capte l'essentiel de l'attention dans la couverture médiatique de l'IA. Or c'est l'inférence qui concentre la valeur métier et, en 2026, la plus grande part du budget IA. Le prix de l'inférence par token a baissé de plusieurs ordres de grandeur depuis 2022, et les usages ont progressé plus vite encore : la dépense totale d'inférence continue donc de grimper alors même que le coût unitaire ne cesse de diminuer.
Entraînement et inférence : la distinction fondamentale
Pour comprendre l'inférence, il faut comprendre ce qu'elle n'est pas. L'entraînement consiste à enseigner un modèle en l'exposant à de grandes quantités de données et en ajustant ses paramètres jusqu'à ce qu'il produise des résultats exacts. Il est gourmand en calcul, coûteux et relativement rare.
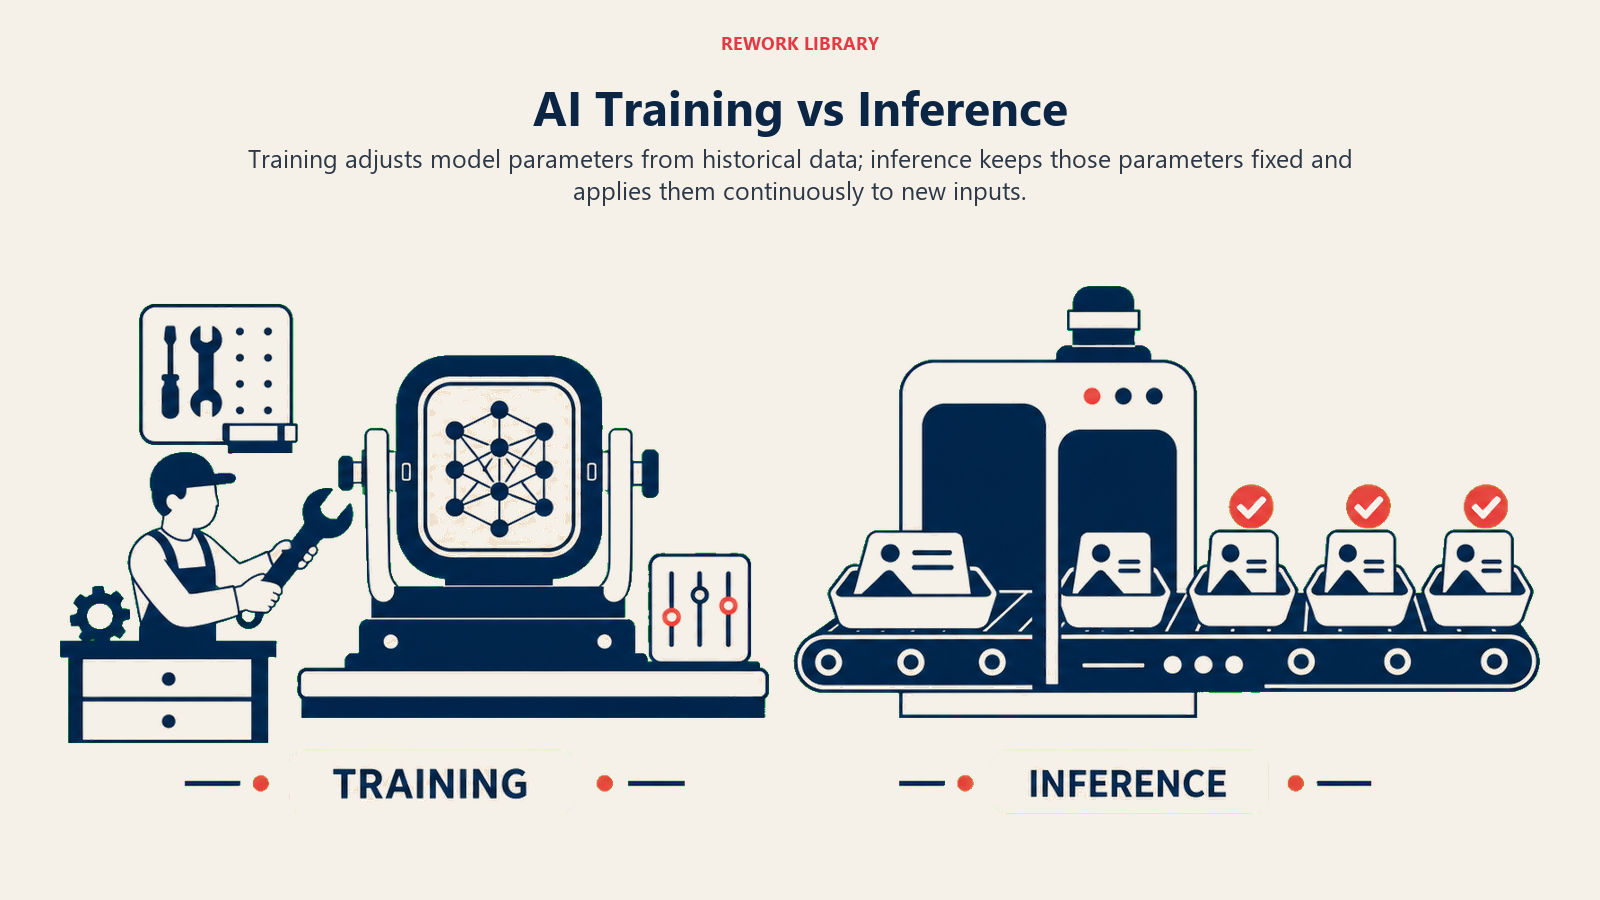
L'inférence est exactement l'inverse. Elle consiste à prendre un modèle dont les paramètres sont déjà fixés et à l'exécuter sur de nouvelles données pour générer des prédictions. Il y a inférence quand :
- un client saisit une question dans un chatbot et obtient une réponse ;
- un système de détection de fraude évalue une transaction en temps réel ;
- un pipeline de traitement de documents extrait les données d'une facture importée ;
- un moteur de recommandation décide de ce qu'il affichera ensuite à un utilisateur.
L'entraînement a lieu une fois (ou périodiquement). L'inférence a lieu en continu, au volume que le système de production exige. Pour la plupart des entreprises, l'inférence représente presque tout le coût de calcul de l'IA en production.
| Dimension | Entraînement | Inférence |
|---|---|---|
| Objectif | Enseigner le modèle en ajustant ses paramètres sur des données historiques | Appliquer les paramètres figés du modèle à une donnée nouvelle, jamais vue |
| Fréquence | Une fois, puis périodiquement pour le réentraînement ou le fine-tuning | En continu, à chaque requête d'un utilisateur ou d'un système |
| Profil de calcul | Calcul soutenu, massif et parallèle sur plusieurs jours ou semaines | Courtes rafales par requête, répétées de milliers à des milliards de fois |
| Forme du coût | Dépense élevée, concentrée au départ, de type projet | Dépense récurrente, à l'usage, qui augmente avec l'adoption |
Un modèle bon marché à entraîner mais coûteux à exploiter à grande échelle peut rester une mauvaise décision. À l'inverse, un modèle coûteux à entraîner mais peu cher à exécuter à fort volume peut se rentabiliser plusieurs fois. Ce sont généralement l'économie de l'inférence, et non les benchmarks d'entraînement, qui décident du modèle réellement déployé.
Comment fonctionne l'inférence
Pendant l'inférence, le modèle entraîné reçoit une entrée (texte, image, données structurées ou audio) et la fait passer par ses paramètres appris pour produire un résultat. Pour un grand modèle de langage, l'entrée est convertie en tokens, le modèle les traite avec son architecture transformer en s'appuyant sur ses mécanismes d'attention, puis les tokens de sortie sont générés l'un après l'autre jusqu'à ce que la réponse soit complète. C'est pourquoi les réponses longues prennent plus de temps : chaque token de sortie exige un nouveau passage complet dans le modèle.
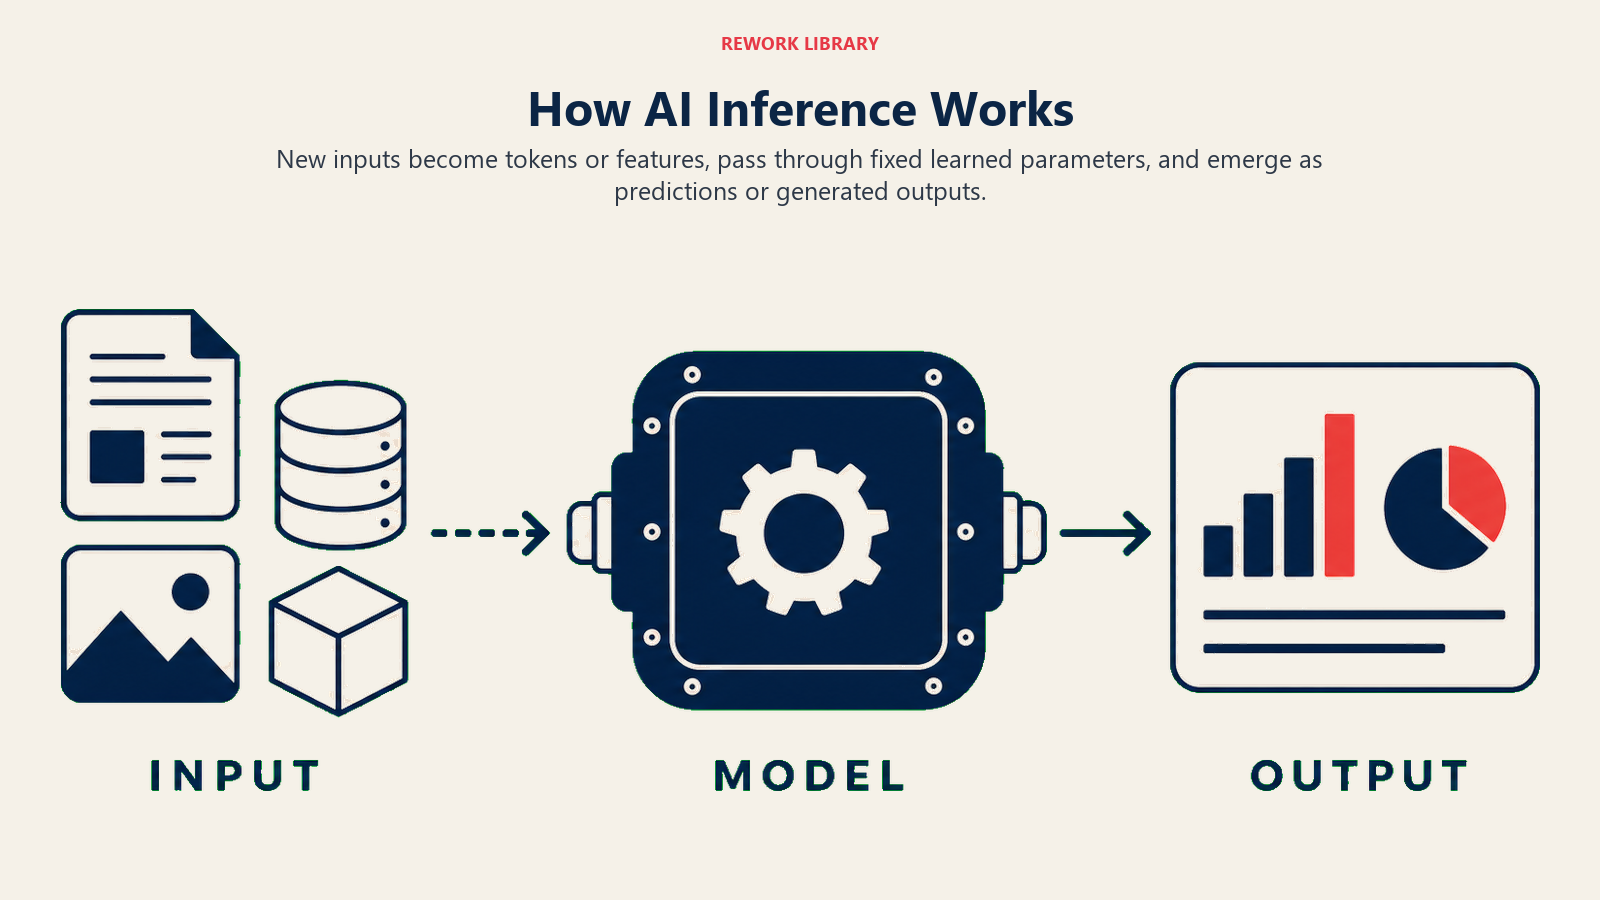
Les paramètres du modèle ne changent pas pendant l'inférence. Le modèle n'apprend pas de la requête : il applique ce qu'il sait déjà à la nouvelle entrée. En pratique, cela signifie qu'un même modèle peut servir des milliers d'utilisateurs simultanés sans que les uns n'influent sur les autres.
Le coût de l'inférence vient du calcul nécessaire pour faire traverser les entrées par un modèle qui peut compter des milliards, voire des centaines de milliards de paramètres. Plus de paramètres signifie en général plus de capacités, mais aussi plus de calcul par appel d'inférence.
Les deux dimensions clés de la performance
La latence est la durée d'un appel d'inférence, de l'entrée à la sortie, y compris le temps avant le premier token puis le temps de génération de chacun des suivants. Un utilisateur qui attend la réponse d'un chatbot subit la latence. Une IA d'imagerie médicale exige une faible latence quand un radiologue attend son analyse. Un traitement de documents exécuté la nuit en batch tolère une latence plus élevée.
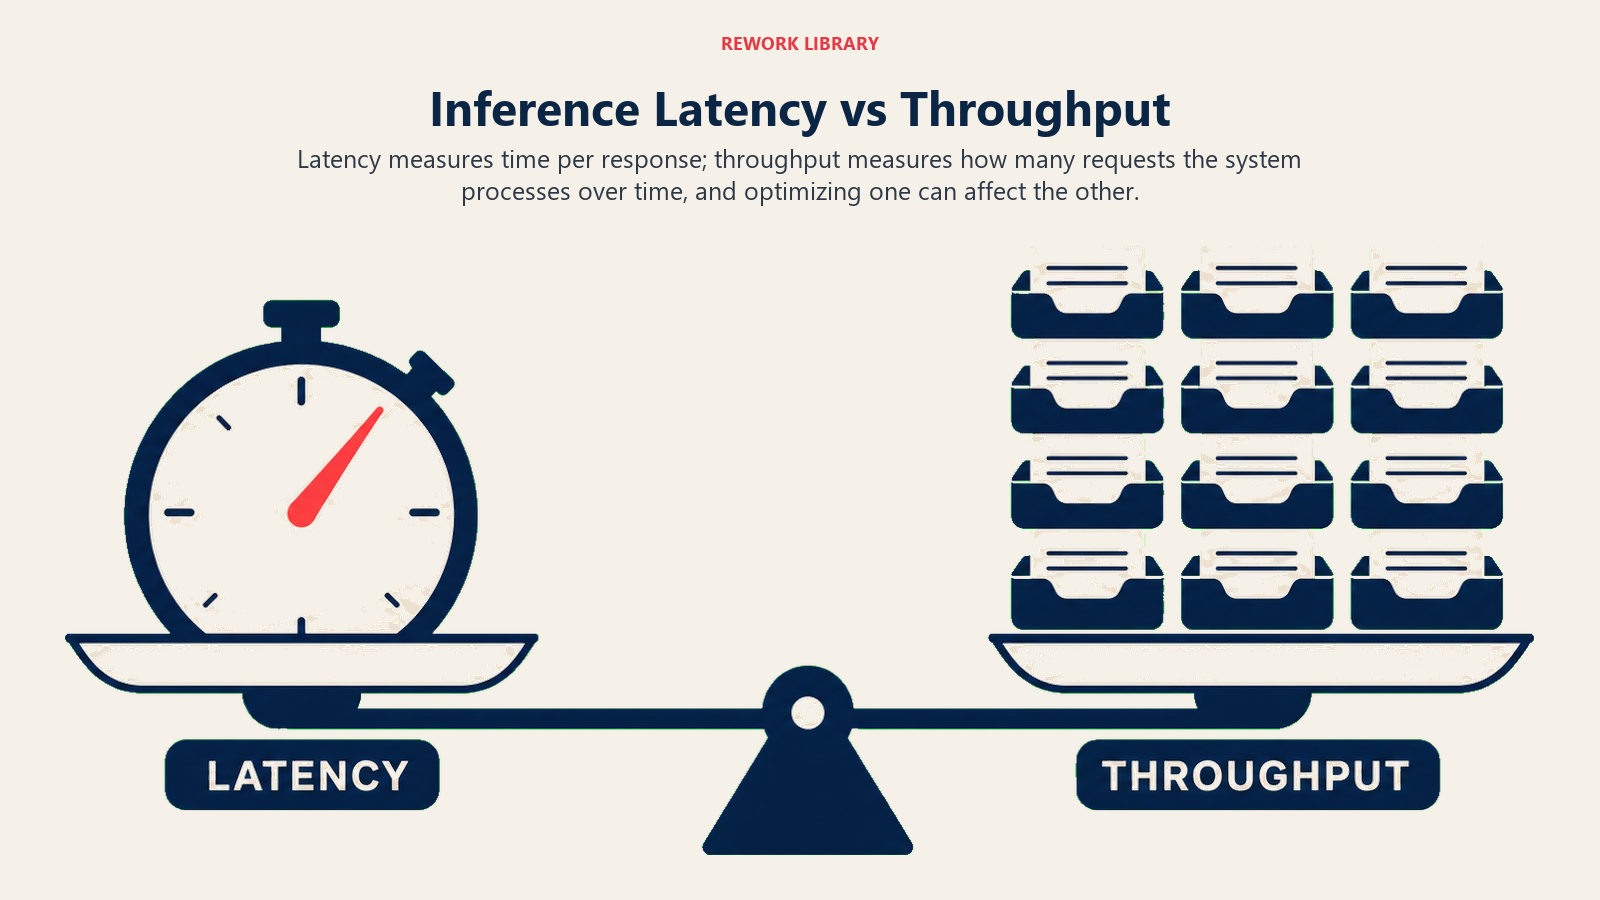
Le débit est le nombre d'appels d'inférence qu'un système peut traiter par unité de temps. Un moteur de recommandation e-commerce qui sert des millions d'acheteurs a besoin d'un débit élevé. Un outil d'analyse de documents juridiques utilisé par une équipe de 20 analystes a des besoins de débit bien moindres.
Ces deux dimensions s'opposent souvent. Regrouper plusieurs requêtes d'inférence, par exemple, augmente le débit puisque le matériel traite de nombreuses entrées en parallèle, mais accroît la latence de chaque requête, qui attend que le lot se remplisse. Le bon équilibre dépend du cas d'usage.
L'optimisation de l'inférence est le champ technique consacré à l'amélioration des deux dimensions : faire tourner les modèles plus vite et à moindre coût sans sacrifier la qualité.
Où s'exécute l'inférence : cloud, edge et sur l'appareil
L'inférence se situe au sommet de la pile IA. Les modèles de fondation sont entraînés une fois par des laboratoires d'IA sur d'immenses clusters de calcul. Les entreprises appellent ensuite ces modèles via une API ou les déploient sur leur propre infrastructure, et le lieu d'exécution de l'inférence est une vraie décision d'architecture, pas un détail à laisser à l'équipe infrastructure.
L'inférence dans le cloud. Le modèle s'exécute sur les serveurs d'un fournisseur, en général via une API. C'est le choix par défaut de la plupart des entreprises qui utilisent les modèles de fondation des grands laboratoires. Le démarrage est simple, la montée en charge est automatique et le coût suit directement l'usage. En contrepartie, la facturation à chaque appel est permanente, l'entreprise dépend de la disponibilité et des décisions tarifaires du fournisseur, et la latence réseau entre la requête et le centre de données s'ajoute.
L'inférence auto-hébergée. L'entreprise exécute le modèle sur sa propre infrastructure GPU, dans un compte cloud privé ou sur site. Elle gagne en maîtrise de la confidentialité des données, peut dépenser moins que les tarifs d'API à très gros volume stable et peut personnaliser plus finement grâce au fine-tuning. Mais elle doit aussi assumer la charge opérationnelle : approvisionner les GPU, garantir la disponibilité et absorber les pics sans l'élasticité d'un fournisseur.
L'inférence en périphérie (edge) et sur l'appareil. Le modèle s'exécute localement, sur un téléphone, dans un navigateur, sur une borne en magasin ou sur un capteur industriel, sans aucun aller-retour réseau. C'est l'option à la plus faible latence, et les données ne quittent pas l'appareil, ce qui compte pour les usages sensibles à la confidentialité. En contrepartie, les capacités sont limitées : les appareils en périphérie disposent de peu de mémoire et de calcul, de sorte que le déploiement edge implique généralement un modèle plus petit et compressé plutôt qu'un modèle de pointe.
Aucune de ces options n'est universellement la bonne. Un chatbot de support client peut recourir à l'inférence cloud pour la qualité. Une application d'inspection sur le terrain à la connectivité aléatoire peut avoir besoin de l'inférence edge pour fonctionner tout court. Un workflow de santé réglementé peut exiger l'inférence auto-hébergée, uniquement pour des raisons de résidence des données.
Les pratiques de MLOps encadrent la gestion de l'inférence en production : versionnage et déploiement des modèles, suivi des performances, retour en arrière quand un modèle se comporte de façon inattendue, moment du réentraînement. Le suivi des modèles consiste à surveiller en continu les résultats et les indicateurs de performance de l'inférence pour détecter toute dégradation avant qu'elle n'ait un impact sur l'activité.
Ce qui a changé en 2026
Pendant des années, le débat sur l'IA a été dominé par l'entraînement : des modèles plus gros, des entraînements plus lourds, des titres plus tapageurs. Ce n'est plus là que se jouent l'argent ni le risque. L'inférence est devenue le centre de gravité opérationnel et financier de l'IA en production, pour trois raisons liées.
L'usage progresse plus vite que le coût par appel ne baisse. Les prix de l'inférence ont chuté spectaculairement depuis fin 2022, mais l'adoption a crû plus vite encore : la dépense totale d'inférence continue donc d'augmenter alors que les coûts unitaires diminuent.
L'inférence est récurrente, l'entraînement non. Un entraînement est un projet avec un début et une fin. L'inférence tourne pendant toute la vie d'une fonctionnalité déployée, soit des années pour un produit qui réussit. Un coût qui paraît faible par appel devient significatif une fois multiplié par des millions de requêtes quotidiennes, sans limite de durée.
Les fournisseurs d'infrastructure se réorganisent déjà autour de ce constat. Les analystes prévoient que les charges d'inférence dépasseront l'entraînement comme principale demande des centres de données d'IA dans les prochaines années, et les hyperscalers adaptent en conséquence la manière et le lieu où ils construisent leurs capacités : les clusters d'entraînement vont vers des sites isolés à forte densité électrique, tandis que la capacité d'inférence se rapproche des utilisateurs pour réduire la latence réseau.
Pour tout dirigeant qui parraine des projets d'IA, la conséquence pratique est claire : le modèle qui gagne le benchmark d'entraînement n'est pas automatiquement celui qu'il faut déployer. C'est le modèle dont l'économie d'inférence tient à votre volume de production réel qui détermine si une fonctionnalité d'IA est un produit durable ou un pilote coûteux.
Chiffres clés :
- Le coût d'interrogation d'un modèle au niveau de GPT-3.5 est passé de 20,00 \(à 0,07\) par million de tokens entre novembre 2022 et octobre 2024, soit une baisse de plus de 280 fois en une quinzaine de mois, selon le rapport Stanford AI Index 2025.
- À niveau de performance constant, les prix d'inférence des LLM ont baissé à un rythme médian d'environ 50 fois par an, avec une accélération à environ 200 fois par an pour les données à partir de janvier 2024, d'après l'analyse des tendances de prix de l'inférence par Epoch AI.
- L'inférence devrait dépasser l'entraînement comme principale charge de calcul de l'IA d'ici 2030, avec plus de la moitié du calcul IA et 30 à 40 pour cent de la demande totale des centres de données, selon l'analyse de McKinsey sur l'évolution des charges de travail IA.
- 49 pour cent des grandes entreprises indiquaient en 2025 que la majeure partie, voire la quasi-totalité, de leur calcul relève de l'inférence, contre 29 pour cent un an plus tôt, d'après la mise à jour de mi-année 2025 de Menlo Ventures sur le marché des LLM.
- En 2025, les dépenses d'Anthropic comprenaient environ 2,7 milliards de dollars de calcul d'inférence et 4,1 milliards de dollars de calcul de R&D (entraînement), sur 9,7 milliards de dollars de dépenses totales, selon l'analyse d'Epoch AI sur les dépenses des entreprises d'IA, à partir d'informations publiées par The Information.
- Le marché mondial de l'inférence IA devrait passer de 106,15 milliards de dollars en 2025 à 254,98 milliards de dollars d'ici 2030, devançant l'entraînement comme première catégorie de dépenses de l'IA en entreprise, selon une étude de MarketsandMarkets citée par Forbes.
Le coût de l'inférence pour l'entreprise
Pour les organisations qui utilisent l'IA à grande échelle, le coût d'inférence est une ligne budgétaire significative. Ses principaux déterminants :
La taille du modèle. Les modèles plus gros demandent plus de calcul par appel d'inférence. Un modèle de 70 milliards de paramètres coûte environ 10 fois plus cher à exécuter qu'un modèle de 7 milliards, même si l'écart de qualité peut justifier ce coût pour certains cas d'usage.
Le volume de requêtes. Les coûts d'inférence augmentent avec l'usage. Un système qui traite 10 millions d'appels d'inférence par jour coûte proportionnellement plus cher qu'un système qui en traite 10 000.
Le matériel. L'inférence sur GPU est plus rapide mais plus coûteuse que sur CPU. Les puces spécialisées pour l'inférence (comme les TPU de Google ou AWS Inferentia) peuvent améliorer le rapport coût-efficacité pour certaines charges.
La taille de la fenêtre de contexte. Pour les modèles de langage, les entrées longues coûtent plus cher à traiter, car le coût d'inférence croît avec le nombre de tokens. Les systèmes qui transmettent beaucoup de contexte à chaque appel supportent des coûts proportionnellement plus élevés.
Comme le coût d'inférence croît directement avec l'usage, c'est le levier le plus puissant pour réduire la dépense d'IA sans toucher au périmètre du produit. Les principales techniques d'optimisation sont :
La quantification. Réduire la précision numérique des poids du modèle, par exemple de la virgule flottante 32 bits à des entiers 8 bits ou 4 bits, diminue l'empreinte mémoire du modèle et accélère le calcul, généralement avec une légère perte de précision. Voir Quantification pour le détail du mécanisme.
La distillation. Entraîner un modèle « élève » plus petit à imiter les sorties d'un modèle « enseignant » plus grand. Le résultat tourne plus vite et coûte moins cher, tout en conservant l'essentiel des capacités de l'enseignant sur les tâches visées par la distillation.
Le batching. Regrouper plusieurs requêtes d'inférence pour que le matériel les traite en parallèle plutôt qu'une par une. Le débit augmente nettement, au prix d'un peu de latence supplémentaire pour chaque requête, puisqu'elle attend que le lot se remplisse.
Le caching. Stocker les résultats des requêtes fréquentes ou répétées pour éviter de retraiter deux fois la même entrée. Pour les applications à fort trafic répétitif, le caching peut supprimer purement et simplement une grande part des appels d'inférence.
Le décodage spéculatif. Un petit modèle « brouillon », rapide, prédit plusieurs tokens à l'avance, et le modèle plus grand les vérifie en un seul passage au lieu de générer chaque token seul. Quand les prédictions du modèle brouillon sont bonnes, le nombre de passages coûteux du modèle complet nécessaires pour produire une réponse diminue.
La plupart des systèmes de production combinent plusieurs de ces techniques. Aucune n'oblige à passer à un modèle fondamentalement différent ou de moindre qualité : elles changent l'efficacité avec laquelle un modèle existant est servi. Les organisations qui les appliquent de façon systématique déclarent couramment des réductions de coûts de 50 à 90 pour cent par rapport à un déploiement non optimisé.
Inférence en temps réel et inférence par lots
Toute l'inférence ne se fait pas en temps réel. De nombreuses applications d'IA à forte valeur tournent selon un calendrier de traitement par lots plutôt qu'en réponse à des requêtes en direct.
L'inférence en temps réel traite les requêtes à mesure qu'elles arrivent, avec une latence de quelques millisecondes à quelques secondes. Les chatbots, la détection de fraude, la personnalisation en temps réel et les assistants vocaux exigent ce mode.
L'inférence par lots (batch) traite de grands jeux de données selon un calendrier, souvent la nuit ou à la demande. L'enrichissement du CRM qui s'exécute chaque nuit pour scorer tous les leads, le traitement de documents qui épuise une file de fichiers importés ou les analyses qui génèrent des rapports hebdomadaires relèvent tous de ce modèle. L'inférence par lots est généralement moins chère par appel, car elle peut tirer parti de stratégies de regroupement efficaces sans la contrainte de latence d'un usage en direct.
Le choix entre les deux modes est une décision de produit et d'architecture, pas seulement technique. De nombreux cas d'usage qui semblent d'abord exiger du temps réel peuvent être repensés en quasi-temps réel ou en batch sans perte notable de valeur métier, pour un coût nettement inférieur.
Ce que les dirigeants doivent comprendre
Les termes d'IA qui attirent le plus l'attention (données d'entraînement, architecture du modèle, scores de benchmark) renvoient tous au potentiel d'un modèle. C'est l'inférence qui décide si ce potentiel se traduit en résultats pour l'entreprise ou non. Trois conséquences pratiques découlent directement de son fonctionnement, et toutes trois doivent figurer sur la liste de contrôle d'un dirigeant avant d'approuver un déploiement d'IA, pas après.
Le coût augmente avec le succès, dans les deux sens. Le coût d'entraînement est à peu près fixe une fois le projet terminé. Le coût d'inférence suit directement l'adoption : plus une fonctionnalité est utile, plus elle est utilisée, et plus elle coûte à exécuter. Une fonctionnalité abordable lors d'un pilote avec 50 utilisateurs peut devenir une vraie ligne budgétaire à 50 000 utilisateurs.
La latence détermine si les gens utilisent réellement la fonctionnalité. Les utilisateurs adaptent leur comportement à la rapidité de réponse d'une fonctionnalité d'IA. Les outils interactifs qui mettent plus de quelques secondes à répondre voient régulièrement l'adoption décroître, et une fois que les utilisateurs ont appris à contourner une fonctionnalité lente, ils n'y reviennent souvent pas, même après correction.
Le lieu d'exécution de l'inférence détermine qui peut voir vos données. Avec l'inférence cloud via une API tierce, les requêtes, et tout le contexte qu'elles contiennent, quittent votre environnement. Pour les charges réglementées ou sensibles, c'est parfois rédhibitoire, d'où l'existence de l'inférence auto-hébergée ou edge comme alternative, même à un coût opérationnel plus élevé.
Pour évaluer des fournisseurs d'IA ou des options de développement en interne, interrogez-les sur le coût d'inférence par appel à votre volume attendu, la latence sous charge réelle de production, l'évolution du coût d'inférence avec l'usage et la destination réelle de vos données lorsque le modèle s'exécute. Ces chiffres déterminent si les cas d'usage d'IA sont économiquement viables.
Concepts d'IA associés
- Optimisation de l'inférence - Les techniques pour rendre l'inférence plus rapide et moins chère
- MLOps - Gérer le déploiement des modèles et les pipelines d'inférence
- Edge AI - Exécuter l'inférence sur du matériel local plutôt que dans le cloud
- Suivi des modèles - Suivre les performances de l'inférence dans le temps
- Latence - Pourquoi le temps de réponse décide de l'adoption des fonctionnalités d'IA en production
- Fenêtre de contexte - Principal déterminant du coût d'inférence des modèles de langage
- Architecture transformer - Comment la plupart des modèles modernes calculent l'inférence
- Quantification - Réduire la taille du modèle pour abaisser le coût d'inférence
- Grands modèles de langage - La catégorie de modèles au cœur de la plupart des discussions sur l'inférence
- Modèles de fondation - Les modèles de base sur lesquels les entreprises exécutent l'inférence via une API ou en auto-hébergement
Ressources externes
- NVIDIA Inference Platform - Infrastructure de référence pour l'inférence de modèles à grande échelle
- Hugging Face Inference Endpoints - Guide sur le déploiement de modèles en production et les compromis d'inférence
- Google AI Inference Best Practices - Guide pratique sur l'architecture et l'optimisation de l'inférence
Questions fréquentes sur l'inférence IA
Qu'est-ce que l'inférence IA ?
L'inférence IA est l'exécution d'un modèle de machine learning entraîné sur de nouvelles données pour générer des prédictions ou des résultats. C'est la phase de production de l'IA, où un modèle entraîné sur des données historiques est appliqué à des données réelles pour créer de la valeur : répondre aux demandes des clients, scorer des leads, détecter des fraudes ou générer des documents.
Quelle différence entre entraînement et inférence ?
L'entraînement consiste à enseigner un modèle en l'exposant à de grands jeux de données et en ajustant ses paramètres. L'inférence consiste à exécuter le modèle entraîné sur de nouvelles entrées sans modifier ces paramètres. L'entraînement est rare et demande une puissance de calcul massive. L'inférence est continue et se fait au volume de production, ce qui explique l'essentiel du coût d'infrastructure récurrent de l'IA.
Pourquoi l'inférence est-elle devenue plus coûteuse à gérer que l'entraînement pour de nombreuses entreprises ?
L'entraînement est un coût de projet, unique ou occasionnel. L'inférence est un coût récurrent qui augmente directement avec le nombre d'utilisateurs d'une fonctionnalité et la fréquence de leur usage. À mesure que l'adoption progresse, la dépense d'inférence progresse avec elle, même si le coût de chaque appel continue de baisser. Plusieurs rapports sectoriels de 2025 ont constaté que l'inférence représente désormais la majorité de la dépense de calcul d'IA récurrente, tant dans les grandes entreprises que dans les startups nées dans l'IA.
Pourquoi la latence d'inférence compte-t-elle pour l'entreprise ?
La latence détermine la réactivité perçue d'une expérience reposant sur l'IA. Les applications orientées client, comme les chatbots, les recommandations en temps réel et les assistants vocaux, exigent une faible latence pour ne pas frustrer les utilisateurs. Les outils internes utilisés par les collaborateurs tolèrent en général davantage de latence. Bien définir le besoin de latence est une étape importante des décisions d'architecture d'inférence.
L'inférence doit-elle s'exécuter dans le cloud ou sur l'appareil ?
Cela dépend du besoin de latence, de la sensibilité des données et du volume. L'inférence cloud est la plus simple à déployer et s'adapte automatiquement à la charge, ce qui convient à la plupart des applications métier. L'inférence sur l'appareil ou en périphérie supprime entièrement la latence réseau et garde les données en local, ce qui compte pour les usages sensibles à la confidentialité ou à la connectivité limitée, mais impose généralement un modèle plus petit et moins performant.
L'inférence IA est-elle toujours en temps réel ?
Non. L'inférence en temps réel répond aux requêtes à mesure qu'elles arrivent, ce dont ont besoin les chatbots, la détection de fraude et la personnalisation en direct. L'inférence par lots traite de gros volumes de données selon un calendrier, souvent la nuit, et coûte généralement moins cher par appel puisqu'elle n'a pas à respecter une exigence de latence en direct. De nombreuses charges qui semblent exiger du temps réel peuvent tourner en batch ou en quasi-temps réel sans véritable perte de valeur métier.
Comment les organisations peuvent-elles réduire leurs coûts d'inférence ?
Les principaux leviers sont l'utilisation de modèles plus petits lorsque la qualité le permet, la quantification pour réduire la taille du modèle, la distillation d'un petit modèle à partir d'un plus grand, le regroupement des requêtes lorsque les contraintes de latence le permettent, la mise en cache des réponses courantes et le décodage spéculatif pour les modèles de langage. L'optimisation de l'inférence est une discipline technique à part entière ; de nombreuses organisations obtiennent des réductions de coûts de 50 à 90 % grâce à une optimisation systématique, sans changer de modèle.

Co-Founder, Rework.com
On this page
- Entraînement et inférence : la distinction fondamentale
- Comment fonctionne l'inférence
- Les deux dimensions clés de la performance
- Où s'exécute l'inférence : cloud, edge et sur l'appareil
- Ce qui a changé en 2026
- Chiffres clés :
- Le coût de l'inférence pour l'entreprise
- Inférence en temps réel et inférence par lots
- Ce que les dirigeants doivent comprendre
- Concepts d'IA associés
- Ressources externes