Was ist AI Inference? KI-Modelle im Produktionsbetrieb
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Ein Händler trainiert über sechs Monate ein Modell zur Nachfrageprognose. Data Scientists validieren es. Die Führungsebene genehmigt es. Das Modell ist bereit. Dann geht es in Produktion und muss täglich Tausende von Anfragen beantworten, jede in unter 200 Millisekunden, über Monate oder Jahre hinweg. Das ist Inference: der live, kontinuierliche Prozess, ein trainiertes Modell auf echten Daten auszuführen, um echte Ausgaben zu generieren.
Training bekommt den größten Teil der Aufmerksamkeit in der AI-Berichterstattung. Inference ist der Ort, an dem der Geschäftswert tatsächlich entsteht, und 2026 ist es auch der Ort, an dem der größte Teil des AI-Budgets liegt. Die Inference-Preise pro Token sind seit 2022 um Größenordnungen gefallen, die Nutzung ist jedoch noch schneller gewachsen. Die Gesamtausgaben für Inference steigen daher weiter, obwohl die Stückkosten weiter sinken.
Training vs. Inference: Der grundlegende Unterschied
Um Inference zu verstehen, muss man verstehen, was es nicht ist. Training ist der Prozess, ein Modell zu lehren, indem es großen Datenmengen ausgesetzt wird und seine Parameter so angepasst werden, bis es genaue Ausgaben produziert. Training ist rechenintensiv, teuer und wird relativ selten durchgeführt.
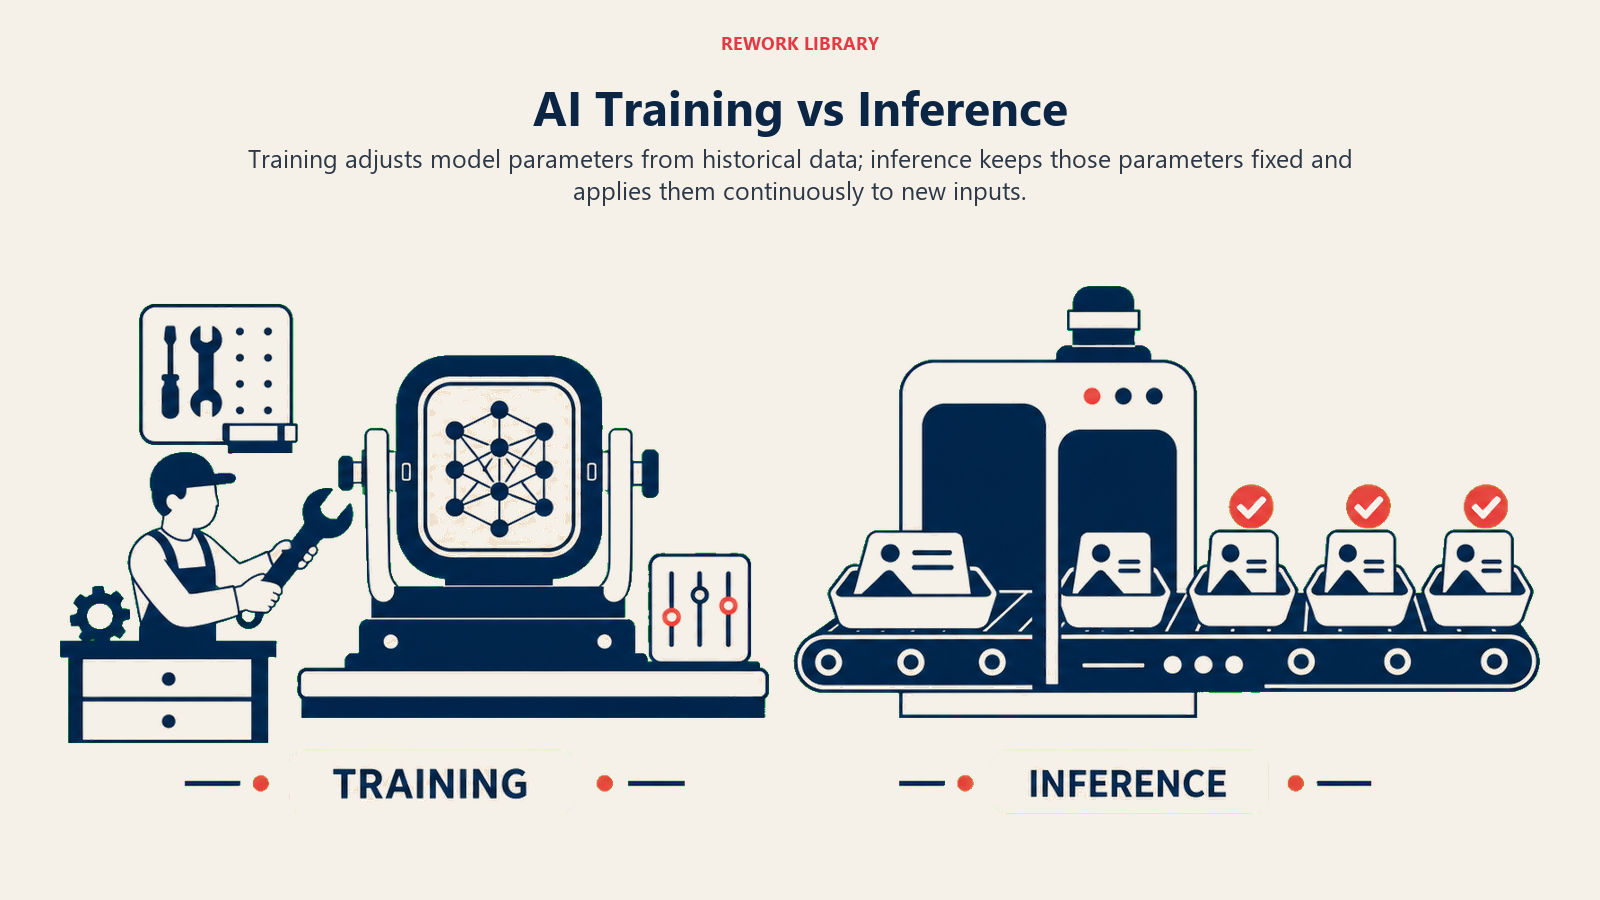
Inference ist das Gegenteil von all dem. Es ist der Prozess, ein Modell, dessen Parameter bereits festgelegt sind, auf neuen Eingaben auszuführen, um Vorhersagen zu generieren. Inference findet statt, wenn:
- Ein Kunde eine Frage in einen Chatbot tippt und eine Antwort erhält
- Ein Betrugserkennungssystem eine Transaktion in Echtzeit bewertet
- Eine Dokumentenverarbeitungs-Pipeline Daten aus einer hochgeladenen Rechnung extrahiert
- Eine Empfehlungsmaschine entscheidet, was einem Nutzer als nächstes angezeigt werden soll
Training findet einmal (oder periodisch) statt. Inference findet kontinuierlich statt, in welchem Volumen auch immer das Produktionssystem verlangt. Für die meisten Unternehmen stammen nahezu alle laufenden Computing-Kosten von AI im Produktionsbetrieb aus der Inference.
| Dimension | Training | Inference |
|---|---|---|
| Zweck | Das Modell durch Anpassung der Parameter an historischen Daten lehren | Die festen Parameter des Modells auf eine neue, unbekannte Eingabe anwenden |
| Häufigkeit | Einmalig, danach periodisch für Retraining oder Fine-Tuning | Kontinuierlich, jedes Mal wenn ein Nutzer oder System das Modell abfragt |
| Rechenmuster | Anhaltende, groß angelegte, parallele Berechnung über Tage oder Wochen | Kurze Lastspitzen pro Anfrage, tausend- bis milliardenfach wiederholt |
| Kostenstruktur | Große, im Voraus anfallende, projektartige Ausgaben | Laufende, nutzungsbasierte Ausgaben, die mit der Adoption skalieren |
Ein Modell, das günstig zu trainieren, aber im großen Maßstab teuer zu betreiben ist, kann trotzdem eine schlechte Geschäftsentscheidung sein. Ein Modell, das teuer zu trainieren, aber bei hohem Volumen günstig zu betreiben ist, kann sich um ein Vielfaches amortisieren. Die Wirtschaftlichkeit der Inference, nicht Trainings-Benchmarks, entscheidet meist darüber, welches Modell tatsächlich ausgeliefert wird.
Wie Inference funktioniert
Während der Inference empfängt das trainierte Modell eine Eingabe, ob Text, ein Bild, strukturierte Daten oder Audio, und führt sie durch seine erlernten Parameter, um eine Ausgabe zu produzieren. Bei einem Large Language Model bedeutet das, dass die Eingabe in Tokens umgewandelt wird, das Modell diese Tokens durch seine Transformer-Architektur mit den erlernten Attention-Mechanismen verarbeitet und die Ausgabe-Tokens sequenziell generiert werden, bis die Antwort vollständig ist. Deshalb dauern längere Antworten länger: Jeder Ausgabe-Token erfordert einen weiteren vollständigen Durchlauf durch das Modell.
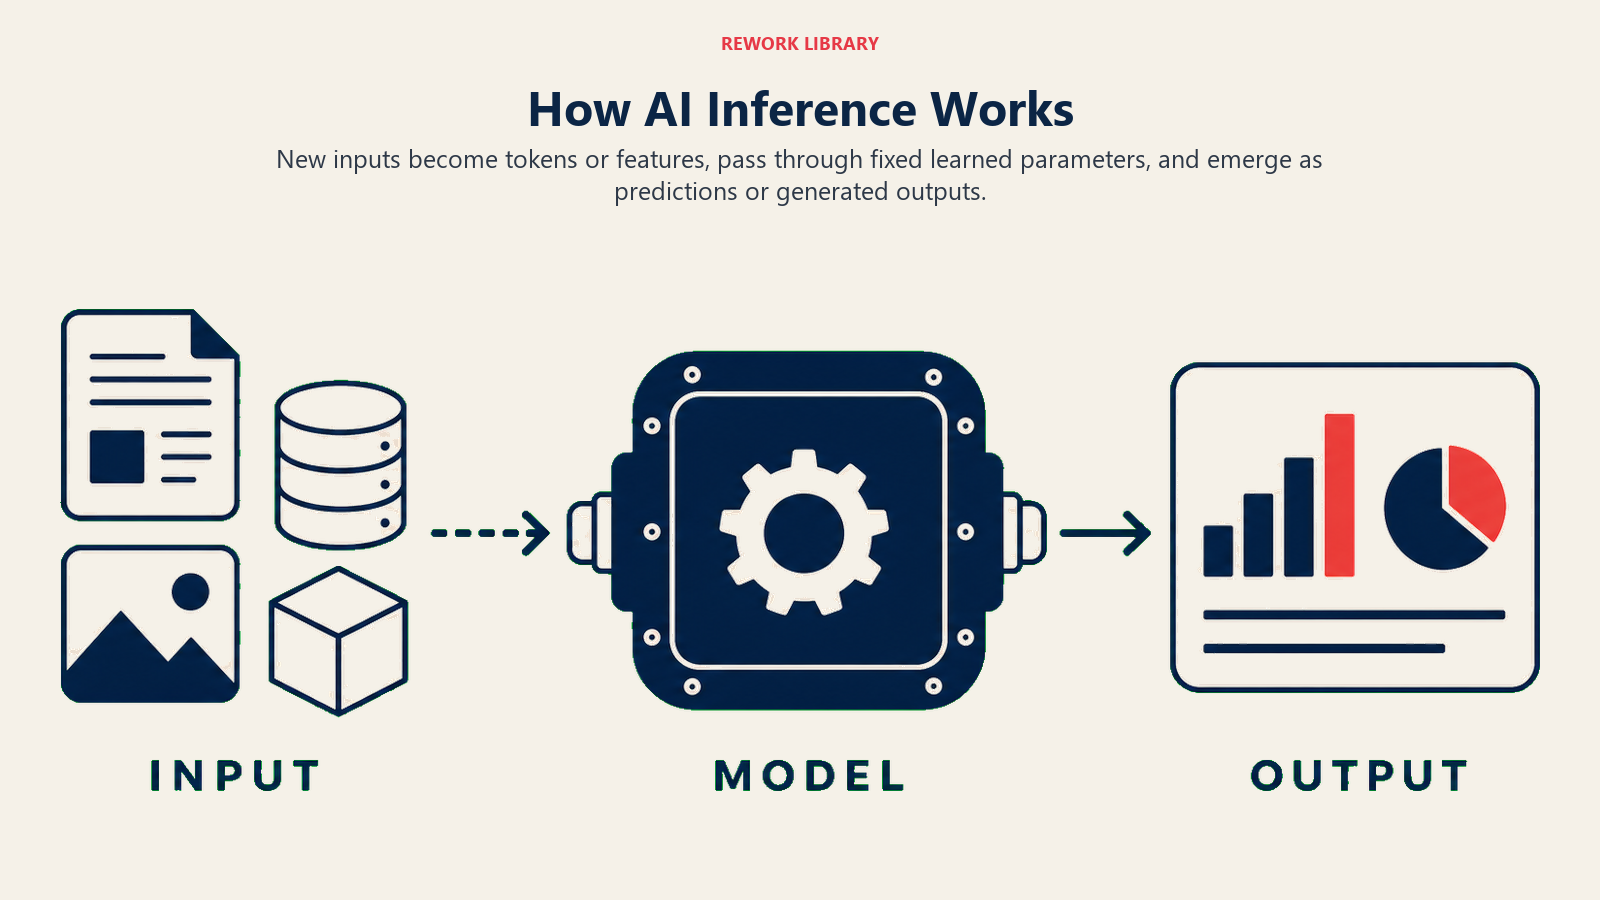
Die Parameter des Modells ändern sich während der Inference nicht. Das Modell lernt nicht aus der Anfrage; es wendet das, was es bereits gelernt hat, auf die neue Eingabe an. Dieser Unterschied ist praktisch bedeutsam: Er bedeutet, dass dasselbe Modell Tausende gleichzeitiger Nutzer bedienen kann, ohne dass einer den anderen beeinflusst.
Die Kosten der Inference entstehen durch die Berechnung, die erforderlich ist, um Eingaben durch ein Modell zu verarbeiten, das möglicherweise Milliarden oder Hunderte von Milliarden von Parametern hat. Mehr Parameter bedeuten im Allgemeinen mehr Fähigkeiten und mehr Berechnung pro Inference-Aufruf.
Die zwei wichtigsten Leistungsdimensionen
Latenz ist die Zeit, die ein einzelner Inference-Aufruf von der Eingabe bis zur Ausgabe benötigt, einschließlich der Zeit bis zum ersten Token und der Zeit für jedes weitere Token. Nutzer, die auf eine Chatbot-Antwort warten, erleben Latenz. Medizinische Bildgebungs-AI braucht niedrige Latenz, wenn ein Radiologe auf eine Diagnose wartet. Dokumentenverarbeitung, die über Nacht im Batch-Betrieb stattfindet, kann höhere Latenz tolerieren.
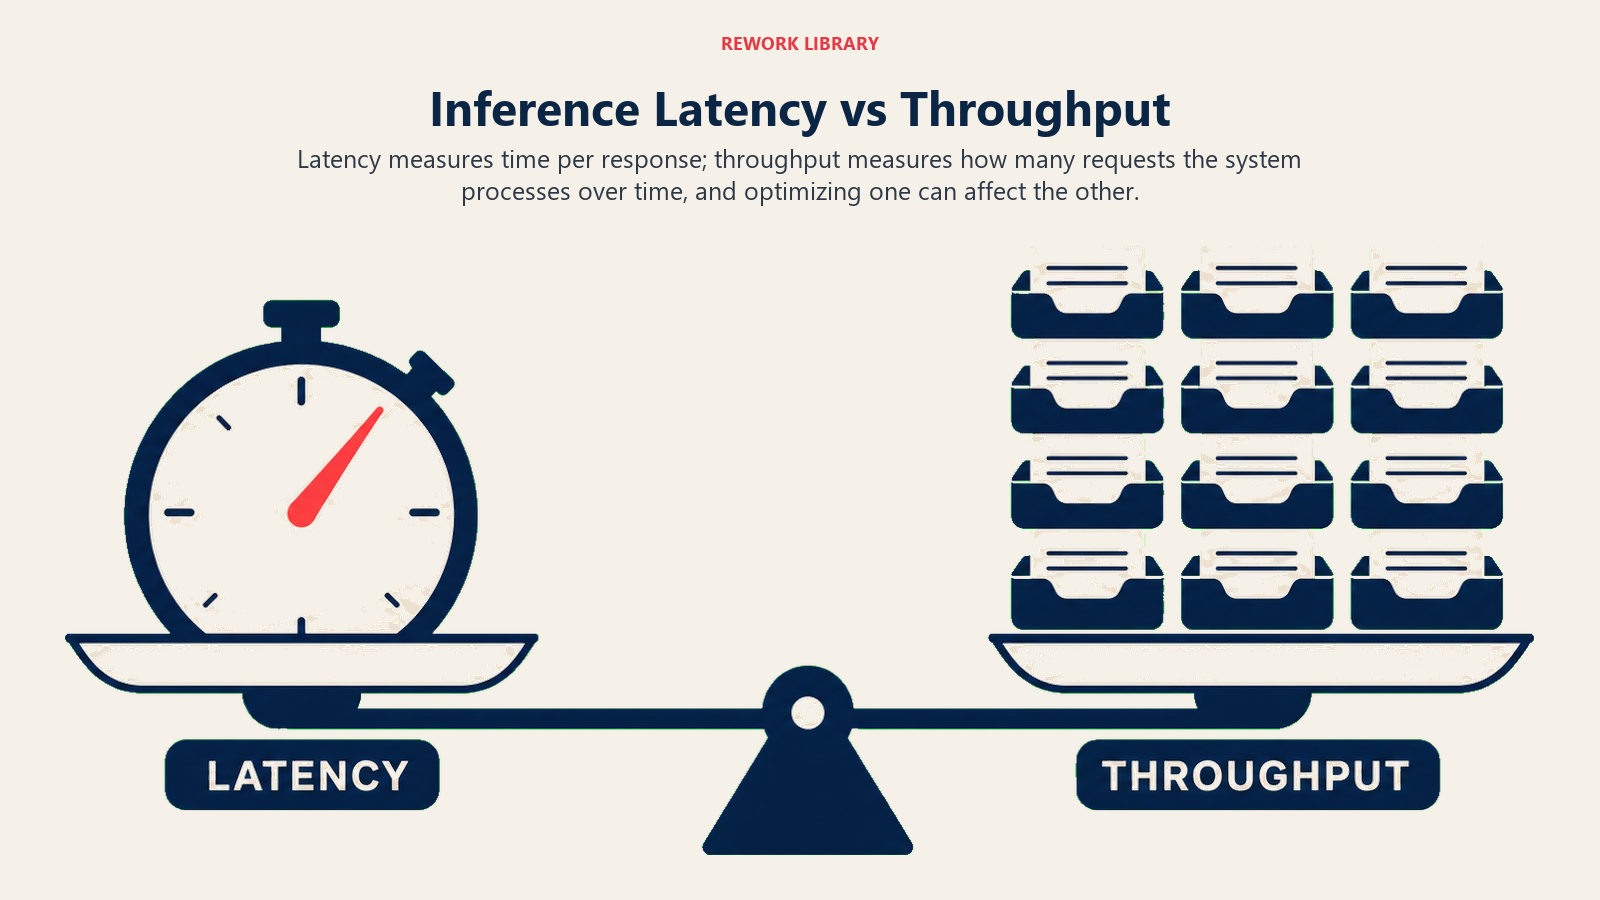
Throughput ist die Anzahl der Inference-Aufrufe, die ein System pro Zeiteinheit verarbeiten kann. Eine E-Commerce-Empfehlungsmaschine, die Millionen von Käufern bedient, benötigt hohen Throughput. Ein Rechtsanalyse-Tool, das von einem Team aus 20 Analysten genutzt wird, hat wesentlich geringere Throughput-Anforderungen.
Diese zwei Dimensionen stehen oft in einem Zielkonflikt zueinander. Das Bündeln mehrerer Inference-Anfragen erhöht beispielsweise den Throughput, da die Hardware viele Eingaben parallel verarbeitet, erhöht aber die Latenz für jede einzelne Anfrage, da diese auf das Füllen des Batches wartet. Die richtige Balance hängt vom Anwendungsfall ab.
Inference-Optimierung ist das technische Fachgebiet, das sich der Verbesserung beider Dimensionen widmet: Modelle schneller und kostengünstiger zu machen, ohne Qualitätseinbußen.
Wo Inference läuft: Cloud, Edge und On-Device
Inference sitzt an der Spitze des AI-Stacks. Foundation Models werden einmalig von AI-Laboren mithilfe massiver Rechencluster trainiert. Unternehmen rufen diese Modelle entweder über API auf (wobei die Inference auf der Infrastruktur des Anbieters läuft) oder setzen Modelle lokal auf ihrer eigenen Hardware oder Cloud-Instanzen ein. Wo diese Inference tatsächlich läuft, ist eine echte Architekturentscheidung, kein Detail, das man dem Infrastruktur-Team überlassen sollte.
Cloud-Inference. Das Modell läuft auf den Servern eines Anbieters und wird in der Regel über eine API angesprochen. Das ist der Standard für die meisten Unternehmen, die Foundation Models großer Labore nutzen. Der Einstieg ist einfach, die Skalierung erfolgt automatisch mit der Nachfrage, und die Kosten bleiben direkt an die Nutzung gekoppelt. Die Kompromisse sind laufende Preise pro Aufruf, die Abhängigkeit von Verfügbarkeit und Preisentscheidungen des Anbieters sowie die Netzwerklatenz zwischen Anfrage und Rechenzentrum.
Self-hosted Inference. Das Unternehmen betreibt das Modell auf der eigenen GPU-Infrastruktur, in einem privaten Cloud-Konto oder On-Premises. Das bietet mehr Kontrolle über den Datenschutz, kann bei sehr hohen, stabilen Volumina günstiger sein als API-Preise und ermöglicht tiefergehende Anpassung durch Fine-Tuning. Es bedeutet aber auch, die operative Last selbst zu tragen: GPUs bereitstellen, Verfügbarkeit sicherstellen und Lastspitzen ohne die Elastizität eines Anbieters bewältigen.
Edge- und On-Device-Inference. Das Modell läuft lokal, auf einem Smartphone, in einem Browser, an einem Verkaufs-Kiosk oder an einem Industriesensor, ganz ohne Netzwerk-Roundtrip. Das ist die Option mit der niedrigsten Latenz, und die Daten verlassen das Gerät nicht, was bei datenschutzsensiblen Anwendungsfällen wichtig ist. Der Kompromiss ist die Leistungsfähigkeit: Edge-Geräte haben begrenzten Speicher und begrenzte Rechenleistung, daher bedeutet Edge-Deployment meist ein kleineres, komprimiertes Modell statt eines Modells in Frontier-Größe.
Keine dieser Optionen ist universell richtig. Ein Kundensupport-Chatbot nutzt vielleicht Cloud-Inference wegen der Qualität. Eine Außendienst-Inspektions-App mit unzuverlässiger Konnektivität braucht womöglich Edge-Inference, um überhaupt zu funktionieren. Ein regulierter Healthcare-Workflow verlangt eventuell allein aus Gründen der Datenresidenz Self-hosted Inference.
MLOps-Praktiken regeln, wie Inference im Produktionsbetrieb verwaltet wird: wie Modelle versioniert und eingesetzt werden, wie die Performance überwacht wird, wie ein Rollback bei unerwartetem Modellverhalten erfolgt und wann ein Retraining nötig ist. Model Monitoring ist die fortlaufende Praxis, Inference-Ausgaben und Performance-Kennzahlen zu beobachten, um Degradation zu erkennen, bevor sie geschäftliche Auswirkungen hat.
Was sich 2026 geändert hat
Jahrelang wurde die AI-Diskussion vom Training dominiert: größere Modelle, größere Trainingsläufe, größere Schlagzeilen. Dort liegen Geld und Risiko längst nicht mehr. Inference ist zum operativen und finanziellen Schwerpunkt von AI im Produktionsbetrieb geworden, und zwar aus drei zusammenhängenden Gründen.
Die Nutzung wächst schneller, als die Kosten pro Aufruf sinken. Die Inference-Preise sind seit Ende 2022 dramatisch gefallen, die Adoption ist jedoch noch schneller gewachsen. Die Gesamtausgaben für Inference steigen daher weiter, auch wenn die Stückkosten schrumpfen.
Inference ist wiederkehrend, Training nicht. Ein Trainingslauf ist ein Projekt mit Anfang und Ende. Inference läuft über die gesamte Lebensdauer einer produktiven Funktion, bei einem erfolgreichen Produkt also über Jahre. Ein Betrag, der pro Aufruf klein wirkt, wird bei Millionen täglicher Anfragen, die unbegrenzt weiterlaufen, zu einer wesentlichen Größe.
Infrastrukturanbieter bauen bereits darauf um. Analysten gehen inzwischen davon aus, dass Inference-Workloads das Training in den nächsten Jahren als dominierende Last in AI-Rechenzentren überholen werden. Die Hyperscaler verändern deshalb, wie und wo sie Kapazität aufbauen: Trainingscluster entstehen an abgelegenen, stromintensiven Standorten, während Inference-Kapazität zunehmend näher an die Nutzer rückt, um die Netzwerklatenz zu senken.
Die praktische Konsequenz für jede Führungskraft, die AI-Vorhaben verantwortet: Das Modell, das den Trainings-Benchmark gewinnt, ist nicht automatisch das Modell, das ausgeliefert werden sollte. Das Modell, dessen Inference-Wirtschaftlichkeit bei Ihrem tatsächlichen Produktionsvolumen aufgeht, entscheidet darüber, ob eine AI-Funktion ein nachhaltiges Produkt oder ein teurer Pilot ist.
Wichtige Fakten
- Die Kosten für die Abfrage eines Modells auf GPT-3.5-Niveau sanken zwischen November 2022 und Oktober 2024 von 20,00 USD auf 0,07 USD pro Million Tokens, ein mehr als 280-facher Rückgang in rund 18 Monaten, laut dem Stanford AI Index 2025.
- Die Preise für LLM-Inference bei gleichbleibendem Leistungsniveau sind laut Epoch AIs Analyse von Inference-Preistrends mit einer mittleren Rate von rund 50-fach pro Jahr gefallen, bei Daten ab Januar 2024 beschleunigt auf etwa 200-fach pro Jahr.
- Inference soll laut McKinseys Analyse der Verschiebung von AI-Workloads bis 2030 die dominierende AI-Rechenlast werden und dann mehr als die Hälfte aller AI-Rechenleistung sowie 30 bis 40 Prozent der gesamten Rechenzentrumsnachfrage ausmachen.
- 49 Prozent der großen Unternehmen gaben 2025 an, dass der Großteil oder nahezu die gesamte Rechenleistung auf Inference entfällt, gegenüber 29 Prozent im Vorjahr, laut dem LLM-Marktupdate von Menlo Ventures zur Jahresmitte 2025.
- Anthropics Ausgaben 2025 umfassten laut Epoch AIs Analyse der Ausgaben von AI-Unternehmen, basierend auf Berichten von The Information, rund 2,7 Milliarden USD für Inference-Rechenleistung und 4,1 Milliarden USD für F&E (Training) bei Gesamtausgaben von 9,7 Milliarden USD.
- Der globale Markt für AI Inference soll laut MarketsandMarkets, zitiert von Forbes, von 106,15 Milliarden USD im Jahr 2025 auf 254,98 Milliarden USD bis 2030 wachsen und damit das Training als dominierende Ausgabenkategorie in der Enterprise-AI überholen.
Die Geschäftskosten der Inference
Für Organisationen, die AI in großem Maßstab einsetzen, sind Inference-Kosten eine materielle Budgetposition. Kostentreiber umfassen:
Die Modellgröße. Größere Modelle erfordern mehr Berechnung pro Inference-Aufruf. Ein 70-Milliarden-Parameter-Modell kostet beim Betrieb etwa 10-mal mehr als ein 7-Milliarden-Parameter-Modell, obwohl Qualitätsunterschiede die Kosten für manche Anwendungsfälle rechtfertigen können.
Das Anfragevolumen. Inference-Kosten skalieren mit der Nutzung. Ein System, das 10 Millionen tägliche Inference-Aufrufe verarbeitet, kostet proportional mehr zu betreiben als eines mit 10.000.
Die Hardware. GPU-Inference ist schneller, aber teurer als CPU-Inference. Spezialisierte Inference-Chips (wie Googles TPUs oder AWS Inferentia) können die Kosteneffizienz für spezifische Workloads verbessern.
Die Größe des Context Windows. Bei Sprachmodellen kosten längere Eingaben mehr zu verarbeiten, da die Inference-Kosten mit der Token-Anzahl skalieren. Systeme, die bei jedem Aufruf große Kontextmengen übergeben, stehen vor proportional höheren Kosten.
Da die Inference-Kosten direkt mit der Nutzung skalieren, ist sie der wirksamste Ansatzpunkt, um AI-Ausgaben zu senken, ohne den Produktumfang anzutasten. Die wichtigsten Optimierungstechniken sind:
Quantisierung. Die numerische Präzision der Modellgewichte wird reduziert, zum Beispiel von 32-Bit-Gleitkommazahlen auf 8-Bit- oder 4-Bit-Ganzzahlen. Das verkleinert den Speicherbedarf des Modells und beschleunigt die Berechnung, meist mit nur geringen Genauigkeitseinbußen. Die Funktionsweise erklärt Quantisierung.
Destillation. Ein kleineres "Student"-Modell wird darauf trainiert, die Ausgaben eines größeren "Teacher"-Modells nachzuahmen. Das Ergebnis läuft schneller und günstiger und behält den Großteil der Fähigkeiten des Teachers bei den Aufgaben, für die es destilliert wurde.
Batching. Mehrere Inference-Anfragen werden gebündelt, sodass die Hardware sie parallel statt nacheinander verarbeitet. Das steigert den Throughput erheblich, auf Kosten einer etwas höheren Latenz für einzelne Anfragen, da jede auf das Füllen des Batches wartet.
Caching. Die Ausgaben häufiger oder wiederholter Anfragen werden gespeichert, damit das Modell dieselbe Eingabe nicht zweimal verarbeiten muss. Bei Anwendungen mit viel wiederkehrendem Traffic kann Caching einen großen Teil der Inference-Aufrufe komplett einsparen.
Speculative Decoding. Ein kleines, schnelles "Draft"-Modell sagt mehrere Tokens im Voraus vorher, und das größere Modell verifiziert sie in einem einzigen Durchlauf, statt jeden Token einzeln selbst zu generieren. Sind die Vorhersagen des Draft-Modells gut, sinkt die Zahl der teuren Durchläufe durch das vollständige Modell, die für eine Antwort nötig sind.
Die meisten Produktionssysteme kombinieren mehrere dieser Techniken. Keine davon erfordert den Wechsel zu einem grundlegend anderen oder qualitativ schlechteren Modell; sie verändern, wie effizient ein bestehendes Modell betrieben wird. Organisationen, die sie systematisch anwenden, berichten häufig von Kostensenkungen von 50 bis 90 Prozent gegenüber einem nicht optimierten Deployment.
Echtzeit- vs. Batch-Inference
Nicht alle Inference findet in Echtzeit statt. Viele wertvolle AI-Anwendungen laufen nach einem Batch-Zeitplan statt auf Live-Anfragen zu reagieren.
Echtzeit-Inference behandelt Anfragen, sobald sie eintreffen, mit Millisekunden bis Sekunden Latenz. Chatbots, Betrugserkennung, Echtzeit-Personalisierung und Sprachassistenten erfordern diesen Modus.
Batch-Inference verarbeitet große Datensätze nach einem Zeitplan, oft über Nacht oder auf Anfrage. CRM-Anreicherung, die jeden Abend alle Leads bewertet, Dokumentenverarbeitung, die durch eine Warteschlange hochgeladener Dateien arbeitet, oder Analyse-Workloads, die wöchentliche Berichte generieren, passen alle zum Batch-Muster. Batch-Inference ist im Allgemeinen günstiger pro Inference-Aufruf, da sie effiziente Batching-Strategien nutzen kann, ohne die Einschränkung nutzerseitiger Latenzanforderungen.
Die Wahl zwischen den Modi ist eine Produkt- und Architekturentscheidung, nicht nur eine technische. Viele Anwendungsfälle, die zunächst Echtzeit-Inference zu erfordern scheinen, können als Nahezu-Echtzeit oder Batch umgestaltet werden, ohne dass ein wesentlicher Verlust an Geschäftswert entsteht, und das bei deutlich niedrigeren Kosten.
Was Führungskräfte verstehen müssen
Die AI-Begriffe, die die meiste Aufmerksamkeit erhalten, Trainingsdaten, Modellarchitektur, Benchmark-Ergebnisse, beziehen sich alle auf das Potenzial eines Modells. Inference ist der Ort, an dem sich dieses Potenzial entweder in Geschäftsergebnisse übersetzt oder nicht. Drei praktische Konsequenzen ergeben sich direkt aus der Funktionsweise von Inference, und alle drei gehören auf die Checkliste einer Führungskraft, bevor ein AI-Deployment genehmigt wird, nicht danach.
Die Kosten skalieren mit dem Erfolg, und das gilt in beide Richtungen. Die Trainingskosten sind nach Projektabschluss weitgehend fix. Die Inference-Kosten steigen direkt mit der Adoption: Je nützlicher eine Funktion ist, desto häufiger wird sie genutzt, und desto mehr kostet ihr Betrieb. Eine Funktion, die im Pilot mit 50 Nutzern erschwinglich wirkt, kann bei 50.000 Nutzern zu einem echten Budgetposten werden.
Die Latenz entscheidet, ob Menschen die Funktion tatsächlich nutzen. Nutzer passen ihr Verhalten daran an, wie schnell eine AI-Funktion antwortet. Interaktive Tools, die mehr als ein paar Sekunden brauchen, verlieren regelmäßig Nutzer, und wer gelernt hat, eine langsame Funktion zu umgehen, kommt oft auch nach der Behebung nicht zurück.
Wo die Inference läuft, bestimmt, wer Ihre Daten sehen kann. Bei Cloud-Inference über eine Drittanbieter-API verlassen Anfragen und der darin enthaltene Kontext Ihre Umgebung. Für regulierte oder sensible Workloads ist das manchmal ausgeschlossen, weshalb Self-hosted oder Edge-Inference als Alternative existiert, auch bei höherem operativem Aufwand.
Wenn Sie AI-Anbieter oder Build-Optionen evaluieren, fragen Sie nach den Inference-Kosten pro Aufruf bei Ihrem erwarteten Volumen, der Latenz unter realer Produktionslast, wie die Inference-Kosten mit der Nutzung skalieren und wohin Ihre Daten tatsächlich gelangen, wenn das Modell läuft. Das sind die Zahlen, die bestimmen, ob AI-Anwendungsfälle wirtschaftlich nachhaltig sind.
Verwandte AI-Konzepte
- Inference-Optimierung - Techniken, um Inference schneller und günstiger zu machen
- MLOps - Verwaltung von Modell-Deployment und Inference-Pipelines
- Edge AI - Inference auf lokaler Hardware statt in der Cloud ausführen
- Model Monitoring - Inference-Performance über die Zeit verfolgen
- Latency - Warum die Antwortzeit darüber entscheidet, ob AI-Funktionen im Produktionsbetrieb angenommen werden
- Context Window - Wichtiger Kostentreiber der Inference bei Sprachmodellen
- Transformer-Architektur - Wie die meisten modernen Modelle Inference berechnen
- Quantisierung - Modellgröße reduzieren, um Inference-Kosten zu senken
- Large Language Models - Die Modellkategorie, um die sich die meisten Inference-Diskussionen drehen
- Foundation Models - Die Basismodelle, gegen die Unternehmen Inference per API oder Self-Hosting ausführen
Externe Ressourcen
- NVIDIA Inference Platform - Branchenstandard-Infrastruktur für groß angelegte Modell-Inference
- Hugging Face Inference Endpoints - Leitfaden zu Produktionsmodell-Serving und Inference-Kompromissen
- Google AI Inference Best Practices - Praktischer Leitfaden zu Inference-Architektur und -Optimierung
Häufig gestellte Fragen zur AI Inference
Was ist AI Inference?
AI Inference ist der Prozess, ein trainiertes Machine-Learning-Modell auf neuen Eingaben auszuführen, um Vorhersagen oder Ausgaben zu generieren. Es ist die Produktionsphase von AI, in der ein Modell, das auf historischen Daten trainiert wurde, auf Live-Daten angewendet wird, um Wert zu schaffen: Kundenanfragen zu beantworten, Leads zu bewerten, Betrug zu erkennen oder Dokumente zu generieren.
Was ist der Unterschied zwischen Training und Inference?
Training ist der Prozess, ein Modell zu lehren, indem es großen Datensätzen ausgesetzt wird und seine Parameter angepasst werden. Inference bedeutet, das trainierte Modell auf neuen Eingaben auszuführen, ohne diese Parameter zu ändern. Training findet selten statt und erfordert massive Rechenkapazität. Inference findet kontinuierlich in Produktionsvolumen statt, was der Ursprung der meisten laufenden AI-Infrastrukturkosten ist.
Warum ist Inference für viele Unternehmen aufwendiger zu steuern als das Training?
Training ist eine einmalige oder gelegentliche Projektausgabe. Inference ist eine wiederkehrende Ausgabe, die direkt damit skaliert, wie viele Menschen eine Funktion wie oft nutzen. Mit wachsender Adoption steigen die Inference-Ausgaben mit, auch wenn die Kosten pro einzelnem Aufruf weiter sinken. Mehrere Branchenberichte aus 2025 kamen zu dem Ergebnis, dass Inference inzwischen den Großteil der laufenden AI-Rechenausgaben sowohl bei großen Unternehmen als auch bei AI-nativen Startups ausmacht.
Warum ist Inference-Latenz für Unternehmen wichtig?
Latenz bestimmt, wie reaktionsfähig eine AI-gestützte Erfahrung für Nutzer wirkt. Kundenorientierte Anwendungen wie Chatbots, Echtzeit-Empfehlungen und Sprachassistenten benötigen niedrige Latenz, um Nutzer nicht zu frustrieren. Interne Tools, die von Mitarbeitern genutzt werden, haben typischerweise eine höhere Toleranz gegenüber Latenz. Die Latenzanforderung richtig zu definieren ist ein wichtiger Teil von Inference-Architekturentscheidungen.
Sollte Inference in der Cloud oder auf dem Gerät laufen?
Das hängt von Latenzanforderungen, Datensensibilität und Volumen ab. Cloud-Inference ist am einfachsten bereitzustellen und skaliert automatisch, was für die meisten Geschäftsanwendungen passt. On-Device- oder Edge-Inference entfernt die Netzwerklatenz komplett und hält Daten lokal, was bei datenschutzsensiblen oder konnektivitätsbegrenzten Anwendungsfällen wichtig ist, erfordert aber meist ein kleineres, weniger leistungsfähiges Modell.
Ist AI Inference immer in Echtzeit?
Nein. Echtzeit-Inference reagiert auf Anfragen, sobald sie eintreffen, was Chatbots, Betrugserkennung und Live-Personalisierung brauchen. Batch-Inference verarbeitet große Datenmengen nach einem Zeitplan, oft über Nacht, und ist pro Aufruf typischerweise günstiger, weil sie keine Live-Latenzanforderung erfüllen muss. Viele Workloads, die Echtzeit-Inference zu brauchen scheinen, können als Batch oder in Nahezu-Echtzeit laufen, ohne echten Verlust an Geschäftswert.
Wie können Organisationen Inference-Kosten reduzieren?
Die wichtigsten Hebel sind: kleinere Modelle einsetzen, wo die Qualität es zulässt, Quantisierung anwenden, um die Modellgröße zu reduzieren, ein kleineres Modell aus einem größeren destillieren, Anfragen bündeln, wo Latenzeinschränkungen es erlauben, häufige Antworten cachen und Speculative Decoding für Sprachmodelle nutzen. Inference-Optimierung ist eine eigenständige technische Disziplin; viele Organisationen erzielen durch systematische Optimierung ohne Modellwechsel Kosteneinsparungen von 50-90%.

Co-Founder, Rework.com
On this page
- Training vs. Inference: Der grundlegende Unterschied
- Wie Inference funktioniert
- Die zwei wichtigsten Leistungsdimensionen
- Wo Inference läuft: Cloud, Edge und On-Device
- Was sich 2026 geändert hat
- Wichtige Fakten
- Die Geschäftskosten der Inference
- Echtzeit- vs. Batch-Inference
- Was Führungskräfte verstehen müssen
- Verwandte AI-Konzepte
- Externe Ressourcen