Apakah Inferens AI? Menjalankan Model AI dalam Pengeluaran
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Seorang peruncit melatih model ramalan permintaan selama enam bulan. Saintis data mengesahkannya. Pihak pengurusan meluluskannya. Model itu bersedia. Kemudian ia memasuki pengeluaran dan perlu menjawab ribuan pertanyaan setiap hari, setiap satu dalam masa kurang daripada 200 milisaat, selama berbulan-bulan atau bertahun-tahun. Itulah inferens: proses langsung dan berterusan menjalankan model terlatih pada data sebenar untuk menjana output sebenar.
Latihan mendapat sebahagian besar perhatian dalam liputan AI. Inferens adalah tempat nilai perniagaan sebenarnya wujud, dan menjelang 2026 ia juga tempat kebanyakan belanjawan AI berada. Harga inferens bagi setiap token telah jatuh beberapa tahap magnitud sejak 2022, dan penggunaan berkembang lebih pantas lagi, jadi jumlah perbelanjaan inferens terus meningkat walaupun kos seunit terus mengecil.
Latihan vs. Inferens: Perbezaan Asas
Memahami inferens memerlukan pemahaman tentang apa yang ia bukan. Latihan adalah proses mengajar model dengan mendedahkannya kepada data dalam jumlah besar dan melaraskan parameternya sehingga ia menghasilkan output yang tepat. Latihan memerlukan pengiraan yang intensif, mahal dan dijalankan agak jarang.
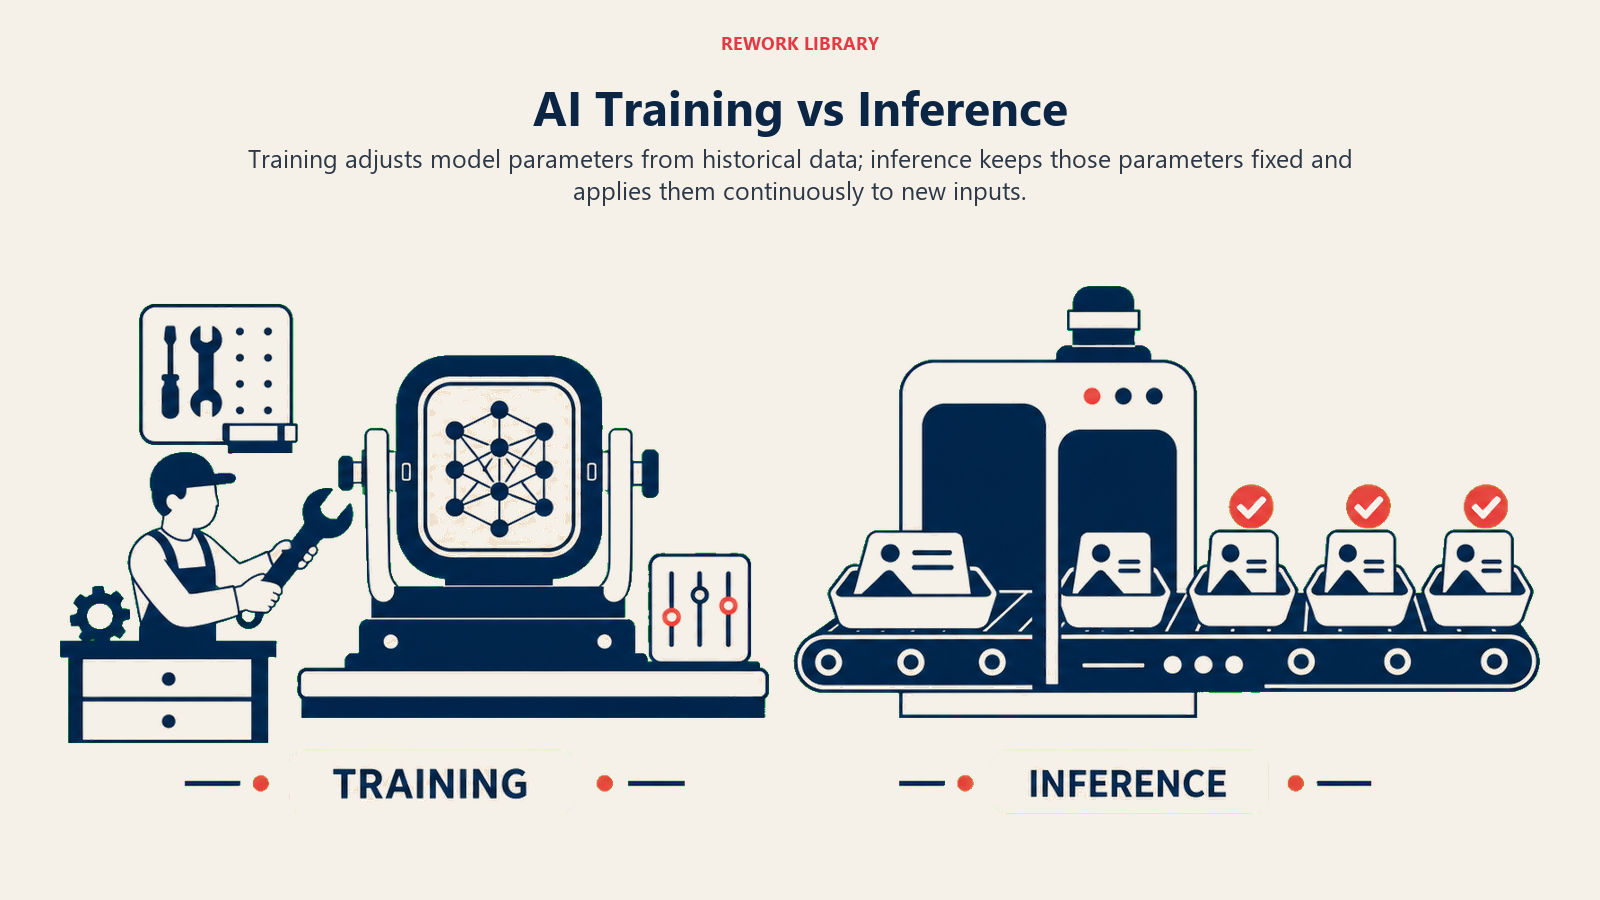
Inferens adalah sebaliknya dalam ketiga-tiga aspek tersebut. Ia adalah proses mengambil model yang parameternya sudah ditetapkan dan menjalankannya pada input baharu untuk menjana ramalan. Inferens berlaku apabila:
- Pelanggan menaip soalan ke dalam chatbot dan mendapat respons
- Sistem pengesanan penipuan menilai transaksi dalam masa nyata
- Pipeline pemprosesan dokumen mengekstrak data daripada invois yang dimuat naik
- Enjin cadangan memutuskan apa yang perlu ditunjukkan kepada pengguna seterusnya
Latihan berlaku sekali (atau berkala). Inferens berlaku secara berterusan, pada volum yang dituntut oleh sistem pengeluaran. Bagi kebanyakan perniagaan, inferens adalah tempat hampir semua kos pengkomputeran AI dalam pengeluaran berasal.
| Dimensi | Latihan | Inferens |
|---|---|---|
| Tujuan | Mengajar model dengan melaraskan parameter pada data sejarah | Menerapkan parameter tetap model kepada input baharu yang belum pernah dilihat |
| Kekerapan | Berlaku sekali, kemudian berkala untuk latihan semula atau fine-tuning | Berlaku secara berterusan, setiap kali pengguna atau sistem membuat pertanyaan kepada model |
| Corak pengiraan | Pengiraan berterusan, berskala besar dan selari selama beberapa hari atau minggu | Letusan pendek bagi setiap permintaan, diulang beribu-ribu hingga berbilion kali |
| Bentuk kos | Perbelanjaan besar, dibayar di awal, bergaya projek | Perbelanjaan berterusan berasaskan penggunaan yang berskala dengan penerimaan |
Model yang murah untuk dilatih tetapi mahal untuk dijalankan pada skala besar masih boleh menjadi keputusan perniagaan yang buruk. Model yang mahal untuk dilatih tetapi murah untuk dijalankan pada volum tinggi boleh menampung kosnya berkali-kali ganda. Ekonomi inferens, bukan penanda aras latihan, lazimnya menentukan model mana yang benar-benar dilancarkan.
Cara Inferens Berfungsi
Semasa inferens, model terlatih menerima input, sama ada teks, imej, data berstruktur atau audio, dan menjalankannya melalui parameter yang telah dipelajari untuk menghasilkan output. Bagi sebuah large language model, ini bermakna input ditukar kepada token, model memproses token tersebut melalui seni bina transformer menggunakan mekanisme perhatian yang telah dipelajari, dan token output dijana secara berurutan sehingga respons selesai. Itulah sebabnya respons yang lebih panjang mengambil masa lebih lama untuk dihasilkan: setiap token output memerlukan satu laluan penuh lagi melalui model.
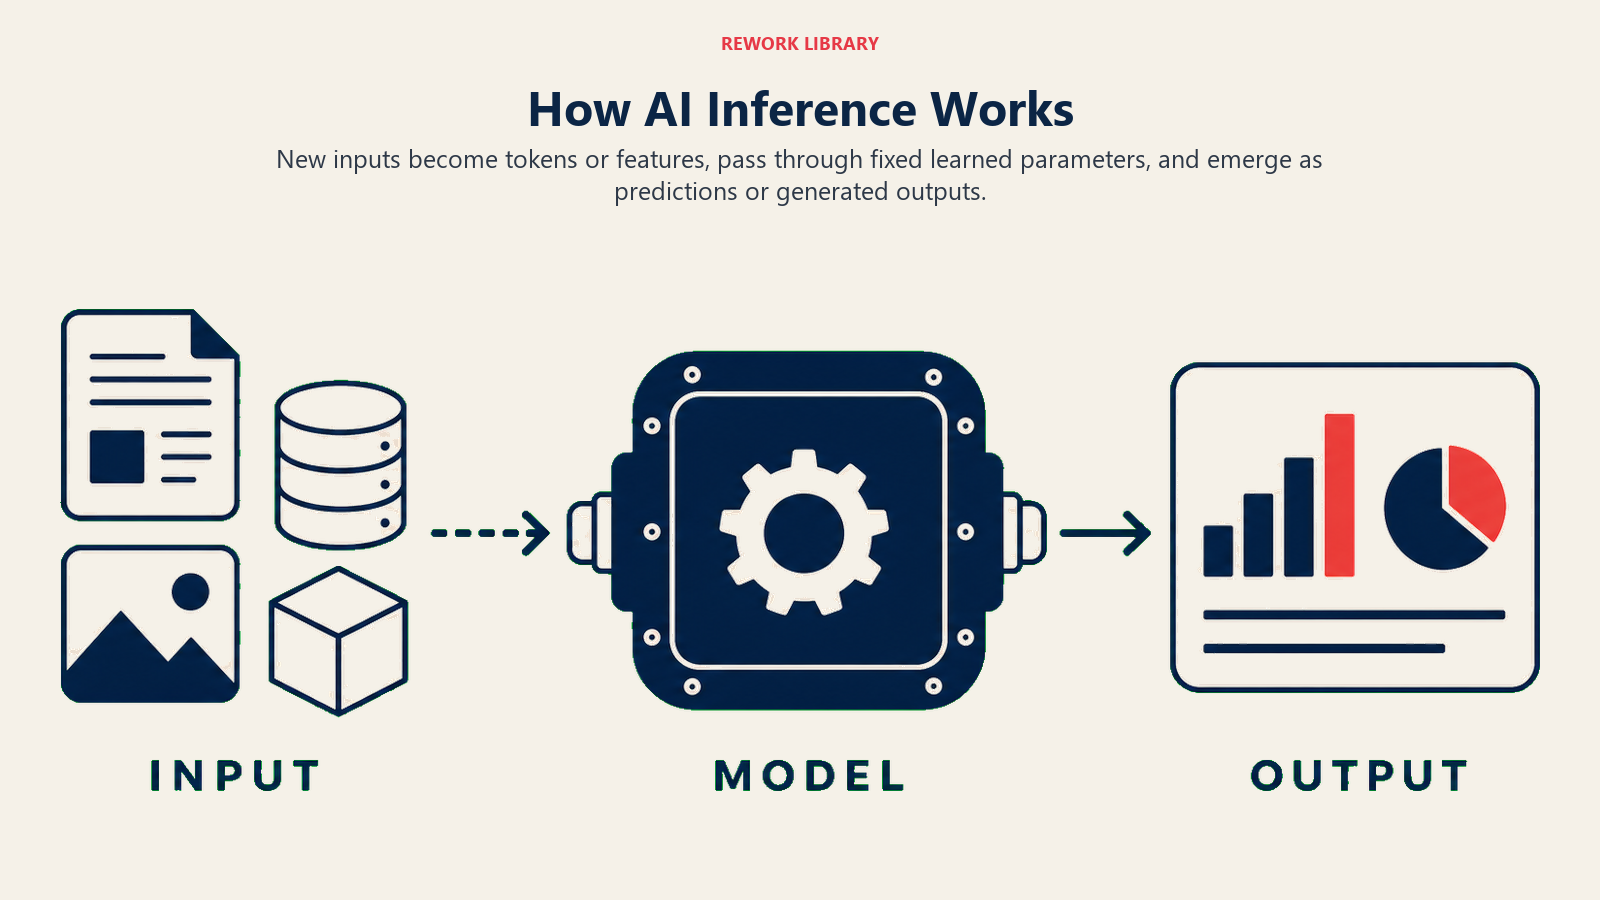
Parameter model tidak berubah semasa inferens. Model tidak belajar daripada pertanyaan; ia menerapkan apa yang telah dipelajari kepada input baharu. Perbezaan ini penting secara praktikal: ia bermakna model yang sama boleh melayani ribuan pengguna serentak tanpa seorang pun mempengaruhi yang lain.
Kos inferens datang daripada pengiraan yang diperlukan untuk memproses input melalui model yang mungkin mempunyai berbilion atau ratusan berbilion parameter. Lebih banyak parameter biasanya bermakna lebih banyak keupayaan dan lebih banyak pengiraan per panggilan inferens.
Dua Dimensi Prestasi Utama
Latensi ialah tempoh masa yang diambil oleh satu panggilan inferens dari input ke output, termasuk masa untuk token pertama dan masa untuk menjana setiap token selepas itu. Pengguna yang menunggu respons chatbot mengalami latensi. AI pengimejan perubatan memerlukan latensi rendah apabila ahli radiologi menunggu bacaan. Pemprosesan dokumen yang berlaku pada waktu malam dalam kelompok boleh bertolak ansur dengan latensi yang lebih tinggi.
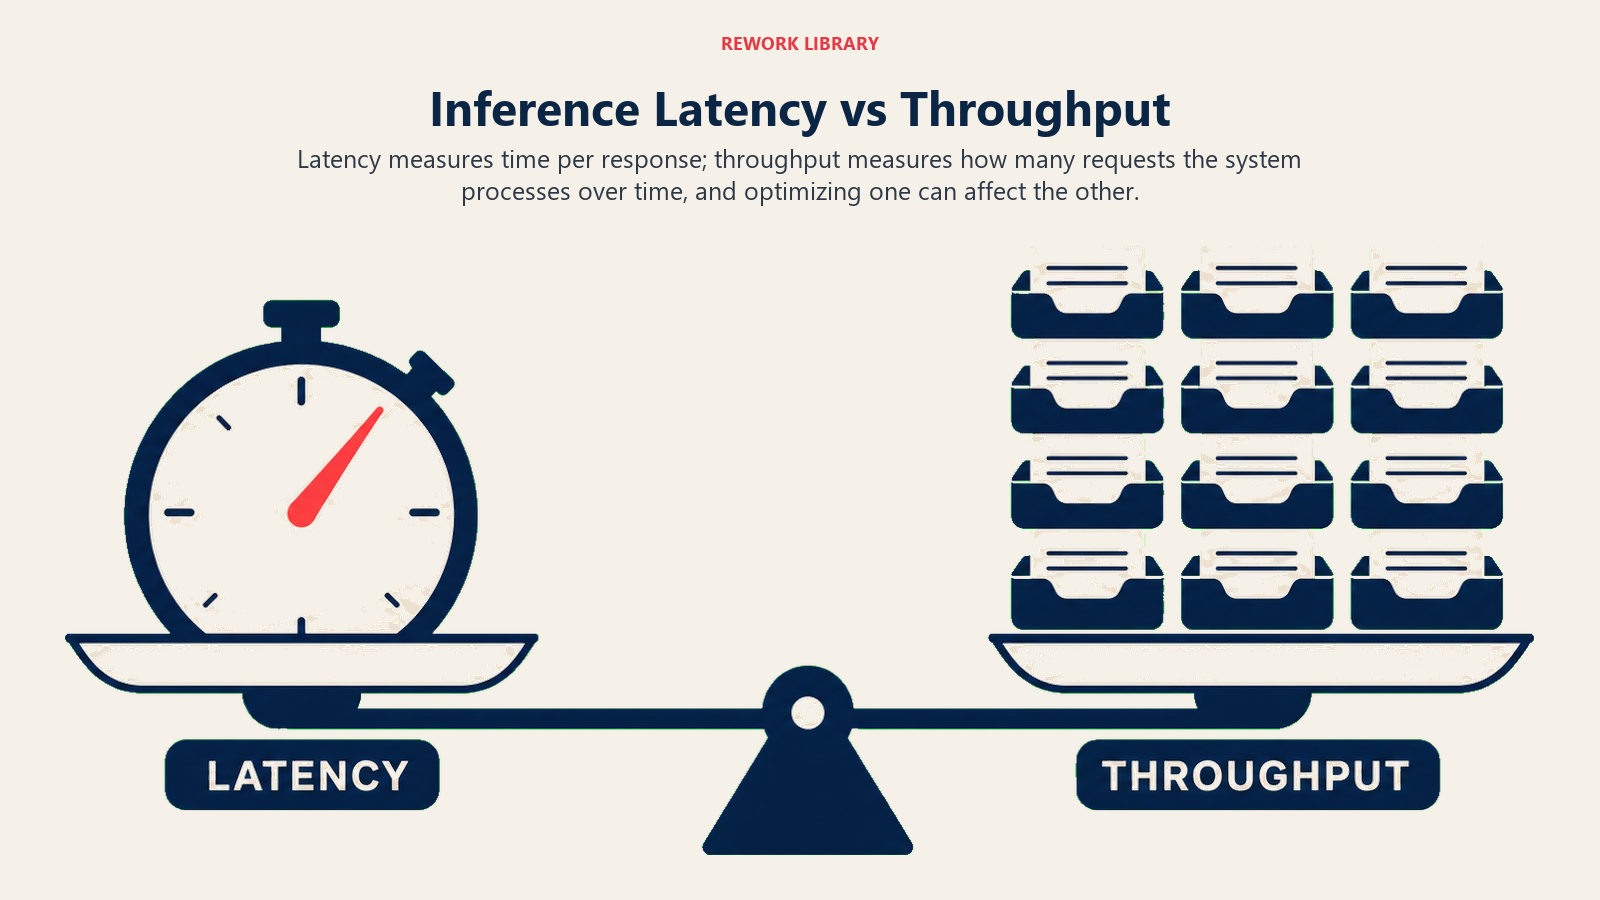
Throughput ialah berapa banyak panggilan inferens yang boleh dikendalikan oleh sistem per unit masa. Enjin cadangan e-dagang yang melayani jutaan pembeli memerlukan throughput yang tinggi. Alat analisis dokumen undang-undang yang digunakan oleh pasukan 20 penganalisis mempunyai keperluan throughput yang jauh lebih rendah.
Kedua-dua dimensi ini sering mengalami pertukaran antara satu sama lain. Mengelompokkan beberapa permintaan inferens bersama, sebagai contoh, meningkatkan throughput kerana perkakasan memproses banyak input secara selari, tetapi meningkatkan latensi untuk setiap permintaan individu kerana ia menunggu kelompok diisi. Imbangan yang tepat bergantung pada kes penggunaan.
Pengoptimuman inferens adalah bidang teknikal yang didedikasikan untuk meningkatkan kedua-dua dimensi, menjadikan model lebih pantas dan lebih murah tanpa mengorbankan kualiti.
Di Mana Inferens Dijalankan: Awan, Tepi dan Pada Peranti
Inferens berada di bahagian atas stack AI. Model asas dilatih sekali oleh makmal AI menggunakan kelompok pengiraan yang besar. Perniagaan sama ada memanggil model ini melalui API atau menggunakan model pada infrastruktur sendiri, dan tempat inferens itu sebenarnya dijalankan merupakan keputusan seni bina yang nyata, bukan butiran yang boleh diserahkan kepada pasukan infrastruktur.
Inferens awan. Model dijalankan pada pelayan pembekal, biasanya diakses melalui API. Ini adalah pilihan lalai bagi kebanyakan perniagaan yang menggunakan model asas daripada makmal utama. Ia mudah untuk dimulakan, berskala secara automatik mengikut permintaan dan mengekalkan kos terikat terus kepada penggunaan. Pertukarannya ialah harga per panggilan yang berterusan, pergantungan pada masa operasi dan keputusan harga pembekal, serta latensi rangkaian antara permintaan dan pusat data.
Inferens dihoskan sendiri. Perniagaan menjalankan model pada infrastruktur GPU sendiri, dalam akaun awan peribadi atau di premis. Ini memberikan lebih kawalan ke atas privasi data, boleh lebih murah daripada harga API pada volum yang sangat tinggi dan stabil, dan membolehkan penyesuaian yang lebih mendalam melalui fine-tuning. Ia juga bermakna memikul beban operasi: menyediakan GPU, mengurus masa operasi dan mengendalikan lonjakan skala tanpa keanjalan pembekal.
Inferens tepi dan pada peranti. Model dijalankan secara tempatan, pada telefon, pelayar, kiosk runcit atau penderia industri, tanpa perjalanan pergi balik rangkaian langsung. Ini ialah pilihan latensi paling rendah dan memastikan data tidak meninggalkan peranti, yang penting bagi kes penggunaan sensitif privasi. Pertukarannya ialah keupayaan: peranti tepi mempunyai memori dan pengiraan terhad, jadi penggunaan di tepi biasanya bermakna model yang lebih kecil dan dimampatkan, bukan model berskala frontier.
Tiada satu pun daripada ini betul secara universal. Chatbot sokongan pelanggan mungkin menggunakan inferens awan demi kualiti. Aplikasi pemeriksaan lapangan dengan ketersambungan yang tidak stabil mungkin memerlukan inferens tepi supaya ia dapat berfungsi sama sekali. Aliran kerja penjagaan kesihatan yang dikawal selia mungkin memerlukan inferens dihoskan sendiri semata-mata atas sebab kediaman data.
Amalan MLOps mengawal cara inferens diurus dalam pengeluaran: cara model diberi versi dan digunakan, cara prestasi dipantau, cara untuk memulihkan semula apabila model berkelakuan tidak dijangka dan bila perlu melatih semula. Pemantauan model adalah amalan berterusan memerhati output inferens dan metrik prestasi untuk mengesan kemerosotan sebelum ia menyebabkan kesan perniagaan.
Apa yang Berubah pada 2026
Bertahun-tahun, perbualan tentang AI didominasi oleh latihan: model yang lebih besar, larian latihan yang lebih besar, tajuk berita yang lebih besar. Di situ bukan lagi tempat wang atau risiko berada. Inferens telah menjadi pusat graviti operasi dan kewangan bagi AI dalam pengeluaran, atas tiga sebab yang berkaitan.
Penggunaan terus berkembang lebih pantas daripada penurunan kos per panggilan. Harga inferens telah jatuh dengan ketara sejak akhir 2022, tetapi penerimaan berkembang lebih pantas lagi, jadi jumlah perbelanjaan inferens terus meningkat walaupun kos seunit mengecil.
Inferens berulang, latihan tidak. Larian latihan ialah projek yang ada permulaan dan pengakhiran. Inferens berjalan sepanjang hayat ciri yang digunakan, yang bagi produk yang berjaya boleh bertahun-tahun. Kos yang kelihatan kecil bagi setiap panggilan menjadi material apabila didarabkan dengan berjuta-juta permintaan harian yang berjalan tanpa had masa.
Penyedia infrastruktur sudah membina semula sekitar perkara ini. Penganalisis kini menjangkakan beban kerja inferens akan mengatasi latihan sebagai permintaan dominan ke atas pusat data AI dalam beberapa tahun akan datang, dan hyperscaler mengubah cara dan tempat mereka membina kapasiti sebagai akibat langsung: kelompok latihan dialihkan ke tapak terpencil yang padat kuasa, manakala kapasiti inferens semakin bergerak lebih dekat dengan lokasi pengguna sebenar untuk mengurangkan latensi rangkaian.
Akibat praktikalnya bagi mana-mana pemimpin yang menaja kerja AI: model yang menang dalam penanda aras latihan tidak semestinya model yang patut dilancarkan. Model yang ekonomi inferensnya berfungsi pada volum pengeluaran sebenar anda ialah model yang menentukan sama ada ciri AI menjadi produk yang mampan atau pilot yang mahal.
Fakta Utama
- Kos untuk membuat pertanyaan kepada model berprestasi tahap GPT-3.5 jatuh daripada $20.00 kepada $0.07 bagi setiap juta token antara November 2022 dan Oktober 2024, penurunan lebih 280 kali ganda dalam kira-kira 18 bulan, menurut laporan Stanford AI Index 2025.
- Harga inferens LLM pada tahap prestasi tetap telah jatuh pada kadar median kira-kira 50 kali ganda setahun, memecut kepada kira-kira 200 kali ganda setahun bagi data dari Januari 2024 dan seterusnya, menurut analisis Epoch AI tentang trend harga inferens.
- Inferens diunjurkan akan mengatasi latihan sebagai beban kerja pengiraan AI dominan menjelang 2030, merangkumi lebih separuh daripada semua pengiraan AI dan 30 hingga 40 peratus daripada jumlah permintaan pusat data, menurut analisis McKinsey tentang peralihan beban kerja AI.
- 49 peratus perusahaan besar melaporkan bahawa kebanyakan atau hampir semua pengiraan mereka didorong oleh inferens pada 2025, meningkat daripada 29 peratus setahun sebelumnya, menurut kemas kini pasaran LLM pertengahan tahun 2025 oleh Menlo Ventures.
- Perbelanjaan Anthropic pada 2025 termasuk kira-kira $2.7 bilion untuk pengiraan inferens dan $4.1 bilion untuk pengiraan R&D (latihan) daripada jumlah perbelanjaan $9.7 bilion, menurut analisis Epoch AI tentang perbelanjaan syarikat AI, berdasarkan laporan The Information.
- Pasaran inferens AI global diunjurkan berkembang daripada $106.15 bilion pada 2025 kepada $254.98 bilion menjelang 2030, mengatasi latihan sebagai kategori perbelanjaan dominan dalam AI perusahaan, menurut penyelidikan MarketsandMarkets yang dipetik oleh Forbes.
Kos Perniagaan Inferens
Bagi organisasi yang menggunakan AI pada skala besar, kos inferens adalah baris belanjawan yang material. Pemacu kos termasuk:
Saiz model. Model yang lebih besar memerlukan lebih banyak pengiraan per panggilan inferens. Model dengan 70 bilion parameter mengambil kos lebih kurang 10 kali lebih banyak untuk menjalankan inferens berbanding model dengan 7 bilion parameter, walaupun perbezaan kualiti mungkin membenarkan kos tersebut untuk beberapa kes penggunaan.
Volum permintaan. Kos inferens berskala dengan penggunaan. Sistem yang mengendalikan 10 juta panggilan inferens harian mengambil kos lebih banyak berbanding sistem yang mengendalikan 10,000.
Perkakasan. Inferens GPU lebih pantas tetapi lebih mahal berbanding inferens CPU. Cip inferens khusus (seperti TPU Google atau AWS Inferentia) boleh meningkatkan kecekapan kos untuk beban kerja tertentu.
Saiz tetingkap konteks. Bagi model bahasa, input yang lebih panjang mengambil kos lebih banyak untuk diproses kerana kos inferens berskala dengan bilangan token. Sistem yang menghantar konteks yang besar pada setiap panggilan menghadapi kos yang lebih tinggi secara berkadar.
Memandangkan kos inferens berskala terus dengan penggunaan, ia adalah tempat berpengaruh tertinggi untuk mengurangkan perbelanjaan AI tanpa menyentuh skop produk. Teknik pengoptimuman teras ialah:
Kuantisasi. Mengurangkan ketepatan berangka pemberat model, contohnya daripada titik terapung 32-bit kepada integer 8-bit atau 4-bit, mengecilkan jejak memori model dan mempercepat pengiraan, biasanya dengan pertukaran ketepatan yang kecil sahaja. Lihat Kuantisasi untuk mekanismenya.
Penyulingan. Melatih model "pelajar" yang lebih kecil untuk meniru output model "guru" yang lebih besar. Hasilnya berjalan lebih pantas dan lebih murah sambil mengekalkan kebanyakan keupayaan guru pada tugas yang dijadikan sasaran penyulingan.
Pengelompokan. Mengumpulkan beberapa permintaan inferens bersama supaya perkakasan memprosesnya secara selari dan bukannya satu demi satu. Ini meningkatkan throughput dengan ketara, dengan kos tambahan latensi bagi setiap permintaan, kerana setiap satu menunggu kelompok diisi.
Caching. Menyimpan output pertanyaan yang lazim atau berulang supaya model tidak perlu memproses input yang sama dua kali. Bagi aplikasi dengan banyak trafik berulang, caching boleh menghapuskan sebahagian besar panggilan inferens secara terus.
Penyahkodan spekulatif. Model "draf" yang kecil dan pantas meramalkan beberapa token ke hadapan, dan model yang lebih besar mengesahkannya dalam satu laluan dan bukannya menjana setiap token satu demi satu sendirian. Apabila tekaan model draf adalah baik, ini mengurangkan bilangan laluan model penuh yang mahal untuk menghasilkan respons.
Kebanyakan sistem pengeluaran menggabungkan beberapa teknik ini serentak. Tiada satu pun memerlukan pertukaran kepada model yang berbeza secara asas atau berkualiti lebih rendah; ia mengubah kecekapan penyediaan model sedia ada. Organisasi yang menerapkannya secara sistematik lazimnya melaporkan pengurangan kos sebanyak 50 hingga 90 peratus berbanding penggunaan yang tidak dioptimumkan.
Inferens Masa Nyata vs. Inferens Kelompok
Tidak semua inferens berlaku dalam masa nyata. Banyak aplikasi AI yang berharga beroperasi mengikut jadual kelompok dan bukannya menjawab permintaan langsung.
Inferens masa nyata mengendalikan permintaan semasa ia tiba, dengan latensi milisaat hingga saat. Chatbot, pengesanan penipuan, pemperibadian masa nyata dan pembantu suara semuanya memerlukan mod ini.
Inferens kelompok memproses set data yang besar mengikut jadual, sering pada waktu malam atau atas permintaan. Pengayaan CRM yang berjalan setiap malam untuk menilai semua petunjuk jualan, pemprosesan dokumen yang melalui baris fail yang dimuat naik, atau beban kerja analitik yang menjana laporan mingguan, semuanya sesuai dengan corak kelompok. Inferens kelompok umumnya lebih murah per panggilan inferens kerana ia boleh memanfaatkan strategi pengelompokan yang cekap tanpa kekangan keperluan latensi yang berhadapan dengan pengguna.
Pilihan antara mod adalah keputusan produk dan seni bina, bukan semata-mata teknikal. Banyak kes penggunaan yang pada mulanya kelihatan memerlukan inferens masa nyata boleh direka bentuk semula sebagai hampir-masa-nyata atau kelompok tanpa kehilangan nilai perniagaan yang bermakna, pada kos yang jauh lebih rendah.
Apa yang Perlu Difahami oleh Pemimpin Perniagaan
Istilah AI yang mendapat paling banyak perhatian, data latihan, seni bina model, skor penanda aras, semuanya berkaitan dengan potensi model. Inferens adalah tempat potensi tersebut sama ada diterjemahkan kepada keputusan perniagaan atau tidak. Tiga akibat praktikal timbul secara langsung daripada cara inferens berfungsi, dan ketiga-tiganya patut berada dalam senarai semak pemimpin sebelum meluluskan penggunaan AI, bukan selepasnya.
Kos berskala dengan kejayaan, yang memberi kesan dua hala. Kos latihan lebih kurang tetap sebaik sahaja projek selesai. Kos inferens meningkat terus dengan penerimaan: semakin berguna sesuatu ciri, semakin banyak ia digunakan, dan semakin tinggi kos untuk menjalankannya. Ciri yang kelihatan mampu milik dalam pilot dengan 50 pengguna boleh menjadi baris belanjawan sebenar pada 50,000 pengguna.
Latensi menentukan sama ada orang benar-benar menggunakan ciri tersebut. Pengguna menyesuaikan tingkah laku mereka dengan kepantasan respons ciri AI. Alat interaktif yang mengambil masa lebih daripada beberapa saat lazimnya menyaksikan penerimaan merosot, dan sebaik sahaja pengguna belajar mengelak ciri yang perlahan, mereka sering tidak kembali walaupun ia telah dibaiki.
Tempat inferens dijalankan mempengaruhi siapa yang boleh melihat data anda. Inferens awan melalui API pihak ketiga bermakna permintaan, dan apa sahaja konteks yang dikandunginya, meninggalkan persekitaran anda. Bagi beban kerja yang dikawal selia atau sensitif, ini kadangkala tidak boleh diterima, itulah sebabnya inferens dihoskan sendiri atau di tepi wujud sebagai alternatif, walaupun dengan kos operasi yang lebih tinggi.
Apabila menilai vendor AI atau pilihan pembinaan, tanya tentang kos inferens per panggilan pada volum jangkaan anda, latensi di bawah beban pengeluaran sebenar, cara kos inferens berskala dengan penggunaan, dan ke mana data anda sebenarnya pergi apabila model dijalankan. Itulah angka yang menentukan sama ada kes penggunaan AI boleh dikekalkan secara ekonomi.
Konsep AI Berkaitan
- Pengoptimuman Inferens - Teknik untuk menjadikan inferens lebih pantas dan lebih murah
- MLOps - Mengurus penggunaan model dan pipeline inferens
- AI Tepi - Menjalankan inferens pada perkakasan tempatan dan bukannya awan
- Pemantauan Model - Menjejaki prestasi inferens dari masa ke masa
- Latensi - Mengapa masa respons menentukan sama ada ciri AI diterima pakai dalam pengeluaran
- Tetingkap Konteks - Pemacu kos utama inferens untuk model bahasa
- Seni Bina Transformer - Cara kebanyakan model moden mengira inferens
- Kuantisasi - Mengurangkan saiz model untuk merendahkan kos inferens
- Large Language Models - Kategori model yang menjadi tumpuan kebanyakan perbincangan tentang inferens
- Model Asas - Model asas yang digunakan perniagaan untuk menjalankan inferens melalui API atau hos sendiri
Sumber Luaran
- NVIDIA Inference Platform - Infrastruktur piawai industri untuk inferens model berskala besar
- Hugging Face Inference Endpoints - Panduan untuk serving model dalam pengeluaran dan pertukaran inferens
- Google AI Inference Best Practices - Panduan praktikal untuk seni bina dan pengoptimuman inferens
Soalan Lazim tentang Inferens AI
Apakah inferens AI?
Inferens AI ialah proses menjalankan model pembelajaran mesin yang telah dilatih pada input baharu untuk menjana ramalan atau output. Ia adalah fasa pengeluaran AI, di mana model yang dilatih dengan data sejarah digunakan pada data langsung untuk mencipta nilai: menjawab pertanyaan pelanggan, menilai petunjuk jualan, mengesan penipuan atau menjana dokumen.
Apakah perbezaan antara latihan dan inferens?
Latihan adalah proses mengajar model dengan mendedahkannya kepada set data yang besar dan melaraskan parameternya. Inferens adalah menjalankan model terlatih pada input baharu tanpa mengubah parameter tersebut. Latihan berlaku jarang dan memerlukan pengiraan yang besar. Inferens berlaku secara berterusan pada volum pengeluaran, yang merupakan tempat sebahagian besar kos infrastruktur AI yang berterusan berasal.
Mengapa inferens menjadi lebih mahal untuk diurus berbanding latihan bagi banyak syarikat?
Latihan ialah kos projek sekali atau sekali-sekala. Inferens ialah kos berulang yang berskala terus dengan bilangan orang yang menggunakan sesuatu ciri dan kekerapannya. Apabila penerimaan berkembang, perbelanjaan inferens turut berkembang, walaupun kos bagi setiap panggilan terus jatuh. Beberapa laporan industri 2025 mendapati inferens kini membentuk majoriti perbelanjaan pengiraan AI yang berterusan di perusahaan besar dan syarikat permulaan asli AI.
Mengapa latensi inferens penting untuk perniagaan?
Latensi menentukan betapa responsifnya pengalaman yang dikuasakan AI terasa kepada pengguna. Aplikasi yang berhadapan dengan pelanggan, seperti chatbot, cadangan masa nyata dan pembantu suara, memerlukan latensi rendah untuk mengelakkan kekecewaan pengguna. Alat dalaman yang digunakan oleh pekerja biasanya mempunyai toleransi latensi yang lebih tinggi. Mendapatkan keperluan latensi yang betul adalah bahagian penting dalam keputusan seni bina inferens.
Patutkah inferens dijalankan di awan atau pada peranti?
Bergantung pada keperluan latensi, sensitiviti data dan volum. Inferens awan paling mudah untuk digunakan dan berskala secara automatik, yang sesuai untuk kebanyakan aplikasi perniagaan. Inferens tepi atau pada peranti menghapuskan latensi rangkaian sepenuhnya dan memastikan data kekal setempat, yang penting bagi kes penggunaan sensitif privasi atau berketersambungan terhad, tetapi biasanya memerlukan model yang lebih kecil dan kurang berkemampuan.
Adakah inferens AI sentiasa masa nyata?
Tidak. Inferens masa nyata menjawab permintaan semasa ia tiba, iaitu apa yang diperlukan oleh chatbot, pengesanan penipuan dan pemperibadian langsung. Inferens kelompok memproses volum data yang besar mengikut jadual, sering pada waktu malam, dan lazimnya lebih murah bagi setiap panggilan kerana ia tidak perlu memenuhi keperluan latensi langsung. Banyak beban kerja yang kelihatan memerlukan inferens masa nyata boleh dijalankan sebagai kelompok atau hampir-masa-nyata tanpa kehilangan nilai perniagaan yang sebenar.
Bagaimana organisasi boleh mengurangkan kos inferens?
Tuas utama adalah menggunakan model yang lebih kecil di mana kualiti membenarkan, menggunakan kuantisasi untuk mengurangkan saiz model, menyuling model yang lebih kecil daripada model yang lebih besar, mengelompokkan permintaan di mana kekangan latensi membenarkan, menyimpan cache respons biasa dan menggunakan penyahkodan spekulatif untuk model bahasa. Pengoptimuman inferens adalah disiplin teknikal yang lengkap; banyak organisasi melihat pengurangan kos 50-90% daripada pengoptimuman sistematik tanpa menukar model yang mendasarinya.

Co-Founder, Rework.com
On this page
- Latihan vs. Inferens: Perbezaan Asas
- Cara Inferens Berfungsi
- Dua Dimensi Prestasi Utama
- Di Mana Inferens Dijalankan: Awan, Tepi dan Pada Peranti
- Apa yang Berubah pada 2026
- Fakta Utama
- Kos Perniagaan Inferens
- Inferens Masa Nyata vs. Inferens Kelompok
- Apa yang Perlu Difahami oleh Pemimpin Perniagaan
- Konsep AI Berkaitan
- Sumber Luaran