Bahasa Indonesia
Apa itu Inferensi AI? Menjalankan Model AI dalam Produksi
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Seorang peritel melatih model prediksi permintaan selama enam bulan. Para ilmuwan data memvalidasinya. Pimpinan menyetujuinya. Model tersebut siap. Kemudian masuk ke produksi dan harus menjawab ribuan kueri per hari, masing-masing dalam waktu kurang dari 200 milidetik, selama berbulan-bulan atau bertahun-tahun. Itulah inferensi: proses langsung dan berkelanjutan menjalankan model terlatih pada data nyata untuk menghasilkan output nyata.
Pelatihan mendapatkan sebagian besar perhatian dalam liputan AI. Inferensi adalah tempat nilai bisnis sebenarnya berada, dan pada 2026 inferensi juga menjadi tempat sebagian besar anggaran AI berada. Harga inferensi per token telah turun berorde-orde besaran sejak 2022, dan penggunaan tumbuh lebih cepat lagi, sehingga total belanja inferensi terus naik meskipun biaya per unit terus menyusut.
Pelatihan vs. Inferensi: Perbedaan Fundamental
Memahami inferensi membutuhkan pemahaman tentang apa yang bukan inferensi. Pelatihan adalah proses mengajar model dengan mengeksposnya pada sejumlah besar data dan menyesuaikan parameternya hingga menghasilkan output yang akurat. Pelatihan intensif secara komputasi, mahal, dan dilakukan relatif jarang.
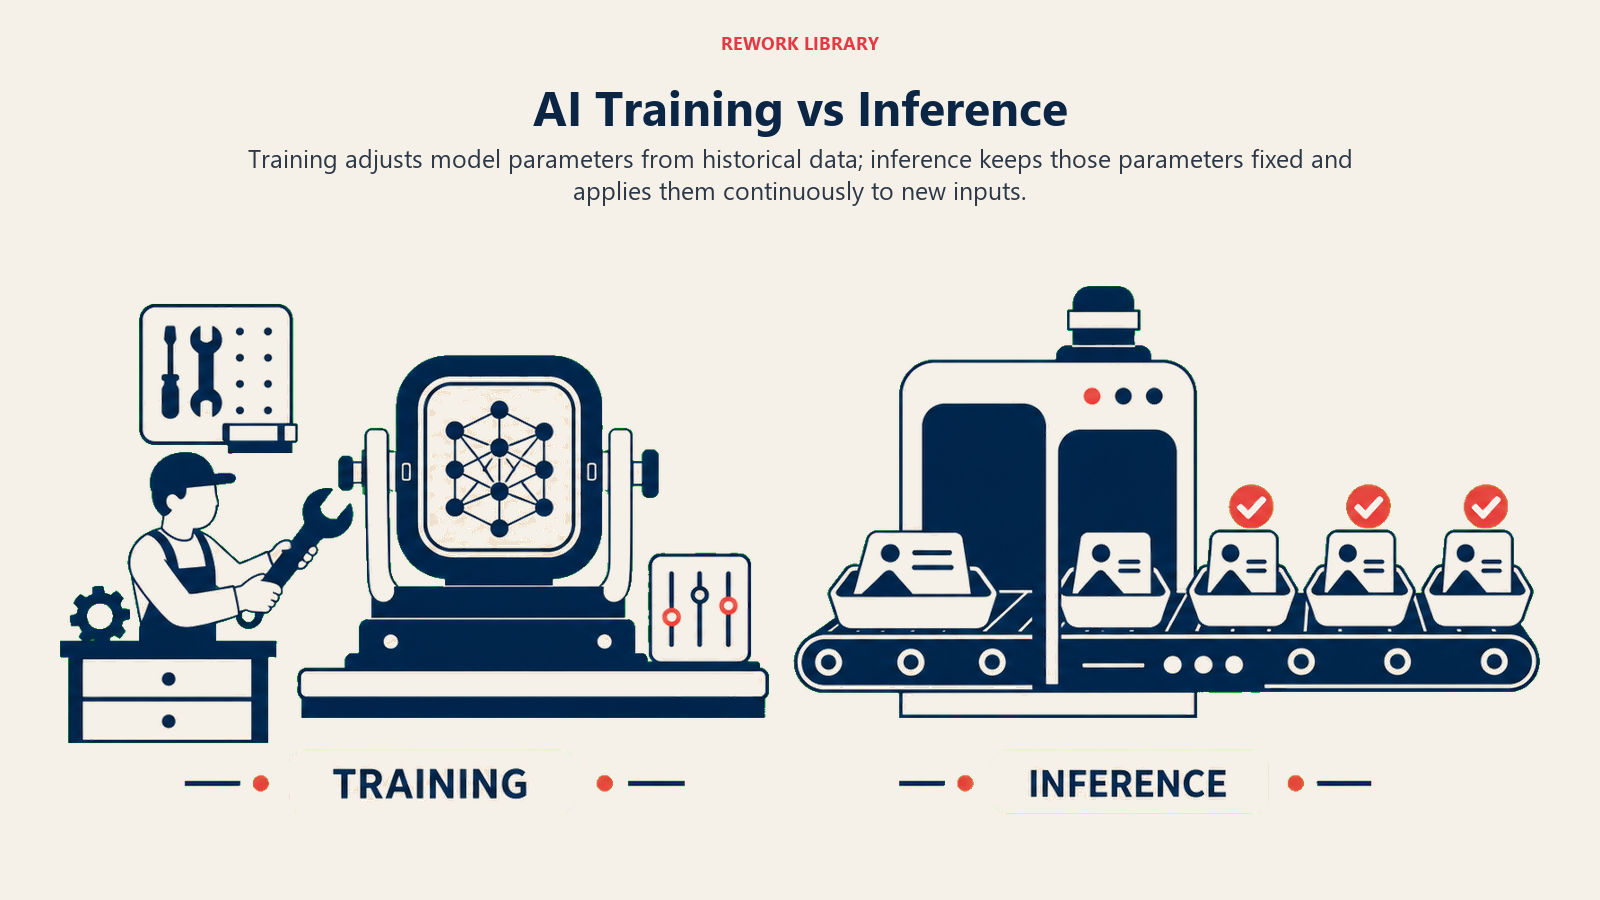
Inferensi adalah kebalikan dari ketiganya. Ini adalah proses mengambil model yang parameternya sudah ditetapkan dan menjalankannya pada input baru untuk menghasilkan prediksi. Inferensi terjadi ketika:
- Pelanggan mengetik pertanyaan ke chatbot dan mendapat respons
- Sistem deteksi penipuan mengevaluasi transaksi secara real-time
- Pipeline pemrosesan dokumen mengekstrak data dari faktur yang diunggah
- Mesin rekomendasi memutuskan apa yang ditampilkan kepada pengguna berikutnya
Pelatihan terjadi sekali (atau secara berkala). Inferensi terjadi secara terus-menerus, pada volume yang diminta oleh sistem produksi. Bagi kebanyakan bisnis, inferensi adalah tempat asal hampir semua biaya komputasi AI dalam produksi.
| Dimensi | Pelatihan | Inferensi |
|---|---|---|
| Tujuan | Mengajar model dengan menyesuaikan parameter pada data historis | Menerapkan parameter tetap model pada input baru yang belum pernah dilihat |
| Frekuensi | Terjadi sekali, lalu berkala untuk pelatihan ulang atau fine-tuning | Terjadi terus-menerus, setiap kali pengguna atau sistem memanggil model |
| Pola komputasi | Komputasi berkelanjutan, skala besar, dan paralel selama berhari-hari atau berminggu-minggu | Lonjakan singkat per permintaan, berulang ribuan hingga miliaran kali |
| Bentuk biaya | Belanja besar di muka, bergaya proyek | Belanja berkelanjutan berbasis penggunaan yang naik seiring adopsi |
Model yang murah dilatih tetapi mahal dijalankan dalam skala besar tetap bisa menjadi keputusan bisnis yang buruk. Model yang mahal dilatih tetapi murah dijalankan pada volume tinggi bisa balik modal berkali-kali lipat. Ekonomi inferensi, bukan skor benchmark pelatihan, biasanya yang menentukan model mana yang benar-benar dirilis.
Cara Kerja Inferensi
Selama inferensi, model terlatih menerima input, baik teks, gambar, data terstruktur, atau audio, dan menjalankannya melalui parameter yang telah dipelajari untuk menghasilkan output. Untuk sebuah large language model, ini berarti input dikonversi menjadi token, model memproses token tersebut melalui arsitektur transformer menggunakan mekanisme perhatian yang dipelajari, dan token output dihasilkan secara berurutan hingga respons selesai. Itulah sebabnya respons yang lebih panjang membutuhkan waktu lebih lama: setiap token output memerlukan satu lintasan penuh lagi melalui model.
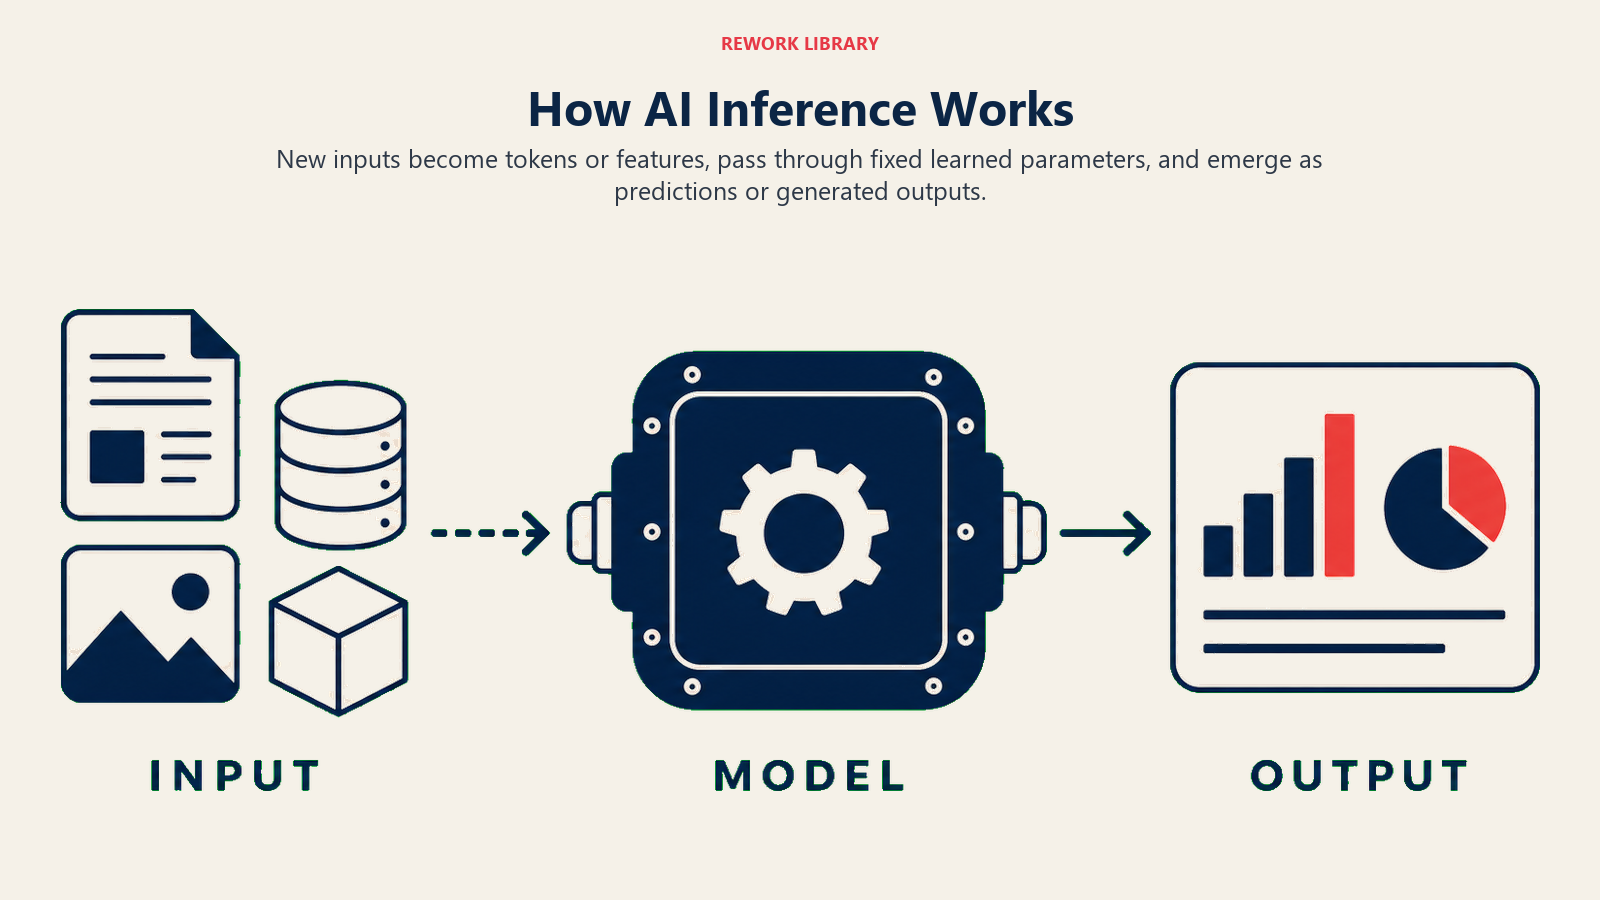
Parameter model tidak berubah selama inferensi. Model tidak belajar dari kueri; ia menerapkan apa yang sudah dipelajari pada input baru. Perbedaan ini penting secara praktis: artinya model yang sama dapat melayani ribuan pengguna secara bersamaan tanpa satu pun memengaruhi yang lain.
Biaya inferensi berasal dari komputasi yang diperlukan untuk memproses input melalui model yang mungkin memiliki miliaran atau ratusan miliaran parameter. Lebih banyak parameter umumnya berarti lebih banyak kemampuan dan lebih banyak komputasi per panggilan inferensi.
Dua Dimensi Kinerja Utama
Latensi adalah berapa lama satu panggilan inferensi berlangsung dari input ke output, termasuk waktu hingga token pertama dan waktu untuk menghasilkan setiap token berikutnya. Pengguna yang menunggu respons chatbot mengalami latensi. AI pencitraan medis membutuhkan latensi rendah saat ahli radiologi menunggu pembacaan. Pemrosesan dokumen yang terjadi semalam dalam batch dapat mentolerir latensi yang lebih tinggi.
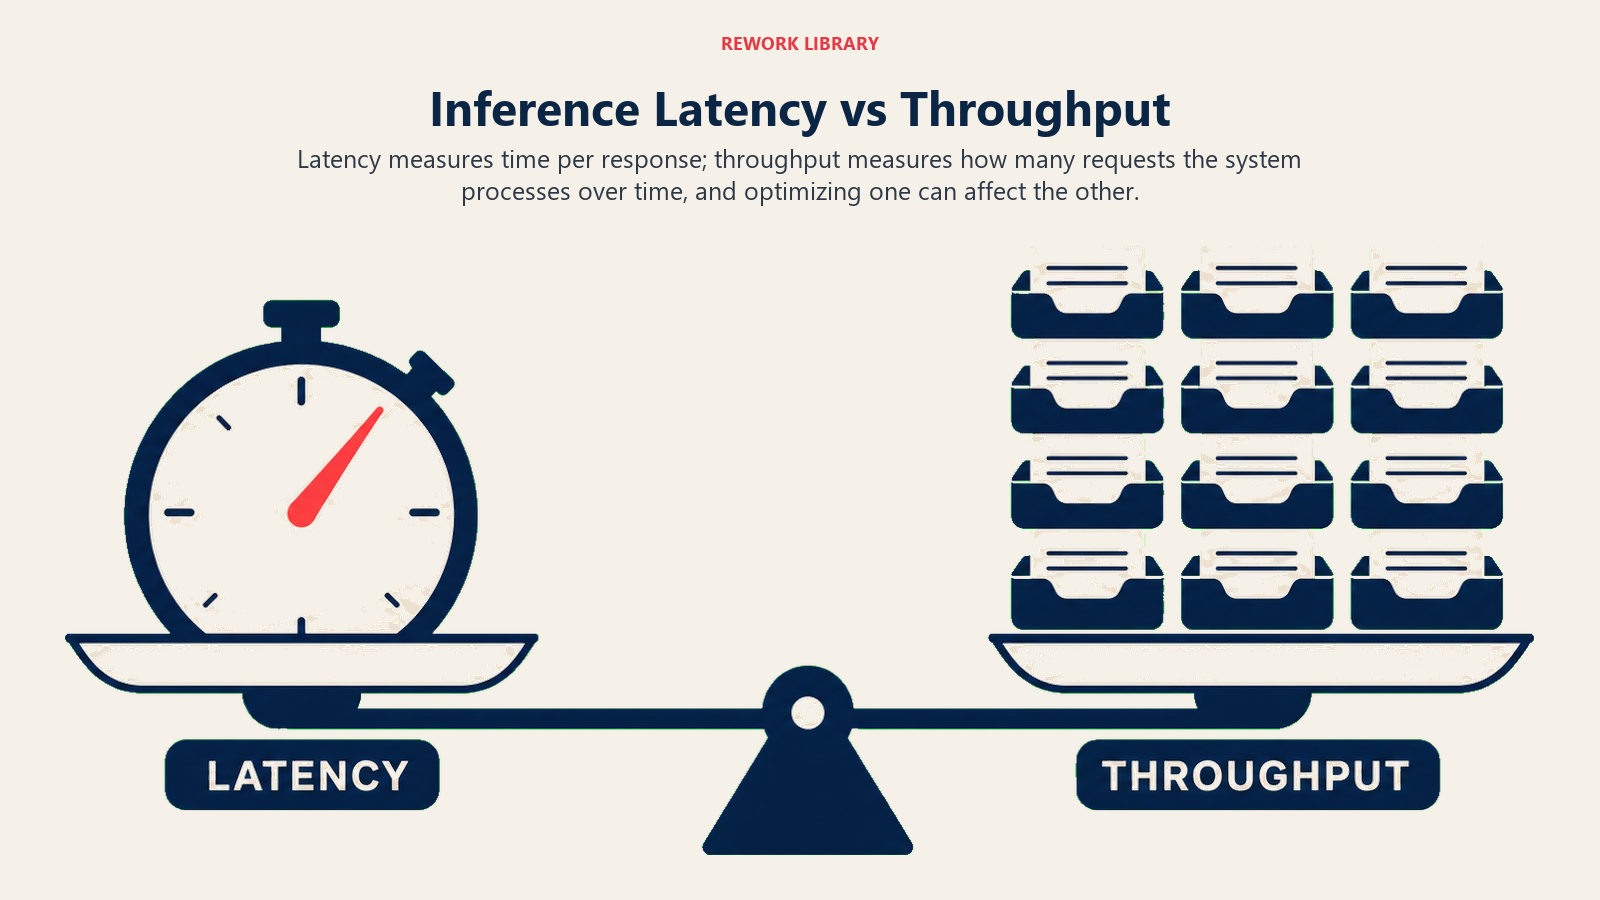
Throughput adalah berapa banyak panggilan inferensi yang dapat ditangani sistem per satuan waktu. Mesin rekomendasi e-commerce yang melayani jutaan pembeli membutuhkan throughput tinggi. Alat analisis dokumen hukum yang digunakan oleh tim 20 analis memiliki persyaratan throughput yang jauh lebih rendah.
Kedua dimensi ini sering saling bertentangan. Mengelompokkan beberapa permintaan inferensi bersama, misalnya, meningkatkan throughput karena perangkat keras memproses banyak input secara paralel, tetapi meningkatkan latensi untuk setiap permintaan individual karena menunggu batch terisi. Keseimbangan yang tepat tergantung pada kasus penggunaan.
Optimasi inferensi adalah bidang teknis yang didedikasikan untuk meningkatkan kedua dimensi, membuat model berjalan lebih cepat dan lebih murah tanpa mengorbankan kualitas.
Tempat Inferensi Berjalan: Cloud, Edge, dan On-Device
Inferensi berada di bagian atas stack AI. Model fondasi dilatih sekali oleh laboratorium AI menggunakan kluster komputasi besar. Bisnis baik memanggil model ini via API maupun menerapkan model di infrastruktur mereka sendiri, dan di mana inferensi itu sebenarnya berjalan adalah keputusan arsitektur yang nyata, bukan detail yang diserahkan begitu saja kepada tim infrastruktur.
Inferensi cloud. Model berjalan di server penyedia, biasanya diakses melalui API. Ini adalah pilihan default bagi kebanyakan bisnis yang memakai model fondasi dari laboratorium besar. Mudah dimulai, berskala otomatis mengikuti permintaan, dan menjaga biaya terkait langsung dengan penggunaan. Trade-off-nya adalah harga per panggilan yang berkelanjutan, ketergantungan pada uptime dan keputusan harga penyedia, serta latensi jaringan antara permintaan dan pusat data.
Inferensi self-hosted. Bisnis menjalankan model di infrastruktur GPU miliknya sendiri, di akun cloud privat atau on-premises. Ini memberi kendali lebih besar atas privasi data, bisa lebih murah daripada harga API pada volume yang sangat tinggi dan stabil, dan memungkinkan kustomisasi lebih dalam melalui fine-tuning. Artinya juga memikul beban operasional: menyediakan GPU, menjaga uptime, dan menangani lonjakan beban tanpa elastisitas penyedia.
Inferensi edge dan on-device. Model berjalan secara lokal, di ponsel, browser, kiosk ritel, atau sensor industri, tanpa perjalanan jaringan sama sekali. Ini adalah opsi dengan latensi terendah dan menjaga data tidak keluar dari perangkat, yang penting untuk kasus penggunaan sensitif privasi. Trade-off-nya adalah kemampuan: perangkat edge memiliki memori dan komputasi terbatas, sehingga deployment edge biasanya berarti model yang lebih kecil dan terkompresi, bukan model skala frontier.
Tidak ada satu pun yang benar secara universal. Chatbot dukungan pelanggan mungkin memakai inferensi cloud demi kualitas. Aplikasi inspeksi lapangan dengan konektivitas tidak stabil mungkin membutuhkan inferensi edge agar bisa berfungsi sama sekali. Alur kerja layanan kesehatan yang diatur regulasi mungkin mewajibkan inferensi self-hosted semata-mata demi residensi data.
Praktik MLOps mengatur bagaimana inferensi dikelola dalam produksi: bagaimana model diberi versi dan dideploy, bagaimana kinerja dipantau, bagaimana rollback ketika model berperilaku tidak terduga, dan kapan perlu melatih ulang. Pemantauan model adalah praktik berkelanjutan mengawasi output inferensi dan metrik kinerja untuk mendeteksi degradasi sebelum menyebabkan dampak bisnis.
Apa yang Berubah pada 2026
Selama bertahun-tahun, percakapan seputar AI didominasi pelatihan: model lebih besar, proses pelatihan lebih besar, berita utama lebih besar. Di situlah uang dan risiko tidak lagi berada. Inferensi telah menjadi pusat gravitasi operasional dan finansial bagi AI dalam produksi, karena tiga alasan yang saling terkait.
Penggunaan terus tumbuh lebih cepat daripada penurunan biaya per panggilan. Harga inferensi turun drastis sejak akhir 2022, tetapi adopsi tumbuh lebih cepat lagi, sehingga total belanja inferensi terus naik meskipun biaya per unit menyusut.
Inferensi bersifat berulang, pelatihan tidak. Satu proses pelatihan adalah proyek dengan awal dan akhir. Inferensi berjalan selama seluruh masa hidup fitur yang dideploy, yang untuk produk yang sukses bisa bertahun-tahun. Biaya yang tampak kecil per panggilan menjadi material ketika dikalikan jutaan permintaan harian yang berjalan tanpa batas waktu.
Penyedia infrastruktur sudah membangun ulang di sekitarnya. Analis kini memproyeksikan beban kerja inferensi akan melampaui pelatihan sebagai permintaan dominan pada pusat data AI dalam beberapa tahun ke depan, dan hyperscaler menggeser cara dan lokasi mereka membangun kapasitas sebagai akibat langsungnya: kluster pelatihan ditempatkan di lokasi terpencil dengan daya padat, sementara kapasitas inferensi makin bergerak mendekati pengguna untuk memangkas latensi jaringan.
Konsekuensi praktisnya bagi setiap pemimpin yang mensponsori proyek AI: model yang menang di benchmark pelatihan belum tentu model yang harus dirilis. Model dengan ekonomi inferensi yang berjalan baik pada volume produksi riil Anda adalah yang menentukan apakah fitur AI menjadi produk yang berkelanjutan atau sekadar pilot yang mahal.
Fakta Utama
- Biaya untuk memanggil model berkinerja setara GPT-3.5 turun dari $20,00 menjadi $0,07 per juta token antara November 2022 dan Oktober 2024, penurunan lebih dari 280 kali lipat dalam sekitar 18 bulan, menurut laporan Stanford AI Index 2025.
- Harga inferensi LLM pada tingkat kinerja tetap telah turun dengan laju median sekitar 50 kali per tahun, mempercepat menjadi sekitar 200 kali per tahun untuk data sejak Januari 2024, menurut analisis tren harga inferensi dari Epoch AI.
- Inferensi diproyeksikan melampaui pelatihan sebagai beban kerja komputasi AI dominan pada 2030, mencakup lebih dari separuh seluruh komputasi AI dan 30 hingga 40 persen dari total permintaan pusat data, menurut analisis McKinsey tentang pergeseran beban kerja AI.
- 49 persen perusahaan besar melaporkan bahwa sebagian besar atau hampir seluruh komputasi mereka digerakkan oleh inferensi pada 2025, naik dari 29 persen tahun sebelumnya, menurut pembaruan pasar LLM pertengahan 2025 dari Menlo Ventures.
- Belanja Anthropic pada 2025 mencakup sekitar $2,7 miliar untuk komputasi inferensi dan $4,1 miliar untuk komputasi R&D (pelatihan) dari total pengeluaran $9,7 miliar, menurut analisis Epoch AI atas belanja perusahaan AI, berdasarkan pemberitaan The Information.
- Pasar inferensi AI global diproyeksikan tumbuh dari $106,15 miliar pada 2025 menjadi $254,98 miliar pada 2030, melampaui pelatihan sebagai kategori pengeluaran dominan dalam AI perusahaan, menurut riset MarketsandMarkets yang dikutip Forbes.
Biaya Bisnis dari Inferensi
Bagi organisasi yang menggunakan AI dalam skala besar, biaya inferensi adalah baris anggaran yang material. Pendorong biaya meliputi:
Ukuran model. Model yang lebih besar memerlukan lebih banyak komputasi per panggilan inferensi. Model dengan 70 miliar parameter menghabiskan biaya sekitar 10 kali lebih banyak untuk inferensi dibandingkan model dengan 7 miliar parameter, meskipun perbedaan kualitas dapat membenarkan biaya tersebut untuk beberapa kasus penggunaan.
Volume permintaan. Biaya inferensi berskala dengan penggunaan. Sistem yang menangani 10 juta panggilan inferensi harian menghabiskan biaya lebih banyak secara proporsional dibandingkan yang menangani 10.000.
Perangkat keras. Inferensi GPU lebih cepat tapi lebih mahal dari inferensi CPU. Chip inferensi khusus (seperti TPU Google atau AWS Inferentia) dapat meningkatkan efisiensi biaya untuk beban kerja tertentu.
Ukuran jendela konteks. Untuk model bahasa, input yang lebih panjang menghabiskan lebih banyak biaya untuk diproses karena biaya inferensi berskala dengan jumlah token. Sistem yang melewati konteks besar di setiap panggilan menghadapi biaya yang lebih tinggi secara proporsional.
Karena biaya inferensi berskala langsung dengan penggunaan, inilah tempat dengan daya ungkit tertinggi untuk memangkas belanja AI tanpa menyentuh cakupan produk. Teknik optimasi intinya adalah:
Kuantisasi. Mengurangi presisi numerik bobot model, misalnya dari floating point 32-bit menjadi integer 8-bit atau 4-bit, mengecilkan jejak memori model dan mempercepat komputasi, biasanya dengan trade-off akurasi yang kecil. Lihat Kuantisasi untuk mekanismenya.
Distilasi. Melatih model "siswa" yang lebih kecil untuk meniru output model "guru" yang lebih besar. Hasilnya berjalan lebih cepat dan lebih murah sambil mempertahankan sebagian besar kemampuan sang guru pada tugas yang didistilasi.
Batching. Mengelompokkan beberapa permintaan inferensi agar perangkat keras memprosesnya secara paralel, bukan satu per satu. Ini meningkatkan throughput secara substansial, dengan konsekuensi tambahan latensi untuk permintaan individual, karena masing-masing menunggu batch terisi.
Caching. Menyimpan output dari kueri yang umum atau berulang agar model tidak perlu memproses input yang sama dua kali. Untuk aplikasi dengan banyak lalu lintas berulang, caching dapat menghilangkan sebagian besar panggilan inferensi sepenuhnya.
Speculative decoding. Model "draf" yang kecil dan cepat memprediksi beberapa token ke depan, dan model yang lebih besar memverifikasinya dalam satu lintasan, bukan menghasilkan tiap token satu per satu sendirian. Ketika tebakan model draf bagus, ini mengurangi jumlah lintasan penuh model yang mahal untuk menghasilkan satu respons.
Sebagian besar sistem produksi menggabungkan beberapa teknik ini sekaligus. Tidak satu pun mengharuskan beralih ke model yang secara fundamental berbeda atau berkualitas lebih rendah; teknik-teknik ini mengubah seberapa efisien model yang sudah ada disajikan. Organisasi yang menerapkannya secara sistematis umumnya melaporkan pengurangan biaya 50 hingga 90 persen dibandingkan deployment yang tidak dioptimalkan.
Inferensi Real-Time vs. Inferensi Batch
Tidak semua inferensi terjadi secara real-time. Banyak aplikasi AI yang berharga berjalan pada jadwal batch daripada merespons permintaan langsung.
Inferensi real-time menangani permintaan saat tiba, dengan latensi milidetik hingga detik. Chatbot, deteksi penipuan, personalisasi real-time, dan asisten suara semuanya memerlukan mode ini.
Inferensi batch memproses dataset besar sesuai jadwal, sering semalam atau sesuai permintaan. Pengayaan CRM yang berjalan setiap malam untuk menilai semua leads, pemrosesan dokumen yang bekerja melalui antrean file yang diunggah, atau beban kerja analitik yang menghasilkan laporan mingguan semuanya cocok dengan pola batch. Inferensi batch umumnya lebih murah per panggilan inferensi karena dapat memanfaatkan strategi batching yang efisien tanpa kendala persyaratan latensi yang berhadapan dengan pengguna.
Pilihan antara mode adalah keputusan produk dan arsitektur, bukan semata-mata teknis. Banyak kasus penggunaan yang awalnya tampak memerlukan inferensi real-time dapat dirancang ulang sebagai mendekati-real-time atau batch tanpa kehilangan nilai bisnis yang berarti, dengan biaya yang jauh lebih rendah.
Yang Perlu Dipahami oleh Pemimpin Bisnis
Istilah AI yang paling banyak diperhatikan, data pelatihan, arsitektur model, skor benchmark, semuanya berkaitan dengan potensi model. Inferensi adalah tempat potensi tersebut diterjemahkan menjadi hasil bisnis atau tidak. Tiga konsekuensi praktis mengikuti langsung dari cara kerja inferensi, dan ketiganya layak masuk daftar periksa pemimpin sebelum menyetujui deployment AI, bukan sesudahnya.
Biaya berskala dengan kesuksesan, dan ini berlaku di dua arah. Biaya pelatihan kurang lebih tetap setelah proyek selesai. Biaya inferensi naik langsung bersama adopsi: semakin berguna sebuah fitur, semakin sering dipakai, dan semakin mahal untuk dijalankan. Fitur yang tampak terjangkau dalam pilot dengan 50 pengguna bisa menjadi baris anggaran yang nyata pada 50.000 pengguna.
Latensi menentukan apakah orang benar-benar memakai fitur tersebut. Pengguna menyesuaikan perilaku mereka dengan kecepatan respons fitur AI. Alat interaktif yang butuh lebih dari beberapa detik rutin mengalami penurunan adopsi, dan setelah pengguna terbiasa menghindari fitur yang lambat, mereka sering tidak kembali meski sudah diperbaiki.
Tempat inferensi berjalan memengaruhi siapa yang dapat melihat data Anda. Inferensi cloud melalui API pihak ketiga berarti permintaan, dan konteks apa pun di dalamnya, keluar dari lingkungan Anda. Untuk beban kerja yang diatur regulasi atau sensitif, itu kadang tidak dapat diterima, yang menjadi alasan inferensi self-hosted atau edge ada sebagai alternatif, meski dengan biaya operasional lebih tinggi.
Saat mengevaluasi vendor AI atau opsi pembangunan, tanyakan tentang biaya inferensi per panggilan pada volume yang Anda harapkan, latensi di bawah beban produksi nyata, bagaimana biaya inferensi berskala dengan penggunaan, dan ke mana data Anda sebenarnya pergi saat model berjalan. Itulah angka yang menentukan apakah kasus penggunaan AI secara ekonomis berkelanjutan.
Konsep AI Terkait
- Optimasi Inferensi - Teknik untuk membuat inferensi lebih cepat dan lebih murah
- MLOps - Mengelola deployment model dan pipeline inferensi
- AI di Tepi - Menjalankan inferensi di hardware lokal alih-alih cloud
- Pemantauan Model - Melacak kinerja inferensi dari waktu ke waktu
- Latensi - Mengapa waktu respons menentukan apakah fitur AI diadopsi dalam produksi
- Jendela Konteks - Pendorong biaya utama inferensi untuk model bahasa
- Arsitektur Transformer - Cara sebagian besar model modern menghitung inferensi
- Kuantisasi - Mengurangi ukuran model untuk menurunkan biaya inferensi
- Large Language Models - Kategori model yang menjadi pusat sebagian besar pembahasan inferensi
- Model Fondasi - Model dasar yang dijalankan bisnis untuk inferensi via API atau self-hosting
Sumber Eksternal
- NVIDIA Inference Platform - Infrastruktur standar industri untuk inferensi model skala besar
- Hugging Face Inference Endpoints - Panduan untuk serving model produksi dan trade-off inferensi
- Google AI Inference Best Practices - Panduan praktis untuk arsitektur dan optimasi inferensi
Pertanyaan yang Sering Diajukan tentang Inferensi AI
Apa itu inferensi AI?
Inferensi AI adalah proses menjalankan model machine learning terlatih pada input baru untuk menghasilkan prediksi atau output. Ini adalah fase produksi AI, di mana model yang dilatih pada data historis diterapkan pada data langsung untuk menciptakan nilai: menjawab kueri pelanggan, menilai leads, mendeteksi penipuan, atau menghasilkan dokumen.
Apa perbedaan antara pelatihan dan inferensi?
Pelatihan adalah proses mengajar model dengan mengeksposnya pada dataset besar dan menyesuaikan parameternya. Inferensi adalah menjalankan model terlatih pada input baru tanpa mengubah parameter tersebut. Pelatihan terjadi jarang dan memerlukan komputasi besar. Inferensi terjadi terus-menerus pada volume produksi, yang merupakan tempat asal sebagian besar biaya infrastruktur AI yang berkelanjutan.
Mengapa inferensi menjadi lebih mahal untuk dikelola daripada pelatihan bagi banyak perusahaan?
Pelatihan adalah biaya proyek sekali atau sesekali. Inferensi adalah biaya berulang yang berskala langsung dengan jumlah orang yang memakai fitur dan seberapa sering. Seiring adopsi tumbuh, belanja inferensi ikut tumbuh, meskipun biaya per panggilan terus turun. Beberapa laporan industri 2025 menemukan bahwa inferensi kini menyusun mayoritas belanja komputasi AI berkelanjutan, baik di perusahaan besar maupun startup AI-native.
Mengapa latensi inferensi penting bagi bisnis?
Latensi menentukan seberapa responsif pengalaman yang didukung AI terasa bagi pengguna. Aplikasi yang berhadapan dengan pelanggan, seperti chatbot, rekomendasi real-time, dan asisten suara, membutuhkan latensi rendah untuk menghindari frustrasi pengguna. Alat internal yang digunakan oleh karyawan biasanya memiliki toleransi latensi yang lebih tinggi. Mendapatkan persyaratan latensi yang tepat adalah bagian penting dari keputusan arsitektur inferensi.
Haruskah inferensi berjalan di cloud atau on-device?
Tergantung kebutuhan latensi, sensitivitas data, dan volume. Inferensi cloud paling sederhana untuk dideploy dan berskala otomatis, yang cocok untuk sebagian besar aplikasi bisnis. Inferensi on-device atau edge menghilangkan latensi jaringan sepenuhnya dan menjaga data tetap lokal, yang penting untuk kasus penggunaan sensitif privasi atau dengan konektivitas terbatas, tetapi biasanya membutuhkan model yang lebih kecil dan kurang mampu.
Apakah inferensi AI selalu real-time?
Tidak. Inferensi real-time merespons permintaan saat tiba, yang dibutuhkan chatbot, deteksi penipuan, dan personalisasi langsung. Inferensi batch memproses data dalam volume besar sesuai jadwal, sering semalam, dan biasanya lebih murah per panggilan karena tidak harus memenuhi persyaratan latensi langsung. Banyak beban kerja yang tampak membutuhkan inferensi real-time dapat berjalan sebagai batch atau mendekati-real-time tanpa kehilangan nilai bisnis yang berarti.
Bagaimana organisasi dapat mengurangi biaya inferensi?
Tuas utamanya adalah menggunakan model yang lebih kecil di mana kualitas memungkinkan, menerapkan kuantisasi untuk mengurangi ukuran model, menerapkan distilasi untuk membuat model lebih kecil dari yang lebih besar, mengelompokkan permintaan di mana kendala latensi memungkinkan, menyimpan cache respons umum, dan memakai speculative decoding untuk model bahasa. Optimasi inferensi adalah disiplin teknis tersendiri; banyak organisasi melihat pengurangan biaya 50-90% dari optimasi sistematis tanpa mengubah model yang mendasarinya.

Co-Founder, Rework.com
On this page
- Pelatihan vs. Inferensi: Perbedaan Fundamental
- Cara Kerja Inferensi
- Dua Dimensi Kinerja Utama
- Tempat Inferensi Berjalan: Cloud, Edge, dan On-Device
- Apa yang Berubah pada 2026
- Fakta Utama
- Biaya Bisnis dari Inferensi
- Inferensi Real-Time vs. Inferensi Batch
- Yang Perlu Dipahami oleh Pemimpin Bisnis
- Konsep AI Terkait
- Sumber Eksternal