O que é Agentic RAG? Definição, arquitetura e diferenças em relação ao RAG tradicional
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Agentic RAG é a geração aumentada por recuperação (retrieval-augmented generation) controlada por um AI agent, e não por um pipeline fixo: o agente decide quando recuperar informações, quais fontes consultar, se as evidências encontradas são boas o bastante e se vale a pena pesquisar de novo antes de responder, em vez de executar uma única busca e gerar uma resposta.
Essa mudança, entregar as decisões de recuperação a um sistema capaz de raciocinar em vez de a um script, é o motivo pelo qual o agentic RAG aparece nos problemas corporativos mais difíceis: pesquisa em múltiplos documentos, dúvidas de compliance que envolvem várias políticas ao mesmo tempo e tickets de suporte que exigem consultar um sistema e, depois, conferir um segundo sistema com base no primeiro.
Agentic RAG vs. RAG tradicional: o que realmente muda
O Retrieval-Augmented Generation padrão segue uma sequência fixa: converte a pergunta em um vetor, busca os trechos mais compatíveis em uma única base de conhecimento, entrega esses trechos ao modelo e gera uma resposta. É rápido e previsível, mas também frágil assim que uma pergunta exige mais de uma consulta.
O agentic RAG envolve essa mesma estrutura de recuperação em um ciclo de raciocínio. Um AI agent fica na frente do pipeline e toma três decisões que um pipeline estático não consegue tomar:
- Quando recuperar. Nem toda pergunta exige uma busca. Uma pergunta simples de esclarecimento pode dispensá-la, enquanto uma pergunta com várias partes pode exigir recuperação a cada etapa, e não apenas uma vez no início.
- O que e onde recuperar. O agente pode escolher entre um banco de dados vetorial, uma tabela SQL, uma API ou uma busca na web, e pode consultar mais de uma fonte quando uma única base de conhecimento não responde à pergunta inteira.
- Se a resposta está boa o suficiente. Depois de recuperar, o agente avalia as evidências. Se forem fracas, contraditórias ou fora do tema, ele reformula a consulta e recupera novamente, em vez de gerar uma resposta frágil a partir de evidências ruins.
Essa terceira decisão, a autocorreção, é a diferença prática que a maioria das equipes percebe primeiro. Um sistema de RAG tradicional que faz uma recuperação inicial ruim simplesmente gera uma resposta ruim com toda a confiança. Um sistema de agentic RAG pode perceber que a recuperação foi fraca e tentar outra consulta, outra fonte ou dividir a pergunta em partes menores antes de gerar a resposta final.
A arquitetura por trás do Agentic RAG
Deixando de lado o marketing dos fornecedores, os sistemas de agentic RAG compartilham um conjunto comum de componentes, a maioria deles conhecida do RAG padrão, mais uma camada de raciocínio por cima.
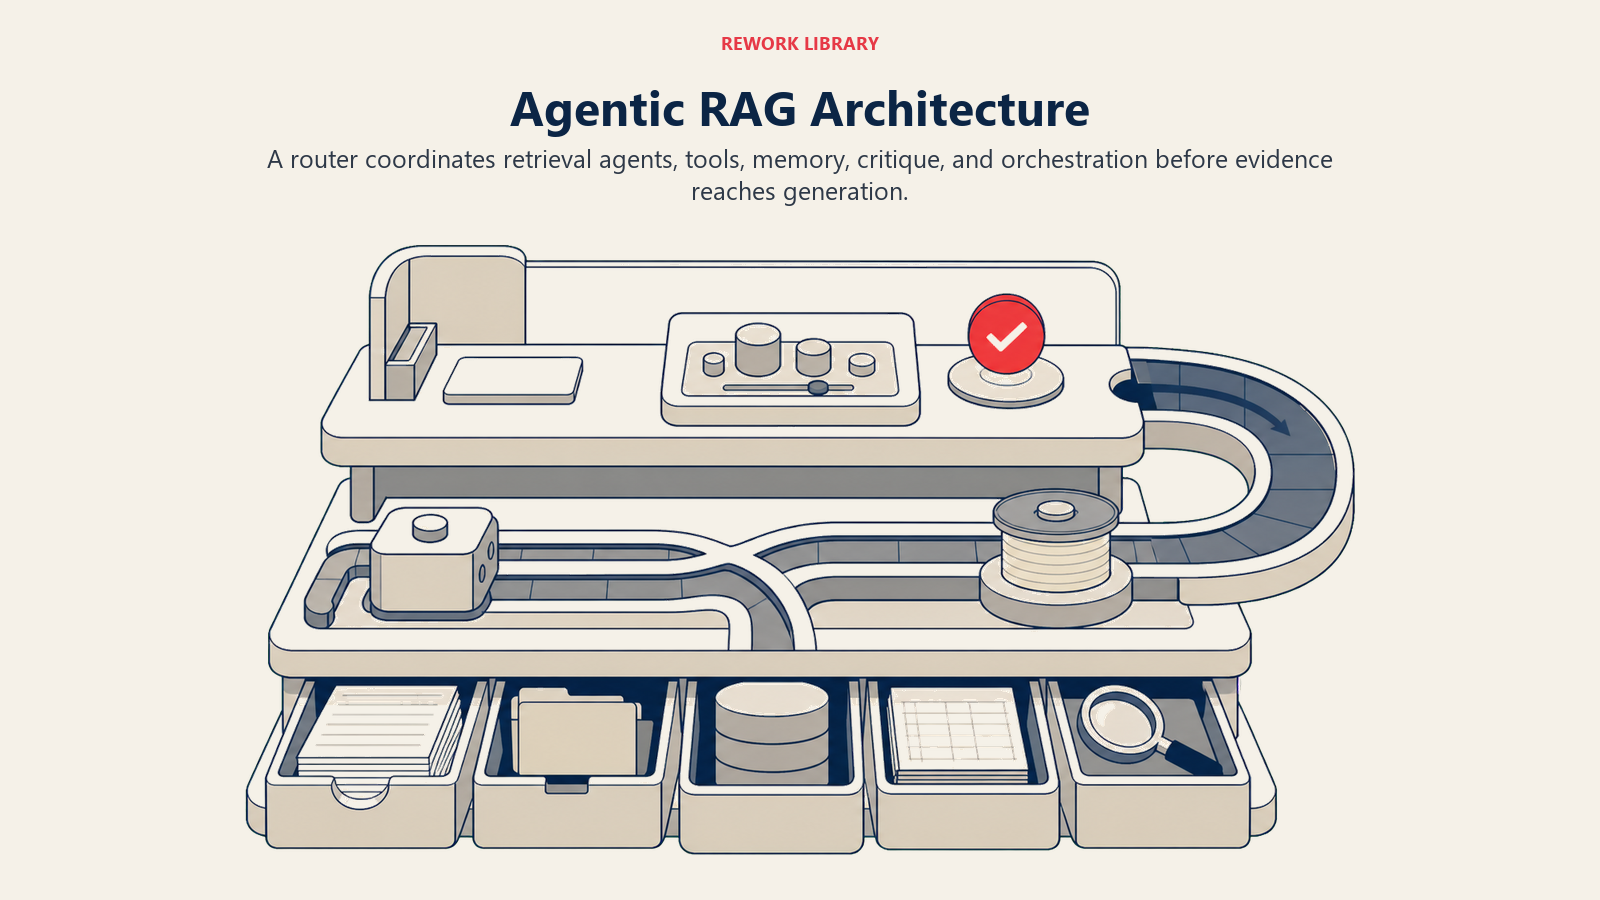
- Query router: O primeiro ponto de decisão. Ele classifica a pergunta recebida e decide se ela exige recuperação, qual fonte (ou fontes) consultar e se a pergunta deve ser dividida antes em subperguntas. É a peça que não existe no RAG tradicional.
- Retrieval agents: Subagentes especializados, cada um responsável por uma fonte de conhecimento: um vector store de documentação de produto, uma consulta a registros do CRM, uma busca ao vivo na web, uma consulta a um banco de dados estruturado. O router pode acionar um ou vários, conforme a pergunta.
- Ferramentas (tools): Tudo o que o sistema pode acionar além da busca em texto: uma calculadora para perguntas numéricas, um mecanismo SQL para dados estruturados, uma API de busca na web para eventos atuais. Veja tool use para entender como isso funciona, em geral, em sistemas agênticos.
- Memória: A memória de trabalho guarda a pergunta atual e tudo o que foi recuperado até agora na sessão. A memória de longo prazo, muitas vezes apoiada em um banco de dados vetorial, permite reaproveitar recuperações anteriores ou lembrar o que funcionou em perguntas semelhantes. Veja AI memory para um detalhamento maior.
- Ciclo de crítica e autocorreção: Após cada recuperação, uma etapa de revisão (às vezes o próprio modelo, às vezes outro) verifica se as evidências recuperadas realmente sustentam uma resposta. Se não sustentarem, ela dispara uma nova rodada de recuperação com a consulta reformulada, até um limite definido, para que o sistema não entre em loop infinito.
- Camada de orquestração: Coordena toda a sequência: quando passar a tarefa entre os retrieval agents, quando parar de recuperar e gerar a resposta, quando escalar para uma pessoa. Isso se sobrepõe bastante à AI orchestration em geral e aos agentic workflows.
A busca semântica e os embeddings continuam fazendo o trabalho pesado dentro de cada etapa de recuperação. O agentic RAG não substitui essa estrutura, ele decide quando e como apontá-la.
Agentic RAG vs. RAG padrão
| Aspecto | RAG padrão | Agentic RAG |
|---|---|---|
| Gatilho da recuperação | Sempre executa uma vez, em toda consulta | O agente decide se, quando e quantas vezes recuperar |
| Seleção de fontes | Fixa, geralmente uma única base de conhecimento | O agente escolhe entre várias fontes ou consulta mais de uma |
| Perguntas em várias etapas | Tem dificuldade, trata a pergunta como uma única busca | Divide a pergunta em subperguntas e recupera para cada uma |
| Autocorreção | Nenhuma, gera a partir do que foi recuperado | Avalia a qualidade das evidências e recupera de novo se forem fracas |
| Uso de ferramentas | Em geral nenhum, além da busca vetorial | Pode acionar calculadoras, mecanismos SQL, APIs e busca na web |
| Latência e custo | Baixos, uma única passagem de recuperação | Mais altos, várias passagens de recuperação e raciocínio |
| Modo de falha | Resposta errada dada com confiança, a partir de evidências ruins | Mais lento, mas com mais chance de sinalizar ou corrigir uma recuperação inicial ruim |
| Melhor aplicação | Perguntas e respostas simples sobre um conjunto de documentos único e bem delimitado | Pesquisa multi-hop, perguntas entre sistemas, verificações de compliance |
Na prática: o RAG padrão é a escolha certa para consultas restritas e bem delimitadas, em que velocidade e custo pesam mais do que lidar com casos de borda. O agentic RAG compensa a latência e o custo extras em perguntas que realmente exigem mais de uma consulta ou uma segunda opinião sobre as evidências.
Casos de uso corporativos reais do Agentic RAG em 2026
Pesquisa financeira: Analistas fazem perguntas que abrangem vários relatórios, teleconferências de resultados e fontes de dados de mercado ao mesmo tempo. Um sistema de agentic RAG verifica cada fonte, cruza os números e sinaliza quando duas fontes divergem, em vez de escolher uma delas em silêncio.
Revisão jurídica e de compliance: Uma única pergunta de compliance, "esta cláusula do contrato entra em conflito com nossa política atual de tratamento de dados?", muitas vezes exige conferir o contrato, a política e, às vezes, uma referência regulatória entre si. O agentic RAG recupera as três fontes e verifica a consistência antes de responder.
Escalonamento de suporte ao cliente: Os sistemas de suporte encaminham a pergunta primeiro à documentação do produto, depois aos dados específicos da conta se a documentação não a responder por completo e, por fim, a uma pessoa se nenhuma das fontes resolver com segurança. Essa lógica de ramificação é exatamente o que um query router e um ciclo de autocorreção foram feitos para tratar.
Busca técnica e de engenharia: Desenvolvedores fazem perguntas que abrangem uma base de código, a documentação interna e relatórios de incidentes anteriores. O agentic RAG pode consultar as três fontes e conciliá-las, em vez de devolver a que por acaso ficou mais bem posicionada em uma única busca vetorial.
Pesquisa comercial e de contas: Os representantes pedem uma visão completa de um prospect: histórico no CRM, notícias recentes, dados firmográficos. Um sistema de agentic RAG decide quais fontes são relevantes para aquela conta específica e ignora as que não vão acrescentar nada.
Benefícios e limitações
A arquitetura troca uma chance maior de encontrar e conferir as evidências certas por mais componentes em movimento em tempo de execução.
Benefícios:
- Lida com perguntas multi-hop que exigem evidências de mais de uma fonte, onde o RAG padrão devolve apenas uma resposta parcial ou errada
- Detecta recuperações fracas ou contraditórias antes que virem uma resposta errada dada com confiança, reduzindo o risco de alucinação
- Adapta a fonte consultada a cada pergunta, em vez de sempre recorrer à mesma base de conhecimento fixa
- Escala com naturalidade conforme novas fontes de conhecimento são adicionadas: o router ganha mais uma opção, sem precisar reconstruir o pipeline
Limitações:
- Latência e custo: Várias passagens de recuperação e raciocínio levam mais tempo e custam mais por consulta do que uma busca de RAG em uma única etapa. Nem todo caso de uso consegue absorver isso.
- Mais difícil de depurar: Quando uma resposta de RAG estático está errada, a correção costuma ser um único trecho ruim. Quando a resposta de um agentic RAG está errada, a falha pode estar no router, na recuperação, na etapa de crítica ou na geração final, o que exige mais instrumentação para rastrear.
- Loops de recuperação descontrolados: Sem um limite rígido de tentativas de recuperação, um ciclo de autocorreção pode continuar consultando sem parar uma pergunta que realmente não tem resposta, em vez de informar que não há evidências suficientes.
- Ainda depende da qualidade das fontes: Um agente que consulta três fontes ruins em vez de uma continua devolvendo uma resposta ruim. O agentic RAG melhora a forma como as decisões de recuperação são tomadas, não a qualidade dos dados de origem.
- Exagero para consultas simples: Uma pergunta de fato único sobre um conjunto de documentos limpo não precisa de um router, de um ciclo de crítica nem de orquestração de várias fontes. Nesse caso, o RAG padrão é mais adequado.
Os checkpoints de human-in-the-loop continuam sendo a principal salvaguarda em implantações de agentic RAG de alto risco, especialmente em casos de uso de compliance e jurídicos, em que uma resposta errada tem consequências reais.
Fatos principais
- 70% das empresas que usam generative AI agora incorporam ferramentas, sistemas de recuperação e bancos de dados vetoriais, em vez de depender apenas de modelos de linguagem prontos para uso. Databricks
- A adoção de bancos de dados vetoriais cresceu 377% em relação ao ano anterior, a categoria que mais cresceu entre todas as tecnologias relacionadas a LLM acompanhadas. Databricks
- As empresas passaram de chatbots isolados para sistemas multiagente coordenados, que cresceram 327% em menos de quatro meses. Databricks
- Empresas com governança formal de AI colocaram mais de 12 vezes mais projetos de AI em produção do que as que não a têm. Databricks
- Apenas 16% das implantações de AI corporativas (27% em startups) se qualificam como agentes de verdade, que planejam, executam, observam o feedback e se adaptam; a maioria ainda são workflows de sequência fixa ou baseados em roteamento. Menlo Ventures
- 40% dos aplicativos corporativos terão AI agents específicos para tarefas até o fim de 2026, contra menos de 5% em 2025. Gartner
- Mais de 40% dos projetos de agentic AI serão cancelados até o fim de 2027 por custos crescentes, valor de negócio pouco claro ou controles de risco inadequados, a mesma falta de disciplina que atrapalha implantações ambiciosas de agentic RAG. Gartner
Perguntas frequentes sobre Agentic RAG
O que é agentic RAG, em termos simples?
Agentic RAG é a geração aumentada por recuperação em que um AI agent, e não um script fixo, decide quando pesquisar, quais fontes consultar e se as evidências encontradas são boas o bastante antes de responder. Se a primeira recuperação não for suficiente, o agente tenta de novo em vez de gerar a resposta a partir de evidências fracas.
Qual é a diferença entre agentic RAG e RAG tradicional?
O RAG tradicional executa uma única passagem de recuperação por consulta em uma única base de conhecimento e gera uma resposta independentemente da qualidade das evidências recuperadas. O agentic RAG pode consultar várias fontes, dividir uma pergunta em subperguntas, avaliar as evidências que recebe e recuperar de novo, se necessário.
O agentic RAG usa mais de uma fonte de conhecimento?
Sim, essa é uma de suas principais vantagens. Um query router pode enviar partes diferentes de uma pergunta a fontes diferentes (um repositório de documentos, um banco de dados, uma API ao vivo) e combinar o que voltar, em vez de ficar preso a uma única base de conhecimento fixa como no RAG padrão.
O que é autocorreção no agentic RAG?
É a etapa em que o sistema verifica se as evidências recuperadas realmente sustentam uma resposta antes de gerá-la. Se as evidências forem fracas ou contraditórias, o agente reformula a consulta e recupera de novo, em vez de responder com informações frágeis.
O agentic RAG é mais lento e mais caro que o RAG padrão?
Em geral, sim. Várias passagens de recuperação e raciocínio levam mais tempo e custam mais por consulta do que uma busca em uma única etapa. Esse custo compensa em perguntas multi-hop ou de alto risco, e normalmente não compensa em consultas simples de um único fato.
Para quais problemas de negócio o agentic RAG é mais indicado?
Perguntas que exigem evidências de mais de uma fonte: pesquisa financeira que abrange vários relatórios, verificações de compliance que cruzam várias políticas, tickets de suporte que exigem conferir a documentação do produto e os dados da conta em conjunto e busca técnica em uma base de código e na respectiva documentação.
Quais são os principais riscos do agentic RAG?
Loops de recuperação descontrolados em perguntas que realmente não têm resposta, depuração mais difícil (uma resposta errada pode ter origem no router, na recuperação ou na etapa de crítica) e o fato de que consultar mais fontes não corrige dados de origem ruins.
Preciso de agentic RAG ou o RAG padrão é suficiente?
Se suas perguntas são restritas e podem ser respondidas a partir de um único conjunto de documentos bem delimitado, o RAG padrão é mais rápido, mais barato e mais simples de manter. Recorra ao agentic RAG quando as perguntas exigirem, de forma recorrente, mais de uma consulta ou a checagem em várias fontes antes que você possa confiar na resposta.
Conceitos de AI relacionados
- Retrieval-Augmented Generation - A base de recuperação e geração sobre a qual o agentic RAG se apoia
- O que é Agentic AI? - A abordagem mais ampla, autônoma e orientada a objetivos da qual o agentic RAG é uma aplicação
- AI Agents - Os sistemas autônomos que tomam as decisões de recuperação no agentic RAG
- Agentic Workflows - Como processos de agentes em várias etapas são coordenados de ponta a ponta
- AI Orchestration - A coordenação de vários retrieval agents e ferramentas em sequência
- Bancos de dados vetoriais - A camada de armazenamento que a maioria dos retrieval agents consulta
- AI Memory - Como os sistemas de agentic RAG acompanham o contexto ao longo das rodadas de recuperação
- Alucinação de IA - O modo de falha que o ciclo de autocorreção do agentic RAG foi criado para detectar
Recursos externos
- Databricks: State of AI Enterprise Adoption and Growth Trends - Dados de adoção de RAG e de bancos de dados vetoriais
- Databricks: 2026 State of AI Agents - Crescimento dos sistemas multiagente e impacto da governança na implantação em produção
- Menlo Ventures: 2025 State of Generative AI in the Enterprise - Taxas de implantação de agentes de verdade em empresas e em startups
- Gartner: 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026 - Projeção de adoção de agentes nas empresas
- Gartner: Agentic AI Project Cancellations - Contexto de risco e governança para implantações agênticas
Parte da Coleção AI Terms. Última atualização: 2026-07-16

Co-Founder, Rework.com