¿Qué es Agentic RAG? Definición, arquitectura y en qué se diferencia del RAG tradicional
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Agentic RAG es la generación aumentada por recuperación (retrieval-augmented generation) controlada por un agente de IA en lugar de un pipeline fijo: el agente decide cuándo recuperar información, qué fuentes consultar, si la evidencia encontrada es suficientemente buena y si conviene buscar de nuevo antes de responder, en vez de ejecutar una sola búsqueda y generar una respuesta.
Ese único cambio, entregar las decisiones de recuperación a un sistema de razonamiento en lugar de a un script, explica por qué agentic RAG aparece en los problemas empresariales más difíciles: investigación sobre múltiples documentos, consultas de cumplimiento que afectan a varias políticas a la vez y tickets de soporte que exigen revisar un sistema y luego contrastar un segundo sistema con el primero.
Agentic RAG vs. RAG tradicional: qué cambia realmente
La Retrieval-Augmented Generation estándar sigue una secuencia fija: convierte la pregunta en un vector, extrae los fragmentos más coincidentes de una sola base de conocimiento, se los entrega al modelo y genera una respuesta. Es rápida y predecible, pero también frágil en cuanto una pregunta requiere más de una búsqueda.
Agentic RAG envuelve esa misma maquinaria de recuperación en un ciclo de razonamiento. Un agente de IA se sitúa frente al pipeline y toma tres decisiones que un pipeline estático no puede tomar:
- Cuándo recuperar. No toda pregunta necesita una búsqueda. Una pregunta aclaratoria sencilla quizá no la requiera, mientras que una pregunta con varias partes puede necesitar recuperación en cada paso, y no solo una vez al inicio.
- Qué recuperar y dónde. El agente puede elegir entre una base de datos vectorial, una tabla SQL, una API o una búsqueda web, y puede consultar más de una fuente cuando una sola base de conocimiento no responde la pregunta completa.
- Si la respuesta es suficientemente buena. Tras recuperar, el agente evalúa la evidencia. Si es escasa, contradictoria o irrelevante, reformula la consulta y vuelve a recuperar en lugar de generar una respuesta endeble a partir de evidencia débil.
Esa tercera decisión, la autocorrección, es la diferencia práctica que la mayoría de los equipos nota primero. Un sistema RAG tradicional que obtiene una mala recuperación inicial simplemente genera una mala respuesta con total seguridad. Un sistema agentic RAG puede darse cuenta de que la recuperación fue débil y probar otra consulta, otra fuente o dividir la pregunta en partes más pequeñas antes de generar la respuesta final.
La arquitectura detrás de Agentic RAG
Más allá del marketing de cada proveedor, los sistemas agentic RAG comparten un conjunto común de componentes, la mayoría conocidos del RAG estándar, más una capa de razonamiento encima.
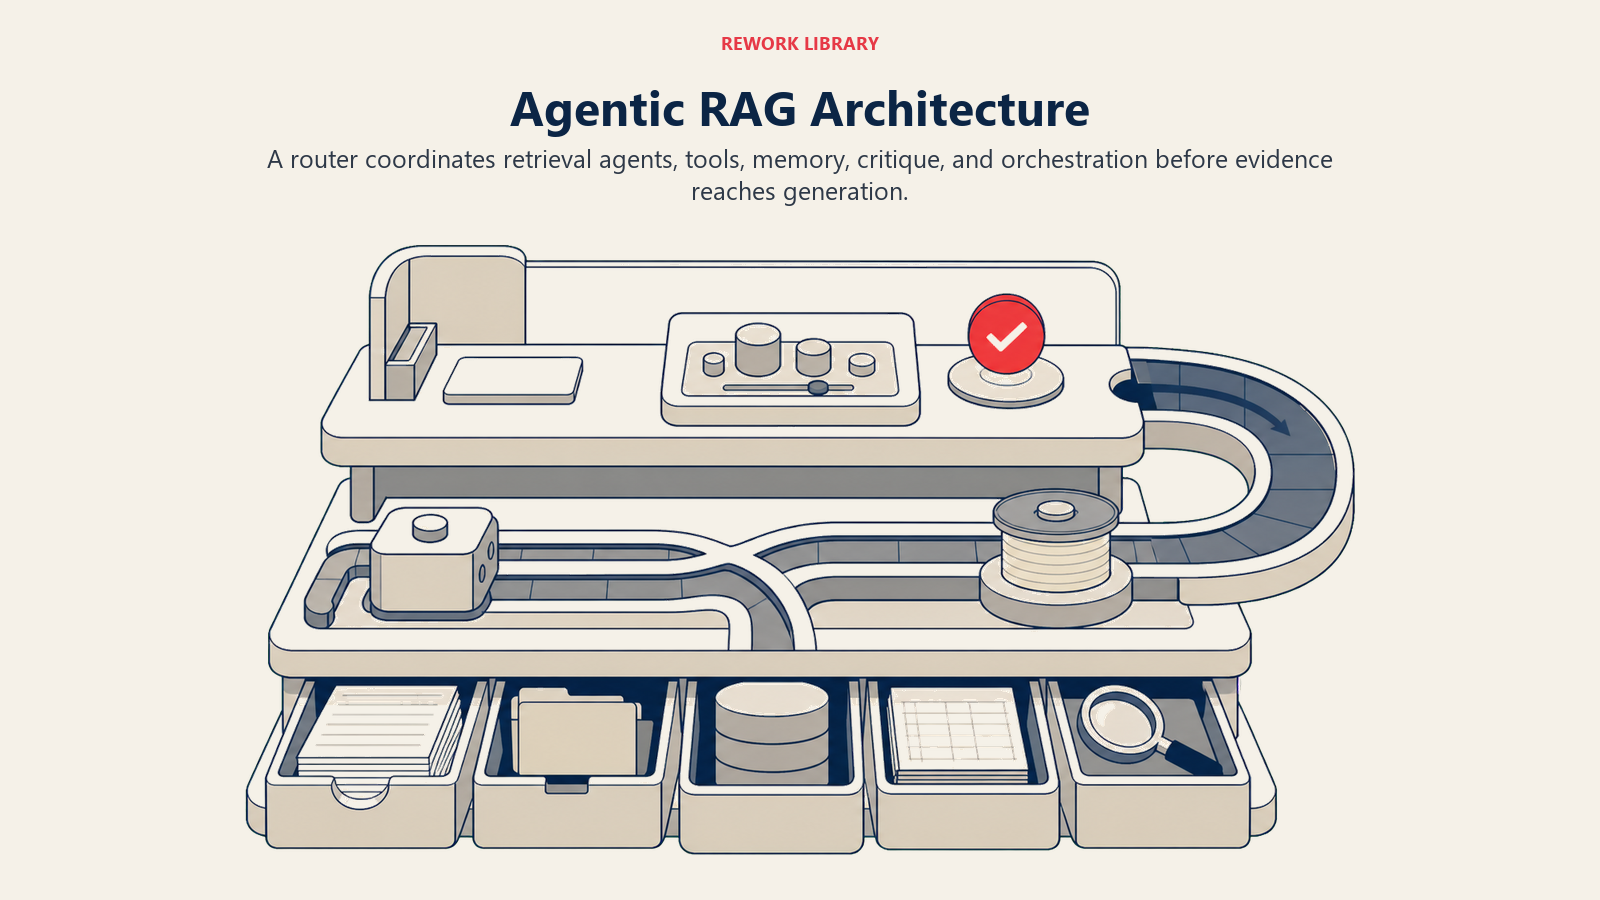
- Enrutador de consultas (query router): El primer punto de decisión. Clasifica la pregunta entrante y decide si necesita recuperación, qué fuente (o fuentes) consultar y si la pregunta debe dividirse antes en subpreguntas. Es la pieza que no existe en el RAG tradicional.
- Agentes de recuperación: Subagentes especializados, cada uno responsable de una fuente de conocimiento: un vector store de documentación de producto, una consulta de registros en el CRM, una búsqueda web en vivo, una consulta a una base de datos estructurada. El enrutador puede llamar a uno o a varios según la pregunta.
- Herramientas: Todo lo que el sistema puede invocar más allá de la búsqueda de texto: una calculadora para preguntas numéricas, un motor SQL para datos estructurados, una API de búsqueda web para eventos actuales. Consulte uso de herramientas para ver cómo funciona esto en general en los sistemas agénticos.
- Memoria: La memoria de trabajo guarda la pregunta actual y todo lo recuperado hasta ahora en la sesión. La memoria a largo plazo, a menudo respaldada por una base de datos vectorial, permite reutilizar recuperaciones previas o recordar qué funcionó en preguntas similares. Consulte memoria de IA para un desglose más completo.
- Ciclo de crítica y autocorrección: Tras cada recuperación, un paso de revisión (a veces el mismo modelo, a veces otro distinto) verifica si la evidencia recuperada realmente respalda una respuesta. Si no, activa otra ronda de recuperación con una consulta reformulada, hasta un límite establecido para que el sistema no entre en un bucle indefinido.
- Capa de orquestación: Coordina toda la secuencia: cuándo pasar el control entre agentes de recuperación, cuándo dejar de recuperar y generar, cuándo escalar a una persona. Se solapa en gran medida con la orquestación de IA en general y con los agentic workflows.
La búsqueda semántica y los embeddings siguen haciendo el trabajo pesado dentro de cada paso de recuperación. Agentic RAG no reemplaza esa maquinaria, decide cuándo y cómo apuntarla.
Agentic RAG vs. RAG estándar
| Aspecto | RAG estándar | Agentic RAG |
|---|---|---|
| Disparador de la recuperación | Se ejecuta siempre una vez, en cada consulta | El agente decide si, cuándo y cuántas veces recuperar |
| Selección de fuentes | Fija, normalmente una sola base de conocimiento | El agente elige entre varias fuentes, o consulta varias |
| Preguntas de varios pasos | Tiene dificultades, trata la pregunta como una sola búsqueda | Divide la pregunta en subpreguntas y recupera para cada una |
| Autocorrección | Ninguna, genera con lo que se haya recuperado | Evalúa la calidad de la evidencia y vuelve a recuperar si es débil |
| Uso de herramientas | Normalmente ninguna más allá de la búsqueda vectorial | Puede llamar a calculadoras, motores SQL, APIs y búsqueda web |
| Latencia y costo | Bajos, una sola pasada de recuperación | Mayores, varias pasadas de recuperación y razonamiento |
| Modo de fallo | Respuesta errónea y con total seguridad a partir de evidencia deficiente | Más lento, pero con mayor probabilidad de detectar o corregir una mala recuperación inicial |
| Mejor aplicación | Preguntas y respuestas sencillas sobre un conjunto de documentos único y bien acotado | Investigación multi-hop, preguntas entre sistemas, verificaciones de cumplimiento |
La conclusión práctica: el RAG estándar es la opción por defecto adecuada para búsquedas acotadas y bien definidas donde la velocidad y el costo importan más que manejar casos límite. Agentic RAG justifica su mayor latencia y costo en preguntas que realmente requieren más de una búsqueda o una segunda opinión sobre la evidencia.
Casos de uso empresariales reales de Agentic RAG en 2026
Investigación financiera: Los analistas hacen preguntas que abarcan a la vez múltiples informes regulatorios, llamadas de resultados y fuentes de datos de mercado. Un sistema agentic RAG revisa cada fuente, contrasta las cifras y avisa cuando dos fuentes discrepan, en lugar de elegir una en silencio.
Revisión legal y de cumplimiento: Una sola consulta de cumplimiento, "¿esta cláusula contractual entra en conflicto con nuestra política vigente de tratamiento de datos?", suele requerir contrastar entre sí el contrato, el documento de política y, en ocasiones, una referencia regulatoria. Agentic RAG recupera de los tres y verifica la coherencia antes de responder.
Escalamiento de soporte al cliente: Los sistemas de soporte dirigen una pregunta primero a la documentación del producto, luego a los datos específicos de la cuenta si la documentación no la responde del todo y, por último, a una persona si ninguna fuente la resuelve con confianza. Esa lógica de ramificación es exactamente para lo que están diseñados un enrutador de consultas y un ciclo de autocorrección.
Búsqueda técnica y de ingeniería: Los desarrolladores hacen preguntas que abarcan un código base, documentación interna e informes de incidentes pasados. Agentic RAG puede consultar los tres y conciliarlos, en lugar de devolver la fuente que haya quedado mejor posicionada en una única búsqueda vectorial.
Investigación de ventas y cuentas: Los representantes piden una visión completa de un prospecto: historial en el CRM, noticias recientes, datos firmográficos. Un sistema agentic RAG decide qué fuentes son relevantes para esa cuenta específica y omite las que no aportarán nada.
Beneficios y limitaciones
La arquitectura cambia una mayor probabilidad de encontrar y verificar la evidencia correcta por más piezas móviles en tiempo de ejecución.
Beneficios:
- Maneja preguntas multi-hop que necesitan evidencia de más de una fuente, donde el RAG estándar solo devuelve una respuesta parcial o incorrecta
- Detecta recuperaciones débiles o contradictorias antes de que se conviertan en una respuesta errónea dicha con total seguridad, lo que reduce el riesgo de alucinación
- Adapta qué fuente consulta en cada pregunta, en lugar de acudir siempre a la misma base de conocimiento fija
- Escala de forma natural a medida que se añaden más fuentes de conocimiento: el enrutador simplemente obtiene una opción más, no hay que reconstruir el pipeline
Limitaciones:
- Latencia y costo: Varias pasadas de recuperación y razonamiento tardan más y cuestan más por consulta que una búsqueda RAG de un solo paso. No todos los casos de uso pueden absorberlo.
- Más difícil de depurar: Cuando una respuesta de un RAG estático es incorrecta, la solución suele ser un solo fragmento defectuoso. Cuando es incorrecta una respuesta de agentic RAG, el fallo puede estar en el enrutador, en la recuperación, en el paso de crítica o en la generación final, lo que requiere más instrumentación para rastrearlo.
- Bucles de recuperación descontrolados: Sin un tope firme de intentos de recuperación, un ciclo de autocorrección puede seguir reconsultando ante una pregunta que realmente no tiene respuesta, en lugar de indicar que no dispone de evidencia suficiente.
- Sigue dependiendo de la calidad de las fuentes: Un agente que consulta tres fuentes malas en lugar de una sigue devolviendo una mala respuesta. Agentic RAG mejora cómo se toman las decisiones de recuperación, no la calidad de los datos subyacentes.
- Excesivo para búsquedas simples: Una pregunta de un solo dato sobre un conjunto de documentos limpio no necesita un enrutador, un ciclo de crítica ni orquestación multifuente. Ahí, el RAG estándar es la mejor opción.
Los puntos de control con Human-in-the-loop siguen siendo la principal salvaguarda en los despliegues de agentic RAG de alto riesgo, en particular en casos de cumplimiento y legales donde una respuesta incorrecta tiene consecuencias reales.
Datos clave
- El 70% de las empresas que usan IA generativa ahora incorporan herramientas, sistemas de recuperación y bases de datos vectoriales en lugar de depender solo de modelos de lenguaje listos para usar. Databricks
- La adopción de bases de datos vectoriales creció un 377% interanual, la categoría de más rápido crecimiento entre todas las tecnologías relacionadas con LLM analizadas. Databricks
- Las empresas pasaron de chatbots individuales a sistemas multiagente coordinados, que crecieron un 327% en menos de cuatro meses. Databricks
- Las empresas con gobernanza formal de IA llevaron a producción más de 12 veces más proyectos de IA que las que no la tienen. Databricks
- Solo el 16% de los despliegues de IA empresariales (27% en startups) califica como agentes verdaderos que planifican, ejecutan, observan la retroalimentación y se adaptan; la mayoría sigue siendo flujos de trabajo de secuencia fija o basados en enrutamiento. Menlo Ventures
- El 40% de las aplicaciones empresariales incluirá agentes de IA específicos para tareas a finales de 2026, frente a menos del 5% en 2025. Gartner
- Más del 40% de los proyectos de IA agéntica se cancelarán a finales de 2027 por costos crecientes, valor de negocio poco claro o controles de riesgo inadecuados, la misma falta de disciplina que hace tropezar a los despliegues ambiciosos de agentic RAG. Gartner
Preguntas frecuentes sobre Agentic RAG
¿Qué es agentic RAG en términos simples?
Agentic RAG es la generación aumentada por recuperación en la que un agente de IA, y no un script fijo, decide cuándo buscar, qué fuentes consultar y si la evidencia encontrada es suficientemente buena antes de responder. Si la primera recuperación se queda corta, el agente lo intenta de nuevo en lugar de generar a partir de evidencia débil.
¿En qué se diferencia agentic RAG del RAG tradicional?
El RAG tradicional ejecuta una sola pasada de recuperación por consulta contra una única base de conocimiento y genera una respuesta sin importar la calidad de la evidencia recuperada. Agentic RAG puede consultar varias fuentes, dividir una pregunta en subpreguntas, evaluar la evidencia que obtiene y volver a recuperar si es necesario.
¿Agentic RAG usa más de una fuente de conocimiento?
Sí, es una de sus ventajas principales. Un enrutador de consultas puede enviar distintas partes de una pregunta a distintas fuentes, un almacén de documentos, una base de datos, una API en vivo, y combinar lo que regresa, en lugar de quedar atado a una única base de conocimiento fija como el RAG estándar.
¿Qué es la autocorrección en agentic RAG?
Es el paso en el que el sistema verifica si la evidencia recuperada realmente respalda una respuesta antes de generarla. Si la evidencia es escasa o contradictoria, el agente reformula su consulta y recupera de nuevo en lugar de responder con información débil.
¿Agentic RAG es más lento y más caro que el RAG estándar?
En general sí. Varias pasadas de recuperación y razonamiento tardan más y cuestan más por consulta que una búsqueda de un solo paso. Esa contrapartida vale la pena en preguntas multi-hop o de alto riesgo, y normalmente no en búsquedas simples de un solo dato.
¿Para qué problemas de negocio es más adecuado agentic RAG?
Para preguntas que necesitan evidencia de más de una fuente: investigación financiera que abarca varios informes, verificaciones de cumplimiento que contrastan múltiples políticas, tickets de soporte que requieren revisar a la vez la documentación del producto y los datos de la cuenta, y búsqueda técnica en un código base y su documentación.
¿Cuáles son los principales riesgos de agentic RAG?
Bucles de recuperación descontrolados ante preguntas que realmente no tienen respuesta, una depuración más difícil porque una respuesta incorrecta puede originarse en el enrutador, en la recuperación o en el paso de crítica, y el hecho de que consultar más fuentes no corrige los datos defectuosos de origen.
¿Necesito agentic RAG o basta con el RAG estándar?
Si sus preguntas son acotadas y se pueden responder desde un conjunto de documentos bien delimitado, el RAG estándar es más rápido, más económico y más sencillo de mantener. Recurra a agentic RAG cuando las preguntas requieran con regularidad más de una búsqueda o una verificación contra varias fuentes antes de poder confiar en la respuesta.
Conceptos de IA relacionados
- Retrieval-Augmented Generation - La base de recuperación y generación sobre la que se construye agentic RAG
- ¿Qué es la IA agéntica? - El enfoque más amplio, autónomo y orientado a objetivos, del que agentic RAG es una aplicación
- Agentes de IA - Los sistemas autónomos que toman las decisiones de recuperación en agentic RAG
- Agentic Workflows - Cómo se coordinan de principio a fin los procesos de agentes de varios pasos
- Orquestación de IA - Coordinación en secuencia de múltiples agentes de recuperación y herramientas
- Bases de datos vectoriales - La capa de almacenamiento que consultan la mayoría de los agentes de recuperación
- Memoria de IA - Cómo los sistemas agentic RAG llevan el contexto a lo largo de las rondas de recuperación
- Alucinación de IA - El modo de fallo que el ciclo de autocorrección de agentic RAG está diseñado para detectar
Recursos externos
- Databricks: State of AI Enterprise Adoption and Growth Trends - Datos de adopción de RAG y bases de datos vectoriales
- Databricks: 2026 State of AI Agents - Crecimiento de sistemas multiagente e impacto de la gobernanza en el despliegue a producción
- Menlo Ventures: 2025 State of Generative AI in the Enterprise - Tasas de despliegue de agentes verdaderos en empresas frente a startups
- Gartner: 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026 - Pronóstico de adopción de agentes en la empresa
- Gartner: Agentic AI Project Cancellations - Contexto de riesgo y gobernanza para los despliegues agénticos
Parte de la Colección de términos de IA. Última actualización: 2026-07-16

Co-Founder, Rework.com