Was ist Agentic RAG? Definition, Architektur und Unterschied zu klassischem RAG
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Agentic RAG ist Retrieval-Augmented Generation, die von einem AI Agent statt von einer festen Pipeline gesteuert wird: Der Agent entscheidet, wann er Informationen abruft, welche Quellen er abfragt, ob die gefundene Evidenz ausreicht und ob er vor der Antwort noch einmal sucht, statt eine einzige Abfrage auszuführen und direkt eine Antwort zu generieren.
Genau diese eine Änderung, Abrufentscheidungen einem Reasoning-System statt einem Skript zu überlassen, ist der Grund, warum Agentic RAG bei den schwierigeren Enterprise-Problemen auftaucht: Recherchen über mehrere Dokumente, Compliance-Fragen, die mehrere Richtlinien gleichzeitig berühren, und Support-Tickets, bei denen erst ein System und dann ein zweites gegen das erste geprüft werden muss.
Agentic RAG vs. klassisches RAG: Was sich tatsächlich ändert
Standardmäßiges Retrieval-Augmented Generation folgt einer festen Abfolge: Die Frage wird in einen Vektor umgewandelt, die am besten passenden Chunks werden aus einer Wissensbasis gezogen, an das Modell übergeben, und daraus wird eine Antwort generiert. Das ist schnell und vorhersehbar, aber auch brüchig, sobald eine Frage mehr als eine Abfrage erfordert.
Agentic RAG hüllt dieselbe Retrieval-Technik in eine Reasoning-Schleife. Ein AI Agent sitzt vor der Pipeline und trifft drei Entscheidungen, zu denen eine statische Pipeline nicht fähig ist:
- Wann abgerufen wird. Nicht jede Frage braucht eine Abfrage. Eine einfache Rückfrage kommt vielleicht ohne aus, während eine mehrteilige Frage bei jedem Schritt einen Abruf braucht, nicht nur einmal am Anfang.
- Was und wo abgerufen wird. Der Agent kann zwischen einer Vektordatenbank, einer SQL-Tabelle, einer API oder einer Websuche wählen und mehr als eine Quelle abfragen, wenn eine einzelne Wissensbasis die Frage nicht vollständig beantwortet.
- Ob die Antwort gut genug ist. Nach dem Abruf bewertet der Agent die Evidenz. Ist sie dünn, widersprüchlich oder am Thema vorbei, formuliert der Agent die Anfrage um und ruft erneut ab, statt aus schwacher Evidenz eine wackelige Antwort zu generieren.
Diese dritte Entscheidung, die Selbstkorrektur, ist der praktische Unterschied, der Teams meist zuerst auffällt. Ein klassisches RAG-System, das zunächst schlecht abruft, generiert einfach selbstsicher eine schlechte Antwort. Ein Agentic-RAG-System kann bemerken, dass der Abruf schwach war, und eine andere Anfrage, eine andere Quelle ausprobieren oder die Frage in kleinere Teile zerlegen, bevor es überhaupt eine endgültige Antwort generiert.
Die Architektur hinter Agentic RAG
Lässt man das Vendor-Branding weg, teilen Agentic-RAG-Systeme einen gemeinsamen Satz an Bausteinen, die meisten davon vertraut aus Standard-RAG, ergänzt um eine Reasoning-Schicht obendrauf.
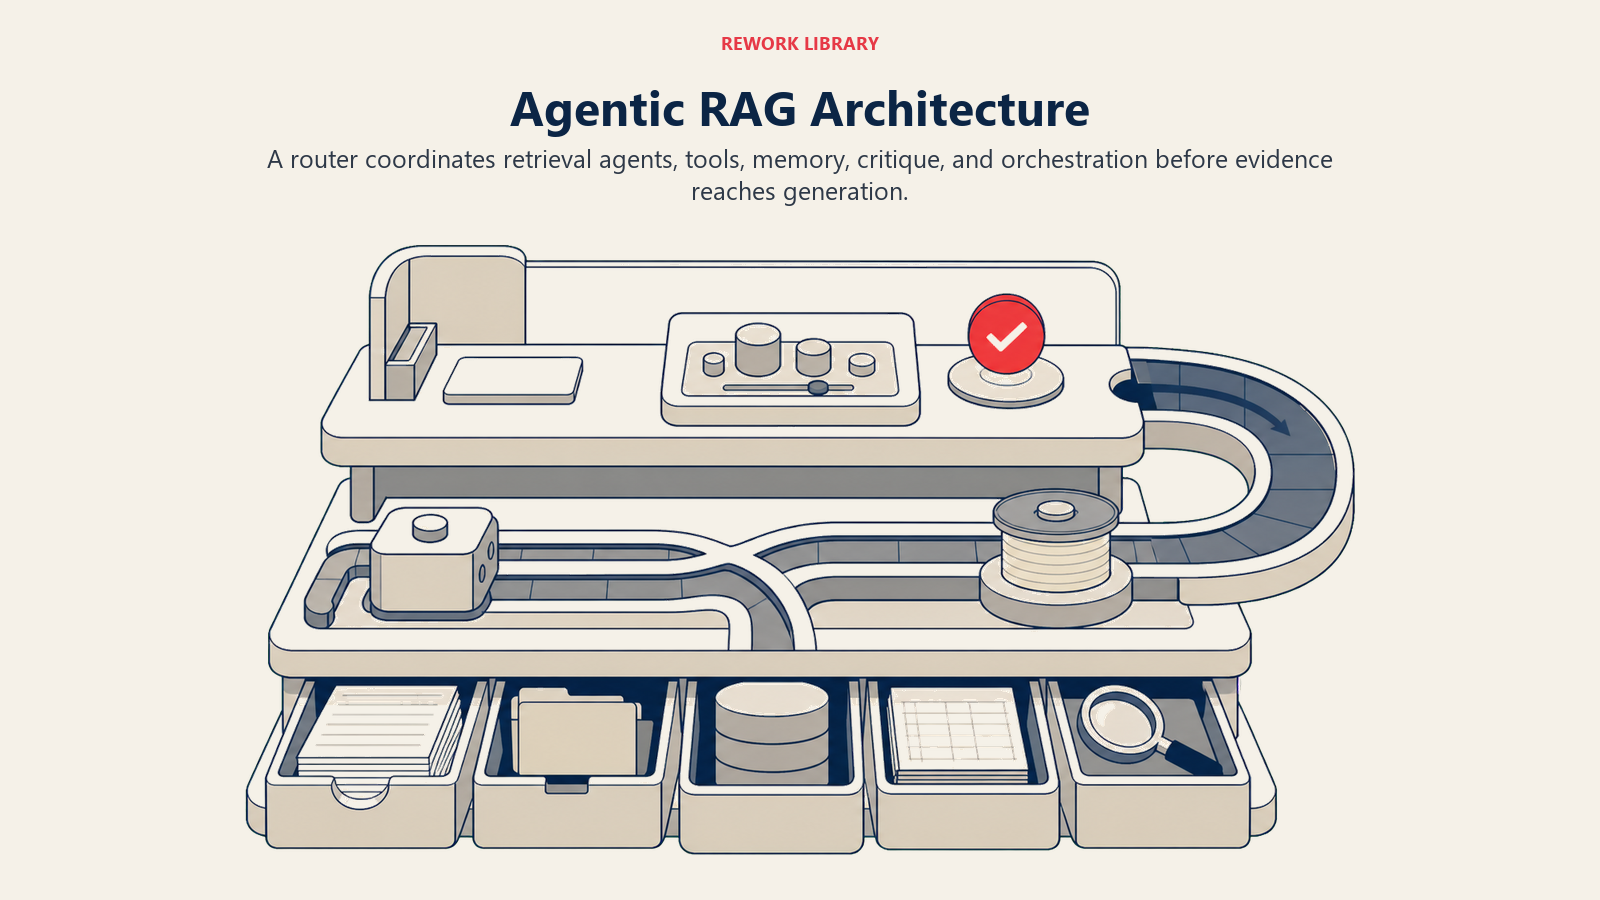
- Query Router: Der erste Entscheidungspunkt. Er klassifiziert die eingehende Frage und entscheidet, ob überhaupt ein Abruf nötig ist, welche Quelle (oder Quellen) abgefragt werden und ob die Frage zuerst in Teilfragen zerlegt werden sollte. Dieser Baustein existiert im klassischen RAG nicht.
- Retrieval Agents: Spezialisierte Sub-Agents, die jeweils für eine Wissensquelle zuständig sind: ein Vector Store mit Produktdokumentation, eine Abfrage von CRM-Datensätzen, eine Live-Websuche, eine strukturierte Datenbankabfrage. Der Router kann je nach Frage einen oder mehrere aufrufen.
- Tools: Alles, was das System über die Textsuche hinaus aufrufen kann: ein Taschenrechner für numerische Fragen, eine SQL-Engine für strukturierte Daten, eine Websuche-API für aktuelle Ereignisse. Wie das in agentischen Systemen allgemein funktioniert, erklärt Tool Use.
- Memory: Das Arbeitsgedächtnis hält die aktuelle Frage und alles, was in dieser Sitzung bisher abgerufen wurde. Ein Langzeitgedächtnis, oft auf Basis einer Vektordatenbank, erlaubt dem System, frühere Abrufe wiederzuverwenden oder sich zu merken, was bei ähnlichen Fragen funktioniert hat. Die ausführliche Aufschlüsselung finden Sie unter AI Memory.
- Kritik- und Selbstkorrekturschleife: Nach jedem Abruf prüft ein Review-Schritt (manchmal dasselbe Modell, manchmal ein separates), ob die abgerufene Evidenz tatsächlich eine Antwort stützt. Falls nicht, löst er eine weitere Abrufrunde mit umformulierter Anfrage aus, bis zu einem festgelegten Limit, damit das System nicht endlos kreist.
- Orchestrierungsschicht: Koordiniert die gesamte Abfolge: wann zwischen Retrieval Agents übergeben wird, wann das Abrufen endet und die Generierung beginnt, wann an einen Menschen eskaliert wird. Das überschneidet sich stark mit allgemeiner AI Orchestration und Agentic Workflows.
Semantic Search und Embeddings leisten innerhalb jedes Abrufschritts weiterhin die Hauptarbeit. Agentic RAG ersetzt diese Technik nicht, sondern entscheidet, wann und wie sie eingesetzt wird.
Agentic RAG vs. Standard-RAG
| Aspekt | Standard-RAG | Agentic RAG |
|---|---|---|
| Auslöser des Abrufs | Läuft bei jeder Anfrage genau einmal | Der Agent entscheidet, ob, wann und wie oft abgerufen wird |
| Quellenauswahl | Fest, meist eine Wissensbasis | Der Agent wählt unter mehreren Quellen oder fragt mehrere ab |
| Mehrstufige Fragen | Schwierig, behandelt die Frage als eine einzige Abfrage | Zerlegt die Frage in Teilfragen und ruft für jede ab |
| Selbstkorrektur | Keine, generiert aus allem, was abgerufen wurde | Bewertet die Qualität der Evidenz und ruft bei Schwäche erneut ab |
| Tool Use | In der Regel nichts jenseits der Vektorsuche | Kann Taschenrechner, SQL-Engines, APIs und Websuche aufrufen |
| Latenz und Kosten | Niedrig, ein Abrufdurchlauf | Höher, mehrere Abruf- und Reasoning-Durchläufe |
| Fehlermodus | Selbstbewusst falsche Antwort aus schlechter Evidenz | Langsamer, aber eher in der Lage, einen schlechten ersten Abruf zu erkennen oder zu beheben |
| Beste Eignung | Einfache Q&A über einen einzelnen, klar abgegrenzten Dokumentenbestand | Multi-Hop-Recherche, systemübergreifende Fragen, Compliance-Prüfungen |
Die praktische Erkenntnis: Standard-RAG ist die richtige Wahl für enge, klar abgegrenzte Abfragen, bei denen Geschwindigkeit und Kosten wichtiger sind als der Umgang mit Sonderfällen. Agentic RAG rechtfertigt seine zusätzliche Latenz und seine Kosten bei Fragen, die wirklich mehr als eine Abfrage oder eine zweite Meinung zur Evidenz brauchen.
Reale Enterprise-Use-Cases für Agentic RAG 2026
Finanzrecherche: Analysten stellen Fragen, die mehrere Berichte, Earnings Calls und Marktdaten-Feeds zugleich betreffen. Ein Agentic-RAG-System prüft jede Quelle, gleicht Zahlen ab und meldet, wenn zwei Quellen sich widersprechen, statt stillschweigend eine auszuwählen.
Rechts- und Compliance-Prüfung: Eine einzelne Compliance-Frage, etwa „Steht diese Vertragsklausel im Widerspruch zu unserer aktuellen Datenverarbeitungsrichtlinie?“, erfordert oft, dass der Vertrag, das Richtliniendokument und manchmal eine regulatorische Referenz gegeneinander geprüft werden. Agentic RAG ruft aus allen dreien ab und verifiziert die Konsistenz, bevor es antwortet.
Eskalation im Kundensupport: Support-Systeme leiten eine Frage zuerst an die Produktdokumentation, dann an kontospezifische Daten weiter, falls die Dokumentation sie nicht vollständig beantwortet, und schließlich an einen Menschen, wenn keine der beiden Quellen sie sicher löst. Genau für diese Verzweigungslogik sind Query Router und Selbstkorrekturschleife gebaut.
Technische und Engineering-Suche: Entwickler stellen Fragen, die eine Codebasis, interne Dokumentation und frühere Incident-Berichte umfassen. Agentic RAG kann alle drei abfragen und abgleichen, statt die Quelle zurückzugeben, die bei einer einzelnen Vektorsuche zufällig am höchsten rankt.
Vertriebs- und Account-Recherche: Vertriebsmitarbeitende wollen ein vollständiges Bild eines Prospects: CRM-Historie, aktuelle News, Firmographics. Ein Agentic-RAG-System entscheidet, welche Quellen für genau diesen Account relevant sind, und überspringt jene, die nichts beitragen würden.
Vorteile und Grenzen
Die Architektur tauscht eine bessere Chance, die richtige Evidenz zu finden und zu prüfen, gegen mehr bewegliche Teile zur Laufzeit.
Vorteile:
- Bewältigt Multi-Hop-Fragen, die Evidenz aus mehr als einer Quelle brauchen, bei denen Standard-RAG nur eine unvollständige oder falsche Antwort liefert
- Erkennt schwache oder widersprüchliche Abrufe, bevor sie zu einer selbstbewusst falschen Antwort werden, und senkt so das Risiko von Halluzinationen
- Passt pro Frage an, welche Quelle abgefragt wird, statt immer dieselbe feste Wissensbasis anzusprechen
- Skaliert natürlich mit, wenn weitere Wissensquellen hinzukommen: Der Router bekommt einfach eine Option mehr, keine neu gebaute Pipeline
Grenzen:
- Latenz und Kosten: Mehrere Abruf- und Reasoning-Durchläufe dauern länger und kosten pro Anfrage mehr als eine einmalige RAG-Abfrage. Nicht jeder Use Case kann das verkraften.
- Schwieriger zu debuggen: Ist eine statische RAG-Antwort falsch, liegt die Ursache meist in einem schlechten Chunk. Ist eine Agentic-RAG-Antwort falsch, kann der Fehler im Router, im Abruf, im Kritikschritt oder in der finalen Generierung liegen, was mehr Instrumentierung zum Nachverfolgen erfordert.
- Endlose Abrufschleifen: Ohne feste Obergrenze für Abrufversuche kann eine Selbstkorrekturschleife bei einer wirklich unbeantwortbaren Frage immer weiter abfragen, statt zu melden, dass die Evidenz nicht ausreicht.
- Weiterhin abhängig von der Quellenqualität: Ein Agent, der drei schlechte statt einer schlechten Quelle abfragt, liefert trotzdem eine schlechte Antwort. Agentic RAG verbessert, wie Abrufentscheidungen getroffen werden, nicht die zugrunde liegende Datenqualität.
- Überdimensioniert für einfache Abfragen: Eine Einzelfaktenfrage über einen sauberen Dokumentenbestand braucht keinen Router, keine Kritikschleife und keine Multi-Source-Orchestrierung. Standard-RAG passt dort besser.
Human-in-the-Loop-Checkpoints bleiben die wichtigste Absicherung bei Agentic-RAG-Deployments mit hohem Risiko, insbesondere bei Compliance- und Rechts-Use-Cases, in denen eine falsche Antwort reale Konsequenzen hat.
Wichtige Fakten
- 70 % der Unternehmen, die Generative AI nutzen, ergänzen inzwischen Tools, Retrieval-Systeme und Vektordatenbanken, statt sich allein auf Standard-Sprachmodelle zu verlassen. Databricks
- Die Nutzung von Vektordatenbanken wuchs im Jahresvergleich um 377 % und war damit die am schnellsten wachsende Kategorie aller erfassten LLM-bezogenen Technologien. Databricks
- Unternehmen wechselten von einzelnen Chatbots zu koordinierten Multi-Agent-Systemen, die in weniger als vier Monaten um 327 % zulegten. Databricks
- Unternehmen mit formaler AI Governance brachten mehr als 12-mal so viele AI-Projekte in den Produktivbetrieb wie solche ohne. Databricks
- Nur 16 % der Enterprise-AI-Deployments (27 % bei Startups) sind echte Agents, die planen, ausführen, Feedback beobachten und sich anpassen; die meisten sind weiterhin Workflows mit fester Abfolge oder Routing. Menlo Ventures
- 40 % der Unternehmensanwendungen werden bis Ende 2026 aufgabenspezifische AI Agents enthalten, gegenüber weniger als 5 % im Jahr 2025. Gartner
- Über 40 % der Agentic-AI-Projekte werden bis Ende 2027 wegen steigender Kosten, unklaren Geschäftsnutzens oder unzureichender Risikokontrollen eingestellt, dieselbe Disziplinlücke, an der auch ehrgeizige Agentic-RAG-Rollouts scheitern. Gartner
Häufig gestellte Fragen zu Agentic RAG
Was ist Agentic RAG in einfachen Worten?
Agentic RAG ist Retrieval-Augmented Generation, bei der ein AI Agent statt eines festen Skripts entscheidet, wann gesucht wird, welche Quellen durchsucht werden und ob die gefundene Evidenz vor der Antwort gut genug ist. Reicht der erste Abruf nicht aus, versucht es der Agent erneut, statt aus schwacher Evidenz zu generieren.
Wie unterscheidet sich Agentic RAG von klassischem RAG?
Klassisches RAG führt pro Anfrage einen Abrufdurchlauf gegen eine einzelne Wissensbasis aus und generiert eine Antwort, unabhängig davon, wie gut die abgerufene Evidenz ist. Agentic RAG kann mehrere Quellen abfragen, eine Frage in Teilfragen zerlegen, die zurückgelieferte Evidenz bewerten und bei Bedarf erneut abrufen.
Nutzt Agentic RAG mehr als eine Wissensquelle?
Ja, das ist einer der Kernvorteile. Ein Query Router kann verschiedene Teile einer Frage an verschiedene Quellen schicken, etwa einen Dokumentenspeicher, eine Datenbank oder eine Live-API, und die Ergebnisse zusammenführen, statt wie Standard-RAG an eine feste Wissensbasis gebunden zu sein.
Was ist Selbstkorrektur bei Agentic RAG?
Das ist der Schritt, in dem das System prüft, ob die abgerufene Evidenz tatsächlich eine Antwort stützt, bevor es eine generiert. Ist die Evidenz dünn oder widersprüchlich, formuliert der Agent seine Anfrage um und ruft erneut ab, statt aus schwachen Informationen zu antworten.
Ist Agentic RAG langsamer und teurer als Standard-RAG?
In der Regel ja. Mehrere Abruf- und Reasoning-Durchläufe dauern länger und kosten pro Anfrage mehr als eine einmalige Abfrage. Dieser Kompromiss lohnt sich bei Multi-Hop-Fragen oder Fragen mit hohem Risiko, bei einfachen Einzelfaktenabfragen meist nicht.
Für welche Geschäftsprobleme eignet sich Agentic RAG am besten?
Für Fragen, die Evidenz aus mehr als einer Quelle brauchen: Finanzrecherche über mehrere Berichte, Compliance-Prüfungen, die mehrere Richtlinien abgleichen, Support-Tickets, bei denen Produktdokumentation und Kontodaten gemeinsam geprüft werden müssen, und technische Suche über eine Codebasis und ihre Dokumentation.
Was sind die wichtigsten Risiken von Agentic RAG?
Endlose Abrufschleifen bei wirklich unbeantwortbaren Fragen, schwierigeres Debugging, weil eine falsche Antwort auf den Router, den Abruf oder den Kritikschritt zurückgehen kann, und die Tatsache, dass mehr Quellen schlechte Quelldaten nicht von selbst beheben.
Brauche ich Agentic RAG, oder reicht Standard-RAG?
Sind Ihre Fragen eng gefasst und aus einem klar abgegrenzten Dokumentenbestand beantwortbar, ist Standard-RAG schneller, günstiger und einfacher zu pflegen. Greifen Sie zu Agentic RAG, wenn Fragen regelmäßig mehr als eine Abfrage oder einen Abgleich mit mehreren Quellen erfordern, bevor Sie der Antwort vertrauen würden.
Verwandte AI-Konzepte
- Retrieval-Augmented Generation - Das Fundament aus Abruf und Generierung, auf dem Agentic RAG aufbaut
- Was ist Agentic AI? - Der breitere autonome, zielgerichtete Ansatz, dessen Anwendung Agentic RAG ist
- AI Agents - Die autonomen Systeme, die bei Agentic RAG die Abrufentscheidungen treffen
- Agentic Workflows - Wie mehrstufige Agent-Prozesse von Anfang bis Ende koordiniert werden
- AI Orchestration - Die Koordination mehrerer Retrieval Agents und Tools in Sequenz
- Vektordatenbanken - Die Speicherschicht, gegen die die meisten Retrieval Agents abfragen
- AI Memory - Wie Agentic-RAG-Systeme Kontext über Abrufrunden hinweg verfolgen
- AI Hallucination - Der Fehlermodus, den die Selbstkorrekturschleife von Agentic RAG abfangen soll
Externe Ressourcen
- Databricks: State of AI Enterprise Adoption and Growth Trends - Daten zur Nutzung von RAG und Vektordatenbanken
- Databricks: 2026 State of AI Agents - Wachstum von Multi-Agent-Systemen und Einfluss von Governance auf den Produktivbetrieb
- Menlo Ventures: 2025 State of Generative AI in the Enterprise - Anteil echter Agent-Deployments in Unternehmen und Startups
- Gartner: 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026 - Prognose zur Verbreitung von Agents in Unternehmen
- Gartner: Agentic AI Project Cancellations - Risiko- und Governance-Kontext für Agentic Deployments
Teil der AI-Terms-Sammlung. Zuletzt aktualisiert: 2026-07-16
