¿Qué es la Infraestructura de IA?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Actualizado en julio de 2026
La infraestructura de IA es la pila tecnológica completa que una empresa necesita para construir, implementar y ejecutar modelos de IA: las GPU y la capacidad en la nube que proporcionan el cómputo, los pipelines que alimentan los datos, la capa de modelo que realiza el razonamiento, y las herramientas de orquestación y observabilidad que mantienen todo funcionando de forma confiable una vez que usuarios reales dependen de ello.
La mayoría de los ejecutivos solo se topan con esta pila de forma indirecta, como una línea en la factura de la nube o en la lista de espera de capacidad de un proveedor. Pero cada función de IA que su empresa usa, un chatbot, un modelo de pronóstico, un copiloto integrado en su CRM, se ejecuta en alguna versión de esta pila en algún lugar. Saber qué contiene realmente facilita mucho leer los precios de un proveedor, evaluar una propuesta de build vs buy, o hacer la pregunta correcta cuando un proyecto interno de IA se estanca.
Las Capas de la Pila de Infraestructura de IA
La infraestructura de IA no es un solo producto que se compra. Es un conjunto de capas apiladas unas sobre otras, y un eslabón débil en cualquiera de ellas ralentiza o rompe todo lo que está por encima.
| Capa | Qué Hace | Ejemplos Comunes |
|---|---|---|
| Cómputo / Hardware | Ejecuta las operaciones matriciales reales detrás del entrenamiento y la ejecución de modelos | GPU Nvidia H100, H200 y de la generación Blackwell, aceleradores AMD serie MI, TPU de Google, silicio personalizado de los hyperscalers |
| Nube y Redes | Aprovisiona capacidad de GPU y conecta miles de chips en un solo clúster funcional | AWS, Azure, Google Cloud, nubes de GPU especializadas como CoreWeave, fabrics de alta velocidad como NVLink e InfiniBand |
| Pipeline de Datos | Recopila, limpia y mueve los datos para que los modelos tengan de dónde aprender o recuperar información al momento de responder | Herramientas de ETL y pipeline de datos, feature stores, bases de datos vectoriales |
| Capa de Modelo | El modelo entrenado que realmente razona sobre la entrada | Foundation models, large language models, variantes ajustadas (fine-tuned) o de peso abierto (open-weight) |
| Model Serving | Implementa un modelo entrenado para que pueda responder solicitudes reales a escala de producción | Plataformas de Model Serving, API gateways, enrutadores de modelos (model routers) que envían las consultas sencillas a modelos económicos y las difíciles a modelos frontier |
| Orquestación | Coordina flujos de trabajo de varios pasos, llamadas a herramientas (tool calls) y el pipeline que despliega un cambio de modelo de forma segura | Pipelines de MLOps y LLMOps, frameworks de workflow y de agentes |
| Observabilidad | Rastrea el costo, la latencia, la calidad y el drift una vez que un modelo está en producción | Plataformas de observabilidad de IA y monitoreo de modelos (Model Monitoring), herramientas de logging y tracing |
El punto práctico es este: una empresa puede tener GPU de clase mundial y aun así lanzar una función de IA rota si su pipeline de datos alimenta al modelo con información obsoleta, o si nadie vigila la latencia y el costo una vez que el tráfico escala. Cada capa tiene que sostenerse para que la capa de arriba funcione.
Infraestructura de IA vs un Centro de Datos de IA
Los dos términos se usan indistintamente, pero no son lo mismo. Un centro de datos de IA es la instalación física, el edificio, la subestación eléctrica, la planta de refrigeración líquida, que alberga las GPU. La infraestructura de IA es más amplia: incluye esa capa de hardware, pero también los servicios en la nube, los pipelines de datos, la capa de modelo, la orquestación y las herramientas de observabilidad que se sitúan encima de ella, sin importar dónde se ejecuten.
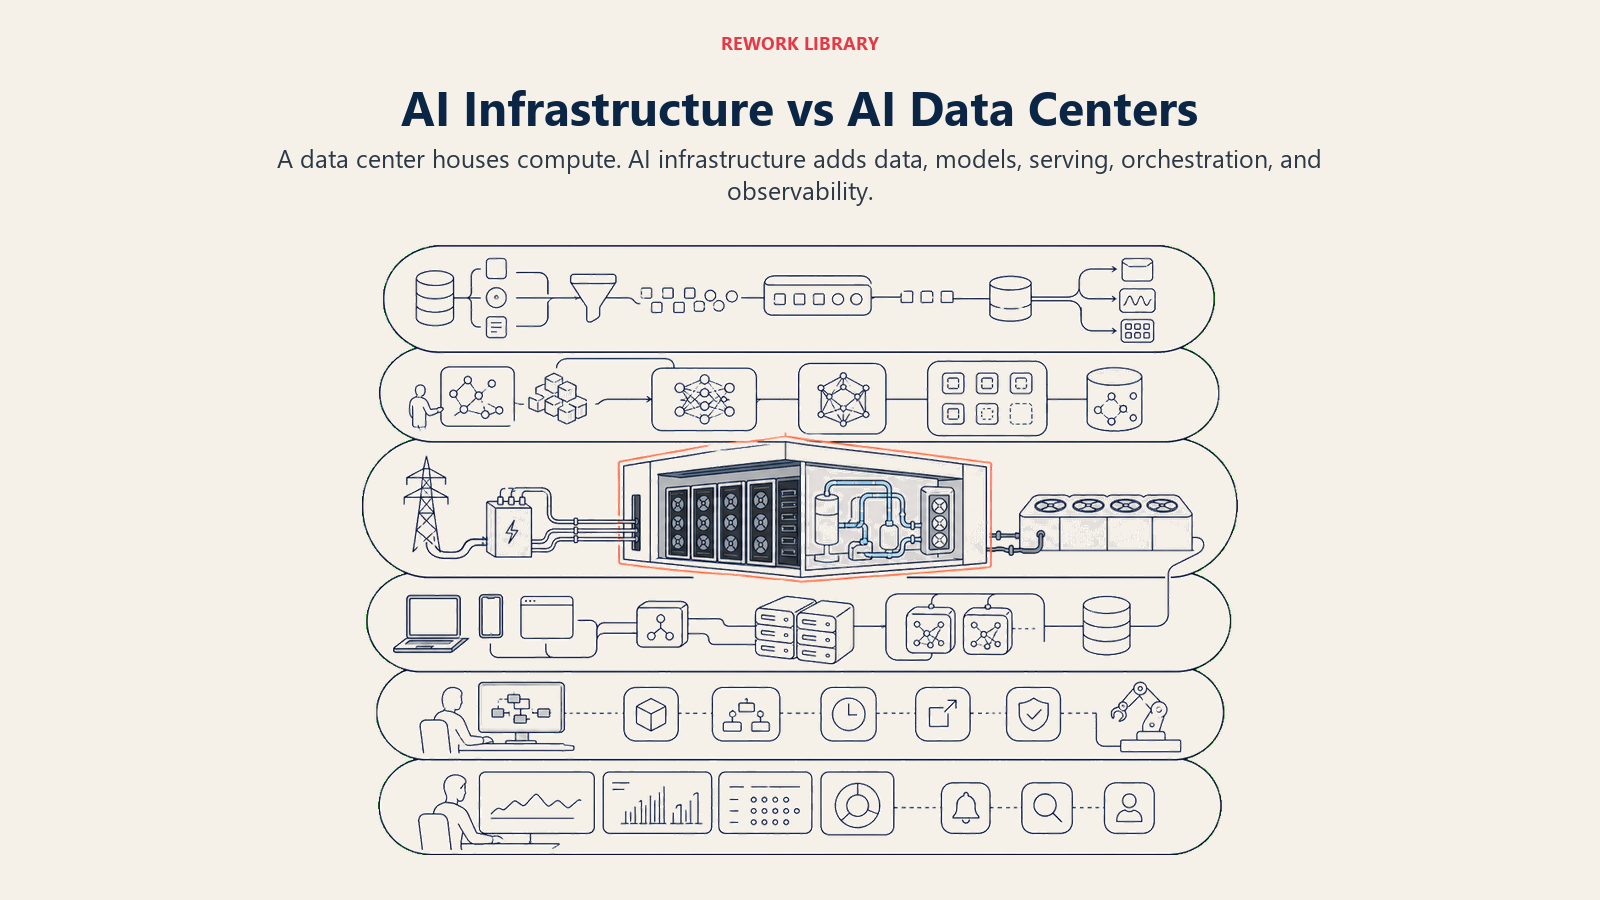
En pocas palabras, un centro de datos de IA es una capa (cómputo y hardware) dentro de la pila de infraestructura de IA más grande. Una empresa puede alquilar capacidad de GPU en el centro de datos de otra compañía y aun así ser propietaria de todas las demás capas de su infraestructura de IA, sus pipelines de datos, sus decisiones de modelo, su configuración de serving y orquestación, sin construir jamás una instalación propia. Esa distinción importa cuando un proveedor afirma que "funciona sobre infraestructura de IA": el hardware suele ser la parte fácil de señalar, y el trabajo más difícil y diferenciado es todo lo que se construye alrededor de él.
Build vs Buy: Cómo las Empresas Realmente Arman la Pila
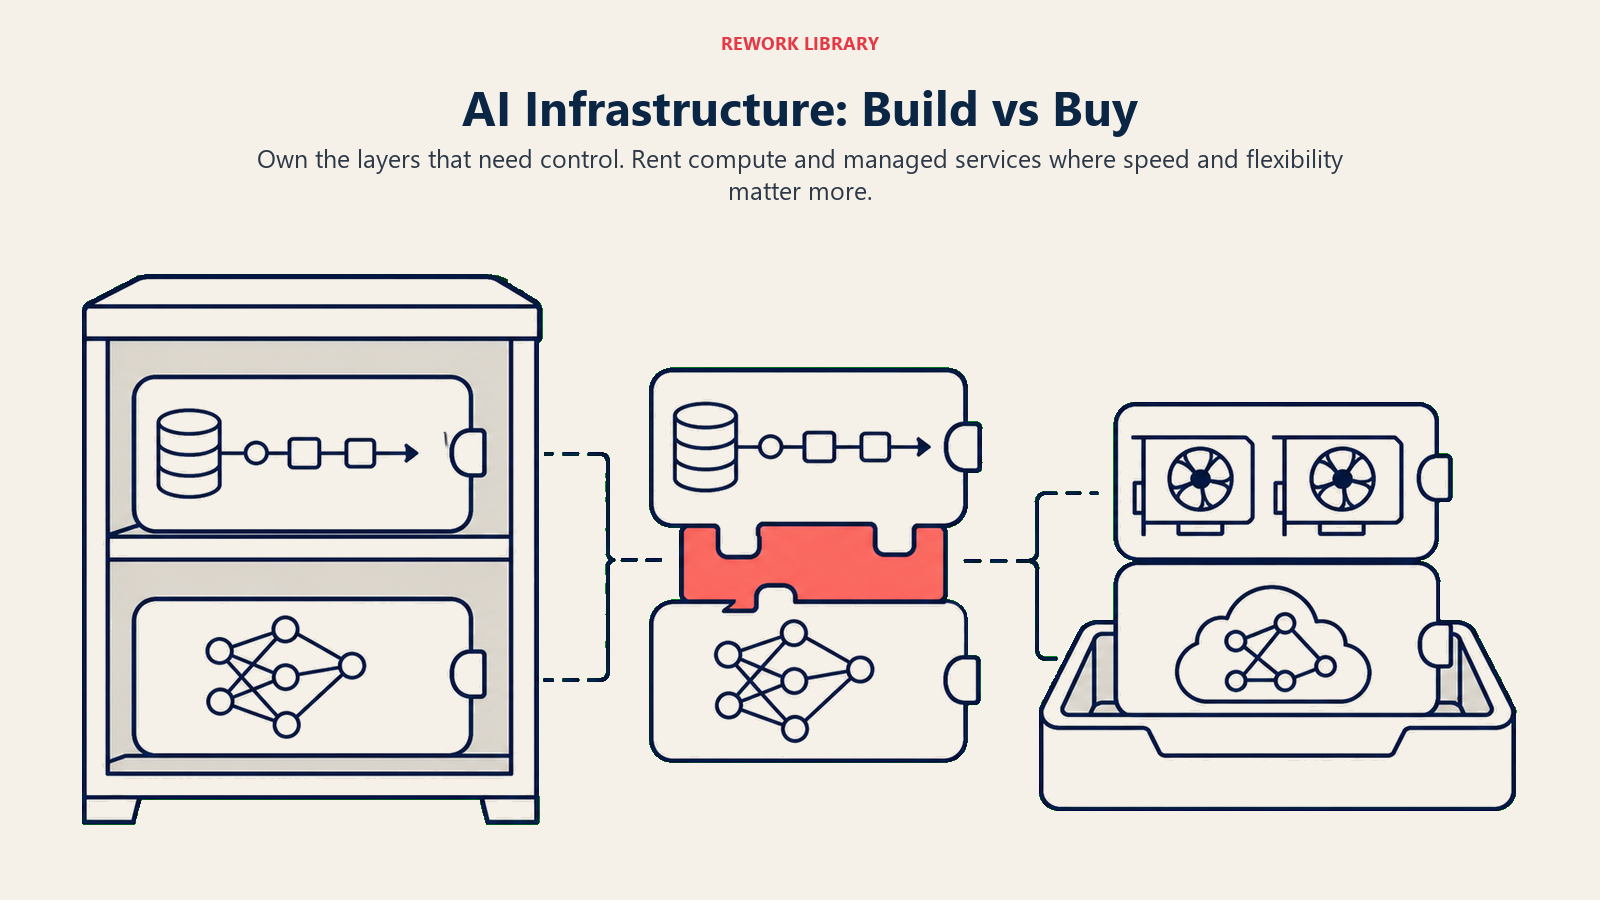
Casi ninguna empresa construye cada capa desde cero. La decisión real es qué capas poseer y cuáles alquilar, y esa elección se ve distinta en cada capa de la pila.
| Enfoque | Qué Posee | Mejor Encaje |
|---|---|---|
| API totalmente gestionada (proveedor del modelo) | Nada por debajo de la propia llamada al modelo | Equipos ágiles que necesitan una capacidad ya mismo y no necesitan tocar los pesos del modelo ni el hardware |
| GPU en la nube gestionada | Su pipeline de datos, decisiones de modelo, configuración de serving, cómputo alquilado | Equipos que hacen fine-tuning o alojan modelos open-weight por su cuenta sin poseer hardware |
| Colocation o on-premises | Todo, incluido el hardware físico | Industrias reguladas, cargas de trabajo sensibles a la latencia, o un uso sostenido lo bastante alto como para que poseer supere a alquilar |
Alquilar cómputo de un proveedor de nube o llamar a una API de modelo es la opción correcta por defecto para casi cualquier empresa: evita el desembolso de capital, el costo de construir un centro de datos de IA y el personal especializado que exige poseer hardware. La decisión de build vs buy en IA casi nunca es "construir un centro de datos o no", sino "sobre qué capas de la pila necesitamos control directo, y cuáles podemos alquilar con seguridad". Una buena prueba de sentido común antes de firmar con cualquier proveedor: haga una evaluación de proveedores adecuada que pregunte qué pasa con su pipeline de datos y sus decisiones de modelo si ese proveedor cambia sus precios o su hoja de ruta.
Qué Impulsa los Costos de la Infraestructura de IA
Un puñado de factores explica la mayor parte de la diferencia entre una factura de infraestructura de IA ajustada y una que se dispara.
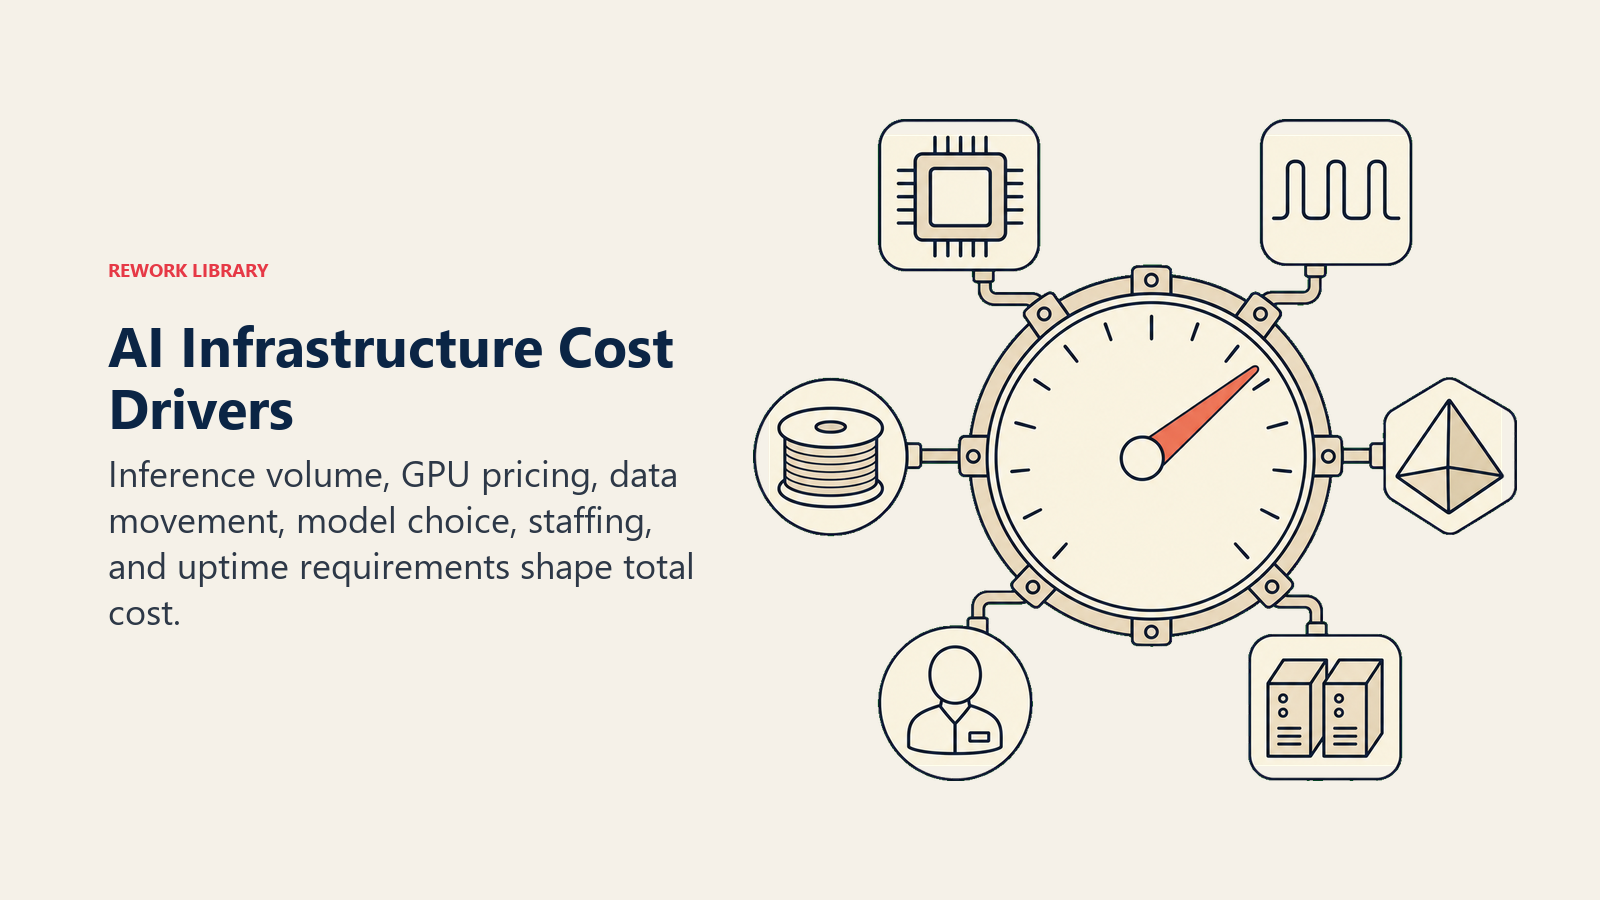
- Escasez y precio de las GPU. La demanda de GPU de clase frontier todavía supera regularmente a la oferta, y esa escasez se traslada directamente a lo que cobran los proveedores de nube por el cómputo.
- Volumen de inferencia, no de entrenamiento. La mayoría de las empresas nunca entrena un modelo desde cero. Su factura está impulsada por la inferencia, el costo continuo de cada consulta que responde un modelo en producción, que escala directamente con el uso en lugar de aparecer como un costo único.
- Movimiento y almacenamiento de datos. Alimentar a un modelo, especialmente uno que hace retrieval sobre datos de la empresa, implica almacenar y mover datos repetidamente, y las tarifas de egress de la nube se acumulan rápido a escala.
- Elección del modelo. Un modelo frontier cuesta más por token que un modelo más pequeño, destilado o comprimido por quantization que ha sido optimizado para hacer el mismo trabajo por menos.
- Personal. Alguien tiene que hacerse cargo de las capas de orquestación y observabilidad. El talento de MLOps y LLMOps es escaso, y la plantilla operativa necesaria para ejecutar la infraestructura de IA de forma confiable es una línea de costo real y continua que la mayoría de las comparaciones de build vs buy subestima.
- Requisitos de redundancia y tiempo de actividad. Una función de IA de cara al cliente que no puede fallar cuesta más operar que una herramienta interna que tolera fallos ocasionales, porque la redundancia significa pagar por capacidad que no siempre se usa.
Cualquier modelo serio de costo total de propiedad de IA tiene que contemplar los seis factores, no solo el precio de etiqueta de una hora de GPU.
El Panorama de la Infraestructura de IA en 2026
Tres cosas son ciertas sobre el gasto en infraestructura de IA en este momento, y las tres afectan lo que su empresa paga por IA.
El gasto todavía crece con rapidez. Gartner proyecta que el gasto global en TI alcanzará los $6.15 billones en 2026, casi un 11% más interanual, con el gasto en sistemas de centros de datos cruzando por sí solo los $650 mil millones, frente a poco menos de $500 mil millones el año anterior. Los cuatro mayores hyperscalers estadounidenses, Amazon, Alphabet, Microsoft y Meta, proyectaron en conjunto aproximadamente $725 mil millones en gasto de capital para 2026, cerca de un 77% más que el ya récord de $410 mil millones de 2025, y la gran mayoría destinada a infraestructura de IA.
El centro de gravedad se está desplazando del entrenamiento a la inferencia. Deloitte proyecta que la inferencia representará aproximadamente dos tercios de todo el cómputo de IA en 2026, frente a un tercio en 2023 y la mitad en 2025, y que el mercado de chips optimizados para inferencia crecerá a más de $50 mil millones este año. Ese cambio importa para la planificación de costos: el entrenamiento es un gasto concentrado al inicio, pero el costo de inferencia escala con cada interacción de usuario, de forma indefinida.
Y las empresas están retirando sus cargas de trabajo de producción de la nube pública. La proporción de empresas que usan la nube pública como entorno principal para la inferencia de IA en producción cayó 15 puntos porcentuales en un año, del 56% al 41%, mientras que el 56% ahora ejecuta o planea ejecutar inferencia de producción en una nube privada, en gran parte por la previsibilidad de costos y el control de datos. Mientras tanto, la capa de hardware sigue concentrada: solo el segmento de centros de datos de Nvidia generó $193.7 mil millones en el año fiscal 2026, un 68% más interanual, un recordatorio de que, incluso cuando las cargas de trabajo se desplazan hacia la inferencia y el despliegue híbrido, el mercado de cómputo subyacente sigue dominado por un pequeño número de proveedores de chips y de nube.
Por Qué la Infraestructura de IA Importa para los Líderes Empresariales
Nada de esto es abstracto si su empresa construye sobre herramientas de IA o las compra. Algunas conclusiones prácticas que vale la pena llevar a cualquier decisión de infraestructura de IA:
- Pregunte por qué capa está pagando realmente. El precio de un proveedor a menudo agrupa cómputo, orquestación y observabilidad. Conocer las capas le permite preguntar cuánto pagaría si sustituyera cualquiera de ellas.
- El costo de inferencia es la cifra que hay que modelar, no el costo de entrenamiento. Si su equipo hace fine-tuning o entrena su propio modelo, eso es un gasto único. La factura continua es la inferencia, y escala con la adopción, lo cual es una buena noticia cuando una función tiene éxito y un problema de presupuesto si nadie lo planificó.
- Lo híbrido ahora es la norma, no la excepción. El giro hacia la nube privada para la inferencia de producción refleja preocupaciones reales de costo y control, no solo preferencia. Pregúntele a cualquier proveedor dónde se ejecuta realmente su carga de trabajo y por qué.
- El riesgo de capacidad del proveedor es una pregunta real de due diligence. Si la hoja de ruta de un proveedor depende del acceso a GPU o a capital que no controla, eso es un punto único de fallo sobre el que vale la pena preguntar directamente, igual que evaluaría a cualquier otro proveedor crítico.
- Poseer infraestructura rara vez es el primer movimiento correcto. Para casi cualquier empresa, alquilar cómputo y sumarse a una capa de modelo gestionada supera a construir. Reserve la conversación de "poseerlo" para cargas de trabajo con volumen sostenido, necesidades estrictas de latencia, o requisitos regulatorios que obliguen a hacerlo.
Datos Clave
- Se proyecta que el gasto global en TI alcance los $6.15 billones en 2026, casi un 11% más interanual, con el gasto en sistemas de centros de datos superando los $650 mil millones, frente a poco menos de $500 mil millones en 2025. Gartner, via CIO.com
- Se proyecta que los ingresos por semiconductores de centros de datos alcancen los $477.1 mil millones en 2026, con el segmento de centros de datos "inteligentes" (aceleradores de IA, GPU, ASIC personalizados y silicio de redes) representando por sí solo $281 mil millones, la categoría identificable más grande dentro de los semiconductores que no son de memoria. IDC
- El segmento de centros de datos de Nvidia generó $193.7 mil millones en el año fiscal 2026, un 68% más interanual, incluido un récord de $62.3 mil millones solo en el cuarto trimestre, un 75% más. Nvidia
- Se proyecta que la inferencia represente aproximadamente dos tercios de todo el cómputo de IA en 2026, frente a un tercio en 2023 y la mitad en 2025, con el mercado de chips optimizados para inferencia proyectado a superar los $50 mil millones este año. Deloitte
- La proporción de empresas que usan la nube pública como entorno principal para la inferencia de IA en producción cayó 15 puntos porcentuales en un año, del 56% al 41%, mientras que el 56% ahora ejecuta o planea ejecutar inferencia de producción en una nube privada. Broadcom
- Los cuatro mayores hyperscalers estadounidenses proyectaron en conjunto aproximadamente $725 mil millones en gasto de capital para 2026, cerca de un 77% más que el récord de $410 mil millones de 2025, con la gran mayoría destinada a infraestructura de IA. CNBC
- Gartner predice que para 2028, el 40% de las organizaciones que implementen IA usará herramientas dedicadas de observabilidad de IA para monitorear el rendimiento, el sesgo y los resultados de los modelos. Gartner
Preguntas Frecuentes sobre AI Infrastructure
¿Qué es la infraestructura de IA en términos simples?
La infraestructura de IA es la pila tecnológica completa necesaria para construir, implementar y ejecutar modelos de IA: el cómputo GPU, la nube y las redes que lo conectan, los pipelines de datos que alimentan a los modelos, la capa de modelo en sí, y las herramientas de orquestación y observabilidad que mantienen todo confiable una vez que usuarios reales dependen de ello.
¿Cuáles son las principales capas de la infraestructura de IA?
Las capas centrales son cómputo y hardware (GPU y aceleradores), nube y redes (capacidad e interconexiones), el pipeline de datos (recopilar y mover datos), la capa de modelo (el modelo entrenado que razona), model serving (implementarlo para tráfico en vivo), orquestación (coordinar flujos de trabajo y despliegue) y observabilidad (monitorear costo, latencia y calidad en producción).
¿En qué se diferencia la infraestructura de IA de un centro de datos de IA?
Un centro de datos de IA es la instalación física que alberga las GPU y los sistemas de refrigeración, una sola capa de la pila. La infraestructura de IA es más amplia: incluye esa capa de hardware más los servicios en la nube, los pipelines de datos, la capa de modelo, la orquestación y las herramientas de observabilidad construidas sobre ella, sin importar en el centro de datos de quién se ejecute físicamente.
¿Debería una empresa construir su propia infraestructura de IA o comprarla?
Para casi cualquier empresa, alquilar cómputo y sumarse a una capa de modelo gestionada es la opción correcta por defecto. Construir la propia solo tiene sentido para industrias reguladas, cargas de trabajo sensibles a la latencia, o un volumen de uso lo bastante alto como para que poseer el hardware supere a alquilarlo a largo plazo.
¿Qué impulsa el costo de la infraestructura de IA?
Los mayores impulsores son la escasez y el precio de las GPU, el volumen continuo de inferencia (no el entrenamiento, que suele ser un costo único), el movimiento y almacenamiento de datos, el modelo que se elige, el personal de MLOps y LLMOps, y la redundancia necesaria para cargas de trabajo sensibles al tiempo de actividad.
¿Cuál es la diferencia entre MLOps y la infraestructura de IA?
La infraestructura de IA es la pila completa, desde el hardware hasta la observabilidad. MLOps es la disciplina operativa, y las herramientas, que se ejecutan sobre esa pila para implementar, monitorear y mantener los modelos de forma confiable. MLOps depende de que exista la infraestructura de IA; no reemplaza ninguna de sus capas.
¿Las pequeñas y medianas empresas necesitan su propia infraestructura de IA?
Casi nunca su propio hardware. La mayoría de las pequeñas y medianas empresas consumen infraestructura de IA de forma indirecta, a través de un producto SaaS o una API de modelo, y nunca tocan directamente las capas de cómputo, pipeline de datos o serving. Las decisiones de infraestructura que les importan suelen ser sobre en qué proveedor confiar, no qué chips comprar.
¿Qué está cambiando en la infraestructura de IA en 2026?
Destacan dos cambios: el gasto se está desplazando del entrenamiento hacia la inferencia, ya que la inferencia ahora representa aproximadamente dos tercios del cómputo de IA y escala con el uso en lugar de ser un costo único, y las empresas están retirando sus cargas de trabajo de producción de la nube pública hacia configuraciones de nube privada e híbridas por la previsibilidad de costos y el control de datos.
Conceptos de IA Relacionados
- ¿Qué es un Centro de Datos de IA? - La capa de instalación física dentro de la pila de infraestructura de IA más amplia
- MLOps - La disciplina operativa que se ejecuta sobre la infraestructura de IA para mantener los modelos confiables
- ¿Qué es LLMOps? - MLOps aplicado específicamente a aplicaciones de large language models
- Model Serving - Cómo se implementa un modelo entrenado para responder tráfico real de producción
- Observabilidad de IA - La capa de monitoreo que detecta problemas de costo, latencia y calidad en producción
- Costo Total de Propiedad de IA - Cómo la economía de la infraestructura se traduce en lo que una empresa realmente paga por IA
- AI Build vs Buy - El marco para decidir qué capas de infraestructura poseer frente a alquilar
- Edge AI - La alternativa a la infraestructura centralizada para cargas de trabajo sensibles a la latencia
- Modelos Fundacionales - Los modelos preentrenados que se ubican en la capa de modelo de la pila
- Inferencia - La carga de trabajo de producción que ahora impulsa la mayor parte del costo de infraestructura de IA
Recursos Externos
- Gartner: IT Spending to Exceed $6 Trillion by 2026 (via CIO.com) - Pronóstico de gasto global en TI y centros de datos
- IDC: Semiconductor Market Forecast, the AI Supercycle - Pronóstico de semiconductores para centros de datos y del segmento de centros de datos "inteligentes"
- Nvidia: Fourth Quarter and Fiscal 2026 Financial Results - Ingresos y crecimiento del segmento de centros de datos
- Deloitte: Compute Power for AI, 2026 TMT Predictions - Participación de la inferencia en el cómputo y pronóstico del mercado de chips de inferencia
- Broadcom: The AI Tipping Point, Private Cloud Outlook 2026 - Desplazamiento empresarial de la nube pública a la privada para la inferencia de IA en producción
Parte de la Colección de Términos de IA. Última actualización: 2026-07-20

Co-Founder, Rework.com
On this page
- Las Capas de la Pila de Infraestructura de IA
- Infraestructura de IA vs un Centro de Datos de IA
- Build vs Buy: Cómo las Empresas Realmente Arman la Pila
- Qué Impulsa los Costos de la Infraestructura de IA
- El Panorama de la Infraestructura de IA en 2026
- Por Qué la Infraestructura de IA Importa para los Líderes Empresariales
- Datos Clave
- Conceptos de IA Relacionados
- Recursos Externos