Bahasa Indonesia
Apa itu Infrastruktur AI?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Diperbarui Juli 2026
Infrastruktur AI adalah keseluruhan technology stack yang dibutuhkan bisnis untuk membangun, men-deploy, dan menjalankan model AI: GPU dan kapasitas cloud yang menyediakan compute, pipeline yang mengalirkan data masuk, lapisan model yang melakukan reasoning, serta tools orkestrasi dan observability yang menjaga semuanya tetap berjalan andal begitu pengguna sungguhan bergantung padanya.
Sebagian besar eksekutif hanya bertemu stack ini secara tidak langsung, sebagai baris item di tagihan cloud atau daftar tunggu kapasitas vendor. Namun setiap fitur AI yang digunakan perusahaan Anda, chatbot, model forecasting, copilot yang tertanam di CRM Anda, berjalan di atas suatu versi stack ini di suatu tempat. Mengetahui apa sebenarnya isinya membuat jauh lebih mudah untuk membaca pricing vendor, menilai pitch build-vs-buy, atau mengajukan pertanyaan yang tepat ketika proyek AI internal terhenti.
Lapisan-Lapisan Stack Infrastruktur AI
Infrastruktur AI bukan satu produk yang Anda beli. Ini adalah serangkaian lapisan yang bertumpuk satu di atas yang lain, dan mata rantai yang lemah di salah satu lapisan akan memperlambat atau merusak semua yang ada di atasnya.
| Lapisan | Fungsinya | Contoh Umum |
|---|---|---|
| Compute / Hardware | Menjalankan operasi matriks sesungguhnya di balik training dan menjalankan model | GPU Nvidia H100, H200, dan generasi Blackwell, akselerator AMD seri MI, Google TPU, silikon kustom hyperscaler |
| Cloud & Networking | Menyediakan kapasitas GPU dan menghubungkan ribuan chip menjadi satu cluster yang berfungsi | AWS, Azure, Google Cloud, cloud GPU khusus seperti CoreWeave, fabric berkecepatan tinggi seperti NVLink dan InfiniBand |
| Data Pipeline | Mengumpulkan, membersihkan, dan memindahkan data sehingga model punya sesuatu untuk dipelajari atau diambil saat menjawab | Tools ETL dan data pipeline, feature store, vector database |
| Model Layer | Model terlatih yang benar-benar melakukan reasoning atas input | Foundation model, large language model, varian fine-tuned atau open-weight |
| Model Serving | Men-deploy model terlatih agar dapat menjawab permintaan sungguhan pada skala production | Platform model serving, API gateway, model router yang mengirim query mudah ke model murah dan query sulit ke model frontier |
| Orkestrasi | Mengoordinasikan workflow multi-langkah, tool call, dan pipeline yang mengirimkan perubahan model dengan aman | Pipeline MLOps dan LLMOps, framework workflow dan agent |
| Observability | Melacak biaya, latensi, kualitas, dan drift begitu model live | Platform AI observability dan model monitoring, tools logging dan tracing |
Poin praktisnya: sebuah perusahaan bisa memiliki GPU kelas dunia dan tetap merilis fitur AI yang rusak jika data pipeline-nya memberi model informasi basi, atau jika tidak ada yang memantau latensi dan biaya begitu traffic meningkat. Setiap lapisan harus bertahan agar lapisan di atasnya dapat berfungsi.
Infrastruktur AI vs Pusat Data AI
Kedua istilah ini sering dipakai secara bergantian, tetapi keduanya bukan hal yang sama. Pusat data AI adalah fasilitas fisik, gedung, substasiun daya, pabrik pendingin cair, yang menampung GPU. Infrastruktur AI lebih luas: ini mencakup lapisan hardware tersebut, tetapi juga layanan cloud, data pipeline, model layer, orkestrasi, dan tooling observability yang berada di atasnya, di mana pun semuanya berjalan.
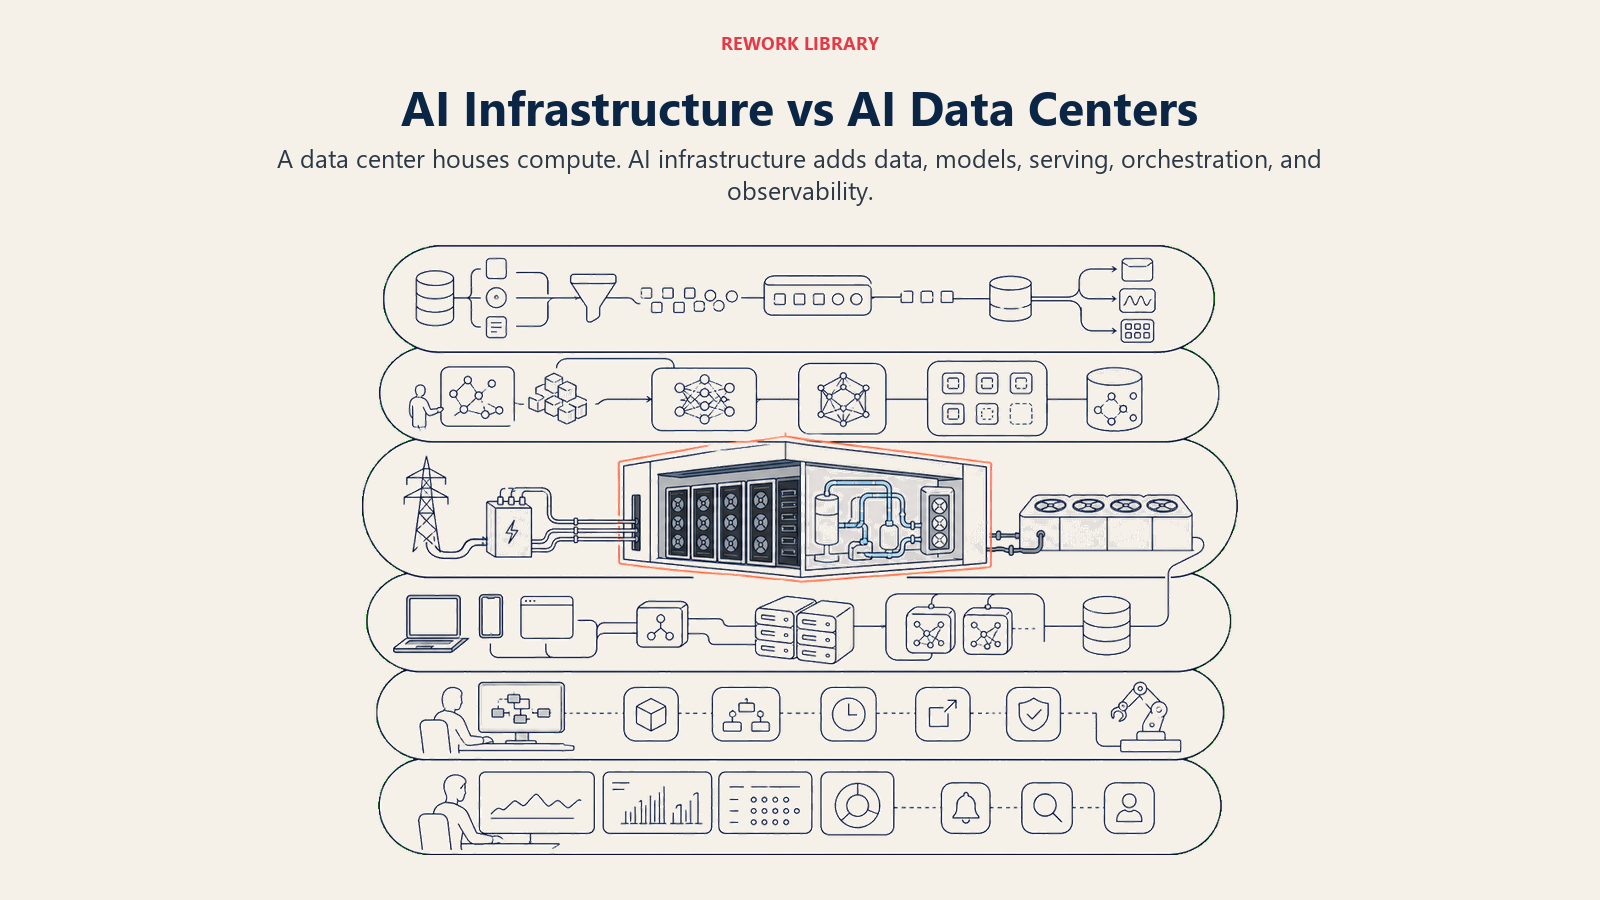
Singkatnya, pusat data AI adalah satu lapisan (compute dan hardware) di dalam stack infrastruktur AI yang lebih besar. Sebuah perusahaan dapat menyewa kapasitas GPU dari pusat data milik pihak lain dan tetap memiliki setiap lapisan lain dari infrastruktur AI-nya, data pipeline-nya, pilihan modelnya, setup serving dan orkestrasinya, tanpa pernah membangun fasilitasnya sendiri. Perbedaan ini penting ketika sebuah vendor mengklaim "berjalan di atas infrastruktur AI": hardware biasanya bagian yang paling mudah ditunjuk, sementara pekerjaan yang lebih sulit dan lebih terdiferensiasi adalah semua yang dibangun di sekitarnya.
Build vs Buy: Bagaimana Perusahaan Sebenarnya Merakit Stack
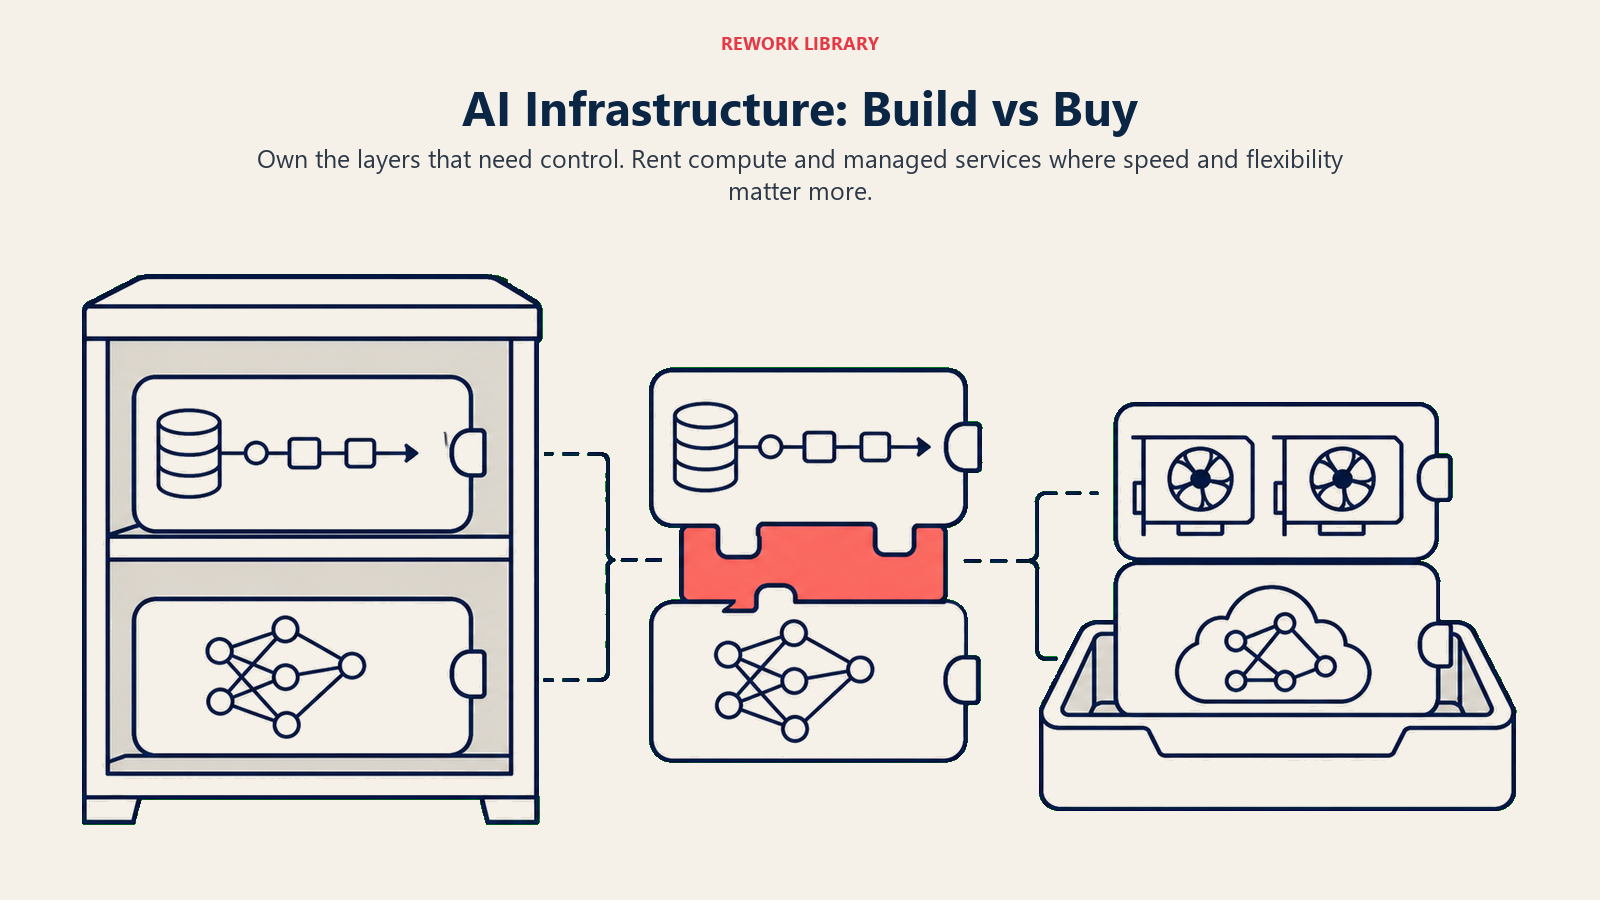
Hampir tidak ada perusahaan yang membangun setiap lapisan dari nol. Keputusan sesungguhnya adalah lapisan mana yang dimiliki dan mana yang disewa, dan pilihan itu berbeda di setiap lapisan stack.
| Pendekatan | Apa yang Anda Miliki | Paling Cocok Untuk |
|---|---|---|
| API yang dikelola penuh (model provider) | Tidak ada apa pun di bawah panggilan model itu sendiri | Tim yang bergerak cepat dan butuh kapabilitas sekarang tanpa perlu menyentuh weight atau hardware |
| GPU cloud yang dikelola | Data pipeline, pilihan model, setup serving, compute sewaan | Tim yang melakukan fine-tuning atau self-hosting model open-weight tanpa memiliki hardware |
| Kolokasi atau on-premises | Segalanya, termasuk hardware fisik | Industri teregulasi, workload yang sensitif terhadap latensi, atau penggunaan berkelanjutan yang cukup tinggi sehingga memiliki lebih untung daripada menyewa |
Menyewa compute dari cloud provider atau memanggil API model adalah default yang tepat untuk hampir semua bisnis: ini menghindari pengeluaran modal, biaya pembangunan pusat data AI, dan staf khusus yang dibutuhkan untuk memiliki hardware. Keputusan build vs buy AI biasanya bukan "bangun pusat data atau tidak," melainkan "lapisan stack mana yang perlu kita kendalikan langsung, dan mana yang aman untuk disewa." Pemeriksaan yang berguna sebelum menandatangani kontrak dengan vendor mana pun: jalankan evaluasi vendor yang tepat yang menanyakan apa yang terjadi pada data pipeline dan pilihan model Anda jika vendor itu mengubah pricing atau roadmap-nya.
Apa yang Mendorong Biaya Infrastruktur AI
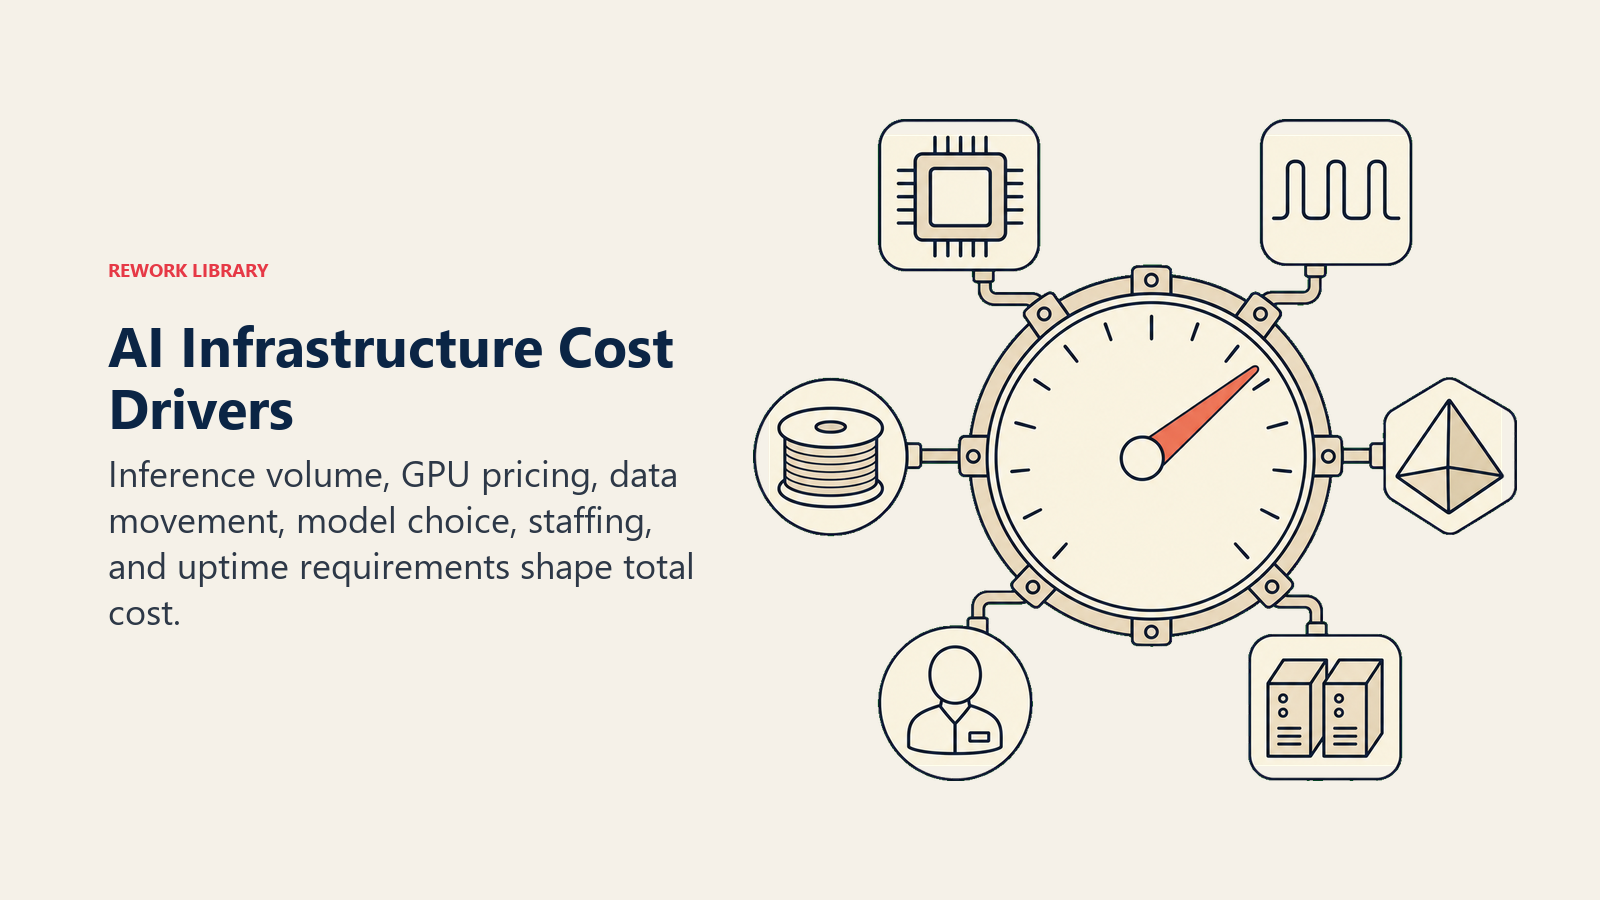
Sejumlah faktor menjelaskan sebagian besar variasi antara tagihan infrastruktur AI yang ramping dan yang membengkak.
- Kelangkaan dan pricing GPU. Permintaan untuk GPU kelas frontier masih secara rutin melampaui pasokan, dan kelangkaan itu langsung memengaruhi apa yang dikenakan cloud provider untuk compute.
- Volume inference, bukan training. Sebagian besar perusahaan tidak pernah melatih model dari nol. Tagihan mereka didorong oleh inference, biaya berkelanjutan dari setiap query yang dijawab model yang live, yang meningkat langsung seiring penggunaan, bukan muncul sebagai biaya sekali bayar.
- Pergerakan dan penyimpanan data. Memberi makan model, terutama yang melakukan retrieval atas data perusahaan, berarti menyimpan dan memindahkan data berulang kali, dan biaya egress cloud bertambah cepat pada skala besar.
- Pilihan model. Model frontier berbiaya lebih tinggi per token dibandingkan model yang lebih kecil, distilled, atau dikompresi dengan quantization yang telah dioptimalkan untuk melakukan pekerjaan yang sama dengan biaya lebih rendah.
- Staffing. Seseorang harus memiliki tanggung jawab atas lapisan orkestrasi dan observability. Talenta MLOps dan LLMOps langka, dan jumlah staf operasional untuk menjalankan infrastruktur AI secara andal adalah item baris nyata dan berkelanjutan yang sering diremehkan sebagian besar perbandingan build-vs-buy.
- Kebutuhan redundansi dan uptime. Fitur AI yang menghadap pelanggan dan tidak boleh down berbiaya lebih mahal untuk dijalankan dibandingkan tool internal yang bisa mentolerir kegagalan sesekali, karena redundansi berarti membayar kapasitas yang tidak selalu Anda gunakan.
Model total cost of ownership AI yang serius harus memperhitungkan keenam faktor ini, bukan hanya harga di label GPU-hour.
Lanskap Infrastruktur AI 2026
Ada tiga hal yang benar tentang belanja infrastruktur AI saat ini, dan ketiganya memengaruhi apa yang dibayar perusahaan Anda untuk AI.
Belanja masih terus meningkat pesat. Gartner memproyeksikan belanja IT global akan mencapai $6,15 triliun pada 2026, naik hampir 11% year over year, dengan belanja sistem pusat data saja melampaui $650 miliar, naik dari sedikit di bawah $500 miliar tahun sebelumnya. Empat hyperscaler AS terbesar, Amazon, Alphabet, Microsoft, dan Meta, memandu belanja modal gabungan sekitar $725 miliar untuk 2026, naik sekitar 77% dari rekor 2025 sebesar $410 miliar, dengan mayoritas mutlak untuk infrastruktur AI.
Titik berat sedang bergeser dari training ke inference. Deloitte memproyeksikan inference akan menyumbang sekitar dua pertiga dari seluruh compute AI pada 2026, naik dari sepertiga pada 2023 dan setengah pada 2025, dan pasar untuk chip yang dioptimalkan untuk inference akan tumbuh melampaui $50 miliar tahun ini. Pergeseran itu penting untuk perencanaan biaya: training adalah biaya yang dibayar di muka, tetapi biaya inference meningkat seiring setiap interaksi pengguna, tanpa batas waktu.
Dan perusahaan-perusahaan menarik kembali workload production dari public cloud. Pangsa perusahaan yang menggunakan public cloud sebagai lingkungan utama untuk production AI inference turun 15 poin persentase dalam setahun, dari 56% menjadi 41%, sementara 56% kini menjalankan atau berencana menjalankan production inference di private cloud, sebagian besar demi prediktabilitas biaya dan kendali data. Sementara itu, lapisan hardware tetap terkonsentrasi: segmen pusat data Nvidia saja menghasilkan $193,7 miliar pada tahun fiskal 2026, naik 68% year over year, sebuah pengingat bahwa meskipun workload bergeser ke arah inference dan deployment hybrid, pasar compute yang mendasarinya masih didominasi oleh sejumlah kecil penyedia chip dan cloud.
Mengapa Infrastruktur AI Penting bagi Pemimpin Bisnis
Tidak ada satu pun dari ini yang abstrak jika perusahaan Anda membangun di atas atau membeli tools AI. Beberapa pelajaran praktis yang layak dibawa ke setiap keputusan infrastruktur AI:
- Tanyakan lapisan mana yang sebenarnya Anda bayar. Harga vendor sering menggabungkan compute, orkestrasi, dan observability menjadi satu. Mengetahui lapisan-lapisannya memungkinkan Anda menanyakan berapa yang akan Anda bayar jika salah satunya ditukar.
- Biaya inference adalah angka yang perlu dimodelkan, bukan biaya training. Jika tim Anda melakukan fine-tuning atau melatih modelnya sendiri, itu adalah pengeluaran sekali bayar. Tagihan berkelanjutan adalah inference, dan itu meningkat seiring adopsi, yang merupakan kabar baik ketika sebuah fitur sukses dan masalah anggaran jika tidak ada yang merencanakannya.
- Hybrid kini menjadi default, bukan pengecualian. Pergeseran ke private cloud untuk production inference mencerminkan kekhawatiran biaya dan kendali yang nyata, bukan sekadar preferensi. Tanyakan pada vendor mana pun di mana sebenarnya workload Anda berjalan dan mengapa.
- Risiko kapasitas vendor adalah pertanyaan due diligence yang nyata. Jika roadmap penyedia bergantung pada akses GPU atau modal yang tidak dikendalikannya sendiri, itu adalah titik kegagalan tunggal yang layak ditanyakan secara langsung, sama seperti Anda mengevaluasi vendor kritis lainnya.
- Memiliki infrastruktur sendiri jarang menjadi langkah pertama yang tepat. Untuk hampir semua bisnis, menyewa compute dan membeli akses ke model layer yang dikelola mengalahkan membangun sendiri. Simpan percakapan "miliki sendiri" untuk workload dengan volume berkelanjutan, kebutuhan latensi yang ketat, atau persyaratan regulasi yang memaksa keputusan itu.
Fakta Penting
- Belanja IT global diproyeksikan mencapai $6,15 triliun pada 2026, naik hampir 11% year over year, dengan belanja sistem pusat data melampaui $650 miliar, naik dari sedikit di bawah $500 miliar pada 2025. Gartner, via CIO.com
- Pendapatan semikonduktor pusat data diproyeksikan mencapai $477,1 miliar pada 2026, dengan segmen pusat data "cerdas" (akselerator AI, GPU, ASIC kustom, dan silikon networking) saja menyumbang $281 miliar, kategori teridentifikasi terbesar dalam semikonduktor non-memori. IDC
- Segmen pusat data Nvidia menghasilkan $193,7 miliar pada tahun fiskal 2026, naik 68% year over year, termasuk rekor $62,3 miliar hanya pada kuartal keempat, naik 75%. Nvidia
- Inference diproyeksikan menyumbang sekitar dua pertiga dari seluruh compute AI pada 2026, naik dari sepertiga pada 2023 dan setengah pada 2025, dengan pasar chip yang dioptimalkan untuk inference diproyeksikan melampaui $50 miliar tahun ini. Deloitte
- Pangsa perusahaan yang menggunakan public cloud sebagai lingkungan utama untuk production AI inference turun 15 poin persentase dalam setahun, dari 56% menjadi 41%, sementara 56% kini menjalankan atau berencana menjalankan production inference di private cloud. Broadcom
- Empat hyperscaler AS terbesar memandu belanja modal gabungan sekitar $725 miliar untuk 2026, naik sekitar 77% dari rekor 2025 sebesar $410 miliar, dengan mayoritas besar dialokasikan untuk infrastruktur AI. CNBC
- Gartner memprediksi 40% organisasi yang men-deploy AI akan menggunakan tools AI observability khusus untuk memantau performa model, bias, dan output pada 2028. Gartner
Pertanyaan yang Sering Diajukan tentang AI Infrastructure
Apa itu infrastruktur AI secara sederhana?
Infrastruktur AI adalah keseluruhan technology stack yang dibutuhkan untuk membangun, men-deploy, dan menjalankan model AI: komputasi GPU, cloud dan networking yang menghubungkannya, data pipeline yang memberi makan model, model layer itu sendiri, serta tools orkestrasi dan observability yang menjaga semuanya tetap andal begitu pengguna sungguhan bergantung padanya.
Apa saja lapisan utama infrastruktur AI?
Lapisan intinya adalah compute dan hardware (GPU dan akselerator), cloud dan networking (kapasitas dan interkoneksi), data pipeline (mengumpulkan dan memindahkan data), model layer (model terlatih yang melakukan reasoning), model serving (men-deploy untuk traffic live), orkestrasi (mengoordinasikan workflow dan deployment), dan observability (memantau biaya, latensi, dan kualitas di production).
Apa bedanya infrastruktur AI dengan pusat data AI?
Pusat data AI adalah fasilitas fisik yang menampung GPU dan sistem pendingin, satu lapisan dari stack. Infrastruktur AI lebih luas: mencakup lapisan hardware itu ditambah layanan cloud, data pipeline, model layer, orkestrasi, dan tooling observability yang dibangun di atasnya, terlepas dari pusat data siapa yang secara fisik menjalankannya.
Haruskah bisnis membangun infrastruktur AI-nya sendiri atau membelinya?
Untuk hampir semua bisnis, menyewa compute dan membeli akses ke model layer yang dikelola adalah default yang tepat. Membangun sendiri hanya masuk akal untuk industri teregulasi, workload yang sensitif terhadap latensi, atau volume penggunaan yang cukup tinggi sehingga memiliki hardware mengalahkan menyewanya dalam jangka panjang.
Apa yang mendorong biaya infrastruktur AI?
Pendorong terbesar adalah kelangkaan dan pricing GPU, volume inference berkelanjutan (bukan training, yang biasanya biaya sekali bayar), pergerakan dan penyimpanan data, model yang Anda pilih, staffing MLOps dan LLMOps, dan redundansi yang dibutuhkan untuk workload yang sensitif terhadap uptime.
Apa bedanya MLOps dengan infrastruktur AI?
Infrastruktur AI adalah keseluruhan stack, dari hardware hingga observability. MLOps adalah disiplin operasional, dan tooling-nya, yang berjalan di atas stack itu untuk men-deploy, memantau, dan memelihara model secara andal. MLOps bergantung pada keberadaan infrastruktur AI; ia tidak menggantikan lapisan mana pun darinya.
Apakah bisnis kecil dan menengah membutuhkan infrastruktur AI-nya sendiri?
Hampir tidak pernah butuh hardware sendiri. Sebagian besar bisnis kecil dan menengah mengonsumsi infrastruktur AI secara tidak langsung, melalui produk SaaS atau API model, dan tidak pernah menyentuh lapisan compute, data pipeline, atau serving secara langsung. Keputusan infrastruktur yang penting bagi mereka biasanya tentang vendor mana yang dipercaya, bukan chip mana yang dibeli.
Apa yang berubah dalam infrastruktur AI pada 2026?
Dua pergeseran menonjol: belanja bergerak dari training menuju inference, karena inference kini membentuk sekitar dua pertiga compute AI dan meningkat seiring penggunaan alih-alih menjadi biaya sekali bayar, dan perusahaan menarik kembali workload production dari public cloud menuju private cloud dan setup hybrid demi prediktabilitas biaya dan kendali data.
Konsep AI Terkait
- Apa itu Pusat Data AI? - Lapisan fasilitas fisik di dalam stack infrastruktur AI yang lebih luas
- MLOps - Disiplin operasional yang berjalan di atas infrastruktur AI untuk menjaga model tetap andal
- Apa itu LLMOps? - MLOps yang diterapkan secara khusus pada aplikasi large language model
- Model Serving - Bagaimana model terlatih di-deploy untuk menjawab traffic production sungguhan
- AI Observability - Lapisan monitoring yang menangkap masalah biaya, latensi, dan kualitas di production
- Total Cost of Ownership AI - Bagaimana ekonomi infrastruktur mengalir ke apa yang sebenarnya dibayar bisnis untuk AI
- Build vs Buy AI - Kerangka kerja untuk memutuskan lapisan infrastruktur mana yang dimiliki versus disewa
- Edge AI - Alternatif dari infrastruktur tersentralisasi untuk workload yang sensitif terhadap latensi
- Foundation Models - Model pre-trained yang berada di model layer dari stack
- Inference - Workload production yang kini mendorong sebagian besar biaya infrastruktur AI
Sumber Eksternal
- Gartner: IT Spending to Exceed $6 Trillion by 2026 (via CIO.com) - Proyeksi belanja IT global dan pusat data
- IDC: Semiconductor Market Forecast, the AI Supercycle - Proyeksi semikonduktor pusat data dan pusat data "cerdas"
- Nvidia: Fourth Quarter and Fiscal 2026 Financial Results - Pendapatan dan pertumbuhan segmen pusat data
- Deloitte: Compute Power for AI, 2026 TMT Predictions - Pangsa inference dari compute dan proyeksi pasar chip inference
- Broadcom: The AI Tipping Point, Private Cloud Outlook 2026 - Pergeseran perusahaan dari public ke private cloud untuk production AI inference
Bagian dari Koleksi AI Terms. Terakhir diperbarui: 2026-07-20

Co-Founder, Rework.com