Was ist KI-Infrastruktur?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Aktualisiert im Juli 2026
KI-Infrastruktur ist der gesamte Technologie-Stack, den ein Unternehmen benötigt, um KI-Modelle zu entwickeln, bereitzustellen und zu betreiben: die GPUs und Cloud-Kapazitäten, die den Compute liefern, die Pipelines, die Daten einspeisen, die Modellebene, die das eigentliche Denken übernimmt, sowie die Orchestrierungs- und Observability-Tools, die alles zuverlässig am Laufen halten, sobald echte Nutzer darauf angewiesen sind.
Die meisten Führungskräfte begegnen diesem Stack nur indirekt, als Posten auf einer Cloud-Rechnung oder auf der Kapazitäts-Warteliste eines Anbieters. Doch jede KI-Funktion, die Ihr Unternehmen nutzt, ein Chatbot, ein Prognosemodell, ein Copilot in Ihrem CRM, läuft irgendwo auf einer Version dieses Stacks. Wer weiß, was tatsächlich darin steckt, kann die Preisgestaltung eines Anbieters leichter einordnen, ein Build-vs-Buy-Angebot besser beurteilen und die richtige Frage stellen, wenn ein internes KI-Projekt ins Stocken gerät.
Die Ebenen des KI-Infrastruktur-Stacks
KI-Infrastruktur ist kein einzelnes Produkt, das man kauft. Sie besteht aus mehreren Ebenen, die aufeinander aufbauen, und ein schwaches Glied in einer dieser Ebenen verlangsamt oder zerstört alles, was darüber liegt.
| Ebene | Was sie tut | Gängige Beispiele |
|---|---|---|
| Compute / Hardware | Führt die eigentliche Matrixmathematik hinter dem Training und Betrieb von Modellen aus | Nvidia H100, H200 und GPUs der Blackwell-Generation, AMD MI-Serie-Beschleuniger, Google TPUs, kundenspezifische Hyperscaler-Chips |
| Cloud & Networking | Stellt GPU-Kapazitäten bereit und verbindet Tausende Chips zu einem funktionierenden Cluster | AWS, Azure, Google Cloud, spezialisierte GPU-Clouds wie CoreWeave, Hochgeschwindigkeitsnetze wie NVLink und InfiniBand |
| Data Pipeline | Sammelt, bereinigt und bewegt Daten, damit Modelle etwas zum Lernen oder Abrufen zum Zeitpunkt der Antwort haben | ETL- und Datenpipeline-Tools, Feature Stores, Vektordatenbanken |
| Modellebene | Das trainierte Modell, das die Eingaben tatsächlich verarbeitet | Foundation Models, Large Language Models, fein abgestimmte oder Open-Weight-Varianten |
| Model Serving | Stellt ein trainiertes Modell bereit, damit es reale Anfragen im Produktionsmaßstab beantworten kann | Model-Serving-Plattformen, API-Gateways, Modell-Router, die einfache Anfragen an günstige Modelle und schwierige an Frontier-Modelle weiterleiten |
| Orchestrierung | Koordiniert mehrstufige Workflows, Tool-Aufrufe und die Pipeline, die eine Modelländerung sicher ausliefert | MLOps- und LLMOps-Pipelines, Workflow- und Agenten-Frameworks |
| Observability | Überwacht Kosten, Latenz, Qualität und Drift, sobald ein Modell live ist | KI-Observability- und Modell-Monitoring-Plattformen, Logging- und Tracing-Tools |
Der praktische Punkt dabei: Ein Unternehmen kann erstklassige GPUs besitzen und trotzdem eine fehlerhafte KI-Funktion ausliefern, wenn die Datenpipeline dem Modell veraltete Informationen liefert oder niemand Latenz und Kosten im Blick behält, sobald der Traffic wächst. Jede Ebene muss halten, damit die darüberliegende funktioniert.
KI-Infrastruktur vs. KI-Rechenzentrum
Die beiden Begriffe werden oft synonym verwendet, meinen aber nicht dasselbe. Ein KI-Rechenzentrum ist die physische Einrichtung, das Gebäude, das Umspannwerk, die Flüssigkeitskühlanlage, die die GPUs beherbergt. KI-Infrastruktur ist weiter gefasst: Sie umfasst diese Hardware-Ebene, aber auch die Cloud-Dienste, Datenpipelines, die Modellebene sowie die Orchestrierungs- und Observability-Tools, die darauf aufbauen, egal wo sie tatsächlich laufen.
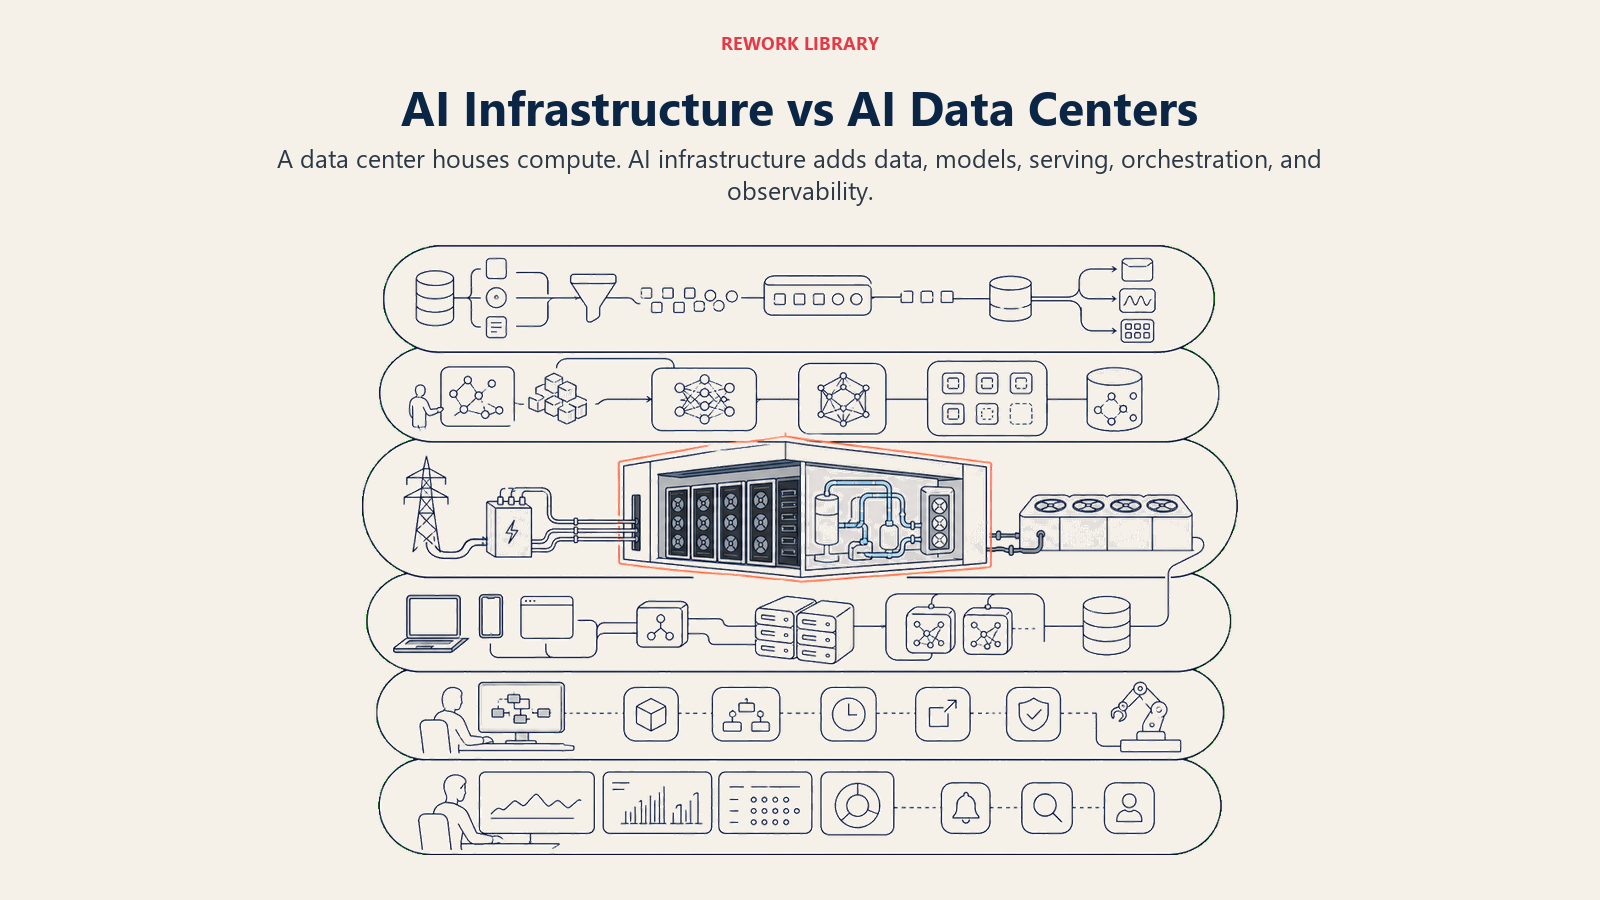
Einfach gesagt: Ein KI-Rechenzentrum ist eine Ebene (Compute und Hardware) innerhalb des größeren KI-Infrastruktur-Stacks. Ein Unternehmen kann GPU-Kapazitäten aus dem Rechenzentrum eines anderen Anbieters mieten und trotzdem jede andere Ebene seiner KI-Infrastruktur selbst besitzen, seine Datenpipelines, seine Modellauswahl, sein Serving- und Orchestrierungs-Setup, ohne jemals eine eigene Einrichtung zu bauen. Diese Unterscheidung ist wichtig, wenn ein Anbieter behauptet, „auf KI-Infrastruktur zu laufen": Die Hardware ist meist der Teil, auf den man am leichtesten zeigen kann, während die schwierigere, differenziertere Arbeit alles ist, was darum herum aufgebaut wird.
Build vs. Buy: Wie Unternehmen den Stack tatsächlich zusammenstellen
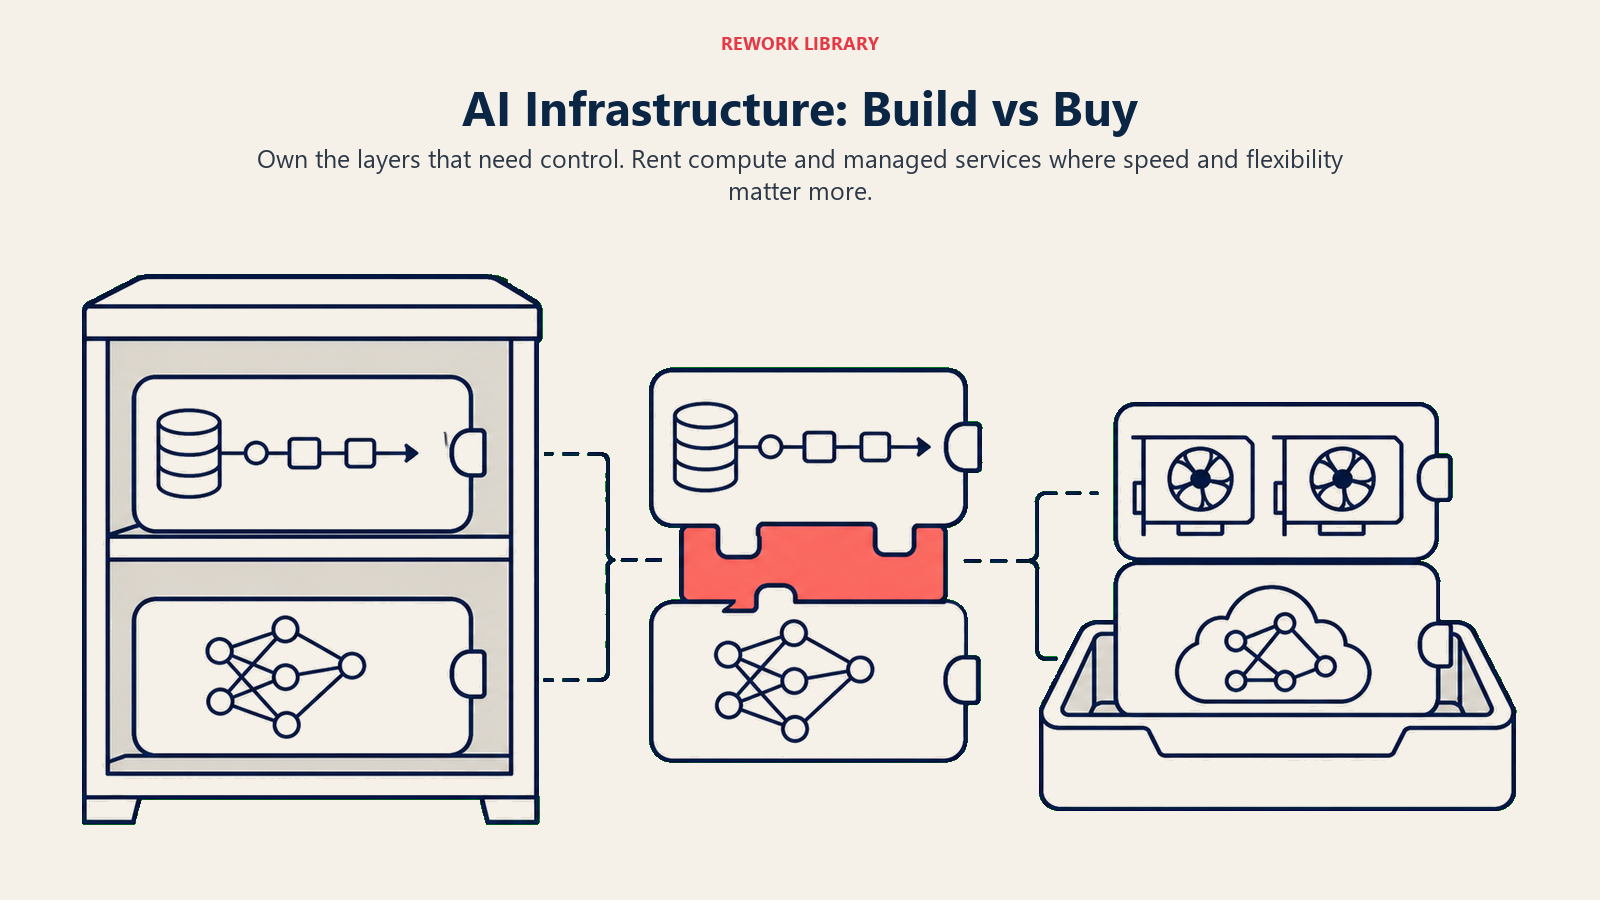
Kaum ein Unternehmen baut jede Ebene von Grund auf selbst. Die eigentliche Entscheidung ist, welche Ebenen man selbst besitzen und welche man mieten sollte, und diese Wahl sieht auf jeder Ebene des Stacks anders aus.
| Ansatz | Was Sie besitzen | Am besten geeignet für |
|---|---|---|
| Vollständig verwaltete API (Modellanbieter) | Nichts unterhalb des eigentlichen Modellaufrufs | Schnell agierende Teams, die eine Fähigkeit sofort brauchen und weder Gewichte noch Hardware anfassen müssen |
| Verwaltete Cloud-GPU | Ihre Datenpipeline, Modellauswahl, Ihr Serving-Setup, gemieteter Compute | Teams, die Open-Weight-Modelle feinabstimmen oder selbst hosten, ohne eigene Hardware zu besitzen |
| Colocation oder On-Premises | Alles, einschließlich der physischen Hardware | Regulierte Branchen, latenzsensible Workloads oder eine dauerhaft hohe Auslastung, bei der Besitz sich gegenüber Miete auszahlt |
Compute von einem Cloud-Anbieter zu mieten oder eine Modell-API aufzurufen ist für fast jedes Unternehmen die richtige Standardwahl: Es vermeidet die Kapitalausgaben, die Baukosten eines KI-Rechenzentrums und die spezialisierten Mitarbeiter, die der Besitz eigener Hardware erfordert. Die Entscheidung Build vs. Buy bei KI lautet meist nicht „Rechenzentrum bauen oder nicht", sondern „über welche Ebenen des Stacks brauchen wir direkte Kontrolle, und welche können wir gefahrlos mieten". Ein sinnvoller Realitätscheck vor der Unterschrift bei jedem Anbieter: eine ordentliche Anbieterbewertung durchführen, die klärt, was mit Ihrer Datenpipeline und Ihrer Modellauswahl passiert, wenn dieser Anbieter seine Preisgestaltung oder seine Roadmap ändert.
Was die Kosten der KI-Infrastruktur treibt
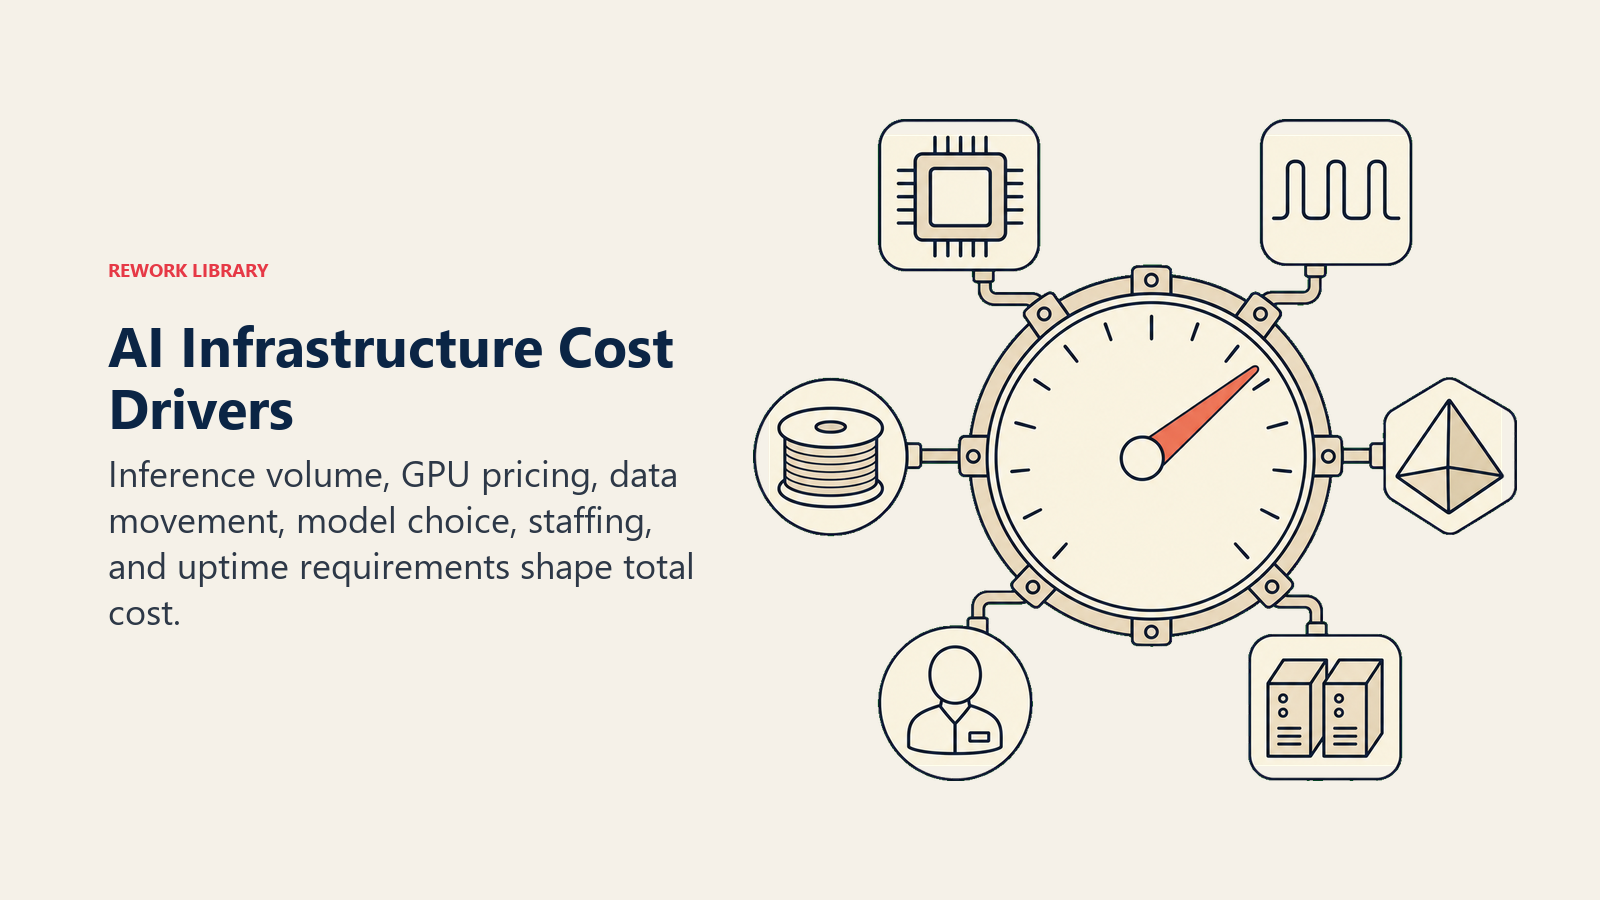
Eine Handvoll Faktoren erklärt den größten Teil des Unterschieds zwischen einer schlanken KI-Infrastruktur-Rechnung und einer aus dem Ruder laufenden.
- GPU-Knappheit und Preise. Die Nachfrage nach GPUs der Frontier-Klasse übersteigt das Angebot noch immer regelmäßig, und diese Knappheit schlägt sich direkt in dem nieder, was Cloud-Anbieter für Compute berechnen.
- Inferenzvolumen, nicht Training. Die meisten Unternehmen trainieren nie ein Modell von Grund auf. Ihre Rechnung wird von der Inferenz bestimmt, den laufenden Kosten für jede Anfrage, die ein Live-Modell beantwortet, die direkt mit der Nutzung skalieren, statt als einmalige Kosten aufzutreten.
- Datenbewegung und -speicherung. Ein Modell zu füttern, insbesondere eines, das Retrieval über Unternehmensdaten durchführt, bedeutet, Daten wiederholt zu speichern und zu bewegen, und Cloud-Egress-Gebühren summieren sich bei zunehmendem Umfang schnell.
- Modellwahl. Ein Frontier-Modell kostet pro Token mehr als ein kleineres, destilliertes oder durch Quantisierung komprimiertes Modell, das darauf optimiert wurde, dieselbe Aufgabe günstiger zu erledigen.
- Personal. Jemand muss die Orchestrierungs- und Observability-Ebenen verantworten. MLOps- und LLMOps-Talente sind knapp, und der operative Personalbedarf, um KI-Infrastruktur zuverlässig zu betreiben, ist ein realer, laufender Kostenposten, den die meisten Build-vs-Buy-Vergleiche unterschätzen.
- Redundanz- und Uptime-Anforderungen. Eine kundenseitige KI-Funktion, die nicht ausfallen darf, ist im Betrieb teurer als ein internes Tool, das gelegentliche Ausfälle verkraften kann, denn Redundanz bedeutet, für Kapazität zu bezahlen, die nicht immer genutzt wird.
Jedes seriöse Modell für die Gesamtbetriebskosten von KI muss alle sechs Faktoren berücksichtigen, nicht nur den Listenpreis einer GPU-Stunde.
Die KI-Infrastruktur-Landschaft 2026
Drei Dinge treffen derzeit auf die Ausgaben für KI-Infrastruktur zu, und alle drei wirken sich darauf aus, was Ihr Unternehmen für KI bezahlt.
Die Ausgaben steigen weiterhin rasant. Gartner prognostiziert, dass die weltweiten IT-Ausgaben 2026 auf 6,15 Billionen US-Dollar steigen werden, fast 11 % mehr als im Vorjahr, wobei allein die Ausgaben für Rechenzentrumssysteme die Marke von 650 Milliarden US-Dollar überschreiten, gegenüber knapp 500 Milliarden US-Dollar im Jahr zuvor. Die vier größten US-Hyperscaler, Amazon, Alphabet, Microsoft und Meta, haben für 2026 zusammen rund 725 Milliarden US-Dollar an Investitionsausgaben in Aussicht gestellt, etwa 77 % mehr als der bereits rekordhohe Wert von 410 Milliarden US-Dollar aus 2025, wobei der weit überwiegende Teil davon auf KI-Infrastruktur entfällt.
Der Schwerpunkt verschiebt sich vom Training zur Inferenz. Deloitte geht davon aus, dass Inferenz 2026 rund zwei Drittel des gesamten KI-Compute ausmachen wird, gegenüber einem Drittel 2023 und der Hälfte 2025, und dass der Markt für inferenzoptimierte Chips in diesem Jahr auf über 50 Milliarden US-Dollar wachsen wird. Diese Verschiebung ist für die Kostenplanung wichtig: Training ist eine vorab anfallende Ausgabe, aber die Inferenzkosten skalieren mit jeder Nutzerinteraktion, unbegrenzt.
Und Unternehmen holen Produktions-Workloads aus der Public Cloud zurück. Der Anteil der Unternehmen, die Public Cloud als primäre Umgebung für produktive KI-Inferenz nutzen, sank innerhalb eines Jahres um 15 Prozentpunkte von 56 % auf 41 %, während 56 % nun produktive Inferenz in einer Private Cloud betreiben oder dies planen, vor allem wegen der Kostenvorhersehbarkeit und Datenkontrolle. Gleichzeitig bleibt die Hardware-Ebene konzentriert: Allein das Rechenzentrumssegment von Nvidia erwirtschaftete im Geschäftsjahr 2026 193,7 Milliarden US-Dollar, ein Plus von 68 % gegenüber dem Vorjahr, eine Erinnerung daran, dass der zugrunde liegende Compute-Markt trotz der Verschiebung hin zu Inferenz und Hybrid-Deployments weiterhin von einer kleinen Zahl an Chip- und Cloud-Anbietern dominiert wird.
Warum KI-Infrastruktur für Führungskräfte wichtig ist
All das ist keineswegs abstrakt, wenn Ihr Unternehmen KI-Tools entwickelt oder einkauft. Ein paar praktische Erkenntnisse, die Sie in jede KI-Infrastruktur-Entscheidung mitnehmen sollten:
- Fragen Sie, für welche Ebene Sie eigentlich bezahlen. Der Preis eines Anbieters bündelt oft Compute, Orchestrierung und Observability. Wer die Ebenen kennt, kann fragen, was man bezahlen würde, wenn man eine davon austauscht.
- Die Inferenzkosten sind die Zahl, die Sie modellieren sollten, nicht die Trainingskosten. Wenn Ihr Team ein eigenes Modell feinabstimmt oder trainiert, ist das eine einmalige Ausgabe. Die laufende Rechnung ist die Inferenz, und sie skaliert mit der Akzeptanz, was eine gute Nachricht ist, wenn eine Funktion erfolgreich wird, und ein Budgetproblem, wenn niemand damit geplant hat.
- Hybrid ist inzwischen der Standard, nicht die Ausnahme. Die Verschiebung hin zu Private Cloud für produktive Inferenz spiegelt echte Kosten- und Kontrollbedenken wider, nicht nur eine Vorliebe. Fragen Sie jeden Anbieter, wo Ihr Workload tatsächlich läuft und warum.
- Das Kapazitätsrisiko eines Anbieters ist eine echte Due-Diligence-Frage. Wenn die Roadmap eines Anbieters von einem Zugang zu GPUs oder Kapital abhängt, den er nicht selbst kontrolliert, ist das ein Single Point of Failure, den es direkt anzusprechen lohnt, genau wie bei jedem anderen kritischen Anbieter.
- Eigene Infrastruktur zu besitzen ist selten der richtige erste Schritt. Für fast jedes Unternehmen schlägt das Mieten von Compute und der Einstieg in eine verwaltete Modellebene den Eigenbau. Heben Sie sich das Gespräch über „selbst besitzen" für Workloads mit dauerhaft hohem Volumen, strengen Latenzanforderungen oder regulatorischen Vorgaben auf, die keine andere Wahl lassen.
Wichtige Fakten
- Die weltweiten IT-Ausgaben sollen 2026 auf 6,15 Billionen US-Dollar steigen, fast 11 % mehr als im Vorjahr, wobei die Ausgaben für Rechenzentrumssysteme die Marke von 650 Milliarden US-Dollar überschreiten, gegenüber knapp 500 Milliarden US-Dollar im Jahr 2025. Gartner, via CIO.com
- Der Umsatz mit Rechenzentrums-Halbleitern soll 2026 auf 477,1 Milliarden US-Dollar steigen, wobei allein das Segment der „intelligenten" Rechenzentren (KI-Beschleuniger, GPUs, kundenspezifische ASICs und Netzwerk-Chips) 281 Milliarden US-Dollar ausmacht, die größte identifizierbare Kategorie innerhalb der Nicht-Speicher-Halbleiter. IDC
- Das Rechenzentrumssegment von Nvidia erwirtschaftete im Geschäftsjahr 2026 193,7 Milliarden US-Dollar, ein Plus von 68 % gegenüber dem Vorjahr, darunter allein im vierten Quartal ein Rekordwert von 62,3 Milliarden US-Dollar, ein Plus von 75 %. Nvidia
- Inferenz soll 2026 rund zwei Drittel des gesamten KI-Compute ausmachen, gegenüber einem Drittel 2023 und der Hälfte 2025, wobei der Markt für inferenzoptimierte Chips in diesem Jahr voraussichtlich 50 Milliarden US-Dollar übersteigen wird. Deloitte
- Der Anteil der Unternehmen, die Public Cloud als primäre Umgebung für produktive KI-Inferenz nutzen, sank innerhalb eines Jahres um 15 Prozentpunkte von 56 % auf 41 %, während 56 % nun produktive Inferenz in einer Private Cloud betreiben oder dies planen. Broadcom
- Die vier größten US-Hyperscaler haben für 2026 zusammen rund 725 Milliarden US-Dollar an Investitionsausgaben in Aussicht gestellt, etwa 77 % mehr als der Rekordwert von 410 Milliarden US-Dollar aus 2025, wobei der weit überwiegende Teil für KI-Infrastruktur vorgesehen ist. CNBC
- Gartner prognostiziert, dass bis 2028 40 % der Organisationen, die KI einsetzen, dedizierte KI-Observability-Tools nutzen werden, um Modellleistung, Bias und Ergebnisse zu überwachen. Gartner
Häufig gestellte Fragen zu AI Infrastructure
Was ist KI-Infrastruktur einfach erklärt?
KI-Infrastruktur ist der gesamte Technologie-Stack, der benötigt wird, um KI-Modelle zu entwickeln, bereitzustellen und zu betreiben: GPU-Compute, die Cloud- und Netzwerkverbindungen, die Datenpipelines, die Modelle mit Daten versorgen, die Modellebene selbst sowie die Orchestrierungs- und Observability-Tools, die alles zuverlässig halten, sobald echte Nutzer darauf angewiesen sind.
Was sind die wichtigsten Ebenen der KI-Infrastruktur?
Die Kernebenen sind Compute und Hardware (GPUs und Beschleuniger), Cloud und Networking (Kapazitäten und Verbindungen), die Datenpipeline (Sammeln und Bewegen von Daten), die Modellebene (das trainierte Modell, das die Verarbeitung übernimmt), Model Serving (Bereitstellung für Live-Traffic), Orchestrierung (Koordination von Workflows und Deployment) und Observability (Überwachung von Kosten, Latenz und Qualität in der Produktion).
Wie unterscheidet sich KI-Infrastruktur von einem KI-Rechenzentrum?
Ein KI-Rechenzentrum ist die physische Einrichtung, die GPUs und Kühlsysteme beherbergt, eine Ebene des Stacks. KI-Infrastruktur ist weiter gefasst: Sie umfasst diese Hardware-Ebene sowie die Cloud-Dienste, Datenpipelines, die Modellebene, die Orchestrierung und die Observability-Tools, die darauf aufbauen, unabhängig davon, in wessen Rechenzentrum sie physisch laufen.
Sollte ein Unternehmen seine eigene KI-Infrastruktur bauen oder einkaufen?
Für fast jedes Unternehmen ist das Mieten von Compute und der Einstieg in eine verwaltete Modellebene die richtige Standardwahl. Der Eigenbau lohnt sich nur für regulierte Branchen, latenzsensible Workloads oder ein Nutzungsvolumen, das so hoch ist, dass der Besitz eigener Hardware langfristig günstiger ist als die Miete.
Was treibt die Kosten der KI-Infrastruktur?
Die größten Treiber sind GPU-Knappheit und Preise, das laufende Inferenzvolumen (nicht das Training, das meist einmalige Kosten verursacht), Datenbewegung und -speicherung, die Wahl des Modells, MLOps- und LLMOps-Personal sowie die Redundanz, die für uptime-sensible Workloads nötig ist.
Was ist der Unterschied zwischen MLOps und KI-Infrastruktur?
KI-Infrastruktur ist der gesamte Stack, von der Hardware bis zur Observability. MLOps ist die operative Disziplin, samt Tooling, die auf diesem Stack aufsetzt, um Modelle zuverlässig bereitzustellen, zu überwachen und zu pflegen. MLOps setzt voraus, dass KI-Infrastruktur existiert, es ersetzt keine ihrer Ebenen.
Brauchen kleine und mittelständische Unternehmen eigene KI-Infrastruktur?
Fast nie eigene Hardware. Die meisten kleinen und mittelständischen Unternehmen nutzen KI-Infrastruktur indirekt, über ein SaaS-Produkt oder eine Modell-API, und kommen nie direkt mit den Compute-, Datenpipeline- oder Serving-Ebenen in Berührung. Die für sie relevanten Infrastrukturentscheidungen drehen sich meist darum, welchem Anbieter man vertraut, nicht welche Chips man kauft.
Was ändert sich 2026 bei der KI-Infrastruktur?
Zwei Verschiebungen stechen hervor: Die Ausgaben verlagern sich vom Training zur Inferenz, da Inferenz inzwischen rund zwei Drittel des KI-Compute ausmacht und mit der Nutzung skaliert statt einmalige Kosten zu verursachen, und Unternehmen holen Produktions-Workloads aus der Public Cloud zurück in Richtung Private Cloud und Hybrid-Setups, wegen der Kostenvorhersehbarkeit und Datenkontrolle.
Verwandte KI-Konzepte
- Was ist ein KI-Rechenzentrum? - Die physische Facility-Ebene innerhalb des breiteren KI-Infrastruktur-Stacks
- MLOps - Die operative Disziplin, die auf der KI-Infrastruktur aufsetzt, um Modelle zuverlässig zu halten
- Was ist LLMOps? - MLOps, speziell angewendet auf Large-Language-Model-Anwendungen
- Model Serving - Wie ein trainiertes Modell bereitgestellt wird, um echten Produktions-Traffic zu beantworten
- KI-Observability - Die Monitoring-Ebene, die Kosten-, Latenz- und Qualitätsprobleme in der Produktion erkennt
- Gesamtbetriebskosten von KI - Wie die Infrastrukturökonomie in das einfließt, was ein Unternehmen tatsächlich für KI bezahlt
- KI Build vs. Buy - Das Framework zur Entscheidung, welche Infrastrukturebenen man besitzen und welche man mieten sollte
- Edge AI - Die Alternative zu zentralisierter Infrastruktur für latenzsensible Workloads
- Foundation Models - Die vortrainierten Modelle, die auf der Modellebene des Stacks sitzen
- Inferenz - Der Produktions-Workload, der heute den Großteil der KI-Infrastrukturkosten treibt
Externe Ressourcen
- Gartner: IT Spending to Exceed $6 Trillion by 2026 (via CIO.com) - Prognose zu globalen IT- und Rechenzentrumsausgaben
- IDC: Semiconductor Market Forecast, the AI Supercycle - Prognose zu Rechenzentrums-Halbleitern und „intelligenten" Rechenzentren
- Nvidia: Fourth Quarter and Fiscal 2026 Financial Results - Umsatz und Wachstum des Rechenzentrumssegments
- Deloitte: Compute Power for AI, 2026 TMT Predictions - Anteil der Inferenz am Compute und Prognose zum Markt für Inferenz-Chips
- Broadcom: The AI Tipping Point, Private Cloud Outlook 2026 - Verschiebung von Unternehmen von Public zu Private Cloud für produktive KI-Inferenz
Teil der AI Terms Collection. Zuletzt aktualisiert: 2026-07-20

Co-Founder, Rework.com
On this page
- Die Ebenen des KI-Infrastruktur-Stacks
- KI-Infrastruktur vs. KI-Rechenzentrum
- Build vs. Buy: Wie Unternehmen den Stack tatsächlich zusammenstellen
- Was die Kosten der KI-Infrastruktur treibt
- Die KI-Infrastruktur-Landschaft 2026
- Warum KI-Infrastruktur für Führungskräfte wichtig ist
- Wichtige Fakten
- Verwandte KI-Konzepte
- Externe Ressourcen