O Que É Infraestrutura de IA?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Atualizado em julho de 2026
Infraestrutura de IA é toda a pilha tecnológica que uma empresa precisa para construir, implantar e executar modelos de IA: as GPUs e a capacidade de nuvem que fornecem computação, os pipelines que alimentam os dados, a camada de modelo que faz o raciocínio, e as ferramentas de orquestração e observabilidade que mantêm tudo funcionando de forma confiável quando usuários reais dependem disso.
A maioria dos executivos só encontra essa pilha indiretamente, como um item de linha na fatura da nuvem ou na lista de espera de capacidade de um fornecedor. Mas todo recurso de IA que sua empresa usa, um chatbot, um modelo de previsão, um copiloto embutido no seu CRM, está rodando em alguma versão dessa pilha em algum lugar. Saber o que realmente há nela facilita muito interpretar o preço de um fornecedor, avaliar uma proposta de construir versus comprar, ou fazer a pergunta certa quando um projeto interno de IA trava.
As Camadas da Pilha de Infraestrutura de IA
Infraestrutura de IA não é um único produto que você compra. É um conjunto de camadas empilhadas umas sobre as outras, e um elo fraco em qualquer uma delas atrasa ou quebra tudo que está acima.
| Camada | O Que Faz | Exemplos Comuns |
|---|---|---|
| Computação / Hardware | Executa a matemática matricial por trás do treinamento e da execução de modelos | GPUs Nvidia H100, H200 e da geração Blackwell, aceleradores AMD da série MI, TPUs do Google, silício customizado de hyperscalers |
| Nuvem e Rede | Provisiona capacidade de GPU e conecta milhares de chips em um único cluster funcional | AWS, Azure, Google Cloud, nuvens de GPU especializadas como a CoreWeave, tecidos de alta velocidade como NVLink e InfiniBand |
| Pipeline de Dados | Coleta, limpa e move dados para que os modelos tenham o que aprender ou recuperar no momento da resposta | Ferramentas de ETL e pipeline de dados, feature stores, bancos de dados vetoriais |
| Camada de Modelo | O modelo treinado que efetivamente raciocina sobre a entrada | Modelos de fundação, grandes modelos de linguagem, variantes ajustadas ou de pesos abertos |
| Model Serving | Implanta um modelo treinado para que ele possa responder a solicitações reais em escala de produção | Plataformas de model serving, gateways de API, roteadores de modelo que enviam consultas simples para modelos baratos e as difíceis para modelos de fronteira |
| Orquestração | Coordena fluxos de trabalho de múltiplas etapas, chamadas de ferramentas e o pipeline que implanta uma mudança de modelo com segurança | Pipelines de MLOps e LLMOps, frameworks de workflow e de agentes |
| Observabilidade | Monitora custo, latência, qualidade e drift depois que um modelo está no ar | Plataformas de observabilidade de IA e monitoramento de modelos, ferramentas de logging e tracing |
O ponto prático: uma empresa pode ter GPUs de classe mundial e ainda assim lançar um recurso de IA quebrado se o pipeline de dados alimentar o modelo com informações desatualizadas, ou se ninguém estiver observando a latência e o custo à medida que o tráfego escala. Cada camada precisa se sustentar para que a camada acima funcione.
Infraestrutura de IA versus um Data Center de IA
Os dois termos são usados de forma intercambiável, mas não são a mesma coisa. Um data center de IA é a instalação física, o prédio, a subestação de energia, a planta de resfriamento líquido, que abriga as GPUs. Infraestrutura de IA é mais ampla: inclui essa camada de hardware, mas também os serviços de nuvem, os pipelines de dados, a camada de modelo, a orquestração e as ferramentas de observabilidade que ficam sobre ela, onde quer que rodem.
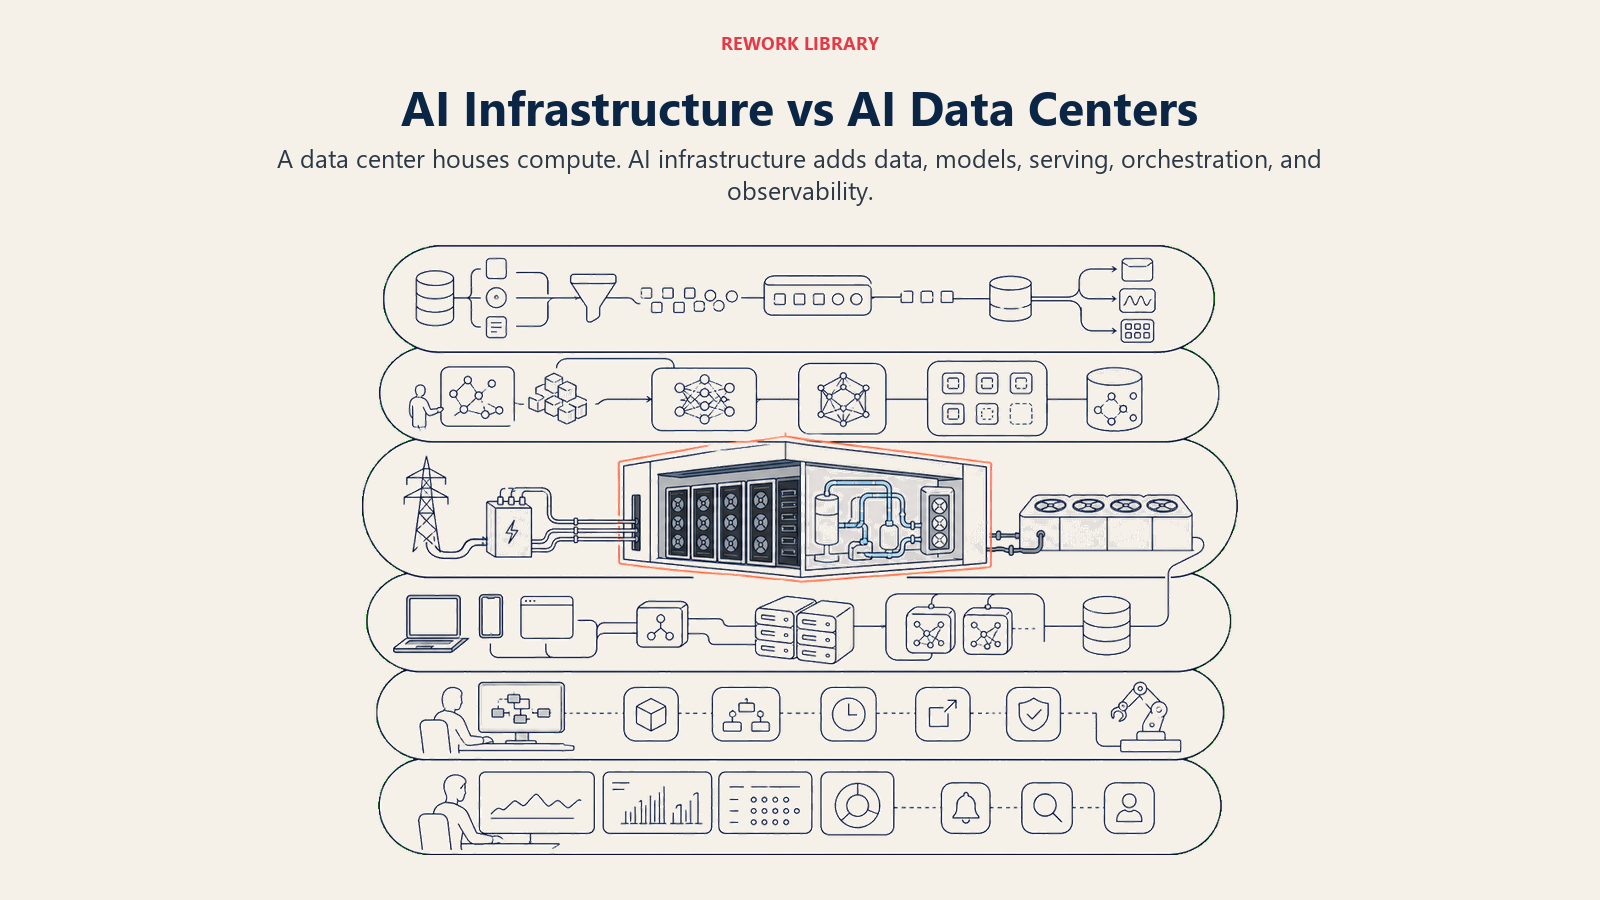
Em termos simples, um data center de IA é uma camada (computação e hardware) dentro da pilha maior de infraestrutura de IA. Uma empresa pode alugar capacidade de GPU do data center de outra empresa e ainda assim ser dona de todas as outras camadas da sua infraestrutura de IA, seus pipelines de dados, suas escolhas de modelo, sua configuração de serving e orquestração, sem nunca construir uma instalação própria. Essa distinção importa quando um fornecedor afirma "rodar em infraestrutura de IA": o hardware costuma ser a parte fácil de apontar, e o trabalho mais difícil e diferenciado é tudo o que é construído ao redor dele.
Construir versus Comprar: Como as Empresas Realmente Montam a Pilha
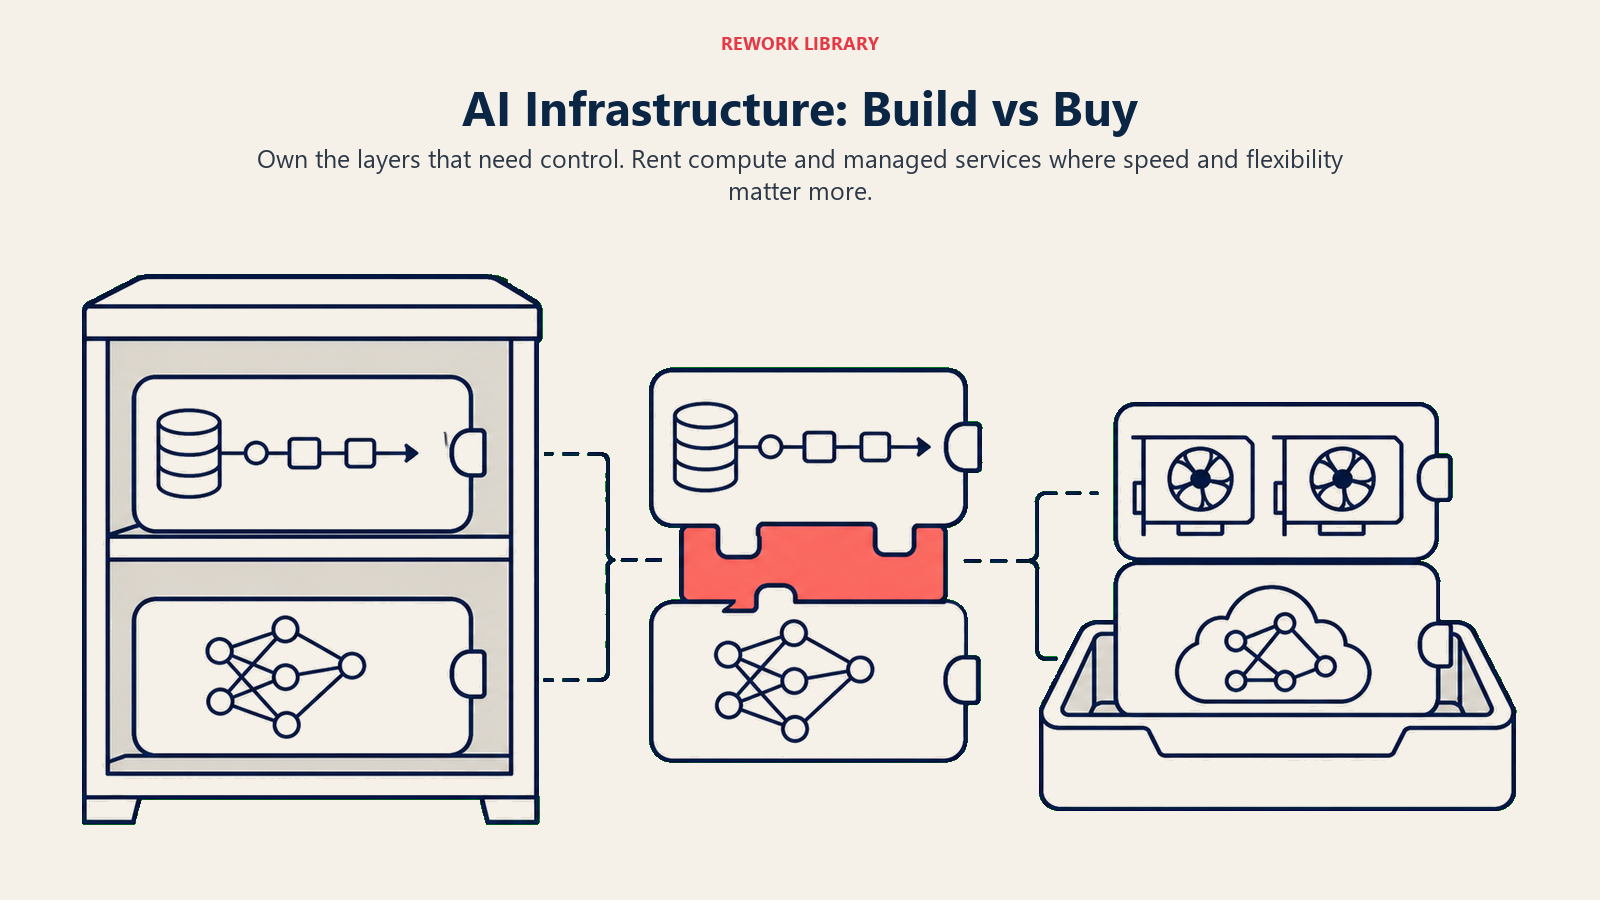
Quase nenhuma empresa constrói todas as camadas do zero. A decisão real é quais camadas possuir e quais alugar, e essa escolha é diferente em cada camada da pilha.
| Abordagem | O Que Você Possui | Melhor Uso |
|---|---|---|
| API totalmente gerenciada (provedor de modelo) | Nada abaixo da própria chamada do modelo | Equipes ágeis que precisam de uma capacidade agora e não precisam mexer em pesos ou hardware |
| GPU gerenciada em nuvem | Seu pipeline de dados, escolhas de modelo, configuração de serving, computação alugada | Equipes que fazem fine-tuning ou hospedam modelos de pesos abertos sem possuir hardware |
| Colocation ou on-premises | Tudo, incluindo o hardware físico | Setores regulados, cargas de trabalho sensíveis à latência, ou uso sustentado alto o suficiente para que possuir compense alugar |
Alugar computação de um provedor de nuvem ou chamar uma API de modelo é o padrão certo para quase todas as empresas: evita o investimento de capital, o custo de construção de um data center de IA e a equipe especializada que possuir hardware exige. A decisão de construir versus comprar em IA geralmente não é "construir um data center ou não", é "sobre quais camadas da pilha precisamos ter controle direto, e quais podemos alugar com segurança". Uma verificação útil antes de assinar com qualquer fornecedor: faça uma avaliação de fornecedor adequada que pergunte o que acontece com seu pipeline de dados e suas escolhas de modelo se esse fornecedor mudar seus preços ou seu roadmap.
O Que Impulsiona os Custos de Infraestrutura de IA
Um punhado de fatores explica a maior parte da variação entre uma conta de infraestrutura de IA enxuta e uma fora de controle.
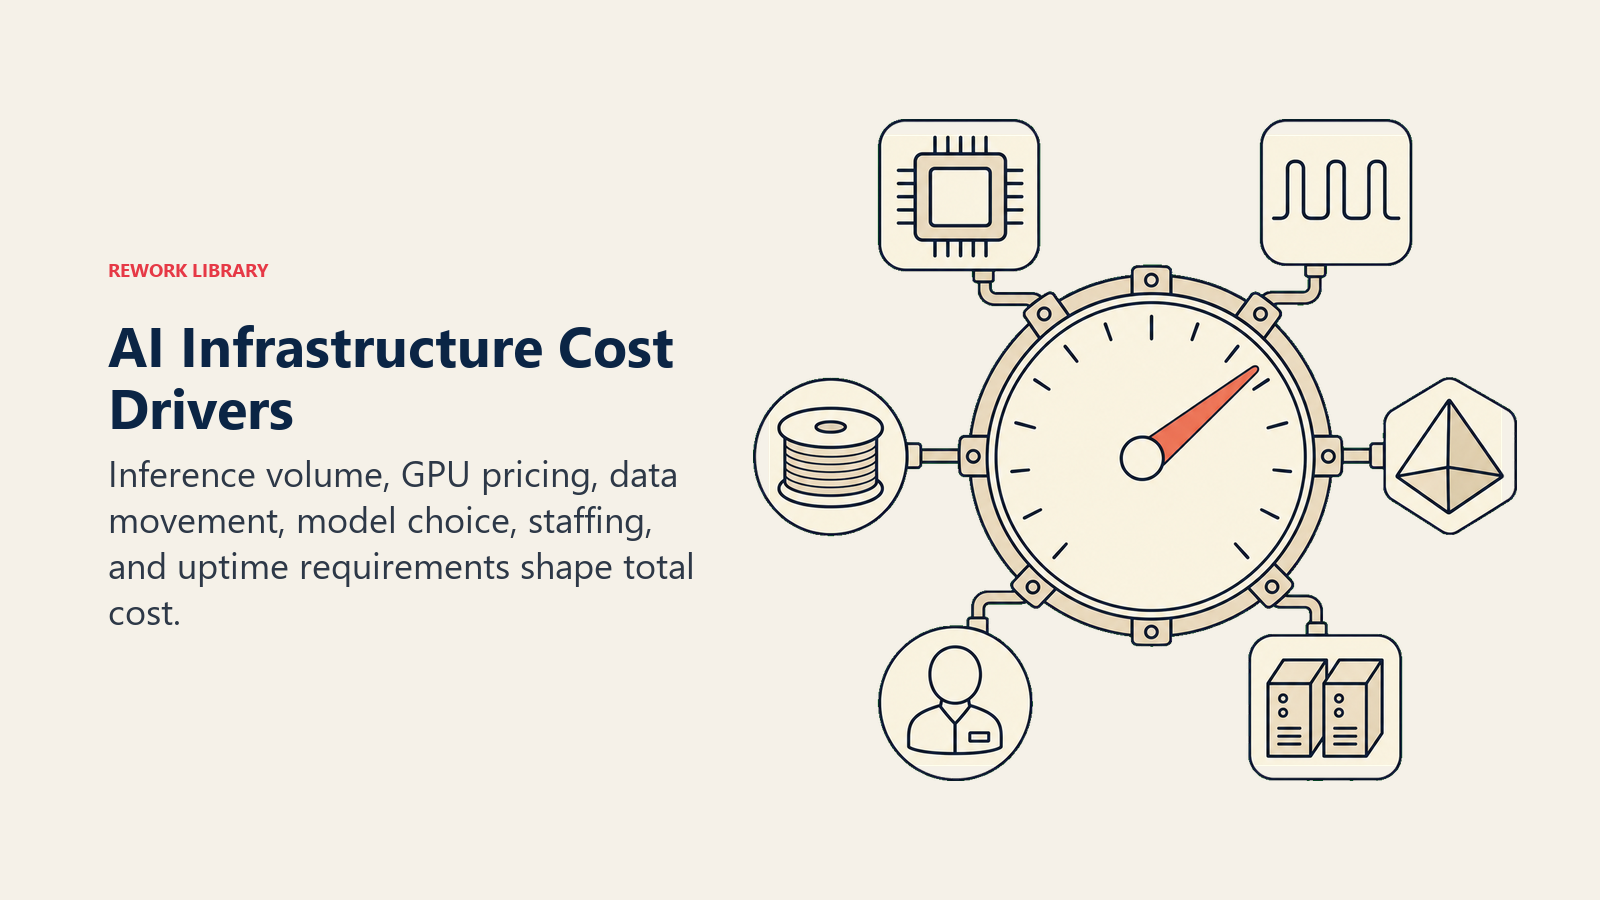
- Escassez e preço de GPU. A demanda por GPUs de classe fronteira ainda supera regularmente a oferta, e essa escassez se reflete diretamente no que os provedores de nuvem cobram pela computação.
- Volume de inferência, não de treinamento. A maioria das empresas nunca treina um modelo do zero. Sua conta é impulsionada pela inferência, o custo contínuo de cada consulta que um modelo em produção responde, que escala diretamente com o uso em vez de aparecer como um custo único.
- Movimentação e armazenamento de dados. Alimentar um modelo, especialmente um que faz recuperação sobre dados da empresa, significa armazenar e mover dados repetidamente, e as taxas de saída de dados da nuvem se acumulam rapidamente em escala.
- Escolha do modelo. Um modelo de fronteira custa mais por token do que um modelo menor, destilado ou comprimido por quantização que foi otimizado para fazer o mesmo trabalho por menos.
- Equipe. Alguém precisa ser responsável pelas camadas de orquestração e observabilidade. Talento em MLOps e LLMOps é escasso, e o quadro operacional para rodar infraestrutura de IA de forma confiável é um item de linha real e contínuo que a maioria das comparações de construir versus comprar subestima.
- Redundância e requisitos de disponibilidade. Um recurso de IA voltado ao cliente que não pode ficar fora do ar custa mais para operar do que uma ferramenta interna que pode tolerar falhas ocasionais, porque redundância significa pagar por capacidade que você nem sempre está usando.
Qualquer modelo sério de custo total de propriedade de IA precisa considerar os seis fatores, não apenas o preço de tabela de uma hora de GPU.
O Panorama da Infraestrutura de IA em 2026
Três coisas são verdadeiras sobre os gastos com infraestrutura de IA agora, e todas as três afetam o que sua empresa paga por IA.
Os gastos continuam subindo rapidamente. O Gartner projeta que os gastos globais com TI chegarão a $6,15 trilhões em 2026, um aumento de quase 11% ano a ano, com os gastos em sistemas de data center sozinhos ultrapassando $650 bilhões, ante pouco menos de $500 bilhões no ano anterior. As quatro maiores hyperscalers dos EUA, Amazon, Alphabet, Microsoft e Meta, projetaram um investimento combinado de capital de cerca de $725 bilhões para 2026, um aumento de cerca de 77% em relação ao recorde de $410 bilhões de 2025, com a grande maioria voltada à infraestrutura de IA.
O centro de gravidade está mudando do treinamento para a inferência. A Deloitte projeta que a inferência responderá por cerca de dois terços de toda a computação de IA em 2026, ante um terço em 2023 e metade em 2025, e que o mercado de chips otimizados para inferência crescerá para mais de $50 bilhões neste ano. Essa mudança importa para o planejamento de custos: o treinamento é uma despesa concentrada no início, mas o custo de inferência escala com cada interação do usuário, indefinidamente.
E as empresas estão trazendo cargas de trabalho de produção de volta da nuvem pública. A parcela de empresas que usam a nuvem pública como ambiente principal para inferência de IA em produção caiu 15 pontos percentuais em um ano, de 56% para 41%, enquanto 56% agora executam ou planejam executar inferência de produção em nuvem privada, em grande parte por previsibilidade de custo e controle de dados. Enquanto isso, a camada de hardware permanece concentrada: o segmento de data center da Nvidia sozinho gerou $193,7 bilhões no ano fiscal de 2026, um aumento de 68% ano a ano, um lembrete de que, mesmo com as cargas de trabalho migrando para inferência e implantação híbrida, o mercado de computação subjacente ainda é dominado por um pequeno número de fornecedores de chips e de nuvem.
Por Que a Infraestrutura de IA Importa para Líderes de Negócios
Nada disso é abstrato se sua empresa constrói ou compra ferramentas de IA. Algumas conclusões práticas para levar para qualquer decisão de infraestrutura de IA:
- Pergunte por qual camada você está realmente pagando. O preço de um fornecedor muitas vezes combina computação, orquestração e observabilidade. Conhecer as camadas permite perguntar quanto você pagaria se trocasse qualquer uma delas.
- O custo de inferência é o número a modelar, não o custo de treinamento. Se sua equipe está fazendo fine-tuning ou treinando seu próprio modelo, isso é uma despesa única. A conta contínua é a inferência, e ela escala com a adoção, o que é uma boa notícia quando um recurso faz sucesso e um problema de orçamento se ninguém planejou para isso.
- Híbrido agora é o padrão, não a exceção. A migração para nuvem privada na inferência de produção reflete preocupações reais de custo e controle, não apenas preferência. Pergunte a qualquer fornecedor onde sua carga de trabalho realmente roda e por quê.
- Risco de capacidade do fornecedor é uma questão real de due diligence. Se o roadmap de um provedor depende de acesso a GPU ou capital que ele não controla, isso é um ponto único de falha que vale a pena perguntar diretamente, da mesma forma que você avaliaria qualquer outro fornecedor crítico.
- Possuir infraestrutura raramente é o primeiro movimento certo. Para quase toda empresa, alugar computação e comprar acesso a uma camada de modelo gerenciada supera construir. Reserve a conversa sobre "possuir" para cargas de trabalho com volume sustentado, necessidades estritas de latência ou requisitos regulatórios que forcem a questão.
Dados Importantes
- Os gastos globais com TI devem chegar a $6,15 trilhões em 2026, um aumento de quase 11% ano a ano, com os gastos em sistemas de data center ultrapassando $650 bilhões, ante pouco menos de $500 bilhões em 2025. Gartner, via CIO.com
- A receita de semicondutores de data center deve chegar a $477,1 bilhões em 2026, com o segmento de data center "inteligente" (aceleradores de IA, GPUs, ASICs customizados e silício de rede) sozinho respondendo por $281 bilhões, a maior categoria identificável dentro dos semicondutores fora de memória. IDC
- O segmento de data center da Nvidia gerou $193,7 bilhões no ano fiscal de 2026, um aumento de 68% ano a ano, incluindo um recorde de $62,3 bilhões somente no quarto trimestre, um aumento de 75%. Nvidia
- A inferência deve responder por cerca de dois terços de toda a computação de IA em 2026, ante um terço em 2023 e metade em 2025, com o mercado de chips otimizados para inferência projetado para ultrapassar $50 bilhões neste ano. Deloitte
- A parcela de empresas que usam a nuvem pública como ambiente principal para inferência de IA em produção caiu 15 pontos percentuais em um ano, de 56% para 41%, enquanto 56% agora executam ou planejam executar inferência de produção em nuvem privada. Broadcom
- As quatro maiores hyperscalers dos EUA projetaram um investimento combinado de capital de cerca de $725 bilhões para 2026, um aumento de cerca de 77% em relação ao recorde de 2025 de $410 bilhões, com a grande maioria destinada à infraestrutura de IA. CNBC
- O Gartner prevê que 40% das organizações que implantam IA usarão ferramentas dedicadas de observabilidade de IA para monitorar desempenho, viés e resultados de modelos até 2028. Gartner
Perguntas Frequentes sobre AI Infrastructure
O que é infraestrutura de IA em termos simples?
Infraestrutura de IA é toda a pilha tecnológica necessária para construir, implantar e executar modelos de IA: computação GPU, a nuvem e a rede que a conectam, os pipelines de dados que alimentam os modelos, a própria camada de modelo, e as ferramentas de orquestração e observabilidade que mantêm tudo confiável quando usuários reais dependem disso.
Quais são as principais camadas da infraestrutura de IA?
As camadas centrais são computação e hardware (GPUs e aceleradores), nuvem e rede (capacidade e interconexões), o pipeline de dados (coleta e movimentação de dados), a camada de modelo (o modelo treinado que faz o raciocínio), o model serving (implantá-lo para tráfego em produção), orquestração (coordenar fluxos de trabalho e implantação) e observabilidade (monitorar custo, latência e qualidade em produção).
Como a infraestrutura de IA difere de um data center de IA?
Um data center de IA é a instalação física que abriga GPUs e sistemas de resfriamento, uma camada da pilha. Infraestrutura de IA é mais ampla: inclui essa camada de hardware mais os serviços de nuvem, pipelines de dados, camada de modelo, orquestração e ferramentas de observabilidade construídas sobre ela, independentemente de em qual data center ela roda fisicamente.
Uma empresa deve construir sua própria infraestrutura de IA ou comprá-la?
Para quase toda empresa, alugar computação e comprar acesso a uma camada de modelo gerenciada é o padrão certo. Construir a própria só faz sentido para setores regulados, cargas de trabalho sensíveis à latência, ou volume de uso alto o suficiente para que possuir hardware compense alugá-lo no longo prazo.
O que impulsiona o custo da infraestrutura de IA?
Os maiores fatores são escassez e preço de GPU, volume contínuo de inferência (não de treinamento, que geralmente é um custo único), movimentação e armazenamento de dados, qual modelo você escolhe, equipe de MLOps e LLMOps, e a redundância necessária para cargas de trabalho sensíveis à disponibilidade.
Qual a diferença entre MLOps e infraestrutura de IA?
Infraestrutura de IA é a pilha completa, do hardware à observabilidade. MLOps é a disciplina operacional, e as ferramentas, que rodam sobre essa pilha para implantar, monitorar e manter modelos de forma confiável. MLOps depende da existência da infraestrutura de IA; não substitui nenhuma de suas camadas.
Pequenas e médias empresas precisam de sua própria infraestrutura de IA?
Quase nunca de hardware próprio. A maioria das pequenas e médias empresas consome infraestrutura de IA indiretamente, por meio de um produto SaaS ou de uma API de modelo, e nunca toca diretamente nas camadas de computação, pipeline de dados ou serving. As decisões de infraestrutura que importam para elas costumam ser sobre em qual fornecedor confiar, não em quais chips comprar.
O que está mudando na infraestrutura de IA em 2026?
Duas mudanças se destacam: os gastos estão migrando do treinamento para a inferência, já que a inferência agora representa cerca de dois terços da computação de IA e escala com o uso em vez de ser um custo único, e as empresas estão trazendo cargas de trabalho de produção de volta da nuvem pública para nuvem privada e configurações híbridas, por previsibilidade de custo e controle de dados.
Conceitos Relacionados de IA
- O Que É um Data Center de IA? - A camada de instalação física dentro da pilha mais ampla de infraestrutura de IA
- MLOps - A disciplina operacional que roda sobre a infraestrutura de IA para manter os modelos confiáveis
- O Que É LLMOps? - MLOps aplicado especificamente a aplicações de grandes modelos de linguagem
- Model Serving - Como um modelo treinado é implantado para responder ao tráfego real de produção
- Observabilidade de IA - A camada de monitoramento que detecta problemas de custo, latência e qualidade em produção
- Custo Total de Propriedade de IA - Como a economia da infraestrutura se traduz no que uma empresa realmente paga por IA
- Construir versus Comprar em IA - O framework para decidir quais camadas de infraestrutura possuir versus alugar
- Edge AI - A alternativa à infraestrutura centralizada para cargas de trabalho sensíveis à latência
- Modelos de Fundação - Os modelos pré-treinados que ocupam a camada de modelo da pilha
- Inferência - A carga de trabalho de produção que hoje impulsiona a maior parte do custo de infraestrutura de IA
Recursos Externos
- Gartner: Gastos com TI Devem Superar $6 Trilhões até 2026 (via CIO.com) - Previsão de gastos globais com TI e data center
- IDC: Previsão do Mercado de Semicondutores, o Superciclo de IA - Previsão de semicondutores de data center e do segmento de data center "inteligente"
- Nvidia: Resultados Financeiros do Quarto Trimestre e do Ano Fiscal de 2026 - Receita e crescimento do segmento de data center
- Deloitte: Poder de Computação para IA, Previsões de TMT para 2026 - Participação da inferência na computação e previsão do mercado de chips de inferência
- Broadcom: O Ponto de Inflexão da IA, Perspectivas de Nuvem Privada 2026 - Migração das empresas da nuvem pública para a nuvem privada na inferência de IA em produção
Parte da Coleção de Termos de IA. Última atualização: 2026-07-20

Co-Founder, Rework.com
On this page
- As Camadas da Pilha de Infraestrutura de IA
- Infraestrutura de IA versus um Data Center de IA
- Construir versus Comprar: Como as Empresas Realmente Montam a Pilha
- O Que Impulsiona os Custos de Infraestrutura de IA
- O Panorama da Infraestrutura de IA em 2026
- Por Que a Infraestrutura de IA Importa para Líderes de Negócios
- Dados Importantes
- Conceitos Relacionados de IA
- Recursos Externos