Qu'est-ce qu'un grand modèle de langage ? La révolution de l'IA dans le langage humain
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
En 2023, ChatGPT a atteint 100 millions d'utilisateurs en seulement deux mois. À la mi-2026, cette curiosité des débuts est devenue une infrastructure du quotidien : Claude, GPT-5.6 et Gemini 3.2 Pro traitent chaque jour des millions de documents d'entreprise, de contrats et de bases de code. Ces grands modèles de langage (LLM, pour Large Language Models) ne sont pas de simples chatbots : ils changent en profondeur la manière dont les entreprises fonctionnent, communiquent et créent de la valeur. Le paysage des modèles a lui-même évolué à toute vitesse, passant d'une poignée d'assistants conversationnels généralistes à un mélange de spécialistes du raisonnement, de modèles économiques et robustes, et d'alternatives open-weight qui rivalisent avec la pointe du marché. Mais qu'est-ce qui les rend si puissants, et qu'est-ce qui a changé pour en arriver là ?
La technologie derrière l'engouement
Les grands modèles de langage sont l'aboutissement de décennies de recherche en traitement automatique du langage naturel, mais la percée date de 2017, avec l'architecture transformer. Le terme « grand » renvoie à leurs milliards de paramètres, des valeurs ajustables qui encodent la compréhension du langage.
Selon l'AI Lab de Stanford, les LLM se définissent comme des « modèles de réseaux de neurones entraînés sur de vastes volumes de textes pour comprendre et générer le langage humain en prédisant le mot suivant d'une séquence, et qui développent des capacités émergentes bien au-delà de la simple complétion de texte ».
La révolution a démarré avec GPT-3 d'OpenAI en 2020, qui a montré que des modèles suffisamment grands pouvaient accomplir des tâches pour lesquelles ils n'avaient pas été entraînés explicitement, de l'écriture de code à l'analyse de contrats.
Ce que cela signifie pour l'entreprise
Pour les dirigeants, les LLM sont des systèmes d'IA capables de lire, d'écrire, d'analyser et de raisonner en langage humain à un niveau proche de l'expertise humaine, avec la vitesse et l'échelle d'un ordinateur.
Imaginez un assistant très instruit qui a lu à peu près tout ce qui a jamais été écrit, qui travaille 24 h/24, n'oublie rien et peut mener des milliers de conversations en même temps. Contrairement à un logiciel traditionnel qui suit des scripts, un LLM comprend le contexte, les nuances et l'intention.
Concrètement, c'est une IA qui peut rédiger vos e-mails, analyser vos contrats, répondre aux questions de vos clients, écrire votre code et même vous aider à élaborer votre stratégie, le tout en langage naturel.
L'architecture de la compréhension
Les LLM reposent sur les éléments essentiels suivants :
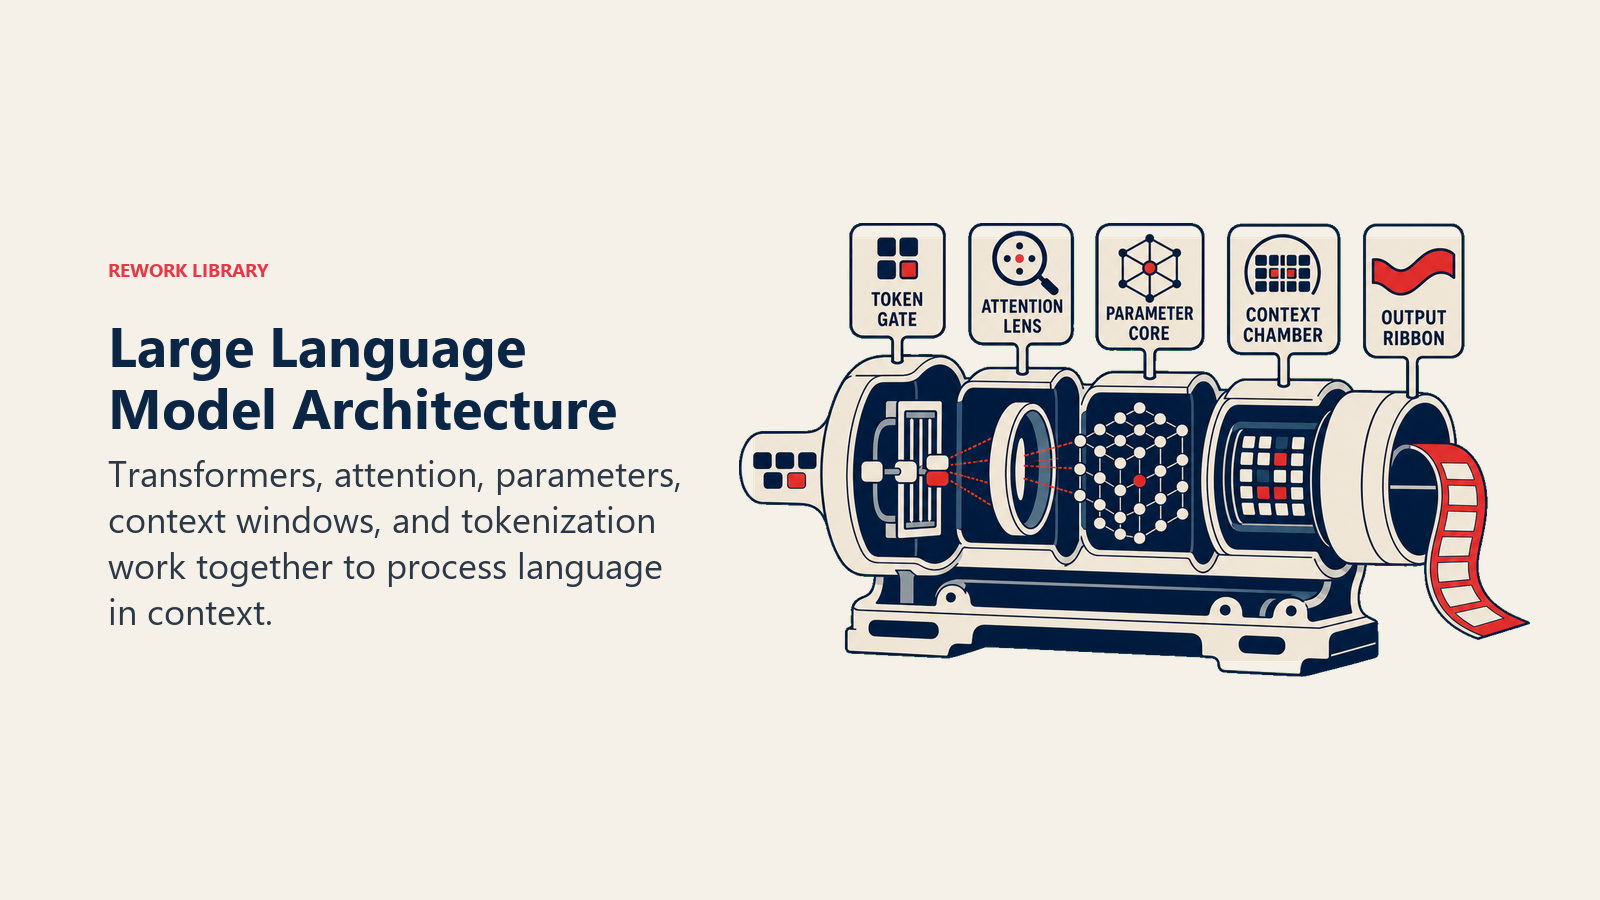
• Architecture transformer : la conception de réseau de neurones qui traite les mots en contexte et comprend que « bank » ne signifie pas la même chose dans « river bank » (la rive d'un cours d'eau) et dans « investment bank » (la banque d'investissement)
• Mécanismes d'attention : des systèmes qui déterminent quels mots d'une phrase sont liés entre eux, pour saisir des relations et des dépendances complexes
• Milliards de paramètres : la « connaissance » encodée dans des poids numériques, qui représentent les motifs appris à partir des données d'entraînement
• Fenêtre de contexte : la quantité de texte que le modèle peut prendre en compte en une seule fois. Les premiers modèles de l'ère GPT-3 plafonnaient autour de 4 000 tokens ; à la mi-2026, les modèles de pointe comme Gemini 3.2 Pro atteignent jusqu'à 2 millions de tokens, et les fenêtres d'un million de tokens (Claude Opus 4.8, GPT-5.6 Sol) sont désormais courantes en haut de gamme
• Système de tokenisation : la manière dont le texte est découpé en unités traitables, ce qui permet de comprendre n'importe quelle langue, et même du code
Comment les LLM traitent le langage
Le traitement par un LLM suit ces étapes :
Tokenisation de l'entrée : votre texte est converti en tokens (fragments de mots), chacun recevant une représentation numérique que le modèle sait traiter
Analyse du contexte : l'architecture transformer examine tous les tokens simultanément et comprend les relations et le sens grâce aux mécanismes d'attention
Génération de la prédiction : à partir des motifs appris pendant l'entraînement, le modèle prédit les tokens suivants les plus probables et génère des réponses cohérentes et contextualisées
Cela se produit des milliards de fois par seconde et produit un texte fluide et pertinent, souvent impossible à distinguer d'une rédaction humaine.
Les catégories de grands modèles de langage
Les LLM se répartissent généralement en quatre grands types :
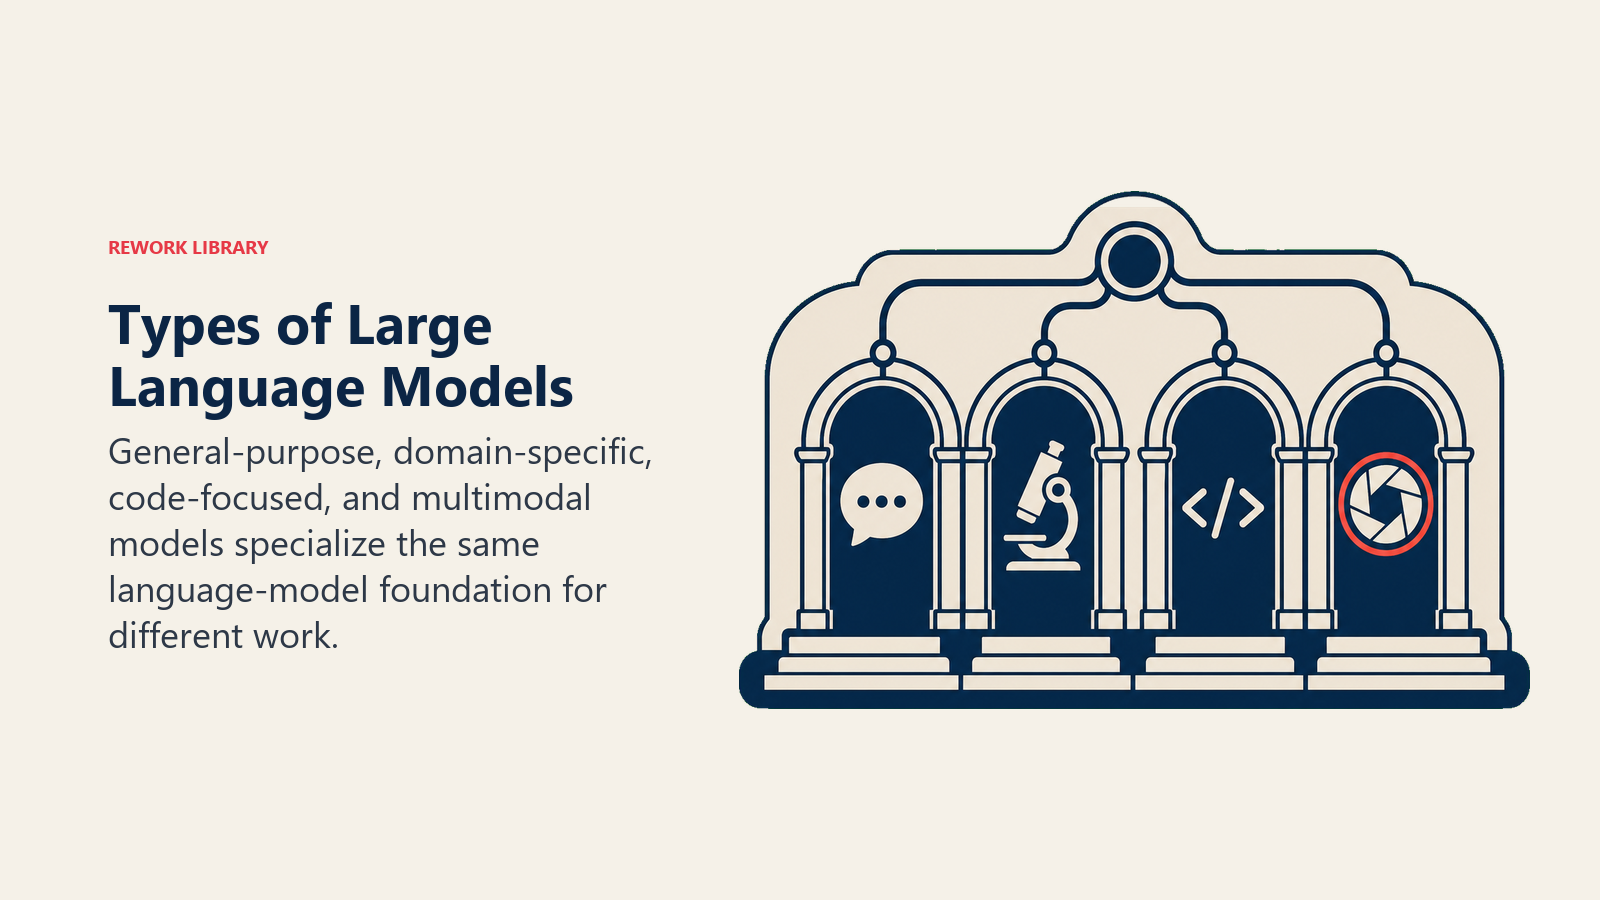
Type 1 : modèles généralistes Idéal pour : un large éventail de tâches, de la rédaction à l'analyse Caractéristique clé : connaissances et capacités étendues Exemples : GPT-5.6, Claude Opus 4.8, Gemini 3.2 Pro
Type 2 : modèles spécialisés par domaine Idéal pour : les applications propres à un secteur Caractéristique clé : affinés (fine-tuning) sur des données spécialisées Exemples : BloombergGPT pour la finance, Med-PaLM pour la santé
Type 3 : modèles orientés code Idéal pour : le développement logiciel et les tâches techniques Caractéristique clé : entraînés sur des langages de programmation Exemples : GitHub Copilot, Claude Code et des spécialistes du code open-weight comme Qwen3-Coder
Type 4 : modèles multimodaux Idéal pour : les tâches mêlant texte, images, vidéo et autres médias Caractéristique clé : comprennent et génèrent plusieurs formats Exemples : GPT-5.6 (vision native), Gemini 3.2 Pro (raisonnement vidéo natif)
Deux évolutions transversales comptent davantage que les étiquettes de catégories. D'abord, la plupart des modèles de pointe de 2026 proposent désormais un mode de raisonnement (parfois appelé « extended thinking » ou « deep think ») qui sacrifie la vitesse pour résoudre pas à pas des problèmes de mathématiques, de code ou de logique métier en plusieurs étapes : le raisonnement n'est plus un type de modèle à part. Ensuite, les modèles open-weight (Llama, Qwen, DeepSeek, Mistral) ont comblé l'essentiel de l'écart de performance avec les modèles propriétaires de pointe, pour une fraction du coût. La décision d'achat ne se limite donc plus à « quel laboratoire », mais à « modèle de pointe fermé, modèle open-weight, ou modèle plus petit et moins cher, suffisant pour la tâche ».
Points clés
- Les investissements mondiaux des entreprises dans l'IA ont atteint 581,7 milliards de dollars en 2025 (dont 344,7 milliards de capitaux privés), les seuls États-Unis y consacrant 285,9 milliards de dollars, soit 23 fois les 12,4 milliards de dollars de la Chine. Stanford HAI AI Index 2026
- L'IA générative a atteint 53 % d'adoption dans la population en trois ans après le lancement de ChatGPT, une courbe plus rapide que celle de l'ordinateur personnel ou d'internet. Stanford HAI AI Index 2026
- L'écart de performance entre le meilleur modèle fermé et le meilleur modèle open-weight s'est réduit à environ 3 points de pourcentage début 2026, contre un écart nettement plus large un an plus tôt. Stanford HAI AI Index 2026
- Les dépenses des entreprises en IA générative ont atteint 37 milliards de dollars en 2025, soit 3,2 fois les 11,5 milliards de dollars de 2024, les applications captant désormais plus de la moitié de ce montant. Menlo Ventures, 2025 State of Generative AI in the Enterprise
- Anthropic détient environ 40 % des dépenses d'API LLM des entreprises (contre 12 % en 2023), tandis que la part d'OpenAI est tombée à 27 % (contre 50 %), les acheteurs répartissant leurs charges de travail entre davantage de fournisseurs. Menlo Ventures, 2025 State of Generative AI in the Enterprise
- Le prix pour atteindre un niveau de performance LLM donné a baissé de 9 à 900 fois par an selon le benchmark, le rythme médian s'accélérant à environ 200 fois par an depuis janvier 2024. Epoch AI, LLM inference price trends
- 88 % des organisations déclarent utiliser régulièrement l'IA dans au moins une fonction, contre 78 % un an plus tôt, même si la plupart affirment ne pas encore avoir capté de valeur « significative » à l'échelle de l'entreprise. McKinsey, The State of AI
Les LLM au service de la transformation des entreprises
Voici comment les entreprises utilisent réellement les LLM, avec quelques leçons difficiles tirées des deux dernières années :
Exemple du service client : l'expérience menée par Klarna en 2023 (remplacer environ 700 agents du support par un assistant LLM traitant les deux tiers des demandes) est devenue l'histoire qui sert de mise en garde dans le secteur. En 2025, l'entreprise réembauchait des agents humains après une baisse de la satisfaction sur les dossiers complexes, et son CEO admettait : « Nous nous sommes trop concentrés sur l'efficacité et les coûts. » Le modèle actuel de Klarna, celui vers lequel la plupart des grandes entreprises convergent en 2026, est hybride : les LLM résolvent instantanément les demandes courantes, et les humains prennent le relais dès qu'il faut de l'empathie ou du jugement.
Exemple du juridique : A&O Shearman (issu de la fusion en 2024 d'Allen & Overy et de Shearman & Sterling) déploie désormais son module ContractMatrix Analyze, développé avec Harvey et Microsoft, auprès de plus de 4 000 juristes dans 43 juridictions. Les premiers utilisateurs rapportent une précision supérieure à 95 % sur la revue fondée sur des playbooks, une réduction de 30 % du temps de revue des contrats et environ 2 à 3 heures gagnées par juriste et par semaine.
Exemple du développement logiciel : le code généré par l'IA n'est plus une nouveauté. GitHub indique que Copilot génère désormais de l'ordre de 46 % du code écrit sur la plateforme, en phase avec les estimations du secteur selon lesquelles 41 à 46 % du nouveau code est assisté par l'IA en 2026. Replit compte à lui seul plus de 500 000 utilisateurs professionnels et une présence dans 85 % des entreprises du Fortune 500.
Ce qui a changé en 2026
Plusieurs éléments distinguent le paysage actuel des LLM de celui d'il y a seulement un an :
- Le raisonnement est devenu un standard, pas un produit à part. La plupart des modèles de pointe (Claude Opus 4.8, GPT-5.6 Sol, Gemini 3.2 Pro) proposent désormais un mode de raisonnement ou de « réflexion » que l'on active pour les problèmes difficiles, sans qu'un modèle dédié au seul raisonnement soit nécessaire.
- Les modèles open-weight sont assez proches pour compter. Les meilleurs modèles open-weight accusent un retard d'environ 3 points de pourcentage sur les meilleurs modèles fermés dans les benchmarks de capacités, contre un écart bien plus grand un an plus tôt, d'où le nombre croissant d'entreprises qui combinent modèles de pointe et modèles open-weight selon la tâche.
- Le coût des tokens a continué de s'effondrer. Atteindre le même niveau de performance coûte désormais une fraction de ce qu'il coûtait en 2024, le rapport prix-performance s'améliorant de plusieurs centaines de pourcents par an sur plusieurs benchmarks. C'est ce qui rend économiquement viable l'usage des LLM dans tous les workflows, et pas seulement dans les cas d'usage phares.
- La fenêtre de contexte n'est plus le goulot d'étranglement. Avec des fenêtres de plus d'un million de tokens, les modèles peuvent désormais ingérer en une seule passe des bases de code entières, des ensembles de contrats ou des trimestres de documents financiers.
- Le marché est revenu de l'effet d'annonce. Le revirement public de Klarna sur un service client entièrement automatisé, et le constat de McKinsey selon lequel la plupart des entreprises n'ont pas encore capté de valeur « significative » de l'IA générative, ont fait passer le débat de « remplacer les personnes » à « associer les LLM à une supervision humaine adaptée ».
Se lancer avec les LLM
Prêt à tirer parti des LLM dans votre entreprise ?
- Apprenez à interagir avec eux grâce aux techniques de prompt engineering
- Comprenez leurs limites, comme l'hallucination de l'IA
- Explorez l'intégration via les API d'IA
- Envisagez des cadres de gouvernance de l'IA pour un déploiement responsable
Ressources associées
Explorez ces concepts d'IA connexes pour approfondir votre compréhension :
- IA générative - La catégorie plus large des systèmes d'IA qui créent de nouveaux contenus
- Apprentissage profond (deep learning) - La technologie fondatrice des LLM modernes
- Modèles de fondation - Des modèles pré-entraînés qui servent de base à des applications spécialisées
- IA conversationnelle - Comment les LLM permettent un dialogue naturel entre l'humain et la machine
Ressources externes
- OpenAI GPT Research Papers - Documentation technique sur le développement des grands modèles de langage
- Anthropic's Claude Technical Documentation - Sécurité et capacités des LLM modernes
- Google DeepMind LLM Research - Perspectives académiques sur l'architecture des modèles de langage
Questions fréquentes sur les grands modèles de langage
Que sont les grands modèles de langage (LLM) ?
Les LLM sont des systèmes d'IA dotés de milliards de paramètres, entraînés sur de vastes volumes de textes pour comprendre et générer le langage humain, et capables d'accomplir des tâches allant de la rédaction à l'analyse en passant par le raisonnement.
Quelle différence entre un LLM et un chatbot ?
Les chatbots traditionnels suivent des réponses scriptées. Les LLM comprennent le contexte, génèrent des contenus originaux et peuvent accomplir des tâches variées au-delà de la conversation, du code à l'analyse en passant par l'écriture créative.
Quels sont les quatre types de LLM ?
Les modèles généralistes (GPT-5.6, Claude Opus 4.8, Gemini 3.2 Pro), les modèles spécialisés par domaine (BloombergGPT pour la finance), les modèles orientés code (GitHub Copilot, Claude Code) et les modèles multimodaux (qui traitent texte, images et vidéo).
Qu'est-ce qu'un « modèle de raisonnement », et en ai-je besoin ?
Un modèle de raisonnement consacre davantage de calcul à résoudre un problème étape par étape avant de répondre, ce qui aide sur les mathématiques, le code et la logique métier en plusieurs étapes. La plupart des modèles de pointe de 2026 l'offrent sous forme d'option à activer plutôt que de produit distinct : utilisez-la pour les problèmes difficiles et laissez-la de côté pour les recherches simples afin de limiter le coût et la latence.
Les LLM open-weight sont-ils assez bons pour remplacer les modèles propriétaires ?
Pour de nombreuses tâches, oui. Les meilleurs modèles open-weight ne sont désormais qu'à quelques points de pourcentage des meilleurs modèles fermés sur les benchmarks de capacités, tout en coûtant souvent bien moins cher à exploiter. Une part croissante des entreprises combine donc modèles open-weight et modèles de pointe selon la charge de travail, plutôt que de se standardiser sur un seul.
Qu'est-ce qu'un paramètre dans un LLM ?
Les paramètres sont des valeurs numériques ajustables qui encodent les connaissances apprises par le modèle. Plus il y a de paramètres, plus le modèle a en général de capacité à comprendre des motifs et des relations linguistiques complexes, même si des modèles plus petits et plus récents égalent de plus en plus les anciens modèles plus grands grâce à un meilleur entraînement.
Fait partie de la [Collection Glossaire de l'IA]. Dernière mise à jour : 2026-07-16

Co-Founder, Rework.com
On this page
- La technologie derrière l'engouement
- Ce que cela signifie pour l'entreprise
- L'architecture de la compréhension
- Comment les LLM traitent le langage
- Les catégories de grands modèles de langage
- Points clés
- Les LLM au service de la transformation des entreprises
- Ce qui a changé en 2026
- Se lancer avec les LLM
- Ressources associées
- Ressources externes