¿Qué es un Centro de Datos de IA?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Actualizado en julio de 2026
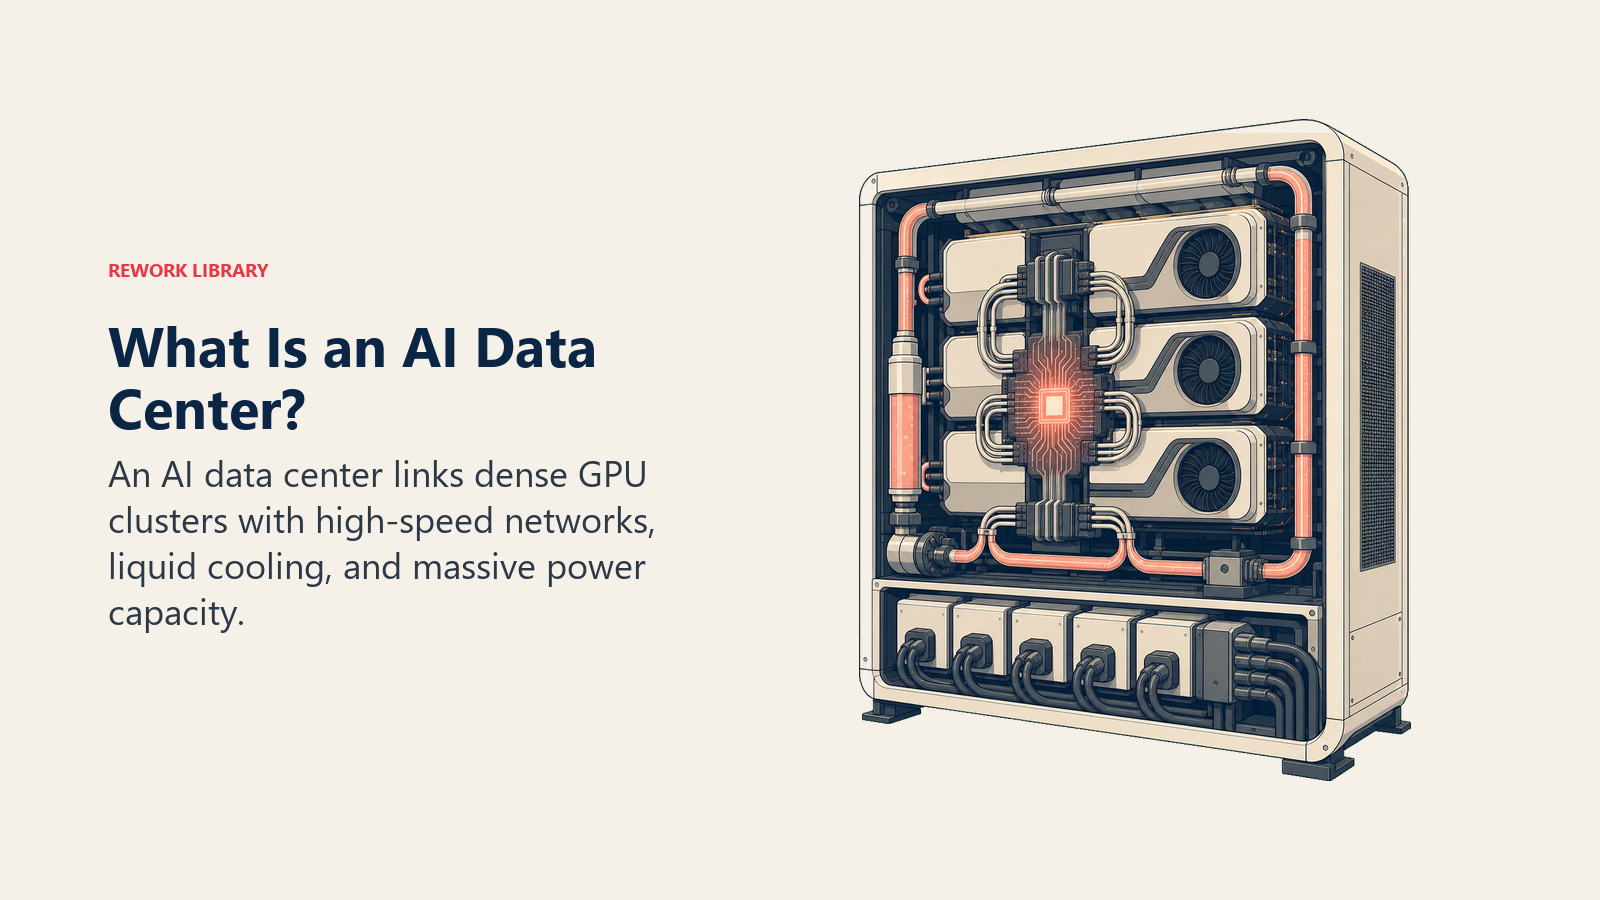
Un centro de datos de IA es una instalación especializada repleta de GPU y otros aceleradores de IA, construida específicamente para entrenar y ejecutar modelos de IA a una escala masiva. A diferencia de un centro de datos de uso general, está diseñado en torno a una densidad de energía extrema, redes de chip a chip de alta velocidad y refrigeración de alta capacidad, las cosas para las que una instalación tradicional que ejecutaba servidores de correo y sitios web nunca fue diseñada.
Para los líderes empresariales, la distinción importa porque explica por qué la IA es costosa y por qué la capacidad es limitada. Cada respuesta de un chatbot, cada pronóstico generado por IA, cada modelo que su equipo ajusta se ejecuta sobre una infraestructura que cuesta más construir, más alimentar y más enfriar que los centros de datos que hicieron funcionar internet durante las últimas dos décadas. Entender qué hay realmente dentro de un centro de datos de IA hace mucho más fácil leer los precios de un proveedor, la lista de espera de capacidad de un proveedor de nube o un titular sobre un nuevo campus de $10 mil millones, y saber qué es lo que realmente impulsa esa cifra.
En Qué Se Diferencia un Centro de Datos de IA de un Centro de Datos Tradicional
Un centro de datos tradicional fue construido para un trabajo distinto: alojar sitios web, ejecutar bases de datos, almacenar archivos y servir aplicaciones donde un solo chip de servidor hacía la mayor parte del trabajo por sí solo. Un centro de datos de IA existe para mover enormes cantidades de datos entre miles de chips a la vez, por lo que casi cada decisión de diseño cambia.
| Aspecto | Centro de Datos Tradicional | Centro de Datos de IA |
|---|---|---|
| Densidad de energía por rack | Aproximadamente de 5 a 10 kilovatios | A menudo de 40 a más de 130 kilovatios, con los racks de GPU más nuevos superando los 120 kilovatios |
| Método de refrigeración | Refrigeración por aire mediante pisos elevados y unidades CRAC | Refrigeración líquida directa al chip o refrigeración por inmersión, porque el aire solo no puede eliminar el calor con suficiente rapidez |
| Redes | Ethernet estándar, ajustado para muchas solicitudes independientes | Tejidos de alto ancho de banda y baja latencia como NVLink e InfiniBand, ajustados para que miles de GPU actúen como una sola máquina |
| Hardware de cómputo | CPU de uso general | GPU y otros aceleradores, a menudo miles por clúster, trabajando en paralelo en un solo trabajo |
| Carga de trabajo principal | Atender muchas solicitudes pequeñas e independientes | Entrenar y ejecutar modelos grandes que necesitan que cada chip hable constantemente con todos los demás |
| Costo de construcción por megavatio | Menor, construcción estándar | Sustancialmente mayor, debido a la infraestructura de energía, la planta de refrigeración líquida y las redes especializadas |
La conclusión práctica: un centro de datos tradicional está optimizado para atender muchos trabajos pequeños y separados a bajo costo. Un centro de datos de IA está optimizado para hacer que miles de chips costosos trabajen juntos en un solo trabajo enorme, y esa diferencia de propósito es lo que impulsa cada diferencia de diseño.
Componentes Clave Dentro de un Centro de Datos de IA
Al quitar el marketing, todo centro de datos de IA está construido a partir de un puñado de piezas centrales.
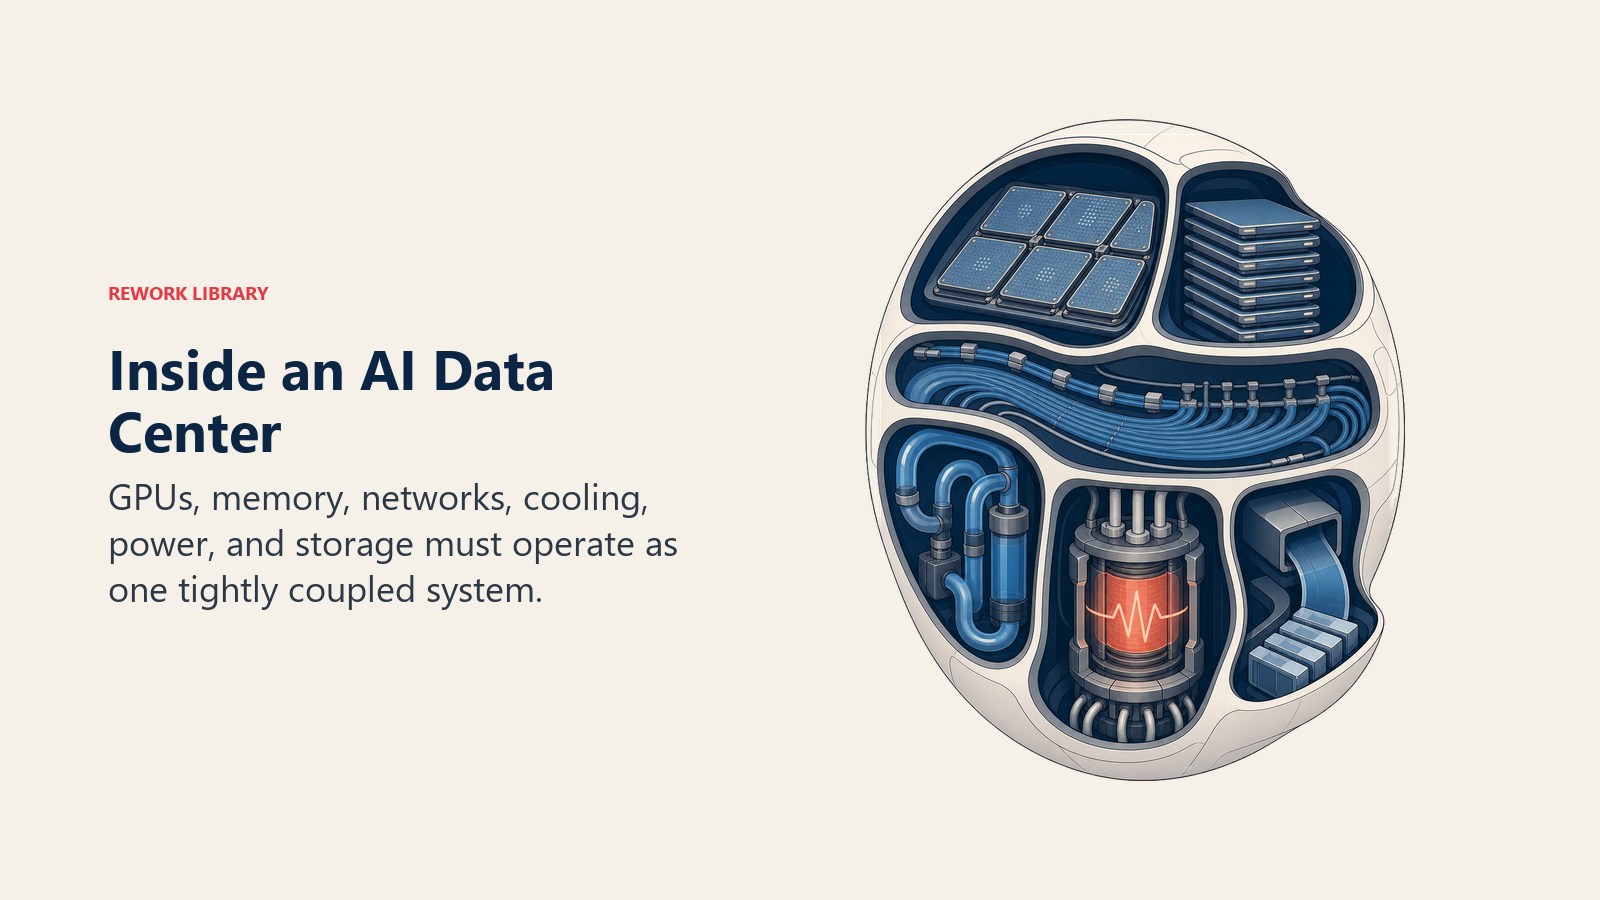
- GPU y aceleradores de IA: Los motores de cómputo que hacen las matemáticas reales, chips como las GPU H100, H200 y de la generación Blackwell de Nvidia, los aceleradores de la serie MI de AMD, las TPU de Google y una ola creciente de silicio personalizado construido por los propios hyperscalers. Aquí es donde realmente se entrenan y ejecutan los Large Language Models y otros Foundation Models.
- Memoria de alto ancho de banda (HBM): Memoria apilada justo al lado del die de la GPU para poder alimentar datos al chip con la rapidez suficiente para mantenerlo ocupado. El tamaño y la velocidad del modelo a menudo están limitados por cuánta HBM tiene un chip, no solo por qué tan rápido puede calcular.
- Interconexión y tejido de red: Las conexiones de chip a chip y de rack a rack (NVLink dentro de un servidor, InfiniBand o Ethernet de alta velocidad entre servidores) que permiten que miles de GPU funcionen como una sola computadora gigante en lugar de miles de computadoras separadas. Esta es la pieza que más gente subestima: un clúster es tan rápido como su conexión más lenta.
- Sistemas de refrigeración líquida: Placas frías directas al chip o tanques de inmersión completa que retiran el calor de racks que funcionan mucho más calientes que cualquier cosa para la que se construyó una instalación tradicional.
- Infraestructura de energía: Subestaciones dedicadas, generación de respaldo en el sitio y, cada vez más, almacenamiento en baterías, porque un solo campus de IA puede consumir tanta energía como una ciudad pequeña.
- Almacenamiento y pipeline de datos: Sistemas de almacenamiento rápidos que mantienen los datos de entrenamiento fluyendo hacia las GPU sin convertirse en el cuello de botella, además de los sistemas que gestionan el Model Serving una vez que un modelo está entrenado y listo para tráfico de producción.
La Expansión de Centros de Datos de IA 2025-2026
La escala de construcción que ocurre en este momento es la expansión de infraestructura más rápida en la historia de la tecnología. Los cuatro mayores hyperscalers estadounidenses, Amazon, Alphabet (Google), Microsoft y Meta, proyectaron en conjunto aproximadamente $725 mil millones en gasto de capital para 2026, cerca de un 77% más que el ya récord de $410 mil millones de 2025, según reportes sobre sus proyecciones de resultados. De forma individual, eso se desglosa en aproximadamente $200 mil millones en Amazon, de $185 a $190 mil millones en Alphabet, de $125 a $145 mil millones en Meta y alrededor de $120 mil millones en Microsoft, la gran mayoría destinada a infraestructura de IA.
Tres fuerzas impulsan ese gasto. Los costos de entrenamiento de los modelos de frontera siguen escalando con el cómputo disponible, de modo que quien tenga más GPU puede construir el modelo más capaz. La demanda de inferencia, el cómputo necesario para realmente ejecutar productos de IA una vez que están en vivo, está creciendo más rápido de lo que la mayoría de los proveedores puede agregar capacidad, ya que cada consulta de usuario, cada tarea de agente de IA y cada paso de razonamiento de Test-Time Compute consume tiempo de GPU. Y cada hyperscaler está compitiendo por construir chips propietarios para reducir su dependencia de Nvidia y bajar el costo por unidad de salida de IA, junto con técnicas como la cuantización que exprimen más rendimiento del hardware ya instalado.
El resultado se manifiesta en el mundo físico como campus multigigavatio en construcción en Texas, Luisiana, Wisconsin y una docena más de estados, además de una ola paralela de expansiones soberanas en los estados del Golfo, Europa y Asia (vea Sovereign AI), a medida que los gobiernos deciden que no quieren que su capacidad de IA dependa del centro de datos de otra persona.
Impacto en Energía, Agua y Red Eléctrica
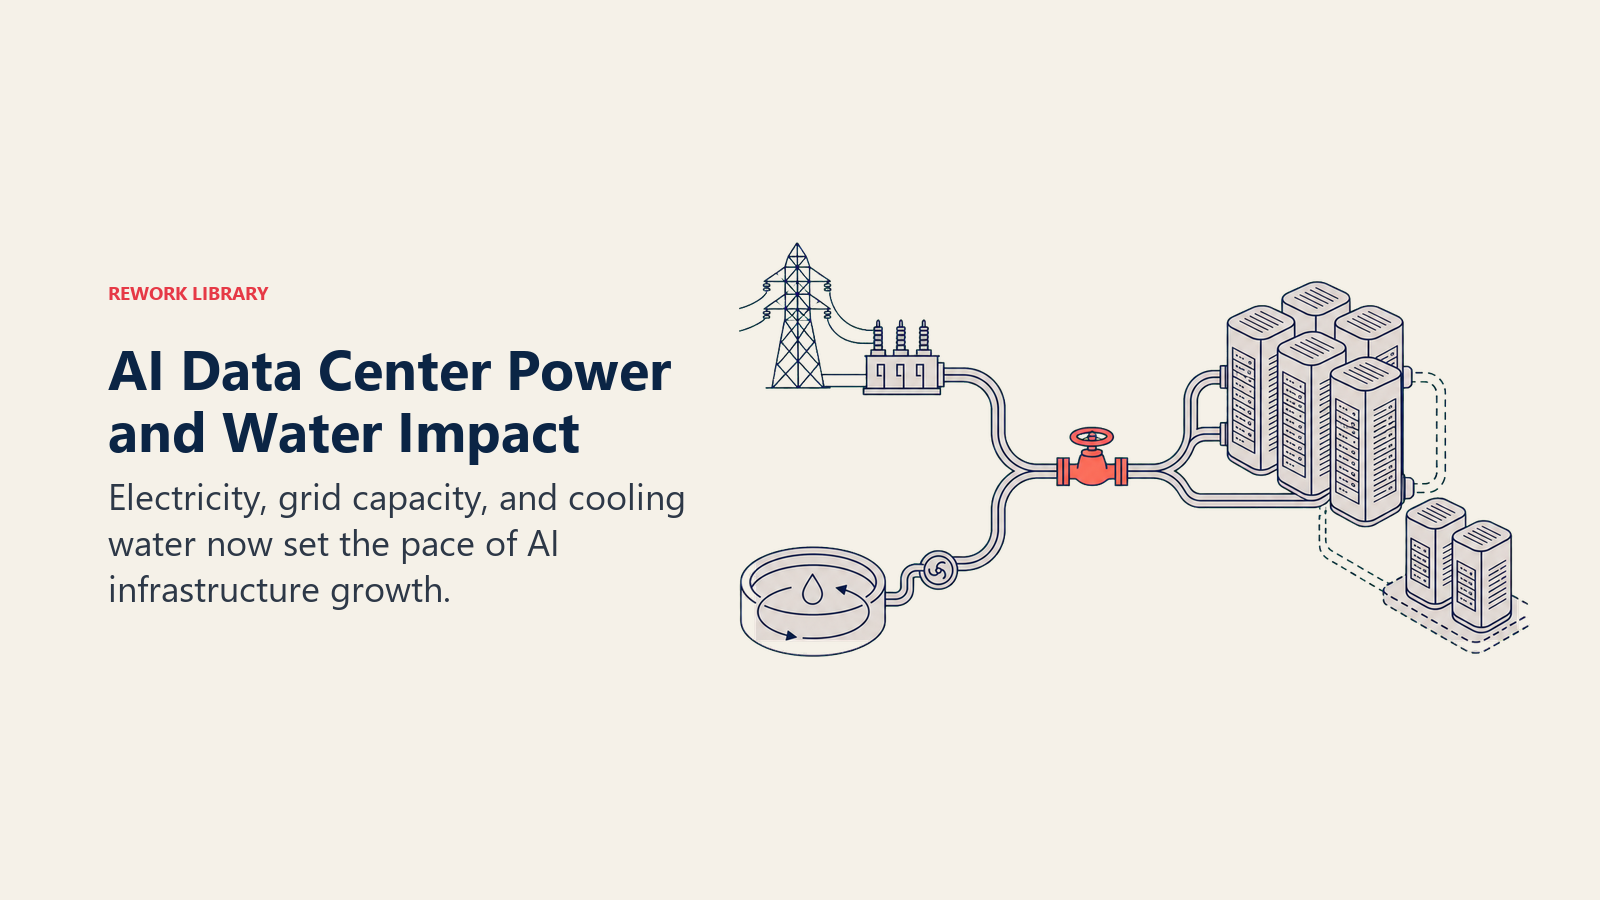
La mayor restricción de la expansión no son los chips, es la electricidad. La IEA proyecta que el consumo mundial de electricidad de los centros de datos se duplicará aproximadamente hasta cerca de 945 teravatios-hora para 2030, cerca del 3% del consumo eléctrico global total, con el uso de electricidad en servidores "acelerados" optimizados para IA creciendo alrededor de un 30% al año en su escenario base, frente a aproximadamente un 9% al año para los servidores convencionales. En Estados Unidos específicamente, se espera que los centros de datos representen casi la mitad de todo el crecimiento de la demanda eléctrica entre ahora y 2030.
Goldman Sachs Research plantea una perspectiva similar sobre las cifras: se proyecta que la demanda mundial de energía de los centros de datos aumente cerca de un 165% para 2030 frente a los niveles de 2023, con los centros de datos pasando de representar del 1 al 2% del uso de energía mundial hoy al 3 al 4% para 2030. En Estados Unidos, esa proporción podría alcanzar el 8% del consumo nacional de energía para 2030, frente a aproximadamente el 3% en 2022. Goldman estima que se necesitarán aproximadamente $720 mil millones en gasto de red eléctrica hasta 2030 solo para mantener al sistema eléctrico capaz de entregar esa energía.
McKinsey plantea el lado del capital de forma aún más contundente: proyecta que los centros de datos requerirán aproximadamente $6.7 billones en gasto de capital a nivel mundial para 2030 para mantener el ritmo de la demanda de cómputo, con $5.2 billones de eso destinados específicamente a instalaciones con capacidad de IA. La demanda total de capacidad de centros de datos podría casi triplicarse hasta 219 gigavatios para 2030, con aproximadamente el 70% de esa nueva demanda proviniendo directamente de cargas de trabajo de IA.
La refrigeración añade una segunda restricción de recursos además de la energía. Los sistemas de refrigeración líquida y evaporativa que evitan que los racks densos de GPU se sobrecalienten pueden consumir cantidades significativas de agua, razón por la cual los nuevos campus de IA enfrentan cada vez más resistencia local en regiones propensas a sequías, y por la cual los hyperscalers están invirtiendo en diseños de refrigeración de circuito cerrado que reciclan el agua en lugar de consumirla. Es de esperar que las negociaciones de tarifas de servicios públicos, los derechos de agua y las colas de interconexión a la red eléctrica sigan siendo el cuello de botella práctico sobre qué tan rápido puede entrar en operación nueva capacidad de IA, sin importar cuánto capital esté disponible para construirla.
Por Qué Esto Importa para los Líderes Empresariales
Nada de esto es abstracto si su empresa compra o construye sobre IA. La economía de los centros de datos fluye directamente hacia lo que usted paga por las herramientas de IA, qué tan rápido puede obtener capacidad de GPU para un proyecto personalizado y qué proveedores realmente pueden cumplir su hoja de ruta frente a cuáles están limitados por capacidad. Algunas implicaciones prácticas que vale la pena seguir:
- La presión de precios funciona en ambas direcciones. La escasez de GPU mantiene el cómputo costoso en el corto plazo, pero la carrera de capex también está impulsando ganancias de eficiencia (mejores chips, mejor refrigeración, mejor utilización) que reducen el costo por unidad de salida de IA con el tiempo. Modele su Costo Total de Propiedad de IA teniendo en cuenta ambas tendencias, no solo el precio de etiqueta de hoy.
- Dónde se ejecuta su carga de trabajo importa más que antes. Las aplicaciones sensibles a la latencia están empujando cada vez más el cómputo más cerca del usuario mediante Edge AI, mientras que el entrenamiento pesado y el trabajo de inferencia por lotes permanecen centralizados en campus de hyperscale. Conocer la diferencia le ayuda a evaluar las afirmaciones de arquitectura de un proveedor en lugar de tomar al pie de la letra un "operamos sobre infraestructura de IA".
- Las restricciones de capacidad son un factor de riesgo de proveedor real. Si la hoja de ruta de un proveedor depende de la disponibilidad de GPU o energía que no controla, vale la pena preguntar directamente al respecto, de la misma forma en que preguntaría sobre cualquier otro punto único de falla en una relación crítica con un proveedor.
- Los compromisos de sostenibilidad están chocando con las metas de crecimiento. Varios proveedores importantes han retrocedido o suavizado públicamente sus plazos de cero neto a medida que la demanda de energía de los centros de datos superó su expansión de energías renovables, una tensión que vale la pena tener en cuenta en cualquier afirmación ESG de proveedores en la que usted se apoye para sus propios informes.
Datos Clave
- Se proyecta que el consumo mundial de electricidad de los centros de datos se duplicará aproximadamente hasta 945 teravatios-hora para 2030, cerca del 3% del consumo eléctrico global total, con el uso de electricidad de servidores optimizados para IA creciendo alrededor de un 30% al año. IEA
- En Estados Unidos, se espera que los centros de datos representen casi la mitad de todo el crecimiento de la demanda eléctrica entre ahora y 2030. IEA
- Se proyecta que la IA impulse un aumento del 165% en la demanda mundial de energía de centros de datos para 2030 frente a los niveles de 2023, llevando a los centros de datos de representar del 1 al 2% del uso de energía mundial hoy al 3 al 4% para 2030, y a cerca del 8% del consumo de energía de Estados Unidos para 2030 (frente a aproximadamente el 3% en 2022). Goldman Sachs
- Se estima que se necesitarán aproximadamente $720 mil millones en gasto de red eléctrica hasta 2030 para respaldar la demanda de energía de centros de datos impulsada por la IA. Goldman Sachs
- Se proyecta que los centros de datos a nivel mundial requerirán aproximadamente $6.7 billones en gasto de capital para 2030 para mantener el ritmo de la demanda de cómputo, con $5.2 billones de eso para instalaciones con capacidad de IA específicamente. McKinsey
- La demanda mundial de capacidad de centros de datos podría casi triplicarse hasta 219 gigavatios para 2030, con cerca del 70% de la nueva demanda proviniendo de cargas de trabajo de IA. McKinsey
- Amazon, Alphabet, Microsoft y Meta proyectaron en conjunto aproximadamente $725 mil millones en gasto de capital para 2026, cerca de un 77% más que el récord de 2025 de $410 mil millones, con la gran mayoría destinada a infraestructura de IA. CNBC
Preguntas Frecuentes sobre los Centros de Datos de IA
¿Qué es un centro de datos de IA en términos simples?
Un centro de datos de IA es una instalación construida alrededor de grandes clústeres de GPU y otros aceleradores de IA, diseñada específicamente para entrenar y ejecutar modelos de IA a escala. Se diferencia de un centro de datos regular principalmente en la densidad de energía, la refrigeración y las redes que permiten que miles de chips trabajen juntos en un solo trabajo.
¿En qué se diferencia un centro de datos de IA de un centro de datos regular?
Un centro de datos regular está construido para atender muchas solicitudes pequeñas e independientes usando servidores estándar y refrigeración por aire. Un centro de datos de IA concentra mucha más energía por rack, usa refrigeración líquida o por inmersión para manejar el calor, y depende de interconexiones de alta velocidad para que las GPU operen como un solo sistema grande en lugar de máquinas separadas.
¿Por qué los centros de datos de IA necesitan tanta energía?
Entrenar y ejecutar modelos de IA grandes requiere miles de GPU funcionando simultáneamente a carga completa, y cada GPU consume mucha más energía que un chip de servidor tradicional. La IEA proyecta que la demanda mundial de electricidad de los centros de datos se duplicará aproximadamente para 2030, impulsada principalmente por este tipo de cómputo optimizado para IA.
¿Qué hardware hay dentro de un centro de datos de IA?
Las piezas centrales son GPU u otros aceleradores de IA, memoria de alto ancho de banda apilada junto a esos chips, interconexiones de alta velocidad como NVLink e InfiniBand que los conectan, sistemas de refrigeración líquida para manejar el calor, infraestructura de energía dedicada y almacenamiento rápido que mantiene los datos fluyendo hacia los chips sin convertirse en un cuello de botella.
¿Quién está construyendo la mayor cantidad de centros de datos de IA en este momento?
Amazon, Alphabet (Google), Microsoft y Meta son los mayores constructores, proyectando en conjunto aproximadamente $725 mil millones en gasto de capital de 2026, la mayor parte para infraestructura de IA. Los proveedores independientes de nube y colocación, junto con iniciativas nacionales soberanas en regiones como los estados del Golfo y Europa, también están expandiendo su capacidad.
¿Cuáles son las preocupaciones ambientales en torno a los centros de datos de IA?
Las dos mayores preocupaciones son la demanda de electricidad, ya que los centros de datos optimizados para IA son el impulsor de más rápido crecimiento del consumo mundial de energía, y el uso de agua para refrigeración, ya que los sistemas de refrigeración líquida y evaporativa pueden consumir cantidades significativas de agua en instalaciones ubicadas en regiones con estrés hídrico.
¿Cómo afecta un centro de datos de IA al costo de las herramientas de IA?
Los costos de construcción, energía y refrigeración de los centros de datos son un insumo importante en lo que cobran los proveedores de nube por el cómputo de IA. La escasez de capacidad de GPU mantiene elevados los precios en el corto plazo, mientras que las ganancias de eficiencia en chips y refrigeración reducen gradualmente el costo por unidad de salida de IA con el tiempo.
¿Cuál es la diferencia entre entrenamiento e inferencia en un centro de datos de IA?
El entrenamiento es el proceso de construir un modelo desde cero, un trabajo extremadamente intensivo en cómputo que generalmente se ejecuta en grandes campus de hyperscale. La inferencia es ejecutar ese modelo entrenado para responder solicitudes reales de usuarios, lo cual ocurre de forma continua y, a escala, puede consumir más cómputo total del que consumió el entrenamiento.
¿Debería una empresa construir alguna vez su propio centro de datos de IA?
Para casi todas las empresas, no. Construir y operar infraestructura de nivel IA requiere capital, acceso a energía y experiencia técnica a una escala que solo los hyperscalers y proveedores especializados pueden justificar. La mayoría de las empresas están mejor servidas alquilando capacidad de un proveedor de nube y enfocando su propia inversión en las aplicaciones de IA construidas sobre esa base.
Conceptos de IA Relacionados
- ¿Qué es la Inferencia de IA? - La carga de trabajo de producción que mantiene funcionando los centros de datos de IA las 24 horas
- Large Language Models - Lo que realmente se entrena dentro de estas instalaciones
- Foundation Models - Los modelos preentrenados que hacen que valga la pena entrenar a escala de hyperscale
- Model Serving - Cómo se despliegan a escala los modelos entrenados una vez terminado el entrenamiento
- Edge AI - La alternativa a los centros de datos centralizados para cargas de trabajo sensibles a la latencia
- Cuantización - Una técnica clave para exprimir más rendimiento del hardware existente de centro de datos
- Sovereign AI - Por qué las naciones están construyendo su propia capacidad de centros de datos de IA
- Costo Total de Propiedad de IA - Cómo la economía de los centros de datos fluye hacia lo que las empresas realmente pagan por la IA
Recursos Externos
- IEA: Energía e IA, Resumen Ejecutivo - Proyecciones de demanda mundial de electricidad de centros de datos hasta 2030
- IEA: La IA está lista para impulsar la creciente demanda eléctrica de los centros de datos - Desglose regional del crecimiento de la demanda
- Goldman Sachs: La IA Impulsará un Aumento del 165% en la Demanda de Energía de Centros de Datos para 2030 - Proyecciones de demanda de energía, gasto de red eléctrica y participación de Estados Unidos
- McKinsey: El Costo del Cómputo, una Carrera de $7 Billones para Escalar Centros de Datos - Proyecciones de gasto de capital y demanda de capacidad
- CNBC: El gasto en IA de las tecnológicas se acerca a $700 mil millones en 2026 - Proyecciones de capex de hyperscalers para 2026
Parte de la Colección de Términos de IA. Última actualización: 2026-07-20

Co-Founder, Rework.com
On this page
- En Qué Se Diferencia un Centro de Datos de IA de un Centro de Datos Tradicional
- Componentes Clave Dentro de un Centro de Datos de IA
- La Expansión de Centros de Datos de IA 2025-2026
- Impacto en Energía, Agua y Red Eléctrica
- Por Qué Esto Importa para los Líderes Empresariales
- Datos Clave
- Conceptos de IA Relacionados
- Recursos Externos