Apakah Pusat Data AI?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Dikemas kini Julai 2026
Pusat data AI ialah kemudahan khusus yang dipenuhi dengan GPU dan pemecut AI lain, dibina khusus untuk melatih dan menjalankan model AI pada skala besar-besaran. Berbeza dengan pusat data serba guna, ia direka bentuk berasaskan kepadatan kuasa yang melampau, rangkaian cip-ke-cip berkelajuan tinggi, dan penyejukan berat, iaitu perkara yang tidak pernah direka untuk dikendalikan oleh kemudahan tradisional yang menjalankan pelayan e-mel dan laman web.
Bagi pemimpin perniagaan, perbezaan ini penting kerana ia menjelaskan mengapa AI mahal dan mengapa kapasiti ketat. Setiap tindak balas chatbot, setiap ramalan yang dijana AI, setiap model yang diperhalusi oleh pasukan anda berjalan di atas infrastruktur yang lebih mahal untuk dibina, lebih mahal untuk dikuasakan, dan lebih mahal untuk disejukkan berbanding pusat data yang menjalankan internet selama dua dekad yang lalu. Memahami apa yang sebenarnya ada di dalam pusat data AI menjadikannya lebih mudah untuk membaca harga vendor, senarai tunggu kapasiti penyedia awan, atau tajuk berita mengenai kampus baharu bernilai $10 bilion, dan mengetahui apa yang sebenarnya mencetuskan angka tersebut.
Bagaimana Pusat Data AI Berbeza daripada Pusat Data Tradisional
Pusat data tradisional dibina untuk tugas yang berbeza: mengehos laman web, menjalankan pangkalan data, menyimpan fail, dan menyajikan aplikasi di mana satu cip pelayan sahaja melakukan kebanyakan kerja. Pusat data AI pula wujud untuk menggerakkan sejumlah besar data antara ribuan cip serentak, jadi hampir setiap pilihan reka bentuk berubah.
| Aspek | Pusat Data Tradisional | Pusat Data AI |
|---|---|---|
| Kepadatan kuasa setiap rak | Kira-kira 5 hingga 10 kilowatt | Selalunya 40 hingga 130+ kilowatt, dengan rak GPU terbaharu melebihi 120 kilowatt |
| Kaedah penyejukan | Penyejukan udara melalui lantai timbul dan unit CRAC | Penyejukan cecair terus ke cip atau penyejukan rendaman, kerana udara sahaja tidak dapat menyingkirkan haba dengan cukup pantas |
| Rangkaian | Ethernet standard, disesuaikan untuk banyak permintaan bebas | Material rangkaian jalur lebar tinggi berkependaman rendah seperti NVLink dan InfiniBand, disesuaikan supaya ribuan GPU boleh bertindak sebagai satu mesin |
| Perkakasan pengkomputeran | CPU serba guna | GPU dan pemecut lain, selalunya beribu-ribu setiap kluster, berfungsi secara selari pada satu tugas |
| Beban kerja utama | Menyajikan banyak permintaan kecil yang bebas | Melatih dan menjalankan model besar yang memerlukan setiap cip berkomunikasi dengan setiap cip lain secara berterusan |
| Kos pembinaan setiap megawatt | Lebih rendah, pembinaan standard | Jauh lebih tinggi, disebabkan infrastruktur kuasa, loji penyejukan cecair, dan rangkaian khusus |
Intipati praktikalnya: pusat data tradisional dioptimumkan untuk menyajikan banyak tugas kecil dan berasingan dengan murah. Pusat data AI pula dioptimumkan untuk menjadikan ribuan cip mahal berfungsi bersama pada satu tugas yang besar, dan perbezaan tujuan itulah yang mendorong setiap perbezaan dalam reka bentuk.
Komponen Utama di Dalam Pusat Data AI
Jika ketepikan pemasaran, setiap pusat data AI dibina daripada beberapa komponen teras.
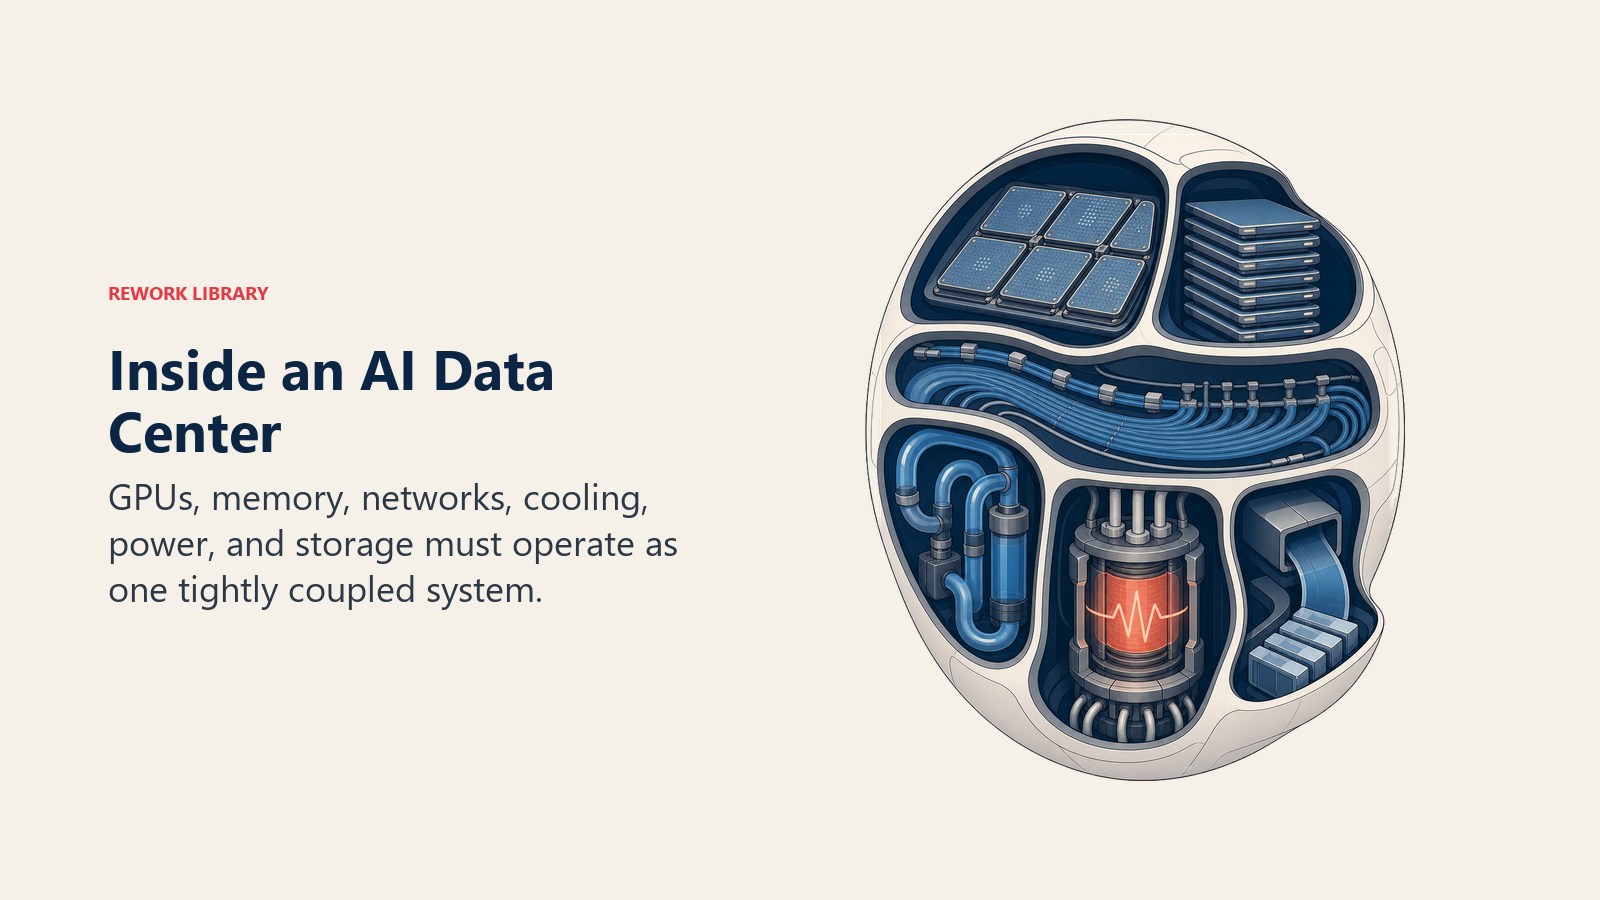
- GPU dan pemecut AI: Enjin pengkomputeran yang melakukan pengiraan sebenar, cip seperti H100, H200, dan GPU generasi Blackwell milik Nvidia, pemecut siri MI milik AMD, TPU milik Google, dan gelombang silikon tersuai yang semakin berkembang yang dibina oleh hyperscaler itu sendiri. Di sinilah model bahasa besar dan model asas lain sebenarnya dilatih dan dijalankan.
- Memori jalur lebar tinggi (HBM): Memori yang disusun terus di sebelah die GPU supaya ia dapat menyalurkan data ke cip cukup pantas untuk memastikannya sentiasa sibuk. Saiz dan kelajuan model selalunya dihadkan oleh jumlah HBM yang dimiliki sesebuah cip, bukan sekadar kelajuan pengiraannya.
- Sambungan antara cip dan material rangkaian: Sambungan cip-ke-cip dan rak-ke-rak (NVLink dalam satu pelayan, InfiniBand atau Ethernet berkelajuan tinggi antara pelayan) yang membolehkan ribuan GPU berfungsi sebagai satu komputer gergasi berbanding ribuan komputer berasingan. Ini adalah komponen yang paling kerap dipandang rendah oleh kebanyakan orang: sesebuah kluster hanya secepat sambungan paling perlahannya.
- Sistem penyejukan cecair: Plat sejuk terus ke cip atau tangki rendaman penuh yang menarik haba keluar daripada rak yang beroperasi jauh lebih panas berbanding apa-apa yang pernah direka untuk kemudahan tradisional.
- Infrastruktur kuasa: Substesen khusus, penjanaan sandaran di tapak, dan storan bateri yang semakin ketara, kerana satu kampus AI tunggal boleh menggunakan kuasa sebanyak sebuah bandar kecil.
- Storan dan saluran data: Sistem storan pantas yang memastikan data latihan terus mengalir ke dalam GPU tanpa menjadi kesesakan, ditambah pula sistem yang menguruskan penyajian model sebaik sahaja model dilatih dan sedia untuk trafik pengeluaran.
Pembinaan Besar-besaran Pusat Data AI 2025-2026
Skala pembinaan yang sedang berlaku sekarang adalah pembinaan infrastruktur paling pantas dalam sejarah teknologi. Empat hyperscaler terbesar AS, iaitu Amazon, Alphabet (Google), Microsoft, dan Meta, menganggarkan jumlah gabungan kira-kira $725 bilion perbelanjaan modal untuk 2026, naik kira-kira 77% daripada rekod 2025 yang sudah pun $410 bilion, menurut laporan mengenai panduan pendapatan mereka. Secara individu, ini terbahagi kepada kira-kira $200 bilion di Amazon, $185 hingga $190 bilion di Alphabet, $125 hingga $145 bilion di Meta, dan sekitar $120 bilion di Microsoft, dengan majoriti besarnya adalah infrastruktur AI.
Tiga kuasa mendorong perbelanjaan itu. Kos latihan bagi model terdepan (frontier) terus berkembang seiring dengan pengiraan yang tersedia, jadi sesiapa yang memiliki GPU paling banyak boleh membina model paling berupaya. Permintaan inferens, iaitu pengiraan yang diperlukan untuk benar-benar menjalankan produk AI setelah dilancarkan, berkembang lebih pantas daripada kebanyakan penyedia dapat menambah kapasiti, kerana setiap pertanyaan pengguna, setiap tugas ejen AI, dan setiap langkah penaakulan pengiraan masa ujian menggunakan masa GPU. Dan setiap hyperscaler sedang bersaing untuk membina cip proprietari sendiri bagi mengurangkan kebergantungan kepada Nvidia dan menurunkan kos bagi setiap unit output AI, bersama teknik seperti kuantisasi yang mengeluarkan lebih banyak prestasi daripada perkakasan yang sudah sedia ada.
Hasilnya muncul dalam dunia fizikal sebagai kampus bergigawatt berganda yang sedang dibina merentasi Texas, Louisiana, Wisconsin, dan belasan negeri lain, ditambah pula gelombang selari pembinaan berdaulat di negara-negara Teluk, Eropah, dan Asia (lihat AI berdaulat), apabila kerajaan memutuskan mereka tidak mahu kapasiti AI mereka bergantung pada pusat data pihak lain.
Kesan Kuasa, Air, dan Grid
Kekangan terbesar pembinaan besar-besaran ini bukan cip, tetapi elektrik. IEA meramalkan penggunaan elektrik pusat data global akan hampir berganda kepada kira-kira 945 terawatt-jam menjelang 2030, hampir 3% daripada jumlah penggunaan elektrik global, dengan penggunaan elektrik pelayan "dipercepatkan" yang dioptimumkan untuk AI berkembang sekitar 30% setahun dalam senario asasnya, berbanding kira-kira 9% setahun untuk pelayan konvensional. Khusus di Amerika Syarikat, pusat data dijangka menyumbang hampir separuh daripada keseluruhan pertumbuhan permintaan elektrik antara sekarang hingga 2030.
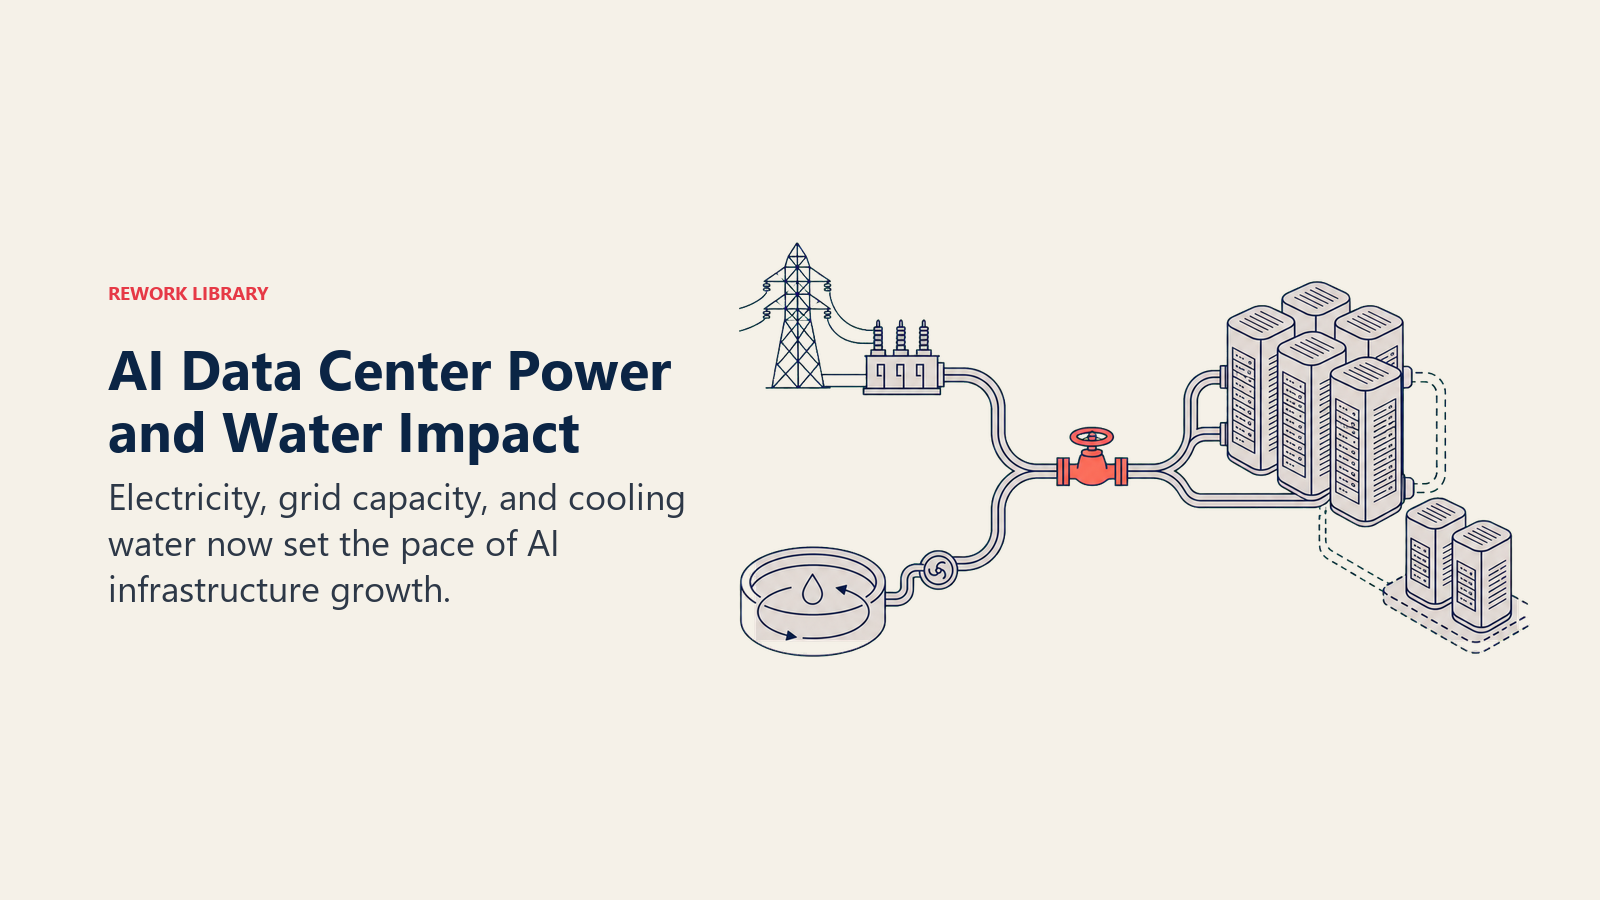
Goldman Sachs Research memberikan bentuk yang serupa pada angka tersebut: permintaan kuasa pusat data global diunjurkan meningkat kira-kira 165% menjelang 2030 berbanding tahap 2023, dengan pusat data beralih daripada 1 hingga 2% penggunaan kuasa dunia hari ini kepada 3 hingga 4% menjelang 2030. Di AS, bahagian itu boleh mencecah 8% penggunaan kuasa negara menjelang 2030, naik daripada kira-kira 3% pada 2022. Goldman menganggarkan kira-kira $720 bilion perbelanjaan grid akan diperlukan sehingga 2030 sekadar untuk memastikan sistem elektrik mampu menyalurkan kuasa tersebut.
McKinsey menggambarkan sisi modal ini dengan lebih ketara lagi: ia meramalkan pusat data akan memerlukan kira-kira $6.7 trilion perbelanjaan modal di seluruh dunia menjelang 2030 untuk mengekalkan kadar seiring dengan permintaan pengiraan, dengan $5.2 trilion daripadanya khusus untuk kemudahan berkeupayaan AI. Jumlah permintaan kapasiti pusat data boleh hampir tiga kali ganda kepada 219 gigawatt menjelang 2030, dengan kira-kira 70% daripada permintaan baharu itu datang terus daripada beban kerja AI.
Penyejukan menambah satu lagi kekangan sumber di atas kuasa. Sistem penyejukan cecair dan penyejatan yang mengelakkan rak GPU padat daripada terlebih panas boleh menggunakan air dalam jumlah besar, itulah sebabnya kampus AI baharu semakin menghadapi bantahan tempatan di kawasan berisiko kemarau dan mengapa hyperscaler melabur dalam reka bentuk penyejukan gelung tertutup yang mengitar semula air berbanding menggunakannya habis. Jangkakan rundingan kadar utiliti, hak air, dan giliran sambungan grid kekal sebagai kesesakan praktikal terhadap kepantasan kapasiti AI baharu sebenarnya boleh beroperasi, tidak kira berapa banyak modal yang tersedia untuk membinanya.
Mengapa Ini Penting bagi Pemimpin Perniagaan
Tiada satu pun daripada ini bersifat abstrak sekiranya syarikat anda membeli atau membina berasaskan AI. Ekonomi pusat data mengalir terus kepada apa yang anda bayar untuk alat AI, sepantas mana anda boleh mendapatkan kapasiti GPU untuk projek tersuai, dan vendor mana yang sebenarnya mampu memenuhi peta hala tuju mereka berbanding yang manakah terhad kapasitinya. Beberapa implikasi praktikal yang perlu dipantau:
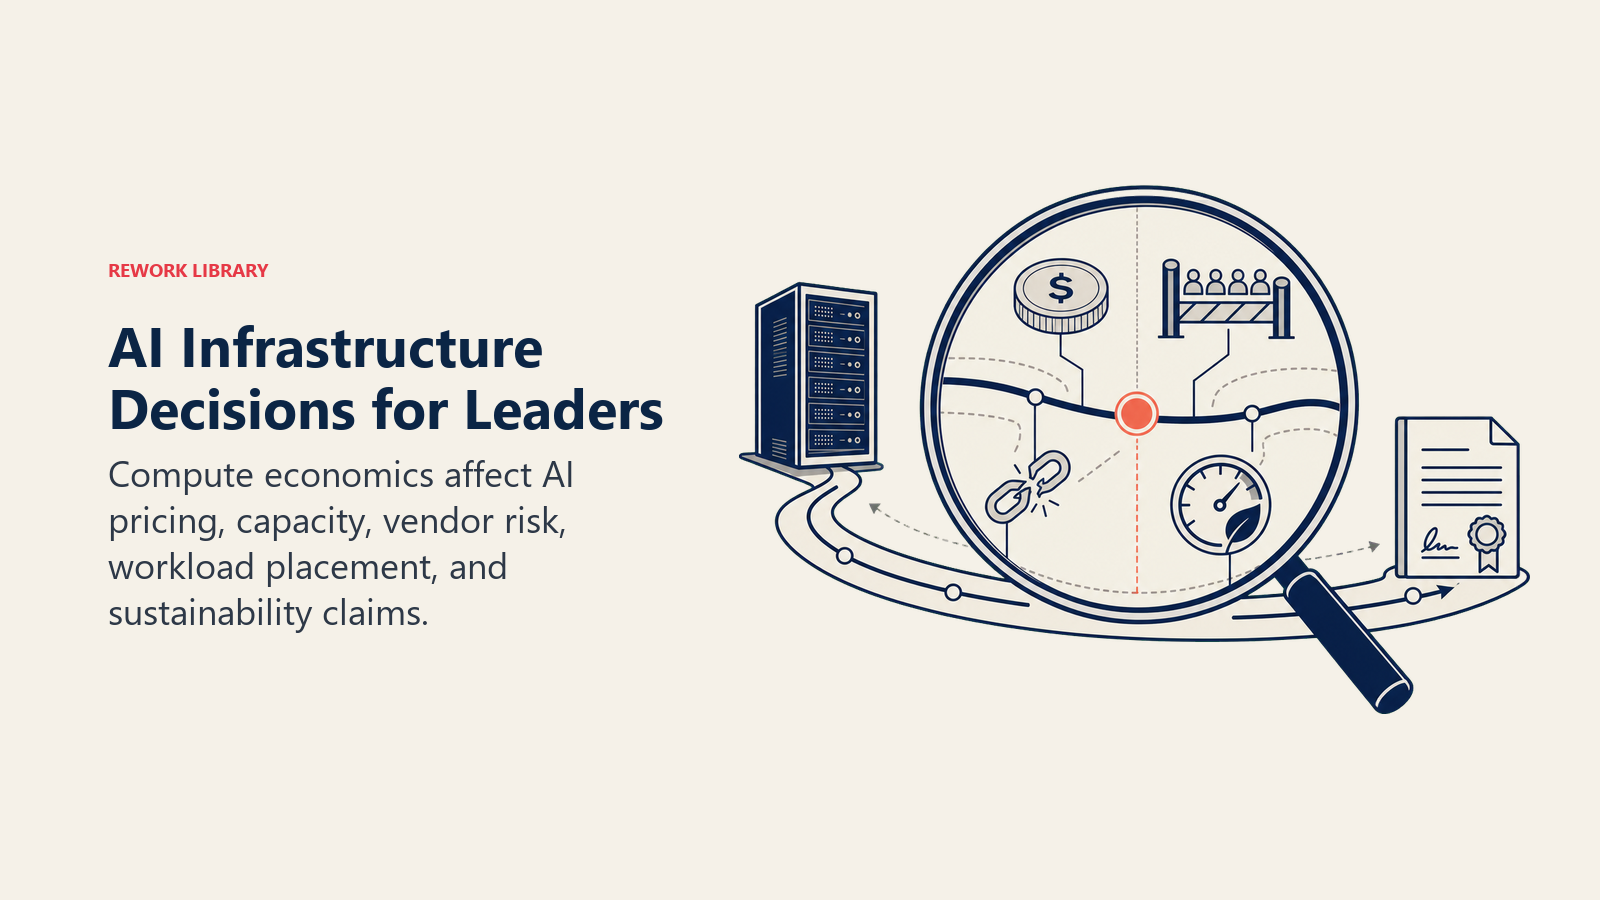
- Tekanan harga bergerak dua arah. Kekurangan bekalan GPU mengekalkan pengiraan mahal dalam jangka masa terdekat, tetapi persaingan perbelanjaan modal juga mendorong peningkatan kecekapan (cip lebih baik, penyejukan lebih baik, penggunaan lebih baik) yang menurunkan kos bagi setiap unit output AI dari semasa ke semasa. Modelkan jumlah kos pemilikan AI anda dengan mengambil kira kedua-dua trend ini, bukan sekadar harga hari ini.
- Di mana beban kerja anda berjalan kini lebih penting berbanding sebelum ini. Aplikasi yang sensitif terhadap kependaman semakin menolak pengiraan lebih dekat kepada pengguna melalui AI tepi, manakala kerja latihan berat dan inferens berkelompok kekal berpusat di kampus hyperscale. Mengetahui perbezaan ini membantu anda menilai dakwaan seni bina vendor berbanding hanya menerima "kami beroperasi atas infrastruktur AI" secara mentah-mentah.
- Kekangan kapasiti adalah faktor risiko vendor yang nyata. Jika peta hala tuju penyedia bergantung pada ketersediaan GPU atau kuasa yang tidak dikawalnya sendiri, itu wajar ditanya secara langsung, sama seperti anda akan bertanya mengenai mana-mana titik kegagalan tunggal lain dalam hubungan vendor yang kritikal.
- Komitmen kelestarian sedang berlanggar dengan sasaran pertumbuhan. Beberapa penyedia utama telah secara terbuka menarik balik atau melembutkan garis masa sifar-bersih (net-zero) mereka apabila permintaan kuasa pusat data mengatasi pembinaan tenaga boleh diperbaharui mereka, satu ketegangan yang wajar diambil kira dalam mana-mana dakwaan ESG vendor yang anda bergantung untuk pelaporan syarikat anda sendiri.
Fakta Utama
- Penggunaan elektrik pusat data global diunjurkan hampir berganda kepada 945 terawatt-jam menjelang 2030, kira-kira 3% daripada jumlah penggunaan elektrik global, dengan penggunaan elektrik pelayan yang dioptimumkan untuk AI berkembang sekitar 30% setahun. IEA
- Di Amerika Syarikat, pusat data dijangka menyumbang hampir separuh daripada keseluruhan pertumbuhan permintaan elektrik antara sekarang hingga 2030. IEA
- AI diunjurkan mendorong peningkatan 165% dalam permintaan kuasa pusat data global menjelang 2030 berbanding 2023, menolak pusat data daripada 1 hingga 2% penggunaan kuasa dunia hari ini kepada 3 hingga 4% menjelang 2030, dan kepada kira-kira 8% penggunaan kuasa AS menjelang 2030 (naik daripada kira-kira 3% pada 2022). Goldman Sachs
- Kira-kira $720 bilion perbelanjaan grid dianggarkan diperlukan sehingga 2030 untuk menyokong permintaan kuasa pusat data yang didorong AI. Goldman Sachs
- Pusat data di seluruh dunia diunjurkan memerlukan kira-kira $6.7 trilion perbelanjaan modal menjelang 2030 untuk mengekalkan kadar seiring dengan permintaan pengiraan, dengan $5.2 trilion daripadanya khusus untuk kemudahan berkeupayaan AI. McKinsey
- Permintaan kapasiti pusat data global boleh hampir tiga kali ganda kepada 219 gigawatt menjelang 2030, dengan kira-kira 70% daripada permintaan baharu datang daripada beban kerja AI. McKinsey
- Amazon, Alphabet, Microsoft, dan Meta menganggarkan jumlah gabungan kira-kira $725 bilion perbelanjaan modal untuk 2026, naik kira-kira 77% daripada rekod 2025 iaitu $410 bilion, dengan majoriti besarnya diperuntukkan untuk infrastruktur AI. CNBC
Soalan Lazim tentang Pusat Data AI
Apakah pusat data AI dalam erti kata mudah?
Pusat data AI ialah kemudahan yang dibina berasaskan kluster besar GPU dan pemecut AI lain, direka khusus untuk melatih dan menjalankan model AI pada skala besar. Ia berbeza daripada pusat data biasa terutamanya dari segi kepadatan kuasa, penyejukan, dan rangkaian yang membolehkan ribuan cip bekerja bersama pada satu tugas.
Bagaimana pusat data AI berbeza daripada pusat data biasa?
Pusat data biasa dibina untuk menyajikan banyak permintaan kecil yang bebas menggunakan pelayan standard dan penyejukan udara. Pusat data AI menumpukan jauh lebih banyak kuasa bagi setiap rak, menggunakan penyejukan cecair atau rendaman untuk mengurus haba, dan bergantung pada sambungan berkelajuan tinggi supaya GPU boleh beroperasi sebagai satu sistem besar berbanding mesin berasingan.
Mengapa pusat data AI memerlukan kuasa yang begitu banyak?
Melatih dan menjalankan model AI besar memerlukan ribuan GPU beroperasi pada beban penuh secara serentak, dan setiap GPU menggunakan kuasa jauh lebih banyak berbanding cip pelayan tradisional. IEA meramalkan permintaan elektrik pusat data global akan hampir berganda menjelang 2030, didorong terutamanya oleh jenis pengiraan yang dioptimumkan untuk AI ini.
Apakah perkakasan di dalam pusat data AI?
Komponen terasnya ialah GPU atau pemecut AI lain, memori jalur lebar tinggi yang disusun di sebelah cip tersebut, sambungan berkelajuan tinggi seperti NVLink dan InfiniBand yang menghubungkannya, sistem penyejukan cecair untuk mengurus haba, infrastruktur kuasa khusus, dan storan pantas yang memastikan data terus mengalir ke cip tanpa menjadi kesesakan.
Siapa yang sedang membina paling banyak pusat data AI sekarang?
Amazon, Alphabet (Google), Microsoft, dan Meta ialah pembina terbesar, secara bersama menganggarkan kira-kira $725 bilion perbelanjaan modal pada 2026, kebanyakannya untuk infrastruktur AI. Penyedia awan dan kolokasi bebas, bersama inisiatif nasional berdaulat di rantau seperti negara-negara Teluk dan Eropah, turut memperluas kapasiti.
Apakah kebimbangan alam sekitar berkaitan pusat data AI?
Dua kebimbangan terbesar ialah permintaan elektrik, kerana pusat data yang dioptimumkan untuk AI adalah pendorong penggunaan kuasa global yang berkembang paling pantas, dan penggunaan air untuk penyejukan, kerana sistem penyejukan cecair dan penyejatan boleh menggunakan air dalam jumlah besar di kemudahan yang terletak di kawasan tertekan sumber air.
Bagaimana pusat data AI menjejaskan kos alat AI?
Kos pembinaan, kuasa, dan penyejukan pusat data adalah input utama kepada apa yang dikenakan oleh penyedia awan untuk pengiraan AI. Kekurangan kapasiti GPU mengekalkan harga tinggi dalam jangka masa terdekat, manakala peningkatan kecekapan dalam cip dan penyejukan secara beransur-ansur menurunkan kos bagi setiap unit output AI dari semasa ke semasa.
Apakah perbezaan antara latihan dan inferens dalam pusat data AI?
Latihan ialah proses membina model dari awal, satu tugas yang amat memerlukan pengiraan tinggi yang biasanya dijalankan di kampus hyperscale yang besar. Inferens pula ialah menjalankan model yang telah dilatih itu untuk menjawab permintaan pengguna sebenar, yang berlaku secara berterusan dan, pada skala besar, boleh menggunakan lebih banyak jumlah pengiraan berbanding latihan.
Patutkah sesebuah perniagaan membina pusat data AI sendiri?
Bagi hampir semua syarikat, tidak. Membina dan mengendalikan infrastruktur bertaraf AI memerlukan modal, akses kuasa, dan kepakaran teknikal pada skala yang hanya mampu dijustifikasikan oleh hyperscaler dan penyedia khusus. Kebanyakan perniagaan lebih terjaga dengan menyewa kapasiti daripada penyedia awan dan menumpukan pelaburan mereka sendiri pada aplikasi AI yang dibina di atasnya.
Konsep AI Berkaitan
- Apakah Inferens AI? - Beban kerja pengeluaran yang memastikan pusat data AI beroperasi sepanjang masa
- Model Bahasa Besar - Apa yang sebenarnya dilatih di dalam kemudahan ini
- Model Asas - Model yang telah dilatih terlebih dahulu yang menjadikan latihan hyperscale berbaloi
- Penyajian Model - Bagaimana model yang dilatih digunakan pada skala besar setelah latihan selesai
- AI Tepi - Alternatif kepada pusat data berpusat untuk beban kerja sensitif kependaman
- Kuantisasi - Teknik utama untuk mengeluarkan lebih banyak prestasi daripada perkakasan pusat data sedia ada
- AI Berdaulat - Mengapa negara-negara membina kapasiti pusat data AI mereka sendiri
- Jumlah Kos Pemilikan AI - Bagaimana ekonomi pusat data mengalir kepada apa yang sebenarnya dibayar oleh perniagaan untuk AI
Sumber Luaran
- IEA: Energy and AI, Executive Summary - Unjuran permintaan elektrik pusat data global sehingga 2030
- IEA: AI is set to drive surging electricity demand from data centres - Pecahan serantau pertumbuhan permintaan
- Goldman Sachs: AI to Drive 165% Increase in Data Center Power Demand by 2030 - Unjuran permintaan kuasa, perbelanjaan grid, dan bahagian AS
- McKinsey: The Cost of Compute, a $7 Trillion Race to Scale Data Centers - Ramalan perbelanjaan modal dan permintaan kapasiti
- CNBC: Tech AI spending approaches $700 billion in 2026 - Panduan perbelanjaan modal hyperscaler 2026
Sebahagian daripada Koleksi Istilah AI. Terakhir dikemas kini: 2026-07-20

Co-Founder, Rework.com