Bahasa Indonesia
Apa itu Pusat Data AI?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Diperbarui Juli 2026
Pusat data AI adalah fasilitas khusus yang dipadati GPU dan akselerator AI lainnya, dibangun khusus untuk melatih dan menjalankan model AI dalam skala masif. Berbeda dari pusat data serbaguna, pusat data AI direkayasa di sekitar kepadatan daya ekstrem, jaringan chip-ke-chip berkecepatan tinggi, dan pendinginan berkapasitas besar, hal-hal yang tidak pernah dirancang untuk ditangani oleh fasilitas tradisional yang menjalankan server email dan situs web.
Bagi pemimpin bisnis, perbedaan ini penting karena menjelaskan mengapa AI mahal dan mengapa kapasitasnya terbatas. Setiap respons chatbot, setiap perkiraan yang dihasilkan AI, setiap model yang di-fine-tune tim Anda berjalan di atas infrastruktur yang lebih mahal untuk dibangun, lebih mahal untuk diberi daya, dan lebih mahal untuk didinginkan dibandingkan pusat data yang menjalankan internet selama dua dekade terakhir. Memahami apa yang sebenarnya ada di dalam pusat data AI membuat jauh lebih mudah untuk membaca harga vendor, daftar tunggu kapasitas penyedia cloud, atau berita utama tentang kampus baru senilai $10 miliar, dan mengetahui apa yang sebenarnya mendorong angka tersebut.
Bagaimana Pusat Data AI Berbeda dari Pusat Data Tradisional
Pusat data tradisional dibangun untuk pekerjaan yang berbeda: menghosting situs web, menjalankan basis data, menyimpan berkas, dan melayani aplikasi di mana satu chip server melakukan sebagian besar pekerjaan sendirian. Pusat data AI ada untuk memindahkan data dalam jumlah besar di antara ribuan chip sekaligus, sehingga hampir setiap pilihan desain pun berubah.
| Aspek | Pusat Data Tradisional | Pusat Data AI |
|---|---|---|
| Kepadatan daya per rak | Sekitar 5 hingga 10 kilowatt | Sering 40 hingga 130+ kilowatt, dengan rak GPU terbaru menembus lebih dari 120 kilowatt |
| Metode pendinginan | Pendinginan udara melalui lantai yang ditinggikan dan unit CRAC | Pendinginan cairan langsung ke chip atau pendinginan imersi, karena udara saja tidak bisa membuang panas cukup cepat |
| Jaringan | Ethernet standar, disetel untuk banyak permintaan independen | Fabric berbandwidth tinggi dan berlatensi rendah seperti NVLink dan InfiniBand, disetel agar ribuan GPU bisa bertindak sebagai satu mesin |
| Perangkat keras komputasi | CPU serbaguna | GPU dan akselerator lain, sering ribuan per klaster, bekerja paralel pada satu pekerjaan |
| Beban kerja utama | Melayani banyak permintaan kecil dan independen | Melatih dan menjalankan model besar yang membutuhkan setiap chip terus berkomunikasi dengan setiap chip lainnya |
| Biaya pembangunan per megawatt | Lebih rendah, konstruksi standar | Jauh lebih tinggi, karena infrastruktur daya, instalasi pendinginan cairan, dan jaringan khusus |
Kesimpulan praktisnya: pusat data tradisional dioptimalkan untuk melayani banyak pekerjaan kecil dan terpisah dengan murah. Pusat data AI dioptimalkan agar ribuan chip mahal bisa bekerja sama pada satu pekerjaan raksasa, dan perbedaan tujuan itulah yang mendorong setiap perbedaan dalam desain.
Komponen Kunci di dalam Pusat Data AI
Singkirkan sisi pemasarannya, dan setiap pusat data AI dibangun dari beberapa komponen inti.
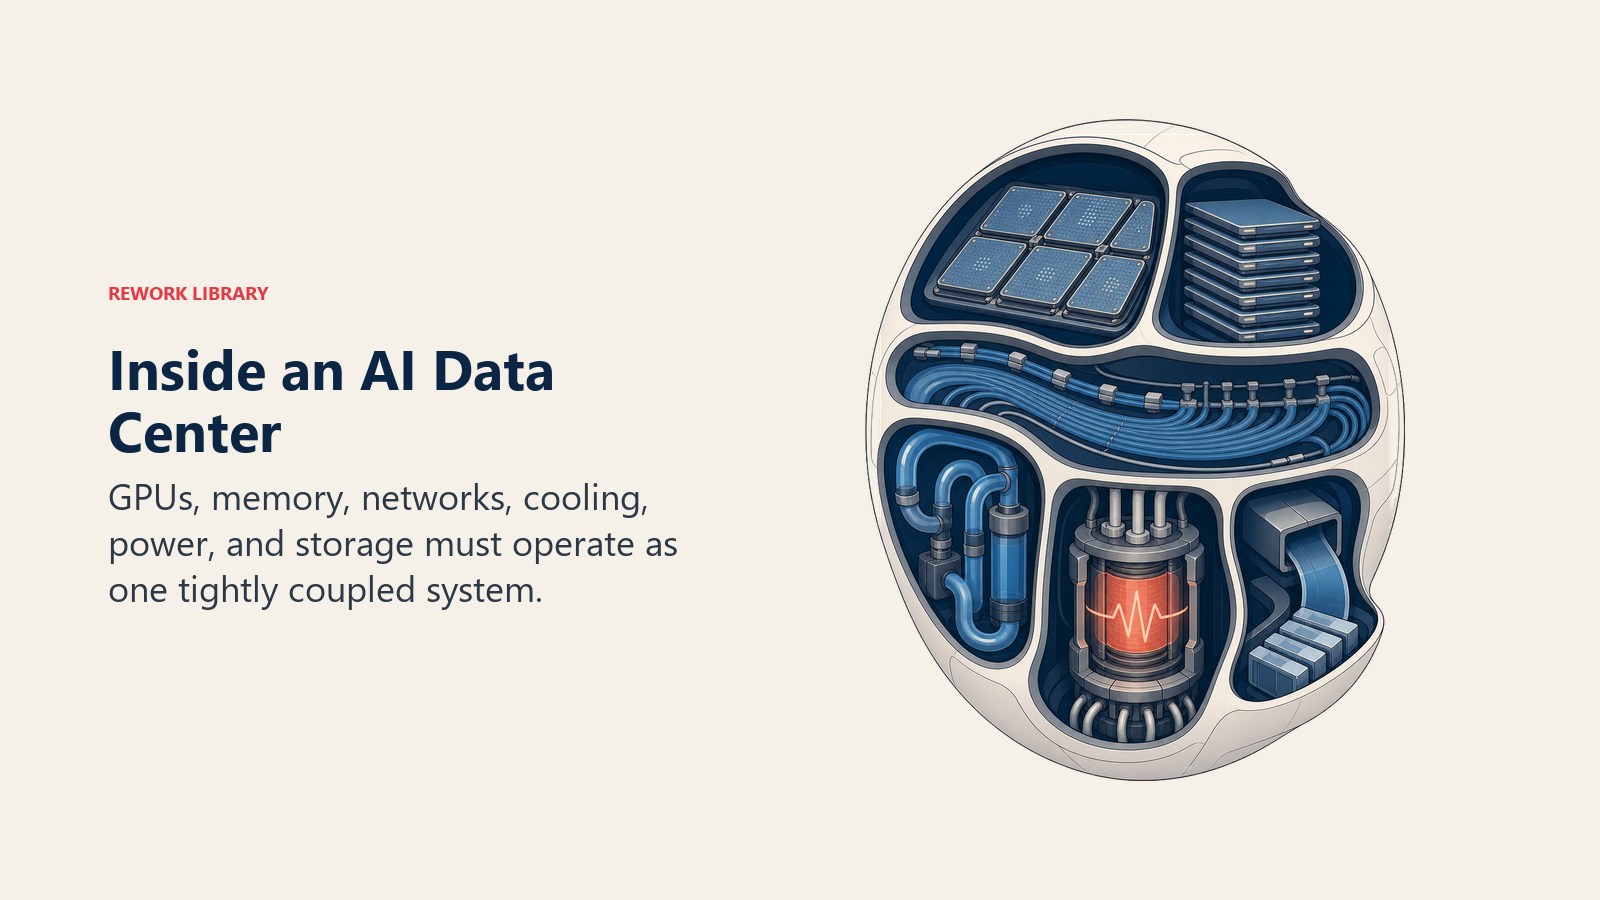
- GPU dan akselerator AI: Mesin komputasi yang melakukan perhitungan sesungguhnya, chip seperti H100, H200, dan GPU generasi Blackwell milik Nvidia, akselerator seri MI milik AMD, TPU milik Google, dan gelombang silikon kustom yang terus tumbuh yang dibangun oleh hyperscaler itu sendiri. Di sinilah model bahasa besar dan model fondasi lainnya benar-benar dilatih dan dijalankan.
- Memori berbandwidth tinggi (HBM): Memori yang ditumpuk langsung di sebelah die GPU sehingga bisa memberi data ke chip cukup cepat untuk menjaganya tetap sibuk. Ukuran dan kecepatan model sering dibatasi oleh seberapa banyak HBM yang dimiliki chip, bukan hanya seberapa cepat ia bisa menghitung.
- Fabric interkoneksi dan jaringan: Koneksi chip-ke-chip dan rak-ke-rak (NVLink di dalam satu server, InfiniBand atau Ethernet berkecepatan tinggi antar server) yang memungkinkan ribuan GPU berfungsi sebagai satu komputer raksasa alih-alih ribuan komputer terpisah. Ini adalah komponen yang paling sering diremehkan orang: klaster hanya secepat koneksi paling lambatnya.
- Sistem pendinginan cairan: Cold plate langsung ke chip atau tangki imersi penuh yang menarik panas keluar dari rak yang berjalan jauh lebih panas dibandingkan apa pun yang dibangun untuk fasilitas tradisional.
- Infrastruktur daya: Gardu induk khusus, pembangkit cadangan on-site, dan semakin banyak penyimpanan baterai, karena satu kampus AI bisa menyerap daya sebanyak kota kecil.
- Penyimpanan dan pipeline data: Sistem penyimpanan cepat yang menjaga data pelatihan terus mengalir ke GPU tanpa menjadi titik kemacetan, ditambah sistem yang mengelola penyajian model setelah model dilatih dan siap untuk lalu lintas produksi.
Pembangunan Pusat Data AI 2025-2026
Skala konstruksi yang sedang berlangsung saat ini adalah pembangunan infrastruktur tercepat dalam sejarah teknologi. Empat hyperscaler AS terbesar, Amazon, Alphabet (Google), Microsoft, dan Meta, memberi panduan belanja modal gabungan sekitar $725 miliar untuk 2026, naik sekitar 77% dari $410 miliar milik 2025 yang sudah mencetak rekor, menurut pemberitaan atas panduan laba mereka. Secara individual, angka itu terbagi menjadi sekitar $200 miliar di Amazon, $185 hingga $190 miliar di Alphabet, $125 hingga $145 miliar di Meta, dan sekitar $120 miliar di Microsoft, dengan mayoritas besarnya adalah infrastruktur AI.
Tiga kekuatan mendorong belanja tersebut. Biaya pelatihan untuk model mutakhir terus meningkat seiring komputasi yang tersedia, sehingga siapa pun yang memiliki GPU terbanyak bisa membangun model paling mumpuni. Permintaan inferensi, komputasi yang dibutuhkan untuk benar-benar menjalankan produk AI setelah diluncurkan, tumbuh lebih cepat daripada kemampuan sebagian besar penyedia menambah kapasitas, karena setiap kueri pengguna, setiap tugas agen AI, dan setiap langkah penalaran komputasi saat pengujian menghabiskan waktu GPU. Dan setiap hyperscaler tengah berlomba membangun chip miliknya sendiri untuk memangkas ketergantungan pada Nvidia dan menurunkan biaya per unit keluaran AI, bersamaan dengan teknik seperti kuantisasi yang memeras lebih banyak performa dari perangkat keras yang sudah terpasang.
Hasilnya muncul di dunia fisik sebagai kampus multi-gigawatt yang sedang dibangun di Texas, Louisiana, Wisconsin, dan selusin negara bagian lain, ditambah gelombang paralel pembangunan berdaulat di negara-negara Teluk, Eropa, dan Asia (lihat AI berdaulat), seiring pemerintah memutuskan mereka tidak ingin kapasitas AI mereka bergantung pada pusat data milik pihak lain.
Dampak Daya, Air, dan Jaringan Listrik
Kendala terbesar dari pembangunan ini bukan chip, melainkan listrik. IEA memproyeksikan konsumsi listrik pusat data global akan hampir dua kali lipat menjadi sekitar 945 terawatt-jam pada 2030, mendekati 3% dari total konsumsi listrik global, dengan penggunaan listrik server "terakselerasi" yang dioptimalkan untuk AI tumbuh sekitar 30% per tahun dalam skenario dasarnya, dibandingkan sekitar 9% per tahun untuk server konvensional. Di Amerika Serikat secara khusus, pusat data diperkirakan akan menyumbang hampir separuh dari seluruh pertumbuhan permintaan listrik antara sekarang hingga 2030.
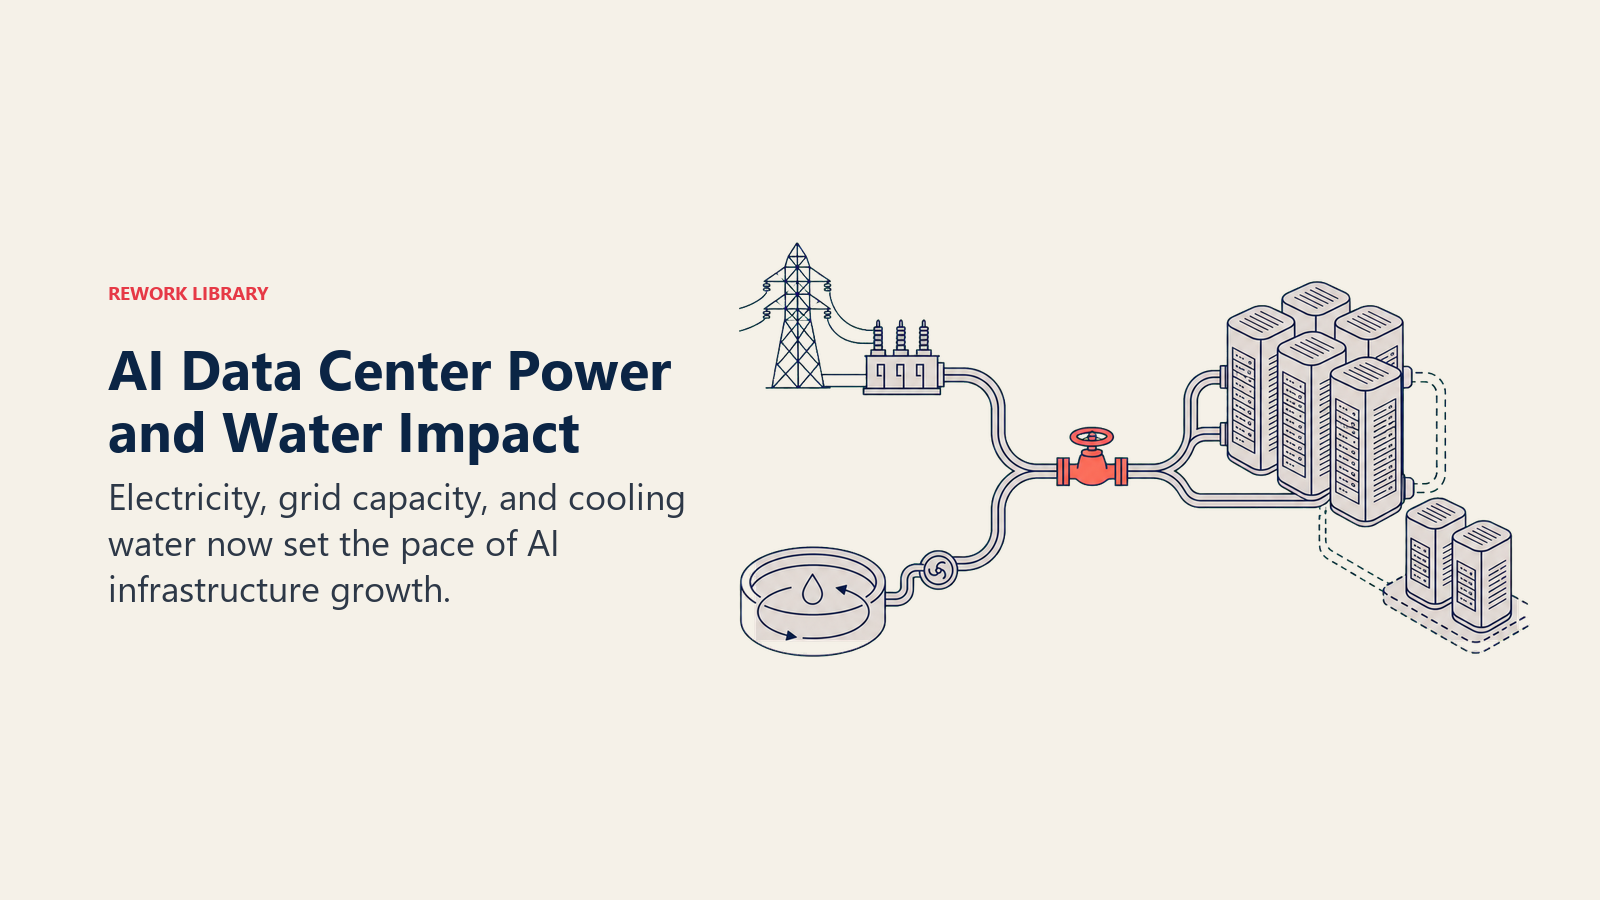
Goldman Sachs Research memberikan gambaran serupa: permintaan daya pusat data global diproyeksikan naik sekitar 165% pada 2030 dibandingkan level 2023, dengan pusat data bergerak dari 1 hingga 2% penggunaan daya dunia saat ini menjadi 3 hingga 4% pada 2030. Di AS, pangsa itu bisa mencapai 8% dari konsumsi daya nasional pada 2030, naik dari sekitar 3% pada 2022. Goldman memperkirakan sekitar $720 miliar belanja jaringan listrik akan dibutuhkan hingga 2030 hanya untuk menjaga sistem kelistrikan mampu memasok daya tersebut.
McKinsey membingkai sisi modalnya secara lebih tajam: mereka memproyeksikan pusat data di seluruh dunia akan membutuhkan sekitar $6,7 triliun belanja modal pada 2030 untuk mengimbangi permintaan komputasi, dengan $5,2 triliun di antaranya khusus untuk fasilitas yang mampu menjalankan AI. Total permintaan kapasitas pusat data bisa hampir tiga kali lipat menjadi 219 gigawatt pada 2030, dengan sekitar 70% dari permintaan baru tersebut berasal langsung dari beban kerja AI.
Pendinginan menambahkan kendala sumber daya kedua di atas daya listrik. Sistem pendinginan cairan dan evaporatif yang menjaga rak GPU padat agar tidak kepanasan bisa menyerap air dalam jumlah signifikan, itulah sebabnya kampus AI baru semakin menghadapi penolakan lokal di wilayah rawan kekeringan dan mengapa hyperscaler berinvestasi pada desain pendinginan loop tertutup yang mendaur ulang air alih-alih mengonsumsinya. Perkirakan negosiasi tarif utilitas, hak atas air, dan antrean interkoneksi jaringan listrik akan tetap menjadi titik kemacetan praktis atas seberapa cepat kapasitas AI baru bisa benar-benar beroperasi, terlepas dari seberapa banyak modal yang tersedia untuk membangunnya.
Mengapa Ini Penting bagi Pemimpin Bisnis
Semua ini tidak abstrak jika perusahaan Anda membeli atau membangun di atas AI. Ekonomi pusat data mengalir langsung ke apa yang Anda bayar untuk alat AI, seberapa cepat Anda bisa mendapatkan kapasitas GPU untuk proyek kustom, dan vendor mana yang benar-benar bisa memenuhi roadmap mereka dibandingkan vendor yang terkendala kapasitas. Beberapa implikasi praktis yang layak dipantau:
- Tekanan harga bekerja dua arah. Kelangkaan GPU menjaga komputasi tetap mahal dalam jangka pendek, tetapi perlombaan capex juga mendorong peningkatan efisiensi (chip yang lebih baik, pendinginan yang lebih baik, utilisasi yang lebih baik) yang menurunkan biaya per unit keluaran AI seiring waktu. Modelkan total biaya kepemilikan AI Anda dengan mempertimbangkan kedua tren tersebut, bukan hanya harga hari ini.
- Lokasi tempat beban kerja Anda berjalan kini lebih penting dari sebelumnya. Aplikasi yang sensitif terhadap latensi semakin mendorong komputasi lebih dekat ke pengguna melalui AI di edge, sementara pelatihan berat dan pekerjaan inferensi batch tetap tersentralisasi di kampus hyperscale. Mengetahui perbedaannya membantu Anda mengevaluasi klaim arsitektur vendor alih-alih menerima begitu saja pernyataan "kami berjalan di infrastruktur AI".
- Kendala kapasitas adalah faktor risiko vendor yang nyata. Jika roadmap sebuah penyedia bergantung pada ketersediaan GPU atau daya yang tidak mereka kendalikan, itu layak ditanyakan secara langsung, sama seperti Anda menanyakan titik kegagalan tunggal lain dalam hubungan vendor yang kritis.
- Komitmen keberlanjutan berbenturan dengan target pertumbuhan. Beberapa penyedia besar secara terbuka telah menarik kembali atau melunakkan target net-zero mereka seiring permintaan daya pusat data melampaui pembangunan energi terbarukan mereka, ketegangan yang layak diperhitungkan dalam klaim ESG vendor mana pun yang Anda andalkan untuk pelaporan Anda sendiri.
Fakta Penting
- Konsumsi listrik pusat data global diproyeksikan hampir dua kali lipat menjadi 945 terawatt-jam pada 2030, sekitar 3% dari total konsumsi listrik global, dengan penggunaan listrik server yang dioptimalkan untuk AI tumbuh sekitar 30% per tahun. IEA
- Di Amerika Serikat, pusat data diperkirakan akan menyumbang hampir separuh dari seluruh pertumbuhan permintaan listrik antara sekarang hingga 2030. IEA
- AI diproyeksikan mendorong kenaikan 165% permintaan daya pusat data global pada 2030 dibandingkan 2023, mendorong pusat data dari 1 hingga 2% penggunaan daya dunia saat ini menjadi 3 hingga 4% pada 2030, dan sekitar 8% dari konsumsi daya AS pada 2030 (naik dari sekitar 3% pada 2022). Goldman Sachs
- Sekitar $720 miliar belanja jaringan listrik diperkirakan dibutuhkan hingga 2030 untuk mendukung permintaan daya pusat data yang didorong AI. Goldman Sachs
- Pusat data di seluruh dunia diproyeksikan membutuhkan sekitar $6,7 triliun belanja modal pada 2030 untuk mengimbangi permintaan komputasi, dengan $5,2 triliun di antaranya khusus untuk fasilitas yang mampu menjalankan AI. McKinsey
- Permintaan kapasitas pusat data global bisa hampir tiga kali lipat menjadi 219 gigawatt pada 2030, dengan sekitar 70% dari permintaan baru berasal dari beban kerja AI. McKinsey
- Amazon, Alphabet, Microsoft, dan Meta memberi panduan belanja modal gabungan sekitar $725 miliar untuk 2026, naik sekitar 77% dari rekor $410 miliar milik 2025, dengan mayoritas besarnya dialokasikan untuk infrastruktur AI. CNBC
Pertanyaan yang Sering Diajukan tentang Pusat Data AI
Apa itu pusat data AI dalam istilah sederhana?
Pusat data AI adalah fasilitas yang dibangun di sekitar klaster besar GPU dan akselerator AI lainnya, dirancang khusus untuk melatih dan menjalankan model AI dalam skala besar. Perbedaan utamanya dari pusat data biasa terletak pada kepadatan daya, pendinginan, dan jaringan yang memungkinkan ribuan chip bekerja sama pada satu pekerjaan.
Bagaimana pusat data AI berbeda dari pusat data biasa?
Pusat data biasa dibangun untuk melayani banyak permintaan kecil dan independen menggunakan server standar dan pendinginan udara. Pusat data AI memusatkan jauh lebih banyak daya per rak, menggunakan pendinginan cairan atau imersi untuk mengelola panas, dan mengandalkan interkoneksi berkecepatan tinggi sehingga GPU bisa beroperasi sebagai satu sistem besar alih-alih mesin terpisah.
Mengapa pusat data AI membutuhkan begitu banyak daya?
Melatih dan menjalankan model AI besar membutuhkan ribuan GPU yang berjalan pada beban penuh secara bersamaan, dan setiap GPU menyerap jauh lebih banyak daya dibandingkan chip server tradisional. IEA memproyeksikan permintaan listrik pusat data global akan hampir dua kali lipat pada 2030, yang terutama didorong oleh komputasi yang dioptimalkan untuk AI semacam ini.
Perangkat keras apa yang ada di dalam pusat data AI?
Komponen intinya adalah GPU atau akselerator AI lain, memori berbandwidth tinggi yang ditumpuk di sebelah chip tersebut, interkoneksi berkecepatan tinggi seperti NVLink dan InfiniBand yang menghubungkannya, sistem pendinginan cairan untuk mengelola panas, infrastruktur daya khusus, dan penyimpanan cepat yang menjaga data terus mengalir ke chip tanpa menjadi titik kemacetan.
Siapa yang sedang membangun pusat data AI terbanyak saat ini?
Amazon, Alphabet (Google), Microsoft, dan Meta adalah pembangun terbesar, bersama-sama memberi panduan belanja modal sekitar $725 miliar pada 2026, sebagian besarnya untuk infrastruktur AI. Penyedia cloud dan colocation independen, bersama inisiatif nasional berdaulat di kawasan seperti negara-negara Teluk dan Eropa, juga sedang memperluas kapasitas.
Apa saja kekhawatiran lingkungan terkait pusat data AI?
Dua kekhawatiran terbesar adalah permintaan listrik, karena pusat data yang dioptimalkan untuk AI adalah pendorong pertumbuhan tercepat konsumsi daya global, dan penggunaan air untuk pendinginan, karena sistem pendinginan cairan dan evaporatif bisa menyerap air dalam jumlah signifikan di fasilitas yang berada di wilayah yang kekurangan air.
Bagaimana pusat data AI memengaruhi biaya alat AI?
Biaya konstruksi, daya, dan pendinginan pusat data adalah input utama untuk apa yang dibebankan penyedia cloud untuk komputasi AI. Kelangkaan kapasitas GPU menjaga harga tetap tinggi dalam jangka pendek, sementara peningkatan efisiensi pada chip dan pendinginan secara bertahap menurunkan biaya per unit keluaran AI seiring waktu.
Apa perbedaan antara pelatihan dan inferensi di pusat data AI?
Pelatihan adalah proses membangun model dari nol, pekerjaan yang sangat intensif komputasi dan biasanya dijalankan di kampus hyperscale besar. Inferensi adalah menjalankan model yang sudah dilatih tersebut untuk menjawab permintaan pengguna nyata, yang terjadi terus-menerus dan, dalam skala besar, bisa mengonsumsi total komputasi lebih banyak dibandingkan pelatihan.
Haruskah sebuah bisnis membangun pusat data AI miliknya sendiri?
Untuk hampir semua perusahaan, tidak. Membangun dan mengoperasikan infrastruktur kelas AI membutuhkan modal, akses daya, dan keahlian teknis dalam skala yang hanya bisa dijustifikasi oleh hyperscaler dan penyedia khusus. Sebagian besar bisnis lebih baik menyewa kapasitas dari penyedia cloud dan memfokuskan investasi mereka sendiri pada aplikasi AI yang dibangun di atasnya.
Konsep AI Terkait
- Apa itu Inferensi AI? - Beban kerja produksi yang menjaga pusat data AI berjalan sepanjang waktu
- Model Bahasa Besar - Apa yang sebenarnya dilatih di dalam fasilitas ini
- Model Fondasi - Model yang sudah dilatih sebelumnya yang membuat pelatihan skala hyperscale sepadan
- Penyajian Model - Bagaimana model yang sudah dilatih diterapkan dalam skala besar setelah pelatihan selesai
- AI di Edge - Alternatif dari pusat data tersentralisasi untuk beban kerja yang sensitif terhadap latensi
- Kuantisasi - Teknik kunci untuk memeras lebih banyak performa dari perangkat keras pusat data yang sudah ada
- AI Berdaulat - Mengapa negara-negara membangun kapasitas pusat data AI mereka sendiri
- Total Biaya Kepemilikan AI - Bagaimana ekonomi pusat data mengalir ke apa yang benar-benar dibayar bisnis untuk AI
Sumber Eksternal
- IEA: Energy and AI, Executive Summary - Proyeksi permintaan listrik pusat data global hingga 2030
- IEA: AI is set to drive surging electricity demand from data centres - Rincian regional pertumbuhan permintaan
- Goldman Sachs: AI to Drive 165% Increase in Data Center Power Demand by 2030 - Permintaan daya, belanja jaringan listrik, dan proyeksi pangsa AS
- McKinsey: The Cost of Compute, a $7 Trillion Race to Scale Data Centers - Perkiraan belanja modal dan permintaan kapasitas
- CNBC: Tech AI spending approaches $700 billion in 2026 - Panduan capex hyperscaler 2026
Bagian dari Koleksi Istilah AI. Terakhir diperbarui: 2026-07-20

Co-Founder, Rework.com