Was ist ein KI-Rechenzentrum?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Aktualisiert im Juli 2026
Ein KI-Rechenzentrum ist eine spezialisierte Anlage voller GPUs und anderer KI-Beschleuniger, die eigens dafür gebaut wurde, KI-Modelle in massivem Maßstab zu trainieren und auszuführen. Anders als ein Allzweck-Rechenzentrum ist es auf extreme Leistungsdichte, hochschnelle Chip-zu-Chip-Vernetzung und robuste Kühlung ausgelegt, Dinge, für die eine herkömmliche Anlage, die E-Mail-Server und Websites betreibt, nie konzipiert war.
Für Führungskräfte ist dieser Unterschied wichtig, weil er erklärt, warum KI teuer ist und warum Kapazität knapp ist. Jede Chatbot-Antwort, jede KI-generierte Prognose, jedes Modell, das Ihr Team feinabstimmt, läuft auf Infrastruktur, die teurer im Bau, teurer im Betrieb und teurer in der Kühlung ist als die Rechenzentren, die das Internet die letzten zwei Jahrzehnte lang betrieben haben. Zu verstehen, was tatsächlich in einem KI-Rechenzentrum steckt, macht es deutlich einfacher, die Preisgestaltung eines Anbieters, die Kapazitätswarteliste eines Cloud-Anbieters oder eine Schlagzeile über einen neuen 10-Milliarden-Dollar-Campus zu lesen und zu verstehen, was die Zahl tatsächlich antreibt.
Wie sich ein KI-Rechenzentrum von einem herkömmlichen Rechenzentrum unterscheidet
Ein herkömmliches Rechenzentrum wurde für eine andere Aufgabe gebaut: das Hosten von Websites, das Betreiben von Datenbanken, das Speichern von Dateien und das Bereitstellen von Anwendungen, bei denen ein einzelner Server-Chip den Großteil der Arbeit allein erledigte. Ein KI-Rechenzentrum existiert, um enorme Datenmengen gleichzeitig zwischen Tausenden von Chips zu bewegen, sodass sich fast jede Designentscheidung ändert.
| Aspekt | Herkömmliches Rechenzentrum | KI-Rechenzentrum |
|---|---|---|
| Leistungsdichte pro Rack | Etwa 5 bis 10 Kilowatt | Oft 40 bis über 130 Kilowatt, wobei die neuesten GPU-Racks über 120 Kilowatt hinausgehen |
| Kühlmethode | Luftkühlung über Doppelböden und CRAC-Einheiten | Direkte Flüssigkühlung am Chip oder Immersionskühlung, weil Luft allein die Wärme nicht schnell genug abführen kann |
| Vernetzung | Standard-Ethernet, abgestimmt auf viele unabhängige Anfragen | Hochbandbreitige, latenzarme Fabrics wie NVLink und InfiniBand, abgestimmt darauf, dass Tausende GPUs wie eine Maschine agieren können |
| Rechenhardware | Allzweck-CPUs | GPUs und andere Beschleuniger, oft Tausende pro Cluster, die parallel an einer Aufgabe arbeiten |
| Primäre Workload | Bedienung vieler kleiner, unabhängiger Anfragen | Training und Betrieb großer Modelle, bei denen jeder Chip ständig mit jedem anderen Chip kommunizieren muss |
| Baukosten pro Megawatt | Niedriger, Standardbau | Deutlich höher, wegen Stromversorgungsinfrastruktur, Flüssigkühlanlage und spezialisierter Vernetzung |
Die praktische Erkenntnis: Ein herkömmliches Rechenzentrum ist darauf optimiert, viele kleine, separate Aufgaben günstig zu bedienen. Ein KI-Rechenzentrum ist darauf optimiert, Tausende teure Chips gemeinsam an einer einzigen riesigen Aufgabe arbeiten zu lassen, und dieser Unterschied im Zweck treibt jeden Unterschied im Design an.
Die wichtigsten Komponenten in einem KI-Rechenzentrum
Entfernt man das Marketing, ist jedes KI-Rechenzentrum aus einer Handvoll Kernbestandteilen aufgebaut.
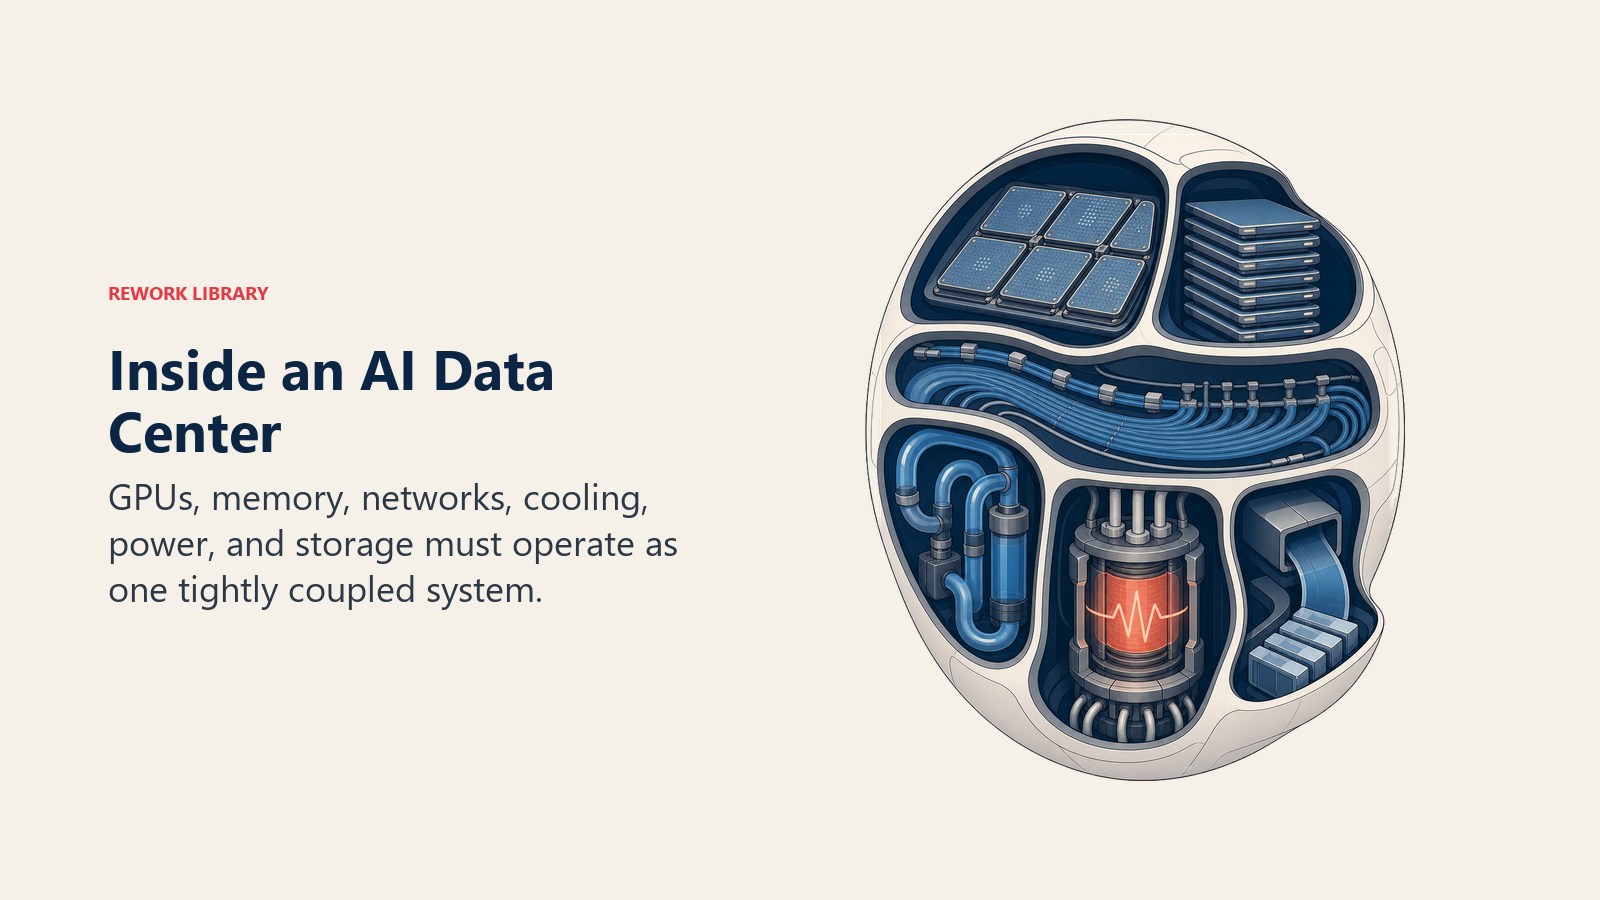
- GPUs und KI-Beschleuniger: Die Rechenmotoren, die die eigentliche Mathematik erledigen, Chips wie Nvidias H100, H200 und GPUs der Blackwell-Generation, AMDs MI-Serie-Beschleuniger, Googles TPUs und eine wachsende Welle kundenspezifischer Chips, die die Hyperscaler selbst entwickeln. Hier werden Large Language Models und andere Foundation Models tatsächlich trainiert und ausgeführt.
- High Bandwidth Memory (HBM): Speicher, der direkt neben dem GPU-Die gestapelt ist, damit er den Chip schnell genug mit Daten versorgen kann, um ihn ausgelastet zu halten. Modellgröße und -geschwindigkeit sind oft dadurch begrenzt, wie viel HBM ein Chip hat, nicht nur davon, wie schnell er rechnen kann.
- Interconnect- und Netzwerk-Fabric: Die Chip-zu-Chip- und Rack-zu-Rack-Verbindungen (NVLink innerhalb eines Servers, InfiniBand oder Hochgeschwindigkeits-Ethernet zwischen Servern), die es Tausenden GPUs erlauben, wie ein einziger riesiger Computer statt wie Tausende separate zu funktionieren. Das ist der Bestandteil, den die meisten Menschen unterschätzen: Ein Cluster ist nur so schnell wie seine langsamste Verbindung.
- Flüssigkühlsysteme: Kühlplatten direkt am Chip oder vollständige Immersionstanks, die Wärme aus Racks abführen, die weit heißer laufen als alles, wofür eine herkömmliche Anlage gebaut war.
- Stromversorgungsinfrastruktur: Dedizierte Umspannwerke, Notstromerzeugung vor Ort und zunehmend auch Batteriespeicher, weil ein einzelner KI-Campus so viel Strom ziehen kann wie eine kleine Stadt.
- Storage und Datenpipeline: Schnelle Storage-Systeme, die den Fluss der Trainingsdaten in die GPUs aufrechterhalten, ohne zum Engpass zu werden, plus die Systeme, die Model Serving verwalten, sobald ein Modell trainiert und bereit für Produktionsverkehr ist.
Der KI-Rechenzentrum-Ausbau 2025-2026
Das Ausmaß des Baus, der gerade stattfindet, ist der schnellste Infrastrukturausbau in der Geschichte der Technologiebranche. Die vier größten US-Hyperscaler, Amazon, Alphabet (Google), Microsoft und Meta, haben laut Berichten über ihre Umsatzprognosen gemeinsam rund 725 Milliarden US-Dollar an Investitionsausgaben für 2026 in Aussicht gestellt, ein Plus von etwa 77 Prozent gegenüber dem bereits rekordhohen Vorjahreswert 2025 von 410 Milliarden US-Dollar. Einzeln aufgeschlüsselt sind das rund 200 Milliarden US-Dollar bei Amazon, 185 bis 190 Milliarden US-Dollar bei Alphabet, 125 bis 145 Milliarden US-Dollar bei Meta und rund 120 Milliarden US-Dollar bei Microsoft, wobei der überwiegende Großteil davon auf KI-Infrastruktur entfällt.
Drei Kräfte treiben diese Ausgaben an. Die Trainingskosten für Frontier-Modelle skalieren weiter mit der verfügbaren Rechenleistung, sodass, wer die meisten GPUs hat, das fähigste Modell bauen kann. Die Nachfrage nach Inferenz, also die Rechenleistung, die benötigt wird, um KI-Produkte tatsächlich im Live-Betrieb auszuführen, wächst schneller, als die meisten Anbieter Kapazität hinzufügen können, da jede Nutzeranfrage, jede KI-Agenten-Aufgabe und jeder Test-Time-Compute-Schritt GPU-Zeit verbraucht. Und jeder Hyperscaler ist bestrebt, eigene Chips zu entwickeln, um seine Abhängigkeit von Nvidia zu verringern und die Kosten pro Einheit KI-Output zu senken, zusammen mit Techniken wie Quantisierung, die mehr Leistung aus der bereits verbauten Hardware herausholen.
Das Ergebnis zeigt sich in der physischen Welt als Mehrgigawatt-Campus im Bau in Texas, Louisiana, Wisconsin und einem Dutzend weiterer Bundesstaaten, dazu eine parallele Welle souveräner Ausbauten in den Golfstaaten, Europa und Asien (siehe Sovereign AI), da Regierungen entscheiden, dass sie ihre KI-Kapazität nicht vom Rechenzentrum eines anderen abhängig machen wollen.
Strom-, Wasser- und Stromnetz-Auswirkungen
Der größte Engpass des Ausbaus sind nicht die Chips, sondern der Strom. Die IEA prognostiziert, dass sich der globale Stromverbrauch von Rechenzentren bis 2030 auf rund 945 Terawattstunden nahezu verdoppeln wird, das entspricht fast 3 Prozent des gesamten globalen Stromverbrauchs, wobei der Stromverbrauch KI-optimierter "beschleunigter" Server im Basisszenario um rund 30 Prozent pro Jahr wächst, gegenüber rund 9 Prozent pro Jahr bei herkömmlichen Servern. In den Vereinigten Staaten speziell sollen Rechenzentren voraussichtlich fast die Hälfte des gesamten Wachstums der Stromnachfrage zwischen jetzt und 2030 ausmachen.
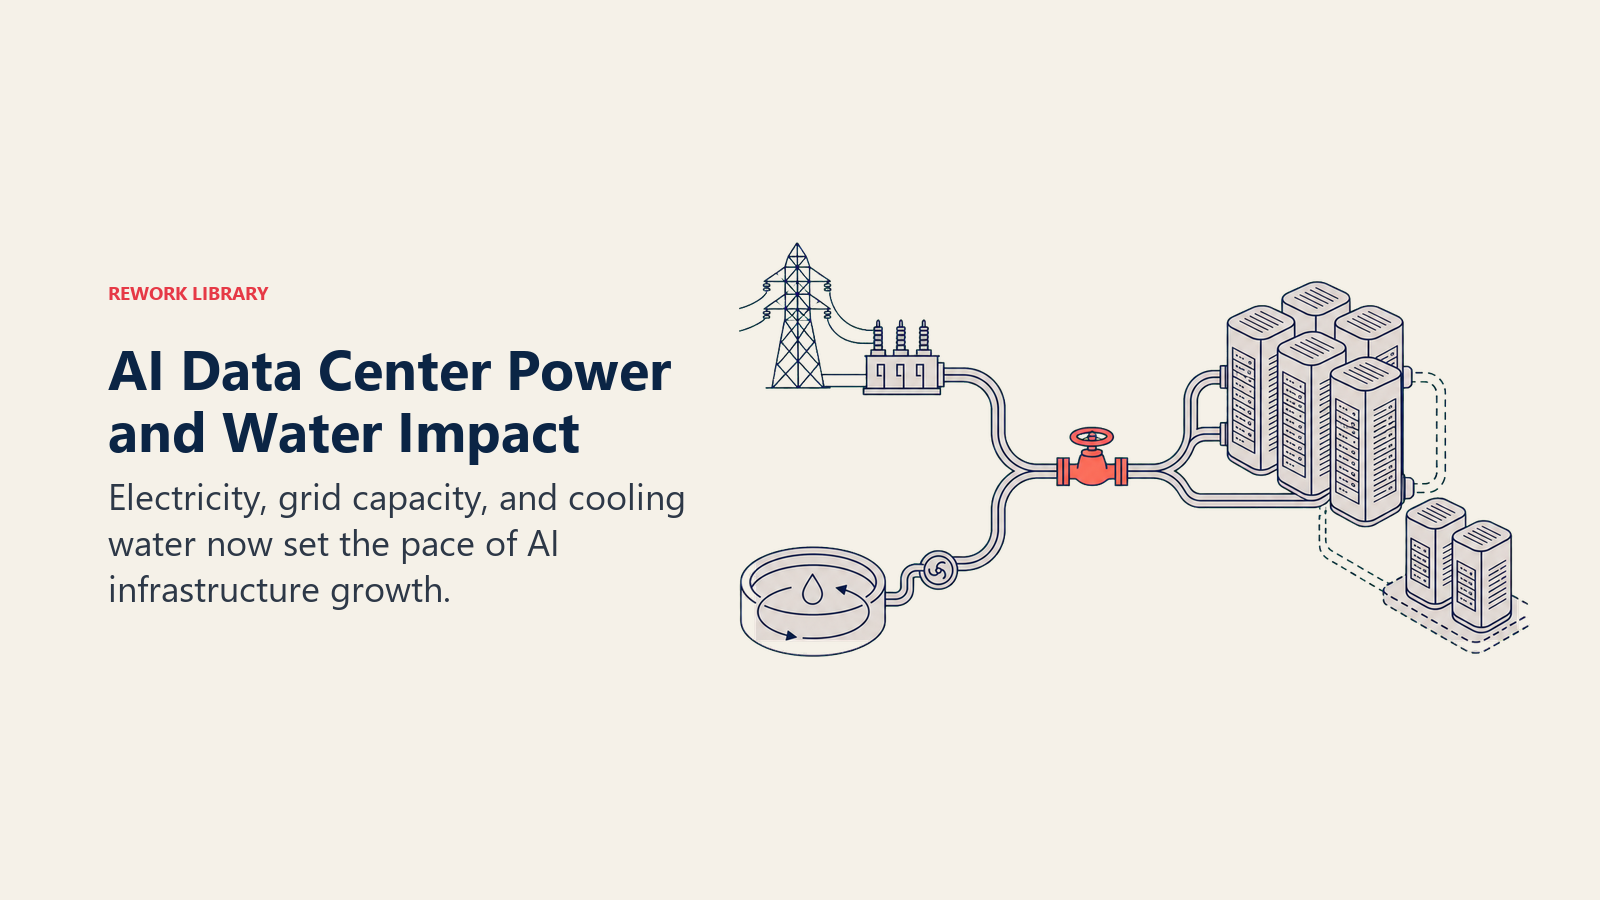
Goldman Sachs Research zeichnet ein ähnliches Bild: Die globale Stromnachfrage von Rechenzentren soll bis 2030 gegenüber dem Niveau von 2023 um rund 165 Prozent steigen, wobei Rechenzentren heute von 1 bis 2 Prozent des weltweiten Stromverbrauchs auf 3 bis 4 Prozent bis 2030 zulegen. In den USA könnte dieser Anteil bis 2030 auf 8 Prozent des nationalen Stromverbrauchs steigen, gegenüber rund 3 Prozent im Jahr 2022. Goldman schätzt, dass bis 2030 rund 720 Milliarden US-Dollar an Stromnetz-Investitionen nötig sein werden, nur um das Stromsystem in die Lage zu versetzen, diese Leistung zu liefern.
McKinsey fasst die Kapitalseite noch drastischer: Das Unternehmen prognostiziert, dass Rechenzentren weltweit bis 2030 rund 6,7 Billionen US-Dollar an Investitionsausgaben benötigen werden, um mit der Rechennachfrage Schritt zu halten, wobei 5,2 Billionen US-Dollar davon speziell auf KI-fähige Anlagen entfallen. Die weltweite Nachfrage nach Rechenzentrumskapazität könnte sich bis 2030 auf fast 219 Gigawatt nahezu verdreifachen, wobei rund 70 Prozent dieser neuen Nachfrage direkt aus KI-Workloads stammen.
Kühlung bringt eine zweite Ressourcenbeschränkung zusätzlich zum Strom mit sich. Flüssig- und Verdunstungskühlsysteme, die dichte GPU-Racks vor Überhitzung bewahren, können erhebliche Wassermengen ziehen, weshalb neue KI-Campus zunehmend auf lokalen Widerstand in dürregefährdeten Regionen stoßen und Hyperscaler zunehmend in geschlossene Kühlkreisläufe investieren, die Wasser recyceln statt zu verbrauchen. Es ist damit zu rechnen, dass Tarifverhandlungen mit Versorgungsunternehmen, Wasserrechte und Warteschlangen für Netzanschlüsse der praktische Engpass dafür bleiben, wie schnell neue KI-Kapazität tatsächlich ans Netz gehen kann, unabhängig davon, wie viel Kapital für den Bau verfügbar ist.
Warum das für Führungskräfte wichtig ist
Nichts davon ist abstrakt, wenn Ihr Unternehmen KI kauft oder darauf aufbaut. Die Wirtschaftlichkeit von Rechenzentren fließt direkt in das ein, was Sie für KI-Tools bezahlen, wie schnell Sie GPU-Kapazität für ein individuelles Projekt bekommen und welche Anbieter tatsächlich gemäß ihrer Roadmap liefern können und welche kapazitätsbeschränkt sind. Ein paar praktische Implikationen, die es zu verfolgen lohnt:
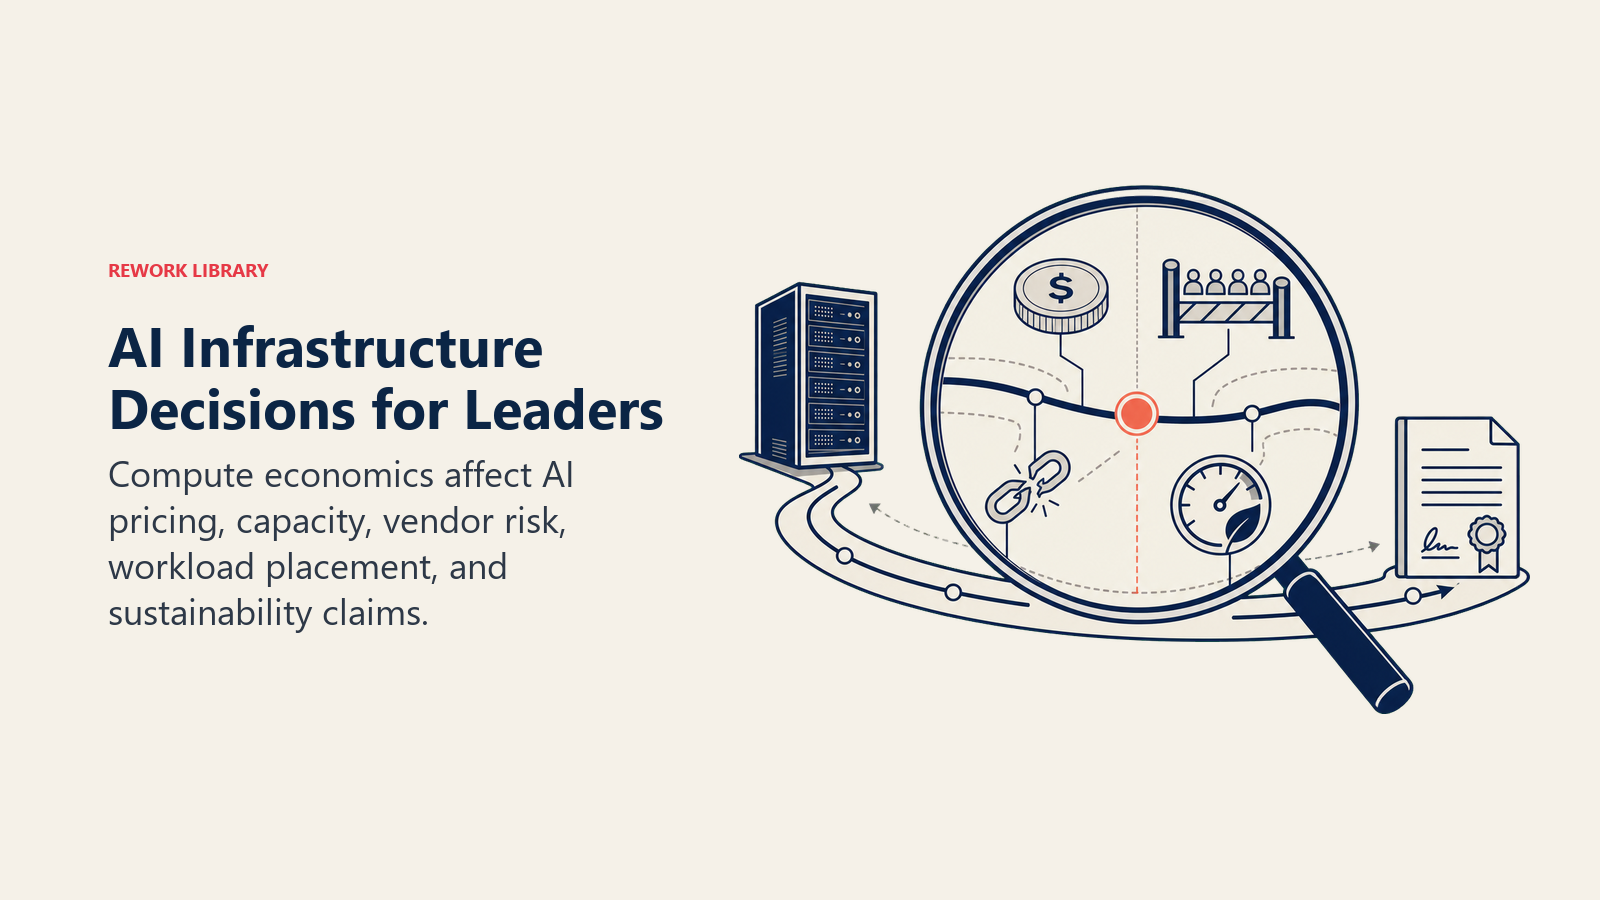
- Der Preisdruck wirkt in beide Richtungen. GPU-Knappheit hält Rechenleistung kurzfristig teuer, aber das Wettrennen bei den Investitionsausgaben treibt auch Effizienzgewinne (bessere Chips, bessere Kühlung, bessere Auslastung) voran, die die Kosten pro Einheit KI-Output langfristig senken. Modellieren Sie Ihre gesamten Betriebskosten von KI unter Berücksichtigung beider Trends, nicht nur des heutigen Listenpreises.
- Wo Ihre Workload läuft, ist wichtiger als früher. Latenzsensible Anwendungen verlagern Rechenleistung zunehmend näher zum Nutzer über Edge-AI, während intensives Training und Batch-Inferenz-Arbeit zentralisiert in Hyperscale-Campus verbleibt. Diesen Unterschied zu kennen hilft Ihnen, Architekturbehauptungen von Anbietern zu bewerten, statt "wir laufen auf KI-Infrastruktur" für bare Münze zu nehmen.
- Kapazitätsengpässe sind ein reales Anbieterrisiko. Wenn die Roadmap eines Anbieters von GPU- oder Stromverfügbarkeit abhängt, die er nicht selbst kontrolliert, lohnt es sich, direkt danach zu fragen, genauso wie Sie nach jedem anderen einzelnen Fehlerrisiko in einer kritischen Anbieterbeziehung fragen würden.
- Nachhaltigkeitsverpflichtungen kollidieren mit Wachstumszielen. Mehrere große Anbieter haben ihre Net-Zero-Zeitpläne öffentlich zurückgenommen oder abgeschwächt, da die Stromnachfrage der Rechenzentren ihren Ausbau erneuerbarer Energien überholt hat, eine Spannung, die es wert ist, bei jeder ESG-Behauptung eines Anbieters zu berücksichtigen, auf die Sie sich für Ihre eigene Berichterstattung verlassen.
Wichtige Fakten
- Der globale Stromverbrauch von Rechenzentren soll sich bis 2030 auf rund 945 Terawattstunden nahezu verdoppeln, etwa 3 Prozent des gesamten globalen Stromverbrauchs, wobei der Stromverbrauch KI-optimierter Server um rund 30 Prozent pro Jahr wächst. IEA
- In den Vereinigten Staaten sollen Rechenzentren voraussichtlich fast die Hälfte des gesamten Wachstums der Stromnachfrage zwischen jetzt und 2030 ausmachen. IEA
- KI soll bis 2030 einen Anstieg der globalen Stromnachfrage von Rechenzentren um 165 Prozent gegenüber 2023 antreiben, wodurch Rechenzentren von heute 1 bis 2 Prozent des weltweiten Stromverbrauchs auf 3 bis 4 Prozent bis 2030 zulegen, und auf rund 8 Prozent des US-Stromverbrauchs bis 2030 (gegenüber rund 3 Prozent im Jahr 2022). Goldman Sachs
- Schätzungsweise werden bis 2030 rund 720 Milliarden US-Dollar an Stromnetz-Investitionen benötigt, um die KI-bedingte Stromnachfrage von Rechenzentren zu unterstützen. Goldman Sachs
- Rechenzentren weltweit sollen bis 2030 rund 6,7 Billionen US-Dollar an Investitionsausgaben benötigen, um mit der Rechennachfrage Schritt zu halten, wobei 5,2 Billionen US-Dollar davon speziell auf KI-fähige Anlagen entfallen. McKinsey
- Die weltweite Nachfrage nach Rechenzentrumskapazität könnte sich bis 2030 auf rund 219 Gigawatt nahezu verdreifachen, wobei rund 70 Prozent der neuen Nachfrage aus KI-Workloads stammen. McKinsey
- Amazon, Alphabet, Microsoft und Meta haben gemeinsam rund 725 Milliarden US-Dollar an Investitionsausgaben für 2026 in Aussicht gestellt, ein Plus von etwa 77 Prozent gegenüber dem Rekordwert 410 Milliarden US-Dollar aus 2025, wobei der überwiegende Großteil für KI-Infrastruktur vorgesehen ist. CNBC
Häufig gestellte Fragen zu KI-Rechenzentren
Was ist ein KI-Rechenzentrum in einfachen Worten?
Ein KI-Rechenzentrum ist eine Anlage, die um große Cluster von GPUs und anderen KI-Beschleunigern herum gebaut ist und speziell dafür entworfen wurde, KI-Modelle im großen Maßstab zu trainieren und auszuführen. Es unterscheidet sich von einem gewöhnlichen Rechenzentrum vor allem in Leistungsdichte, Kühlung und der Vernetzung, die es Tausenden Chips erlaubt, gemeinsam an einer Aufgabe zu arbeiten.
Wie unterscheidet sich ein KI-Rechenzentrum von einem gewöhnlichen Rechenzentrum?
Ein gewöhnliches Rechenzentrum ist dafür gebaut, viele kleine, unabhängige Anfragen mit Standardservern und Luftkühlung zu bedienen. Ein KI-Rechenzentrum konzentriert weit mehr Leistung pro Rack, nutzt Flüssig- oder Immersionskühlung, um die Wärme zu managen, und setzt auf hochschnelle Interconnects, damit GPUs als ein großes System statt als separate Maschinen arbeiten können.
Warum brauchen KI-Rechenzentren so viel Strom?
Das Training und der Betrieb großer KI-Modelle erfordern Tausende GPUs, die gleichzeitig unter Volllast laufen, und jede GPU zieht weit mehr Strom als ein herkömmlicher Server-Chip. Die IEA prognostiziert, dass sich die globale Stromnachfrage von Rechenzentren bis 2030 nahezu verdoppeln wird, hauptsächlich getrieben von dieser Art KI-optimierter Rechenleistung.
Welche Hardware steckt in einem KI-Rechenzentrum?
Die Kernbestandteile sind GPUs oder andere KI-Beschleuniger, High Bandwidth Memory direkt neben diesen Chips, Hochgeschwindigkeits-Interconnects wie NVLink und InfiniBand, die sie verbinden, Flüssigkühlsysteme zur Wärmeabfuhr, dedizierte Stromversorgungsinfrastruktur und schneller Storage, der den Datenfluss zu den Chips aufrechterhält, ohne zum Engpass zu werden.
Wer baut derzeit die meisten KI-Rechenzentren?
Amazon, Alphabet (Google), Microsoft und Meta sind die größten Bauherren und haben gemeinsam rund 725 Milliarden US-Dollar an Investitionsausgaben für 2026 in Aussicht gestellt, der Großteil davon für KI-Infrastruktur. Unabhängige Cloud- und Colocation-Anbieter sowie souveräne nationale Initiativen in Regionen wie den Golfstaaten und Europa bauen ebenfalls Kapazität aus.
Welche Umweltbedenken gibt es rund um KI-Rechenzentren?
Die beiden größten Bedenken sind der Stromverbrauch, da KI-optimierte Rechenzentren der am schnellsten wachsende Treiber des globalen Stromverbrauchs sind, und der Wasserverbrauch für die Kühlung, da Flüssig- und Verdunstungskühlsysteme in Anlagen in wasserarmen Regionen erhebliche Wassermengen ziehen können.
Wie wirkt sich ein KI-Rechenzentrum auf die Kosten von KI-Tools aus?
Bau, Strom und Kühlung von Rechenzentren sind ein wichtiger Kostenfaktor für das, was Cloud-Anbieter für KI-Rechenleistung berechnen. Die Knappheit der GPU-Kapazität hält die Preise kurzfristig hoch, während Effizienzgewinne bei Chips und Kühlung die Kosten pro Einheit KI-Output im Laufe der Zeit allmählich senken.
Was ist der Unterschied zwischen Training und Inferenz in einem KI-Rechenzentrum?
Training ist der Prozess, ein Modell von Grund auf aufzubauen, eine extrem rechenintensive Aufgabe, die meist in großen Hyperscale-Campus läuft. Inferenz ist die Ausführung des bereits trainierten Modells, um reale Nutzeranfragen zu beantworten, was kontinuierlich geschieht und im großen Maßstab mehr Gesamtrechenleistung verbrauchen kann als das Training.
Sollte ein Unternehmen jemals ein eigenes KI-Rechenzentrum bauen?
Für fast alle Unternehmen: nein. Der Bau und Betrieb von KI-tauglicher Infrastruktur erfordert Kapital, Stromzugang und technische Expertise in einem Ausmaß, das nur Hyperscaler und spezialisierte Anbieter rechtfertigen können. Die meisten Unternehmen fahren besser damit, Kapazität von einem Cloud-Anbieter zu mieten und ihre eigenen Investitionen auf die darauf aufbauenden KI-Anwendungen zu konzentrieren.
Verwandte KI-Konzepte
- Was ist KI-Inferenz? - Die Produktions-Workload, die KI-Rechenzentren rund um die Uhr am Laufen hält
- Large Language Models - Was in diesen Anlagen tatsächlich trainiert wird
- Foundation Models - Die vortrainierten Modelle, die Hyperscale-Trainingsläufe lohnenswert machen
- Model Serving - Wie trainierte Modelle im großen Maßstab bereitgestellt werden, sobald das Training abgeschlossen ist
- Edge-AI - Die Alternative zu zentralisierten Rechenzentren für latenzsensible Workloads
- Quantisierung - Eine Schlüsseltechnik, um mehr Leistung aus vorhandener Rechenzentrumshardware herauszuholen
- Sovereign AI - Warum Nationen ihre eigene KI-Rechenzentrumskapazität aufbauen
- Gesamtbetriebskosten von KI - Wie die Wirtschaftlichkeit von Rechenzentren in das einfließt, was Unternehmen tatsächlich für KI bezahlen
Externe Ressourcen
- IEA: Energy and AI, Executive Summary - Prognosen zum globalen Stromverbrauch von Rechenzentren bis 2030
- IEA: AI is set to drive surging electricity demand from data centres - Regionale Aufschlüsselung des Nachfragewachstums
- Goldman Sachs: AI to Drive 165% Increase in Data Center Power Demand by 2030 - Stromnachfrage, Netzausgaben und Prognosen zum US-Anteil
- McKinsey: The Cost of Compute, a $7 Trillion Race to Scale Data Centers - Prognosen zu Investitionsausgaben und Kapazitätsnachfrage
- CNBC: Tech AI spending approaches $700 billion in 2026 - Capex-Prognosen der Hyperscaler für 2026
Teil der KI-Begriffe-Sammlung. Zuletzt aktualisiert: 2026-07-20

Co-Founder, Rework.com
On this page
- Wie sich ein KI-Rechenzentrum von einem herkömmlichen Rechenzentrum unterscheidet
- Die wichtigsten Komponenten in einem KI-Rechenzentrum
- Der KI-Rechenzentrum-Ausbau 2025-2026
- Strom-, Wasser- und Stromnetz-Auswirkungen
- Warum das für Führungskräfte wichtig ist
- Wichtige Fakten
- Verwandte KI-Konzepte
- Externe Ressourcen