O que é Test-Time Compute?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Atualizado em julho de 2026
Test-time compute, também chamado de inference-time compute, é o processamento extra que um modelo gasta raciocinando sobre um problema depois de receber uma consulta, em vez de depender apenas do que foi absorvido durante o treinamento. Em vez de responder instantaneamente, o modelo gera etapas intermediárias de raciocínio, testa múltiplas abordagens e verifica o próprio trabalho, gastando mais processamento por consulta para aumentar a precisão em problemas difíceis.
Durante boa parte da história dos large language models, obter uma resposta mais inteligente significava treinar um modelo maior. O test-time compute quebrou essa premissa. Um modelo agora pode ficar mensuravelmente mais inteligente em uma pergunta específica apenas recebendo mais tempo e mais processamento para trabalhar nela, sem alterar um único parâmetro treinado.
De Modelos Maiores para Pensamento Mais Longo
Por anos, o progresso da IA seguiu um padrão simples: adicione mais parâmetros, mais dados de treinamento, mais processamento de treinamento, e o modelo melhora. Isso é o train-time scaling, e definiu o campo desde os primeiros modelos GPT até os lançamentos de fronteira da metade dos anos 2020. Todo ganho vinha de uma rodada de treinamento maior e mais cara, e o modelo resultante então respondia a toda consulta em aproximadamente o mesmo tempo, não importa quão difícil fosse a pergunta.
O o1 da OpenAI, lançado em setembro de 2024, quebrou esse padrão. Em vez de escalar o modelo, o o1 escalou o tempo que o modelo tinha permissão para "pensar" antes de responder, gerando uma cadeia interna de raciocínio que o modelo percorre antes de se comprometer com uma resposta final. Os resultados deixaram claro que o tempo de pensamento era uma alavanca própria, separada do tamanho do modelo.
De acordo com o relatório Stanford AI Index 2025, o o1 pontuou 74,4% em um exame classificatório da Olimpíada Internacional de Matemática, contra 9,3% do GPT-4o, nas mesmas questões. O trade-off também foi real: o relatório observa que o o1 é quase seis vezes mais caro e 30 vezes mais lento que o GPT-4o. Esse trade-off, mais precisão por mais custo e mais tempo, é toda a premissa do test-time compute.
Como "Pensar Mais" Realmente Melhora as Respostas
Um large language model padrão gera sua resposta token por token, em uma única passagem direta, sem nenhum mecanismo para parar, reconsiderar ou verificar sua própria lógica antes que a resposta esteja completa. É por isso que ele pode afirmar uma resposta errada com a mesma confiança fluente de uma certa.
Os modelos de raciocínio construídos para test-time compute adicionam três coisas que um modelo padrão não faz por padrão:
Traços de raciocínio estendidos. O modelo gera uma longa sequência interna de etapas intermediárias, trabalhando em subproblemas, verificando restrições e narrando sua própria lógica antes de produzir uma resposta final. Esse é o mecanismo por trás do raciocínio chain-of-thought, escalado e frequentemente executado fora do que o usuário vê.
Amostragem e seleção. Em vez de gerar uma única resposta, o modelo pode gerar várias soluções candidatas e escolher a melhor, seja por voto majoritário (a resposta com a qual a maioria dos candidatos concorda) ou por uma função de pontuação aprendida que classifica os candidatos pela probabilidade de estarem corretos.
Autoverificação. O modelo verifica seu próprio raciocínio em relação às restrições do problema e pode retroceder para tentar uma abordagem diferente quando uma etapa não se sustenta, de forma parecida com como uma pessoa revisa duas vezes seu trabalho antes de entregá-lo.
Os próprios resultados da OpenAI no exame de matemática AIME 2024 mostram quanto vale cada uma dessas alavancas isoladamente. De acordo com as notas de lançamento da OpenAI para o o1, o modelo teve em média 74% de precisão com uma única amostra por problema, subiu para 83% ao usar consenso entre 64 amostras, e chegou a 93% ao reordenar 1.000 amostras com uma função de pontuação aprendida, tudo usando exatamente o mesmo modelo subjacente. O GPT-4o, sem raciocínio em test-time, resolveu apenas 12% dos mesmos problemas. Nada nos parâmetros do modelo mudou entre esses três resultados. Apenas a quantidade de test-time compute mudou.
A Nova Lei de Escalonamento
Antes de 2024, "lei de escalonamento" significava uma única coisa em IA: desempenho em função do processamento de treinamento, dos parâmetros do modelo e dos dados de treinamento. O test-time compute adicionou um segundo eixo. Um artigo de 2024 de pesquisadores da UC Berkeley e do Google DeepMind, Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parameters, formalizou isso: alocar test-time compute de forma "otimizada em processamento", combinando o esforço de raciocínio com a dificuldade do prompt específico em vez de gastar uma quantidade fixa em toda consulta, melhorou a eficiência em mais de 4x em comparação com uma linha de base ingênua de best-of-N. Em uma comparação equalizada por FLOPs, o artigo descobriu que o test-time compute permitiu que um modelo menor superasse um modelo 14 vezes maior.
Essa descoberta reformula a questão de construir versus comprar para os laboratórios de fronteira e, por consequência, para as empresas que compram seus modelos. Um laboratório com um orçamento de processamento fixo agora tem dois lugares para gastá-lo: uma rodada de treinamento maior e mais cara que melhora cada resposta futura em uma pequena margem, ou um sistema de raciocínio que permite que um modelo já existente gaste mais processamento nas consultas específicas que precisam disso.
O trade-off não desaparece em escala, ele só fica mais visível. O modelo o3 da OpenAI, avaliado no benchmark ARC-AGI-Pub, mostra essa curva diretamente: uma configuração de alta eficiência pontuou 75,7% na avaliação semiprivada a um custo de processamento de US$ 26 por tarefa, enquanto uma configuração de baixa eficiência, usando aproximadamente 172 vezes mais processamento, pontuou 87,5% a US$ 4.560 por tarefa. Doze pontos a mais de precisão custaram mais de 170 vezes o processamento. Essa é a forma do test-time scaling na prática: ganhos reais, a um preço que sobe de forma acentuada a cada ponto adicional.
Test-Time Compute vs. Train-Time Compute
| Dimensão | Train-Time Compute | Test-Time Compute |
|---|---|---|
| Quando acontece | Uma vez, durante o desenvolvimento do modelo, antes da implantação | Toda vez que o modelo responde a uma consulta, em produção |
| O que muda | Os parâmetros do modelo (pesos) | Nada no modelo, apenas quanto esforço de raciocínio é gasto em uma consulta |
| Formato do custo | Grande, antecipado, gasto no estilo de projeto | Por consulta, baseado em uso, escala com o volume e com o quão "difícil" uma pergunta é tratada |
| O que compra | Um modelo geralmente mais capaz, para toda consulta futura | Uma resposta melhor para essa consulta específica, com latência e custo mais altos apenas para ela |
| Alavancas principais | Mais parâmetros, mais dados de treinamento, treinamentos mais longos | Cadeias de raciocínio mais longas, mais candidatos amostrados, passagens de autoverificação |
| Modo de falha se exagerado | Um modelo caro que ainda é medíocre se a receita estava errada | Uma resposta lenta e cara para uma pergunta que não precisava de raciocínio profundo |
Os dois eixos ainda são leis de escalonamento no sentido técnico: o desempenho melhora como uma função aproximadamente previsível do processamento gasto. A diferença está em quando você paga e o que recebe em troca. O train-time compute é um investimento único no próprio modelo. O test-time compute é uma decisão por consulta que uma empresa, ou a aplicação que chama o modelo, precisa tomar toda vez.
Trade-offs de Custo e Latência
O test-time compute não é gratuito, e isso aparece em dois lugares ao mesmo tempo: dinheiro e tempo.
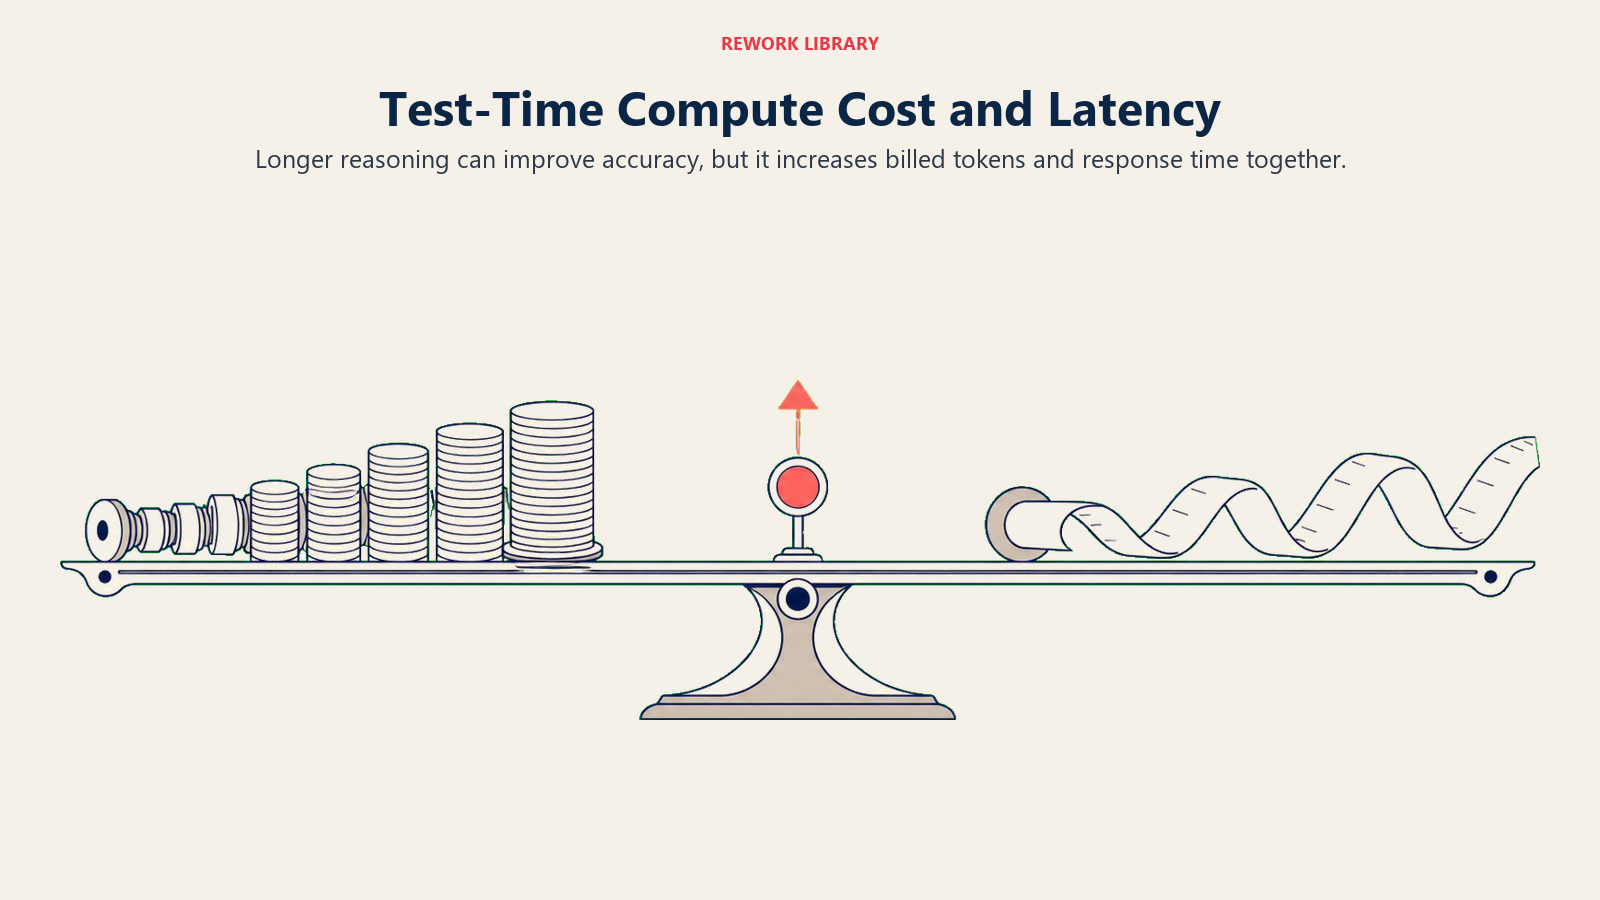
Latência. Um modelo padrão responde em uma fração de segundo a alguns segundos. Um modelo de raciocínio percorrendo uma cadeia de pensamento estendida pode levar de vários segundos a múltiplos minutos, dependendo de quanto raciocínio interno ele gera antes de produzir uma resposta visível. Para casos de uso interativos, essa diferença é tudo: um agente de suporte que espera 20 segundos em vez de 2 por uma resposta vai encontrar uma solução alternativa, ou parar de usar a ferramenta. Veja latência para entender como o tempo de resposta define se um recurso realmente é adotado.
Custo. Os tokens de raciocínio também não são gratuitos, e a maioria deles é invisível. De acordo com a Artificial Analysis, o o3 da OpenAI custa US$ 2,00 por milhão de tokens de entrada e US$ 8,00 por milhão de tokens de saída, e os tokens internos de raciocínio, aqueles gerados durante o processo de "pensamento" do modelo, são cobrados como tokens de saída mesmo que o usuário nunca os veja na resposta. Uma resposta visível curta pode estar sobre um traço de raciocínio muito maior e cobrado. Esse é um perfil de custo estruturalmente diferente de um modelo padrão, onde a contagem de tokens que você vê é próxima da contagem de tokens que você paga.
A consequência prática é que o test-time compute transforma "quão profundamente o modelo deve pensar sobre isso" em uma decisão de controle de custo, não apenas de qualidade. Técnicas de otimização de inferência, como limitar o comprimento do raciocínio, direcionar consultas fáceis para um modelo rápido e escalar apenas as difíceis para um modelo de raciocínio, e fazer cache de consultas repetidas, tornam-se mais valiosas assim que uma parcela significativa das consultas carrega uma conta de tokens de raciocínio variável e, às vezes, grande.
Implicações para os Negócios: Quando Faz Sentido Usar Modelos de Raciocínio
Nem todo recurso de IA precisa de test-time compute, e tratar toda consulta como se precisasse é a forma mais rápida de transformar um piloto promissor em um piloto caro. A decisão se resume a uma pergunta bastante simples: quão custosa é uma resposta errada, comparada a quão custosa é uma resposta lenta ou cara?
Use um modelo padrão e rápido quando: a tarefa tem alto volume, a resposta é obviamente correta ou fácil de verificar, e a velocidade importa para quem está esperando por ela. Respostas de FAQ de clientes, classificação básica, geração de rascunhos iniciais de conteúdo e extração de dados rotineira se encaixam nesse padrão. Rodar cada uma dessas tarefas em um modelo de raciocínio queima orçamento com uma precisão que a tarefa não precisava.
Reserve o test-time compute para: análises de múltiplas etapas em que um erro é caro de detectar depois do fato, tarefas com um grande espaço de soluções em que o modelo se beneficia de explorar alternativas, e qualquer fluxo de trabalho em que uma pessoa vá agir sobre a saída sem derivá-la de forma independente, como modelagem financeira, análise de contratos ou depuração técnica. Esses são os casos em que o trade-off de "seis vezes mais caro, 30 vezes mais lento" do Stanford AI Index vale a pena pagar.
A implicação orçamentária para um líder patrocinando trabalho de IA: o custo por consulta de um recurso baseado em modelo de raciocínio não é um número fixo como muitas vezes era com modelos padrão. Ele varia conforme o quão difícil cada consulta individual acaba sendo, já que o próprio modelo decide quanto precisa raciocinar. Isso faz do monitoramento de uso e da lógica de roteamento, enviando apenas as consultas que precisam de raciocínio profundo para o modelo caro, parte do plano de controle de custos desde o primeiro dia, não uma reflexão tardia quando a conta chega. Agentes de IA que encadeiam múltiplas chamadas de modelo compõem esse efeito ainda mais, já que um fluxo de trabalho de agente com múltiplas etapas pode invocar o raciocínio em test-time várias vezes em uma única tarefa.
Dados Importantes
- O o1 da OpenAI pontuou 74,4% em um exame classificatório da Olimpíada Internacional de Matemática, contra 9,3% do GPT-4o, mas o o1 é quase seis vezes mais caro e 30 vezes mais lento que o GPT-4o, segundo o relatório Stanford AI Index 2025.
- Nos exames de matemática AIME de 2024, o o1 teve em média 74% de precisão com uma única amostra por problema, 83% com consenso entre 64 amostras, e 93% ao reordenar 1.000 amostras, contra 12% do GPT-4o nos mesmos problemas, de acordo com as notas oficiais de lançamento do o1 da OpenAI.
- Uma estratégia de escalonamento de test-time compute otimizada em processamento pode melhorar a eficiência em mais de 4x em comparação com uma linha de base ingênua de best-of-N, e em comparações equalizadas por FLOPs, o test-time compute permitiu que um modelo menor superasse um 14 vezes maior, segundo o artigo da Berkeley e da DeepMind Scaling LLM Test-Time Compute Optimally.
- No benchmark ARC-AGI-Pub, uma configuração de alta eficiência do o3 da OpenAI pontuou 75,7% a US$ 26 por tarefa, enquanto uma configuração de baixa eficiência pontuou 87,5% a US$ 4.560 por tarefa, usando aproximadamente 172 vezes mais processamento para um ganho de 12 pontos de precisão, segundo os resultados oficiais do ARC Prize.
- O o3 da OpenAI custa US$ 2,00 por milhão de tokens de entrada e US$ 8,00 por milhão de tokens de saída, e os tokens internos de raciocínio são cobrados como tokens de saída mesmo que nunca apareçam na resposta visível, de acordo com a Artificial Analysis.
Conceitos Relacionados de IA
- Modelos de Raciocínio - A categoria de modelo construída especificamente para usar test-time compute
- Inferência - A fase de produção mais ampla da qual o test-time compute é uma forma de custo variável
- Chain-of-Thought - A técnica de raciocínio passo a passo que o test-time compute escala
- Large Language Models - A categoria de modelo base que os modelos de raciocínio estendem
- Otimização de Inferência - Técnicas para controlar custo e latência na inferência
- Latência - Por que o tempo de pensamento extra no test-time compute afeta a adoção
- Agentes de IA - Sistemas de múltiplas etapas em que o custo de raciocínio em test-time pode se acumular
- Modelos de Fundação - Os modelos base sobre os quais a capacidade de raciocínio é construída
Recursos Externos
- Stanford AI Index 2025, Technical Performance - Dados de benchmark independentes sobre a precisão, o custo e a latência do o1 em comparação com o GPT-4o
- OpenAI: Learning to Reason with LLMs - Notas de lançamento e dados de benchmark da própria OpenAI para o o1
- Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parameters - O artigo da Berkeley/DeepMind que formaliza o test-time compute como uma lei de escalonamento
- ARC Prize: o3 ARC-AGI-Pub Results - Dados oficiais de custo por tarefa entre configurações de processamento
Perguntas Frequentes sobre Test-Time Compute
O que é test-time compute?
Test-time compute, também chamado de inference-time compute, é o processamento extra que um modelo gasta raciocinando sobre um problema quando recebe uma consulta, em vez de depender apenas do que foi aprendido durante o treinamento. Isso inclui gerar cadeias de raciocínio estendidas, amostrar múltiplas respostas candidatas e se autoverificar antes de responder.
Como o test-time compute é diferente do processamento de treinamento?
O processamento de treinamento é gasto uma vez, antes da implantação, para definir os parâmetros do modelo. O test-time compute é gasto toda vez que o modelo responde a uma consulta, e não muda o modelo em nada, muda apenas quanto esforço de raciocínio entra nessa resposta específica.
Por que o o1 da OpenAI tornou o test-time compute um grande assunto?
O o1, lançado em setembro de 2024, mostrou que dar a um modelo mais tempo para raciocinar na inferência poderia produzir grandes ganhos de precisão em problemas difíceis sem nenhuma mudança no tamanho do modelo ou no treinamento. Segundo o relatório Stanford AI Index 2025, ele pontuou 74,4% em um exame classificatório da Olimpíada Internacional de Matemática contra 9,3% do GPT-4o, a aproximadamente seis vezes o custo e 30 vezes a latência.
Mais test-time compute sempre significa uma resposta melhor?
Ele melhora a precisão em problemas que se beneficiam de raciocínio em múltiplas etapas, mas os ganhos diminuem conforme o processamento aumenta. Os resultados do o3 da OpenAI no ARC-AGI-Pub mostram um ganho de 12 pontos de precisão para aproximadamente 172 vezes mais processamento entre as configurações eficiente e de alto processamento. Em tarefas simples e bem definidas, o raciocínio extra costuma adicionar custo e latência sem uma melhora significativa de precisão.
Como o test-time compute afeta os custos de API?
Os modelos de raciocínio cobram os tokens internos de "pensamento" como tokens de saída, mesmo que esses tokens nunca apareçam na resposta visível. Isso significa que a mesma resposta visível pode carregar uma conta de tokens muito maior do que carregaria em um modelo padrão, e o custo total varia por consulta, já que o modelo decide o quanto precisa raciocinar.
Quais tarefas se beneficiam mais do test-time compute?
Análises de múltiplas etapas, tarefas com um grande espaço de soluções e fluxos de trabalho em que uma resposta errada é cara de detectar depois, como modelagem financeira, análise de contratos ou depuração técnica, se beneficiam mais. Tarefas de alto volume e baixo risco, como respostas de FAQ ou classificação básica, geralmente não precisam disso.
Test-time compute é o mesmo que chain-of-thought prompting?
Eles são relacionados, mas não idênticos. Chain-of-thought é a técnica de gerar raciocínio passo a passo antes de uma resposta. Test-time compute é a categoria mais ampla que inclui chain-of-thought além de outras técnicas, como amostrar múltiplos candidatos e autoverificação, todas aplicadas no momento da inferência.
O test-time scaling vai substituir o treinamento de modelos maiores?
Não, eles são complementares, não um substituto um do outro. Pesquisas como o artigo Scaling LLM Test-Time Compute Optimally mostram que o test-time compute pode permitir que um modelo menor iguale ou supere um muito maior em tarefas específicas, mas os laboratórios de fronteira continuam investindo tanto em rodadas de treinamento maiores quanto em melhor raciocínio em test-time, já que cada um compra algo diferente.
Parte da Coleção de Termos de IA. Última atualização: 2026-07-16

Co-Founder, Rework.com
On this page
- De Modelos Maiores para Pensamento Mais Longo
- Como "Pensar Mais" Realmente Melhora as Respostas
- A Nova Lei de Escalonamento
- Test-Time Compute vs. Train-Time Compute
- Trade-offs de Custo e Latência
- Implicações para os Negócios: Quando Faz Sentido Usar Modelos de Raciocínio
- Dados Importantes
- Conceitos Relacionados de IA
- Recursos Externos