Bahasa Indonesia
Apa itu Test-Time Compute?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Diperbarui Juli 2026
Test-time compute, yang juga disebut inference-time compute, adalah komputasi tambahan yang dihabiskan model untuk bernalar melalui suatu masalah setelah menerima kueri, alih-alih hanya mengandalkan apa yang sudah tertanam selama pelatihan. Alih-alih langsung menjawab, model menghasilkan langkah-langkah penalaran perantara, mencoba berbagai pendekatan, dan memeriksa hasil kerjanya sendiri, menghabiskan lebih banyak compute per kueri untuk meningkatkan akurasi pada masalah yang sulit.
Sepanjang sebagian besar sejarah large language model, mendapatkan jawaban yang lebih cerdas berarti melatih model yang lebih besar. Test-time compute mematahkan asumsi itu. Sebuah model kini bisa menjadi jauh lebih cerdas secara terukur pada pertanyaan tertentu hanya dengan diberi lebih banyak waktu dan lebih banyak komputasi untuk menyelesaikannya, tanpa mengubah satu pun parameter hasil pelatihannya.
Dari Model yang Lebih Besar ke Pemikiran yang Lebih Panjang
Selama bertahun-tahun, kemajuan AI mengikuti pola sederhana: tambahkan lebih banyak parameter, lebih banyak data pelatihan, lebih banyak compute pelatihan, dan model menjadi lebih baik. Ini disebut train-time scaling, dan pola ini mendefinisikan bidang ini sejak model GPT pertama hingga rilis-rilis frontier pertengahan 2020-an. Setiap peningkatan berasal dari proses pelatihan yang lebih besar dan lebih mahal, dan model yang dihasilkan kemudian menjawab setiap kueri dalam waktu yang kurang lebih sama, tidak peduli seberapa sulit pertanyaannya.
o1 dari OpenAI, dirilis pada September 2024, mematahkan pola itu. Alih-alih menskalakan model, o1 menskalakan berapa lama model diizinkan untuk "berpikir" sebelum menjawab, menghasilkan rantai penalaran internal yang dilalui model sebelum memberikan jawaban akhir. Hasilnya menunjukkan dengan jelas bahwa waktu berpikir adalah tuas tersendiri, terpisah dari ukuran model.
Menurut laporan Stanford AI Index 2025, o1 mencetak skor 74.4% pada ujian kualifikasi International Mathematical Olympiad, dibandingkan dengan 9.3% milik GPT-4o, pada soal yang sama. Trade-off itu juga nyata: laporan tersebut mencatat bahwa o1 hampir enam kali lebih mahal dan 30 kali lebih lambat dibandingkan GPT-4o. Trade-off itu, yaitu akurasi yang lebih tinggi dengan biaya dan waktu yang lebih besar, adalah inti dari premis test-time compute.
Bagaimana "Berpikir Lebih Lama" Sebenarnya Meningkatkan Kualitas Jawaban
Large language model standar menghasilkan responsnya token demi token, dalam satu kali forward pass, tanpa mekanisme untuk berhenti, mempertimbangkan ulang, atau memeriksa logikanya sendiri sebelum jawabannya selesai. Itulah sebabnya model bisa menyatakan jawaban yang salah dengan kepercayaan diri yang sama lancarnya seperti jawaban yang benar.
Reasoning model yang dibangun untuk test-time compute menambahkan tiga hal yang tidak dilakukan model standar secara default:
Jejak penalaran yang diperluas. Model menghasilkan urutan internal yang panjang dari langkah-langkah perantara, menyelesaikan sub-masalah, memeriksa batasan, dan menjabarkan logikanya sendiri sebelum menghasilkan jawaban akhir. Ini adalah mekanisme di balik penalaran chain-of-thought, yang diskalakan lebih jauh dan sering dijalankan di luar yang terlihat oleh pengguna.
Sampling dan seleksi. Alih-alih menghasilkan satu jawaban, model dapat menghasilkan beberapa kandidat solusi dan memilih yang terbaik, baik melalui majority vote (jawaban yang paling banyak disepakati oleh kandidat) atau fungsi penilaian yang dipelajari (learned scoring function) yang mengurutkan kandidat berdasarkan kemungkinan kebenarannya.
Self-verification. Model memeriksa penalarannya sendiri terhadap batasan-batasan masalah dan dapat mundur (backtrack) untuk mencoba pendekatan yang berbeda ketika satu langkah tidak terbukti valid, mirip dengan cara seseorang memeriksa ulang pekerjaannya sebelum menyerahkannya.
Hasil OpenAI sendiri pada ujian matematika AIME 2024 menunjukkan seberapa besar nilai masing-masing tuas ini jika berdiri sendiri. Menurut catatan rilis OpenAI untuk o1, model ini rata-rata mencapai akurasi 74% dengan satu sampel per soal, naik menjadi 83% ketika menggunakan konsensus dari 64 sampel, dan mencapai 93% ketika melakukan re-ranking terhadap 1,000 sampel dengan fungsi penilaian yang dipelajari, semuanya menggunakan model dasar yang persis sama. GPT-4o, tanpa penalaran test-time, hanya menyelesaikan 12% dari soal yang sama. Tidak ada perubahan apa pun pada parameter model di antara ketiga skor tersebut. Hanya jumlah test-time compute yang berubah.
Hukum Penskalaan Baru
Sebelum 2024, "scaling law" (hukum penskalaan) di dunia AI hanya berarti satu hal: performa sebagai fungsi dari compute pelatihan, parameter model, dan data pelatihan. Test-time compute menambahkan sumbu kedua. Sebuah makalah tahun 2024 dari para peneliti UC Berkeley dan Google DeepMind, Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parameters, memformalkan hal ini: mengalokasikan test-time compute secara "compute-optimal", yaitu menyesuaikan upaya penalaran dengan tingkat kesulitan prompt tertentu alih-alih menghabiskan jumlah yang sama rata untuk setiap kueri, meningkatkan efisiensi lebih dari 4x dibandingkan baseline sampling best-of-N yang naif. Dalam perbandingan yang disetarakan berdasarkan FLOPs, makalah tersebut menemukan bahwa test-time compute memungkinkan model yang lebih kecil mengungguli model yang 14 kali lebih besar.
Temuan ini mengubah cara pandang terhadap pertanyaan build-versus-buy bagi lab-lab frontier dan, pada akhirnya, bagi bisnis yang membeli model mereka. Sebuah lab yang menghadapi anggaran compute tetap kini memiliki dua tempat untuk membelanjakannya: proses pelatihan yang lebih besar dan lebih mahal yang meningkatkan setiap respons di masa depan dengan margin kecil, atau sistem penalaran yang memungkinkan model yang sudah ada membelanjakan lebih banyak compute pada kueri-kueri spesifik yang membutuhkannya.
Trade-off ini tidak hilang seiring skala yang membesar, hanya menjadi lebih terlihat. Model o3 dari OpenAI, yang dievaluasi pada benchmark ARC-AGI-Pub, menunjukkan kurva ini secara langsung: konfigurasi berefisiensi tinggi mencetak skor 75.7% pada evaluasi semi-privat dengan biaya compute $26 per task, sementara konfigurasi berefisiensi rendah, yang menggunakan compute sekitar 172 kali lebih banyak, mencetak skor 87.5% dengan biaya $4,560 per task. Dua belas poin akurasi tambahan itu berbiaya lebih dari 170 kali lipat compute. Itulah bentuk test-time scaling dalam praktik: peningkatan yang nyata, dengan harga yang naik tajam untuk setiap poin tambahan.
Test-Time Compute vs. Train-Time Compute
| Dimensi | Train-Time Compute | Test-Time Compute |
|---|---|---|
| Kapan terjadi | Sekali, selama pengembangan model, sebelum deployment | Setiap kali model menjawab kueri, di lingkungan produksi |
| Apa yang berubah | Parameter model (bobot/weights) | Tidak ada yang berubah pada model, hanya seberapa besar upaya penalaran yang dihabiskan untuk satu kueri |
| Bentuk biaya | Besar, dibayar di muka, seperti pengeluaran proyek | Per kueri, berbasis penggunaan, meningkat sesuai volume dan seberapa "sulit" suatu pertanyaan diperlakukan |
| Apa yang didapat | Model yang secara umum lebih mumpuni, untuk setiap kueri di masa depan | Jawaban yang lebih baik untuk kueri spesifik ini, dengan latensi dan biaya yang lebih tinggi hanya untuk kueri tersebut |
| Tuas utama | Lebih banyak parameter, lebih banyak data pelatihan, proses pelatihan yang lebih lama | Rantai penalaran yang lebih panjang, lebih banyak kandidat yang di-sampling, proses self-verification |
| Mode kegagalan jika berlebihan | Model mahal yang tetap biasa-biasa saja jika resepnya salah | Jawaban yang lambat dan mahal untuk pertanyaan yang sebenarnya tidak membutuhkan penalaran mendalam |
Kedua sumbu ini tetap merupakan scaling law dalam pengertian teknis: performa meningkat sebagai fungsi yang kurang lebih dapat diprediksi dari compute yang dihabiskan. Perbedaannya terletak pada kapan Anda membayar dan apa yang Anda dapatkan darinya. Train-time compute adalah investasi satu kali pada model itu sendiri. Test-time compute adalah keputusan per kueri yang harus diambil oleh bisnis, atau aplikasi yang memanggil model tersebut, setiap kali digunakan.
Trade-off Biaya dan Latensi
Test-time compute tidaklah gratis, dan biayanya muncul di dua tempat sekaligus: uang dan waktu.
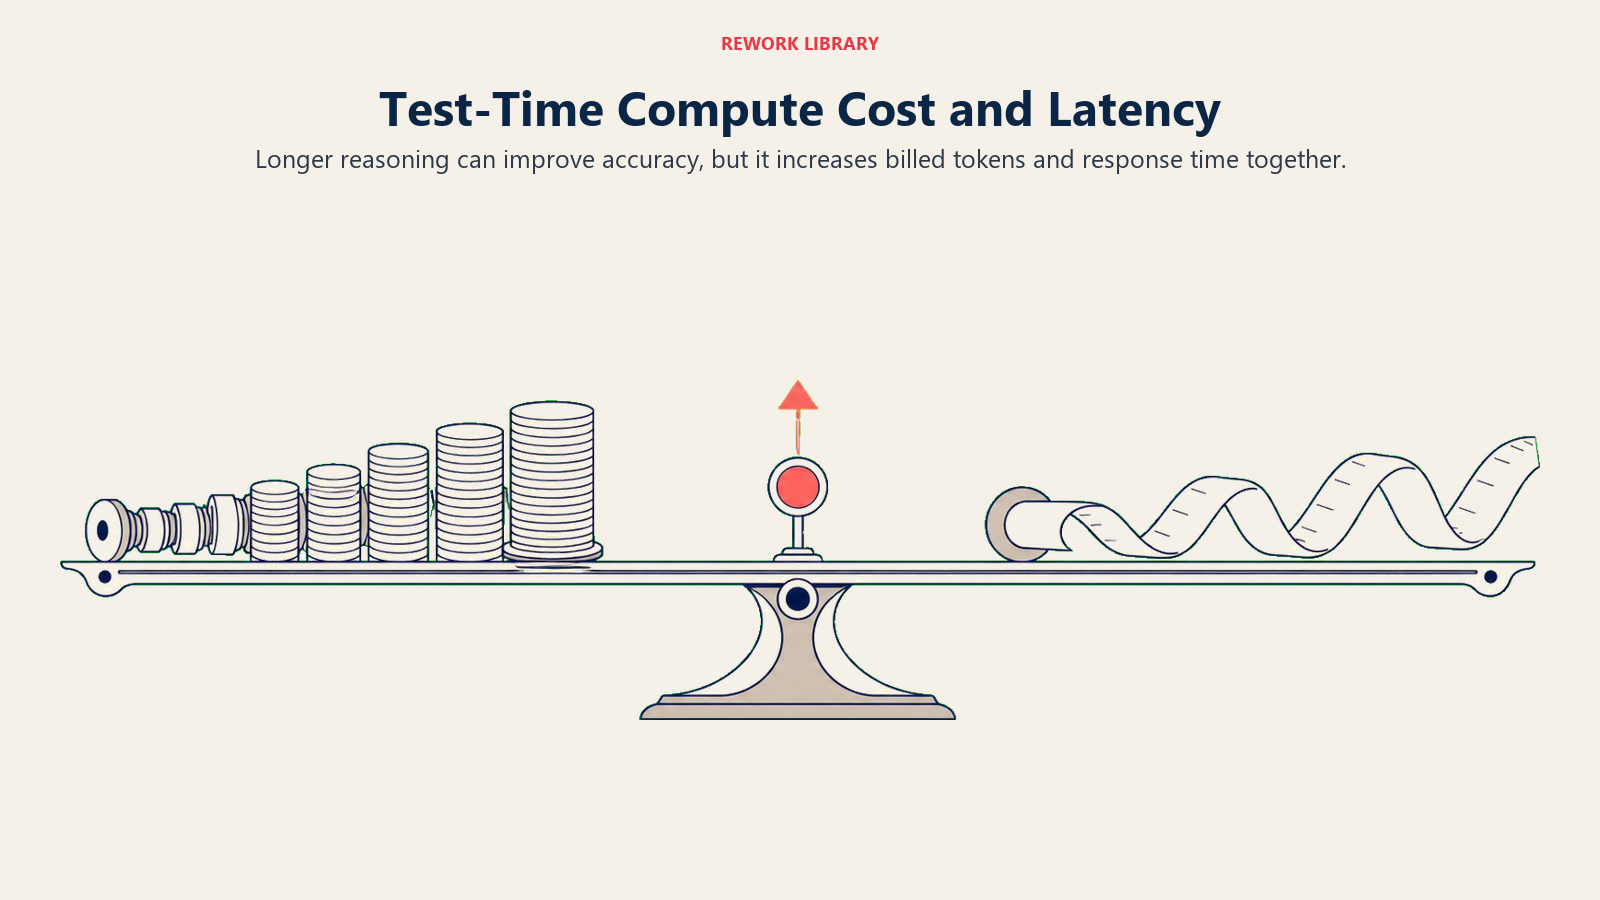
Latensi. Model standar merespons dalam hitungan sepersekian detik hingga beberapa detik. Reasoning model yang bekerja melalui chain of thought yang diperluas bisa memakan waktu mulai dari beberapa detik hingga berbagai menit, tergantung seberapa banyak penalaran internal yang dihasilkannya sebelum memunculkan jawaban yang terlihat. Untuk kasus penggunaan interaktif, perbedaan ini menentukan segalanya: agen dukungan yang menunggu 20 detik alih-alih 2 detik untuk sebuah jawaban akan mencari cara lain, atau berhenti menggunakan alat tersebut. Lihat latensi untuk memahami bagaimana waktu respons menentukan apakah sebuah fitur benar-benar diadopsi.
Biaya. Token penalaran juga tidak gratis, dan sebagian besar darinya tidak terlihat. Menurut Artificial Analysis, o3 dari OpenAI dihargai $2.00 per juta token input dan $8.00 per juta token output, dan token penalaran internal, yaitu token yang dihasilkan selama proses "berpikir" model, ditagih sebagai token output meskipun pengguna tidak pernah melihatnya dalam respons. Jawaban singkat yang terlihat bisa saja berdiri di atas jejak penalaran yang jauh lebih besar dan tetap ditagihkan. Ini adalah profil biaya yang secara struktural berbeda dari model standar, di mana jumlah token yang Anda lihat mendekati jumlah token yang Anda bayar.
Konsekuensi praktisnya adalah test-time compute mengubah pertanyaan "seberapa keras model ini harus berpikir" menjadi keputusan pengendalian biaya, bukan hanya keputusan kualitas. Teknik optimisasi inferensi, seperti membatasi panjang penalaran, mengarahkan kueri yang mudah ke model yang cepat dan hanya mengeskalasikan kueri yang sulit ke reasoning model, serta melakukan caching untuk kueri yang berulang, semuanya menjadi lebih bernilai begitu sebagian besar kueri membawa tagihan token penalaran yang bervariasi, dan terkadang besar.
Implikasi Bisnis: Kapan Harga Reasoning Model Masuk Akal
Tidak semua fitur AI membutuhkan test-time compute, dan memperlakukan setiap kueri seolah-olah membutuhkannya adalah cara tercepat untuk mengubah pilot yang menjanjikan menjadi pilot yang mahal. Keputusannya bermuara pada pertanyaan yang cukup sederhana: seberapa mahal biaya sebuah jawaban yang salah, dibandingkan dengan biaya jawaban yang lambat atau mahal?
Gunakan model standar yang cepat saat: tugasnya bervolume tinggi, jawabannya jelas benar atau mudah diperiksa, dan kecepatan penting bagi orang yang menunggu jawaban tersebut. Respons FAQ pelanggan, klasifikasi dasar, pembuatan draf konten pertama, dan ekstraksi data rutin semuanya cocok dengan pola ini. Menjalankan semua tugas ini melalui reasoning model hanya menghabiskan anggaran untuk akurasi yang sebenarnya tidak dibutuhkan tugas tersebut.
Simpan test-time compute untuk: analisis multi-langkah di mana kesalahan mahal untuk diperbaiki setelah terjadi, tugas dengan ruang solusi yang besar sehingga model mendapat manfaat dari mengeksplorasi berbagai alternatif, dan workflow apa pun di mana seseorang akan bertindak berdasarkan output tanpa memverifikasi ulang secara independen, seperti financial modeling, analisis kontrak, atau debugging teknis. Inilah kasus-kasus di mana trade-off "enam kali lebih mahal, 30 kali lebih lambat" dari Stanford AI Index layak dibayar.
Implikasi penganggarannya bagi pemimpin yang mensponsori pekerjaan AI: biaya per kueri untuk fitur reasoning model bukanlah angka tetap seperti yang sering terjadi pada model standar. Biayanya bervariasi tergantung seberapa sulit setiap kueri individual ternyata, karena model itu sendiri yang menentukan seberapa banyak penalaran yang dibutuhkannya. Itulah sebabnya pemantauan penggunaan dan logika routing, yaitu hanya mengirim kueri yang membutuhkan penalaran mendalam ke model yang mahal, harus menjadi bagian dari rencana pengendalian biaya sejak hari pertama, bukan sekadar renungan setelah tagihan datang. Agen AI yang merangkai beberapa panggilan model secara berurutan memperbesar hal ini lebih jauh lagi, karena sebuah workflow agen multi-langkah dapat memicu penalaran test-time beberapa kali dalam satu tugas.
Fakta Penting
- o1 dari OpenAI mencetak skor 74.4% pada ujian kualifikasi International Mathematical Olympiad, dibandingkan dengan 9.3% milik GPT-4o, tetapi o1 hampir enam kali lebih mahal dan 30 kali lebih lambat dibandingkan GPT-4o, menurut laporan Stanford AI Index 2025.
- Pada ujian matematika AIME 2024, o1 rata-rata mencapai akurasi 74% dengan satu sampel per soal, 83% dengan konsensus dari 64 sampel, dan 93% ketika melakukan re-ranking terhadap 1,000 sampel, dibandingkan dengan 12% untuk GPT-4o pada soal yang sama, menurut catatan rilis resmi o1 dari OpenAI.
- Strategi test-time scaling yang compute-optimal dapat meningkatkan efisiensi lebih dari 4x dibandingkan baseline best-of-N yang naif, dan dalam perbandingan yang disetarakan berdasarkan FLOPs, test-time compute memungkinkan model yang lebih kecil mengungguli model yang 14 kali lebih besar, menurut makalah Berkeley dan DeepMind Scaling LLM Test-Time Compute Optimally.
- Pada benchmark ARC-AGI-Pub, konfigurasi berefisiensi tinggi dari o3 milik OpenAI mencetak skor 75.7% dengan biaya $26 per task, sementara konfigurasi berefisiensi rendah mencetak skor 87.5% dengan biaya $4,560 per task, menggunakan compute sekitar 172 kali lebih banyak untuk kenaikan akurasi 12 poin, menurut hasil resmi ARC Prize.
- o3 dari OpenAI dihargai $2.00 per juta token input dan $8.00 per juta token output, dan token penalaran internal ditagih sebagai token output meskipun tidak pernah muncul dalam respons yang terlihat, menurut Artificial Analysis.
Konsep AI Terkait
- Reasoning Models - Kategori model yang dibangun khusus untuk menggunakan test-time compute
- Inferensi - Fase produksi yang lebih luas, dengan test-time compute sebagai salah satu bentuk biaya variabelnya
- Chain-of-Thought - Teknik penalaran langkah demi langkah yang diskalakan lebih jauh oleh test-time compute
- Large Language Models - Kategori model dasar yang diperluas oleh reasoning model
- Optimisasi Inferensi - Teknik untuk mengendalikan biaya dan latensi pada saat inferensi
- Latensi - Alasan mengapa waktu berpikir tambahan pada test-time compute memengaruhi tingkat adopsi
- Agen AI - Sistem multi-langkah di mana biaya penalaran test-time dapat menumpuk
- Foundation Models - Model dasar tempat kemampuan reasoning model dibangun
Sumber Eksternal
- Stanford AI Index 2025, Technical Performance - Data benchmark independen mengenai akurasi, biaya, dan latensi o1 dibandingkan dengan GPT-4o
- OpenAI: Learning to Reason with LLMs - Catatan rilis resmi dan data benchmark dari OpenAI untuk o1
- Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parameters - Makalah Berkeley/DeepMind yang memformalkan test-time compute sebagai sebuah scaling law
- ARC Prize: o3 ARC-AGI-Pub Results - Data biaya resmi per task di berbagai konfigurasi compute
Pertanyaan yang Sering Diajukan tentang Test-Time Compute
Apa itu test-time compute?
Test-time compute, yang juga disebut inference-time compute, adalah komputasi tambahan yang dihabiskan model untuk bernalar melalui suatu masalah ketika menerima kueri, alih-alih hanya mengandalkan apa yang dipelajari selama pelatihan. Ini mencakup menghasilkan rantai penalaran yang diperluas, melakukan sampling terhadap beberapa kandidat jawaban, dan memeriksa diri sendiri sebelum menjawab.
Apa perbedaan test-time compute dengan training compute?
Training compute dihabiskan sekali, sebelum deployment, untuk menentukan parameter model. Test-time compute dihabiskan setiap kali model menjawab kueri, dan sama sekali tidak mengubah model itu sendiri, melainkan mengubah seberapa besar upaya penalaran yang dicurahkan untuk satu jawaban spesifik itu.
Mengapa o1 dari OpenAI membuat test-time compute menjadi begitu penting?
o1, yang dirilis pada September 2024, menunjukkan bahwa memberi model lebih banyak waktu untuk bernalar pada saat inferensi dapat menghasilkan peningkatan akurasi yang besar pada masalah-masalah sulit, tanpa perubahan apa pun pada ukuran model atau pelatihannya. Menurut laporan Stanford AI Index 2025, o1 mencetak skor 74.4% pada ujian kualifikasi International Mathematical Olympiad dibandingkan 9.3% milik GPT-4o, dengan biaya sekitar enam kali lipat dan latensi 30 kali lipat.
Apakah lebih banyak test-time compute selalu berarti jawaban yang lebih baik?
Test-time compute meningkatkan akurasi pada masalah yang mendapat manfaat dari penalaran multi-langkah, tetapi peningkatannya semakin mengecil seiring bertambahnya compute. Hasil o3 dari OpenAI pada ARC-AGI-Pub menunjukkan kenaikan akurasi 12 poin untuk compute yang sekitar 172 kali lebih banyak antara konfigurasi efisien dan konfigurasi compute tinggi. Pada tugas-tugas sederhana yang sudah jelas batasannya, penalaran tambahan sering kali hanya menambah biaya dan latensi tanpa peningkatan akurasi yang berarti.
Bagaimana test-time compute memengaruhi biaya API?
Reasoning model menagih token "berpikir" internal sebagai token output, meskipun token-token tersebut tidak pernah muncul dalam respons yang terlihat. Ini berarti jawaban yang tampak sama bisa membawa tagihan token yang jauh lebih besar dibandingkan model standar, dan total biayanya bervariasi per kueri karena model itu sendiri yang menentukan seberapa banyak penalaran yang dibutuhkan.
Tugas apa saja yang paling diuntungkan dari test-time compute?
Analisis multi-langkah, tugas dengan ruang solusi yang besar, dan workflow di mana jawaban yang salah mahal untuk diperbaiki di kemudian hari, seperti financial modeling, analisis kontrak, atau debugging teknis, adalah yang paling diuntungkan. Tugas bervolume tinggi dan berisiko rendah seperti respons FAQ atau klasifikasi dasar biasanya tidak membutuhkannya.
Apakah test-time compute sama dengan chain-of-thought prompting?
Keduanya saling berkaitan tetapi tidak identik. Chain-of-thought adalah teknik menghasilkan penalaran langkah demi langkah sebelum memberikan jawaban. Test-time compute adalah kategori yang lebih luas, mencakup chain-of-thought ditambah teknik-teknik lain seperti sampling beberapa kandidat dan self-verification, semuanya diterapkan pada saat inferensi.
Apakah test-time scaling akan menggantikan pelatihan model yang lebih besar?
Tidak, keduanya saling melengkapi, bukan saling menggantikan. Riset seperti makalah Scaling LLM Test-Time Compute Optimally menunjukkan bahwa test-time compute dapat membuat model yang lebih kecil menyamai atau bahkan mengungguli model yang jauh lebih besar pada tugas-tugas tertentu, tetapi lab-lab frontier tetap berinvestasi pada proses pelatihan yang lebih besar maupun penalaran test-time yang lebih baik, karena masing-masing memberikan manfaat yang berbeda.
Bagian dari Koleksi Istilah AI. Terakhir diperbarui: 2026-07-16

Co-Founder, Rework.com
On this page
- Dari Model yang Lebih Besar ke Pemikiran yang Lebih Panjang
- Bagaimana "Berpikir Lebih Lama" Sebenarnya Meningkatkan Kualitas Jawaban
- Hukum Penskalaan Baru
- Test-Time Compute vs. Train-Time Compute
- Trade-off Biaya dan Latensi
- Implikasi Bisnis: Kapan Harga Reasoning Model Masuk Akal
- Fakta Penting
- Konsep AI Terkait
- Sumber Eksternal