Apakah itu Test-Time Compute?
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Dikemas kini Julai 2026
Test-time compute, juga dipanggil inference-time compute, ialah pengiraan tambahan yang digunakan oleh model untuk menaakul sesuatu masalah selepas ia menerima pertanyaan, bukannya bergantung semata-mata pada apa yang telah tertanam semasa latihan. Berbanding menjawab serta-merta, model menjana langkah penaakulan pertengahan, mencuba pelbagai pendekatan, dan menyemak kerjanya sendiri, dengan membelanjakan lebih banyak pengiraan bagi setiap pertanyaan untuk meningkatkan ketepatan pada masalah yang sukar.
Bagi sebahagian besar sejarah large language models, untuk mendapatkan jawapan yang lebih bijak bermakna melatih model yang lebih besar. Test-time compute mematahkan andaian itu. Kini sesebuah model boleh menjadi lebih bijak secara terukur pada soalan tertentu hanya dengan diberikan lebih banyak masa dan pengiraan untuk menyelesaikannya, tanpa mengubah walau satu pun parameter terlatihnya.
Daripada Model Lebih Besar kepada Pemikiran Lebih Lama
Selama bertahun-tahun, kemajuan AI mengikuti corak yang mudah: tambah lebih banyak parameter, lebih banyak data latihan, lebih banyak pengiraan latihan, dan model menjadi lebih baik. Ini dipanggil train-time scaling, dan ia mentakrifkan bidang ini bermula daripada model GPT pertama sehingga pelancaran model terkehadapan pertengahan 2020-an. Setiap peningkatan datang daripada larian latihan yang lebih besar dan lebih mahal, dan model yang terhasil kemudiannya menjawab setiap pertanyaan dalam tempoh masa yang lebih kurang sama, tidak kira sesukar mana soalan tersebut.
o1 daripada OpenAI, yang dilancarkan pada September 2024, mematahkan corak itu. Berbanding menskalakan model, o1 menskalakan berapa lama model dibenarkan untuk "berfikir" sebelum menjawab, menjana satu rantaian penaakulan dalaman yang dilalui oleh model sebelum ia menetapkan jawapan akhir. Keputusan tersebut menjelaskan bahawa masa berfikir adalah tuil tersendiri, berasingan daripada saiz model.
Menurut laporan Stanford AI Index 2025, o1 mencatatkan markah 74.4% dalam peperiksaan kelayakan International Mathematical Olympiad, berbanding 9.3% bagi GPT-4o, pada soalan yang sama. Pertukaran nilai itu turut nyata: laporan tersebut menyatakan bahawa o1 hampir enam kali lebih mahal dan 30 kali lebih perlahan berbanding GPT-4o. Pertukaran nilai itu, iaitu ketepatan yang lebih tinggi dengan kos dan masa yang lebih besar, adalah premis utama test-time compute.
Bagaimana "Berfikir Lebih Lama" Sebenarnya Menambah Baik Jawapan
Sesebuah large language model standard menjana responsnya token demi token, dalam satu laluan hadapan sahaja, tanpa mekanisme untuk berhenti, mempertimbangkan semula, atau menyemak logiknya sendiri sebelum jawapan itu selesai. Itulah sebabnya ia boleh menyatakan jawapan yang salah dengan keyakinan lancar yang sama seperti jawapan yang betul.
Reasoning models yang dibina untuk test-time compute menambah tiga perkara yang tidak dilakukan secara lalai oleh model standard:
Jejak penaakulan lanjutan. Model menjana satu urutan dalaman yang panjang bagi langkah pertengahan, menyelesaikan sub-masalah, menyemak kekangan, dan menghuraikan logiknya sendiri sebelum menghasilkan jawapan akhir. Inilah mekanisme di sebalik penaakulan chain-of-thought, yang diskalakan dan sering dijalankan di luar apa yang dilihat oleh pengguna.
Persampelan dan pemilihan. Berbanding menjana satu jawapan sahaja, model boleh menjana beberapa penyelesaian calon dan memilih yang terbaik, sama ada melalui undian majoriti (jawapan yang dipersetujui oleh kebanyakan calon) atau fungsi pemarkahan terlatih yang menyusun calon mengikut kebarangkalian ketepatan.
Pengesahan kendiri. Model menyemak penaakulannya sendiri berdasarkan kekangan masalah dan boleh berundur untuk mencuba pendekatan lain apabila sesuatu langkah tidak kukuh, lebih hampir kepada cara seseorang menyemak semula kerjanya sebelum menghantarnya.
Keputusan OpenAI sendiri pada peperiksaan matematik AIME 2024 menunjukkan nilai setiap tuil ini secara berasingan. Menurut nota pelancaran o1 daripada OpenAI, model tersebut mencatatkan purata ketepatan 74% dengan satu sampel bagi setiap masalah, meningkat kepada 83% apabila menggunakan konsensus merentasi 64 sampel, dan mencecah 93% apabila menyusun semula 1,000 sampel dengan fungsi pemarkahan terlatih, kesemuanya menggunakan model asas yang sama persis. GPT-4o, tanpa penaakulan test-time, hanya berjaya menyelesaikan 12% daripada masalah yang sama. Tiada apa-apa pada parameter model yang berubah antara ketiga-tiga markah tersebut. Hanya jumlah test-time compute yang berubah.
Undang-Undang Penskalaan Baharu
Sebelum 2024, "scaling law" hanya membawa satu maksud dalam bidang AI: prestasi sebagai fungsi pengiraan latihan, parameter model, dan data latihan. Test-time compute menambah satu paksi kedua. Satu kertas kerja 2024 daripada penyelidik di UC Berkeley dan Google DeepMind, Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parameters, merasmikan perkara ini: memperuntukkan test-time compute secara "compute-optimal", iaitu memadankan usaha penaakulan dengan tahap kesukaran prompt tertentu berbanding membelanjakan jumlah yang sama rata bagi setiap pertanyaan, meningkatkan kecekapan lebih daripada 4x berbanding garis dasar persampelan best-of-N yang naif. Dalam perbandingan yang dipadankan mengikut FLOPs, kertas kerja tersebut mendapati test-time compute membolehkan model yang lebih kecil mengatasi prestasi model yang 14 kali lebih besar.
Penemuan ini mengubah semula persoalan bina-berbanding-beli bagi makmal terkehadapan dan, seterusnya, bagi perniagaan yang membeli model mereka. Sebuah makmal yang berhadapan dengan bajet pengiraan tetap kini mempunyai dua tempat untuk membelanjakannya: larian latihan yang lebih besar dan lebih mahal yang menambah baik setiap respons masa depan dengan margin kecil, atau sistem penaakulan yang membolehkan model sedia ada membelanjakan lebih banyak pengiraan pada pertanyaan tertentu yang memerlukannya.
Pertukaran nilai ini tidak hilang pada skala yang lebih besar, ia hanya menjadi lebih ketara. Model o3 daripada OpenAI, yang dinilai pada penanda aras ARC-AGI-Pub, menunjukkan lengkung ini secara langsung: konfigurasi kecekapan tinggi mencatatkan markah 75.7% pada penilaian separa persendirian dengan kos pengiraan $26 setiap tugas, manakala konfigurasi kecekapan rendah, yang menggunakan kira-kira 172 kali lebih banyak pengiraan, mencatatkan markah 87.5% pada $4,560 setiap tugas. Dua belas mata ketepatan tambahan menelan kos lebih 170 kali ganda pengiraan. Itulah bentuk penskalaan test-time dalam amalan sebenar: peningkatan yang nyata, dengan harga yang meningkat curam bagi setiap mata tambahan.
Test-Time Compute vs. Train-Time Compute
| Dimensi | Train-Time Compute | Test-Time Compute |
|---|---|---|
| Bila ia berlaku | Sekali sahaja, semasa pembangunan model, sebelum penggunaan | Setiap kali model menjawab pertanyaan, dalam pengeluaran |
| Apa yang berubah | Parameter model (weights) | Tiada apa-apa pada model, hanya jumlah usaha penaakulan yang dibelanjakan bagi satu pertanyaan |
| Bentuk kos | Besar, dibelanjakan di hadapan, seperti perbelanjaan projek | Setiap pertanyaan, berasaskan penggunaan, berskala mengikut volum dan tahap "kesukaran" sesuatu soalan dilayan |
| Apa yang diperoleh | Model yang secara umumnya lebih berkeupayaan, bagi setiap pertanyaan masa depan | Jawapan yang lebih baik bagi pertanyaan tertentu ini, dengan kependaman dan kos yang lebih tinggi bagi pertanyaan itu sahaja |
| Tuil utama | Lebih banyak parameter, lebih banyak data latihan, larian latihan yang lebih lama | Rantaian penaakulan yang lebih panjang, lebih banyak calon disampel, pusingan pengesahan kendiri |
| Mod kegagalan jika terlebih belanja | Model yang mahal tetapi masih sederhana jika resipinya salah | Jawapan yang perlahan dan mahal bagi soalan yang sebenarnya tidak memerlukan penaakulan mendalam |
Kedua-dua paksi ini masih merupakan scaling law dari segi teknikal: prestasi bertambah baik sebagai fungsi yang lebih kurang boleh diramal daripada pengiraan yang dibelanjakan. Perbezaannya ialah bila anda membayar dan apa yang anda perolehi daripadanya. Train-time compute ialah pelaburan sekali sahaja dalam model itu sendiri. Test-time compute pula ialah keputusan bagi setiap pertanyaan yang perlu dibuat oleh sesebuah perniagaan, atau aplikasi yang memanggil model tersebut, setiap kali tanpa gagal.
Pertukaran Nilai Kos dan Kependaman
Test-time compute bukanlah percuma, dan kesannya timbul pada dua tempat serentak: wang dan masa.
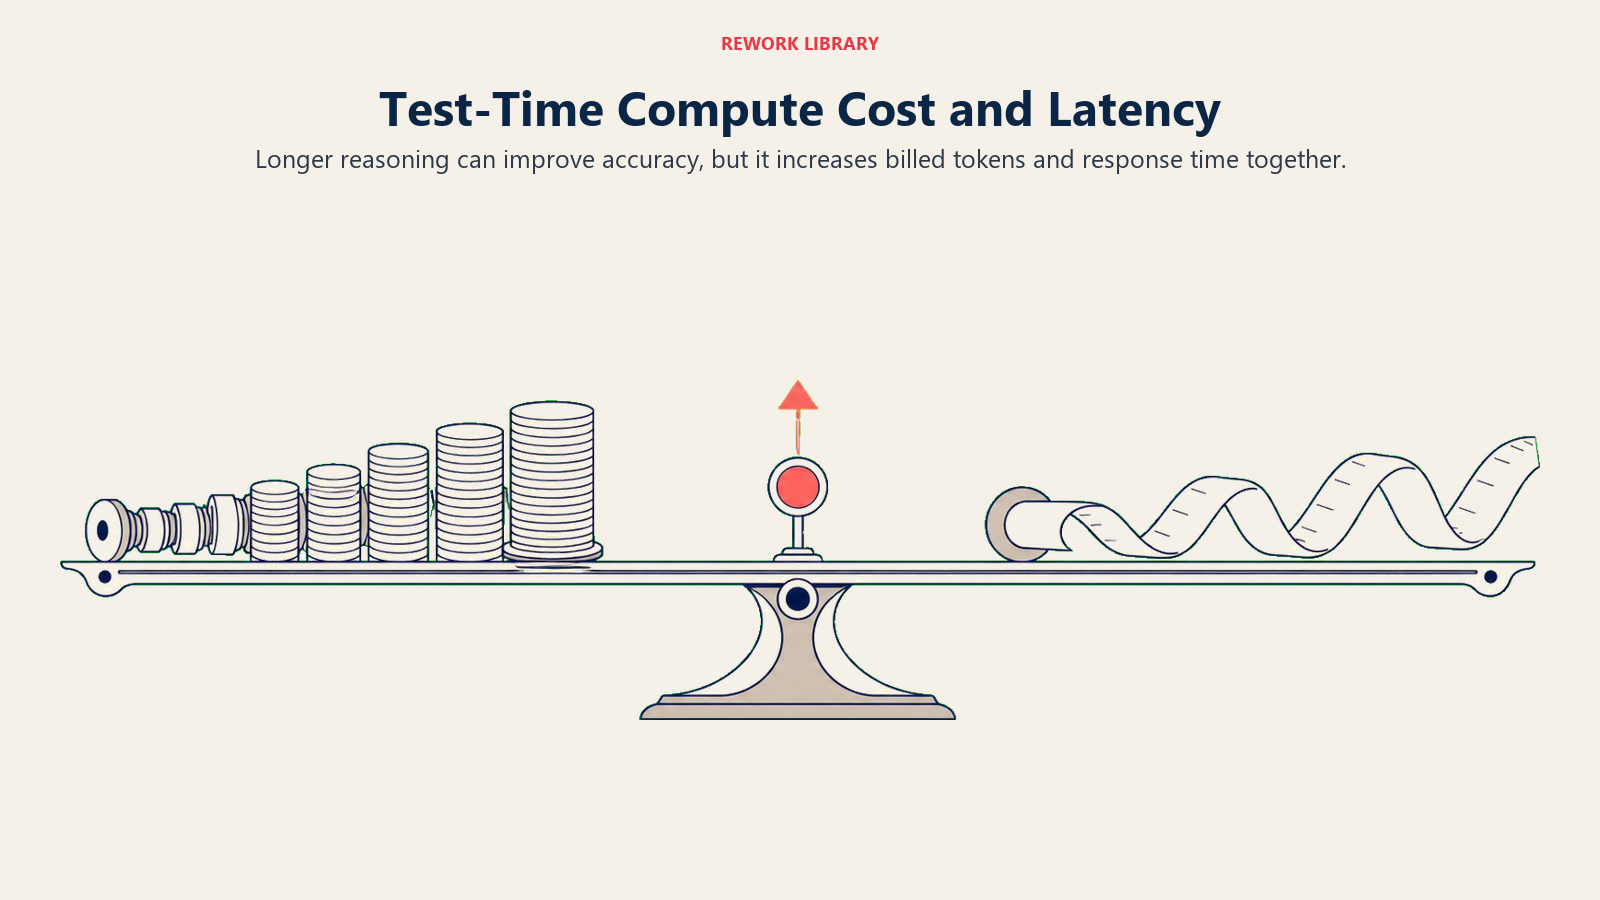
Kependaman. Model standard bertindak balas dalam pecahan saat hingga beberapa saat sahaja. Model penaakulan yang melalui rantaian pemikiran lanjutan boleh mengambil masa antara beberapa saat hingga beberapa minit, bergantung pada berapa banyak penaakulan dalaman yang dijananya sebelum menghasilkan jawapan yang kelihatan. Bagi kes penggunaan interaktif, perbezaan itu menentukan segalanya: seorang ejen sokongan yang menunggu 20 saat berbanding 2 saat untuk mendapatkan jawapan akan mencari jalan lain, atau berhenti menggunakan alat tersebut. Lihat latency untuk memahami bagaimana masa tindak balas menentukan sama ada sesuatu ciri benar-benar diguna pakai.
Kos. Token penaakulan juga tidak percuma, dan kebanyakannya tidak kelihatan. Menurut Artificial Analysis, o3 daripada OpenAI dikenakan harga $2.00 bagi setiap sejuta token input dan $8.00 bagi setiap sejuta token output, dan token penaakulan dalaman, iaitu token yang dijana semasa proses "pemikiran" model, dicaj sebagai token output walaupun pengguna tidak pernah melihatnya dalam respons. Satu jawapan yang kelihatan ringkas boleh berada di atas jejak penaakulan yang jauh lebih besar dan turut dicaj. Ini merupakan profil kos yang berbeza secara struktur berbanding model standard, di mana bilangan token yang anda lihat hampir sama dengan bilangan token yang anda bayar.
Kesan praktikalnya ialah test-time compute mengubah persoalan "sejauh mana model perlu berfikir tentang ini" menjadi satu keputusan kawalan kos, bukan sekadar keputusan kualiti. Teknik inference optimization, seperti mengehadkan panjang penaakulan, menghalakan pertanyaan mudah kepada model yang lebih pantas dan hanya meningkatkan pertanyaan sukar kepada model penaakulan, serta menyimpan cache bagi pertanyaan berulang, semuanya menjadi lebih bernilai apabila sebahagian besar pertanyaan membawa bil token penaakulan yang berubah-ubah dan kadangkala besar.
Implikasi Perniagaan: Bila Harga Model Penaakulan Berbaloi
Tidak semua ciri AI memerlukan test-time compute, dan melayan setiap pertanyaan seolah-olah ia memerlukannya adalah cara paling pantas untuk menukar projek rintis yang berpotensi menjadi projek yang mahal. Keputusan ini bergantung pada satu soalan yang agak mudah: sejauh mana mahalnya kesan jawapan yang salah, berbanding sejauh mana mahalnya jawapan yang perlahan atau mahal?
Gunakan model standard yang pantas apabila: tugas tersebut bervolum tinggi, jawapannya sama ada jelas betul atau mudah disemak, dan kelajuan penting bagi orang yang menunggunya. Respons FAQ pelanggan, klasifikasi asas, penjanaan kandungan draf pertama, dan pengekstrakan data rutin semuanya sesuai dengan corak ini. Menjalankan kesemua tugas ini melalui model penaakulan hanya membazirkan bajet untuk ketepatan yang sebenarnya tidak diperlukan oleh tugas tersebut.
Simpan test-time compute untuk: analisis pelbagai langkah di mana kesilapan mahal untuk dikesan selepas berlaku, tugas dengan ruang penyelesaian yang luas di mana model mendapat manfaat daripada meneroka alternatif, dan mana-mana aliran kerja di mana seseorang akan bertindak berdasarkan output tanpa menyemak semula secara berasingan, seperti pemodelan kewangan, analisis kontrak, atau nyahpepijat teknikal. Inilah kes-kes di mana pertukaran nilai "enam kali lebih mahal, 30 kali lebih perlahan" daripada Stanford AI Index berbaloi untuk dibayar.
Implikasi pembajetan bagi pemimpin yang menaja kerja AI ialah: kos bagi setiap pertanyaan untuk ciri model penaakulan bukanlah nombor tetap seperti yang selalunya berlaku dengan model standard. Ia berubah-ubah bergantung pada tahap kesukaran setiap pertanyaan, kerana model itu sendiri yang menentukan berapa banyak penaakulan yang diperlukannya. Ini menjadikan pemantauan penggunaan dan logik penghalaan, iaitu menghantar hanya pertanyaan yang memerlukan penaakulan mendalam kepada model yang mahal, sebahagian daripada pelan kawalan kos sejak hari pertama, bukan sesuatu yang difikirkan kemudian apabila bil tiba. AI agents yang merantai beberapa panggilan model bersama-sama memperbesarkan lagi kesan ini, kerana satu aliran kerja agen pelbagai langkah boleh mencetuskan penaakulan test-time beberapa kali dalam satu tugas.
Fakta Utama
- o1 daripada OpenAI mencatatkan markah 74.4% dalam peperiksaan kelayakan International Mathematical Olympiad, berbanding 9.3% bagi GPT-4o, tetapi o1 hampir enam kali lebih mahal dan 30 kali lebih perlahan berbanding GPT-4o, menurut laporan Stanford AI Index 2025.
- Pada peperiksaan matematik AIME 2024, o1 mencatatkan purata ketepatan 74% dengan satu sampel bagi setiap masalah, 83% dengan konsensus merentasi 64 sampel, dan 93% apabila menyusun semula 1,000 sampel, berbanding 12% bagi GPT-4o pada masalah yang sama, menurut nota pelancaran rasmi o1 daripada OpenAI.
- Strategi penskalaan test-time yang compute-optimal boleh meningkatkan kecekapan lebih daripada 4x berbanding garis dasar best-of-N yang naif, dan dalam perbandingan yang dipadankan mengikut FLOPs, test-time compute membolehkan model yang lebih kecil mengatasi prestasi model yang 14 kali lebih besar, menurut kertas kerja Berkeley dan DeepMind Scaling LLM Test-Time Compute Optimally.
- Pada penanda aras ARC-AGI-Pub, konfigurasi kecekapan tinggi bagi o3 daripada OpenAI mencatatkan markah 75.7% pada $26 setiap tugas, manakala konfigurasi kecekapan rendah mencatatkan markah 87.5% pada $4,560 setiap tugas, menggunakan kira-kira 172 kali lebih banyak pengiraan bagi peningkatan ketepatan 12 mata, menurut keputusan rasmi ARC Prize.
- o3 daripada OpenAI dikenakan harga $2.00 bagi setiap sejuta token input dan $8.00 bagi setiap sejuta token output, dan token penaakulan dalaman dicaj sebagai token output walaupun ia tidak pernah muncul dalam respons yang kelihatan, menurut Artificial Analysis.
Konsep AI Berkaitan
- Reasoning Models - Kategori model yang dibina khusus untuk menggunakan test-time compute
- Inference - Fasa pengeluaran yang lebih luas di mana test-time compute merupakan satu bentuk kos berubah-ubah
- Chain-of-Thought - Teknik penaakulan langkah demi langkah yang diskalakan oleh test-time compute
- Large Language Models - Kategori model asas yang dilanjutkan oleh reasoning models
- Inference Optimization - Teknik untuk mengawal kos dan kependaman semasa inferens
- Latency - Sebab masa berfikir tambahan dalam test-time compute memberi kesan kepada penerimaan pakai
- AI Agents - Sistem pelbagai langkah di mana kos penaakulan test-time boleh bertambah berganda
- Foundation Models - Model asas yang menjadi tapak pembinaan keupayaan penaakulan
Sumber Luaran
- Stanford AI Index 2025, Technical Performance - Data penanda aras bebas mengenai ketepatan, kos, dan kependaman o1 berbanding GPT-4o
- OpenAI: Learning to Reason with LLMs - Nota pelancaran dan data penanda aras rasmi OpenAI bagi o1
- Scaling LLM Test-Time Compute Optimally Can Be More Effective Than Scaling Model Parameters - Kertas kerja Berkeley/DeepMind yang merasmikan test-time compute sebagai satu scaling law
- ARC Prize: o3 ARC-AGI-Pub Results - Data kos-setiap-tugas rasmi merentasi pelbagai konfigurasi pengiraan
Soalan Lazim tentang Test-Time Compute
Apakah itu test-time compute?
Test-time compute, juga dipanggil inference-time compute, ialah pengiraan tambahan yang digunakan oleh model untuk menaakul sesuatu masalah apabila ia menerima pertanyaan, berbanding hanya bergantung pada apa yang dipelajari semasa latihan. Ia termasuk menjana rantaian penaakulan lanjutan, mempersampel pelbagai jawapan calon, dan menyemak kendiri sebelum menjawab.
Bagaimanakah test-time compute berbeza daripada pengiraan latihan?
Pengiraan latihan dibelanjakan sekali sahaja, sebelum penggunaan, untuk menetapkan parameter model. Test-time compute pula dibelanjakan setiap kali model menjawab pertanyaan, dan ia langsung tidak mengubah model itu sendiri, sebaliknya ia mengubah berapa banyak usaha penaakulan yang diberikan kepada jawapan tertentu itu.
Mengapakah o1 daripada OpenAI menjadikan test-time compute begitu penting?
o1, yang dilancarkan pada September 2024, menunjukkan bahawa memberikan model lebih banyak masa untuk menaakul semasa inferens boleh menghasilkan peningkatan ketepatan yang besar pada masalah yang sukar tanpa sebarang perubahan pada saiz model atau latihan. Menurut laporan Stanford AI Index 2025, ia mencatatkan markah 74.4% dalam peperiksaan kelayakan International Mathematical Olympiad berbanding 9.3% bagi GPT-4o, dengan kos kira-kira enam kali ganda dan kependaman 30 kali ganda.
Adakah lebih banyak test-time compute sentiasa bermakna jawapan yang lebih baik?
Ia meningkatkan ketepatan pada masalah yang mendapat manfaat daripada penaakulan pelbagai langkah, tetapi peningkatannya semakin mengecil apabila pengiraan bertambah. Keputusan o3 daripada OpenAI pada ARC-AGI-Pub menunjukkan peningkatan ketepatan 12 mata bagi kira-kira 172 kali lebih banyak pengiraan antara konfigurasi cekap dan konfigurasi pengiraan tinggi. Pada tugas yang mudah dan jelas, penaakulan tambahan selalunya hanya menambah kos dan kependaman tanpa peningkatan ketepatan yang bermakna.
Bagaimanakah test-time compute memberi kesan kepada kos API?
Reasoning models mencaj token "pemikiran" dalaman sebagai token output, walaupun token tersebut tidak pernah muncul dalam respons yang kelihatan. Ini bermakna jawapan yang kelihatan sama boleh membawa bil token yang jauh lebih besar berbanding daripada model standard, dan jumlah kos berbeza-beza mengikut pertanyaan kerana model itu sendiri yang menentukan berapa banyak penaakulan yang diperlukan.
Tugas manakah yang paling mendapat manfaat daripada test-time compute?
Analisis pelbagai langkah, tugas dengan ruang penyelesaian yang luas, dan aliran kerja di mana jawapan yang salah mahal untuk dikesan kemudian, seperti pemodelan kewangan, analisis kontrak, atau nyahpepijat teknikal, mendapat manfaat paling besar. Tugas bervolum tinggi dan bertaruhan rendah seperti respons FAQ atau klasifikasi asas biasanya tidak memerlukannya.
Adakah test-time compute sama dengan chain-of-thought prompting?
Kedua-duanya berkaitan tetapi tidak sama. Chain-of-thought ialah teknik menjana penaakulan langkah demi langkah sebelum jawapan. Test-time compute pula ialah kategori yang lebih luas yang merangkumi chain-of-thought serta teknik lain seperti mempersampel pelbagai calon dan pengesahan kendiri, kesemuanya diterapkan semasa inferens.
Adakah penskalaan test-time akan menggantikan latihan model yang lebih besar?
Tidak, kedua-duanya saling melengkapi, bukan menggantikan antara satu sama lain. Penyelidikan seperti kertas kerja Scaling LLM Test-Time Compute Optimally menunjukkan test-time compute boleh membolehkan model yang lebih kecil menyamai atau mengatasi model yang jauh lebih besar pada tugas tertentu, tetapi makmal terkehadapan terus melabur dalam kedua-dua larian latihan yang lebih besar dan penaakulan test-time yang lebih baik, kerana setiap satu memberikan manfaat yang berbeza.
Sebahagian daripada Koleksi Istilah AI. Terakhir dikemas kini: 2026-07-16

Co-Founder, Rework.com
On this page
- Daripada Model Lebih Besar kepada Pemikiran Lebih Lama
- Bagaimana "Berfikir Lebih Lama" Sebenarnya Menambah Baik Jawapan
- Undang-Undang Penskalaan Baharu
- Test-Time Compute vs. Train-Time Compute
- Pertukaran Nilai Kos dan Kependaman
- Implikasi Perniagaan: Bila Harga Model Penaakulan Berbaloi
- Fakta Utama
- Konsep AI Berkaitan
- Sumber Luaran