Qu'est-ce que l'observabilité de l'IA ? Espérer que l'IA fonctionne ou savoir qu'elle fonctionne
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Une entreprise du Fortune 500 a déployé un moteur de tarification piloté par l'IA. Il fonctionnait bien en test. Trois semaines après la mise en production, il s'est mis à renvoyer des prix subtilement faux pour une catégorie de produits précise, lors des traitements par lots de nuit. Aucune alerte ne s'est déclenchée. Aucune erreur n'est apparue dans les logs. L'équipe l'a découvert six semaines plus tard, quand un commercial a remarqué des remises inhabituelles.
Le problème ne venait pas du modèle. Personne ne pouvait voir ce que le modèle faisait.
L'observabilité de l'IA (« AI observability ») consiste à construire les systèmes d'IA de production de façon à pouvoir comprendre leur état interne à partir de leurs sorties externes. C'est la même discipline que le site reliability engineering a apportée à l'infrastructure logicielle.
En quoi l'observabilité de l'IA diffère du model monitoring
Ces deux termes sont souvent employés l'un pour l'autre, mais ils ne recouvrent pas la même chose.
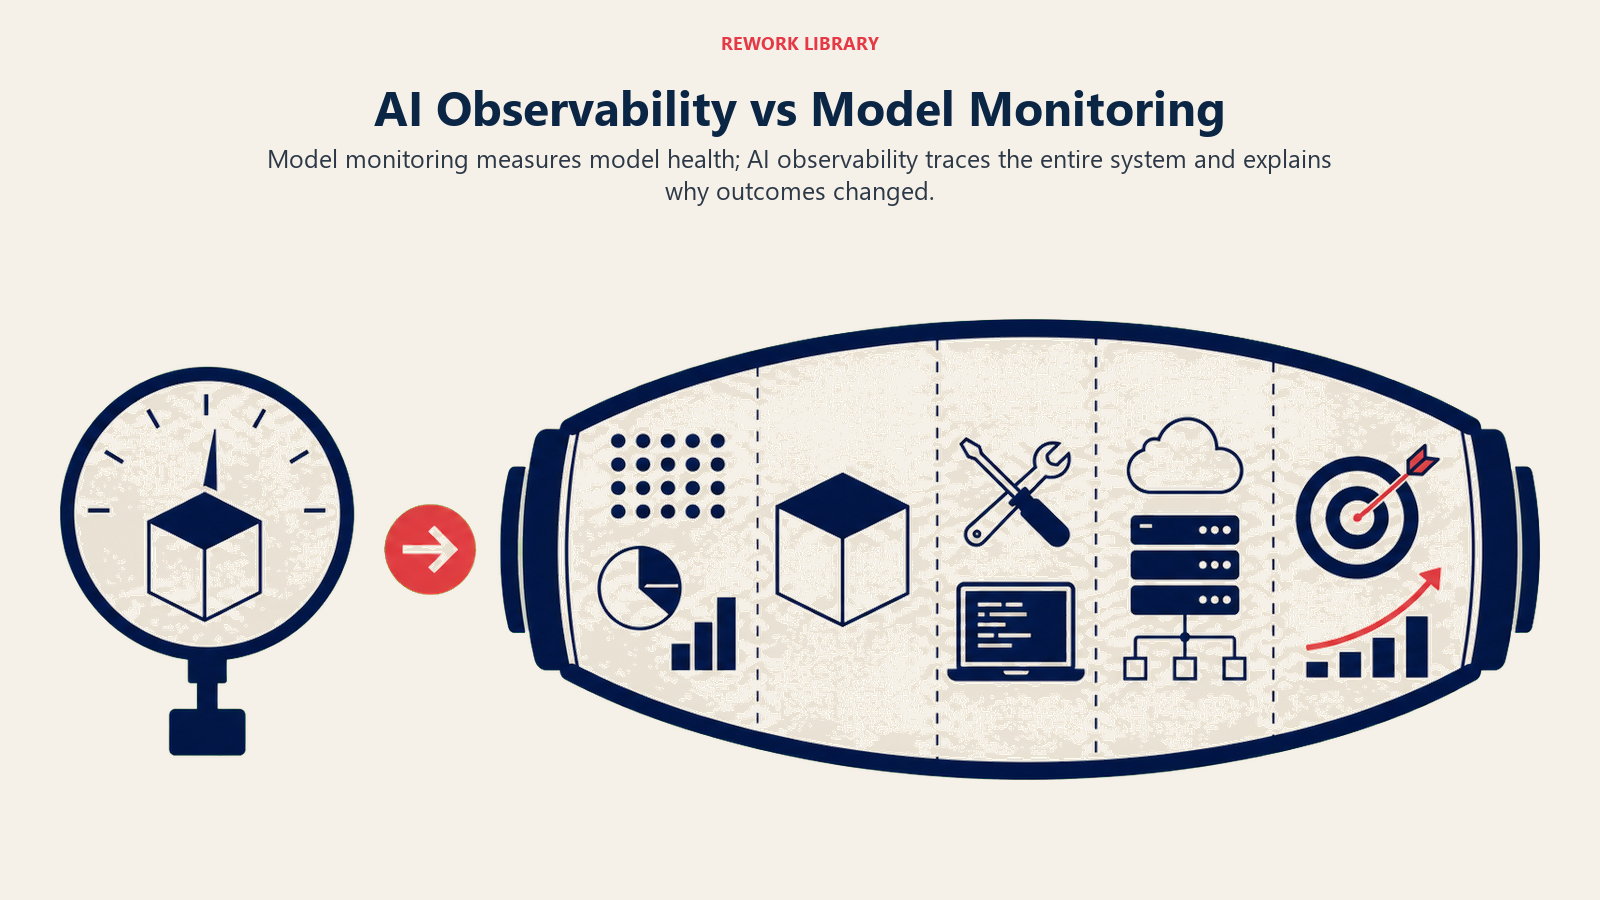
Le model monitoring suit des métriques au niveau du modèle : précision, dérive des prédictions, évolution de la distribution des données et qualité des sorties dans le temps. Il répond à la question : « Ce modèle donne-t-il toujours les performances attendues ? »
L'observabilité de l'IA est plus large. Elle couvre toute la pile du système d'IA : le modèle lui-même, les pipelines de données qui l'alimentent, l'infrastructure qui l'exécute, les appels d'API entrants et sortants, la latence à chaque couche et les résultats métier en aval. Elle répond à la question : « Que fait réellement mon système d'IA, et puis-je remonter n'importe quel problème jusqu'à sa cause première ? »
Le monitoring revient à mesurer la tension d'un patient. L'observabilité, c'est disposer du dossier médical complet, avec l'historique, le contexte, les notes de diagnostic et la trace de chaque décision de traitement.
Pour les dirigeants : le model monitoring vous dit qu'une métrique est mauvaise ; l'observabilité vous dit pourquoi.
Les trois piliers
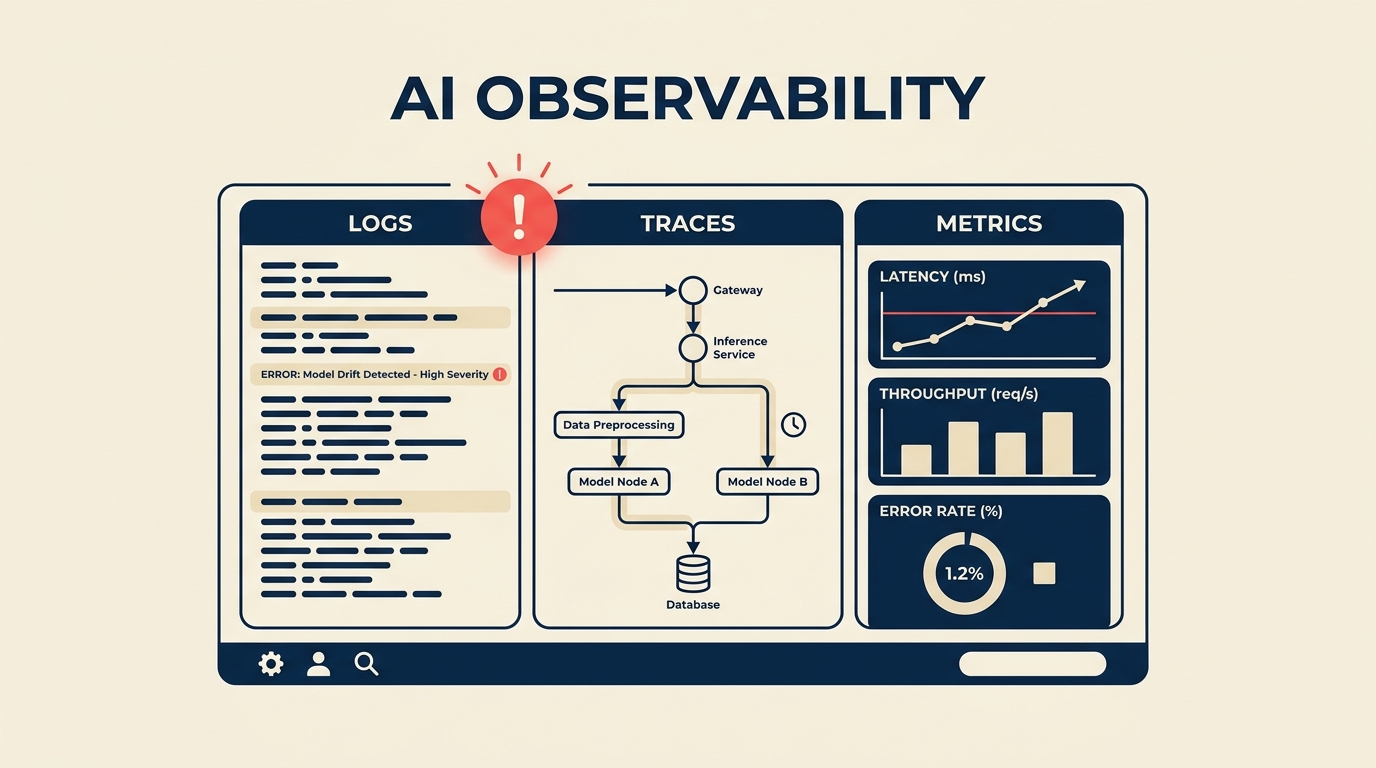
En ingénierie logicielle, l'observabilité repose sur trois signaux. Les systèmes d'IA utilisent les trois, avec des ajouts propres à l'IA pour chacun :
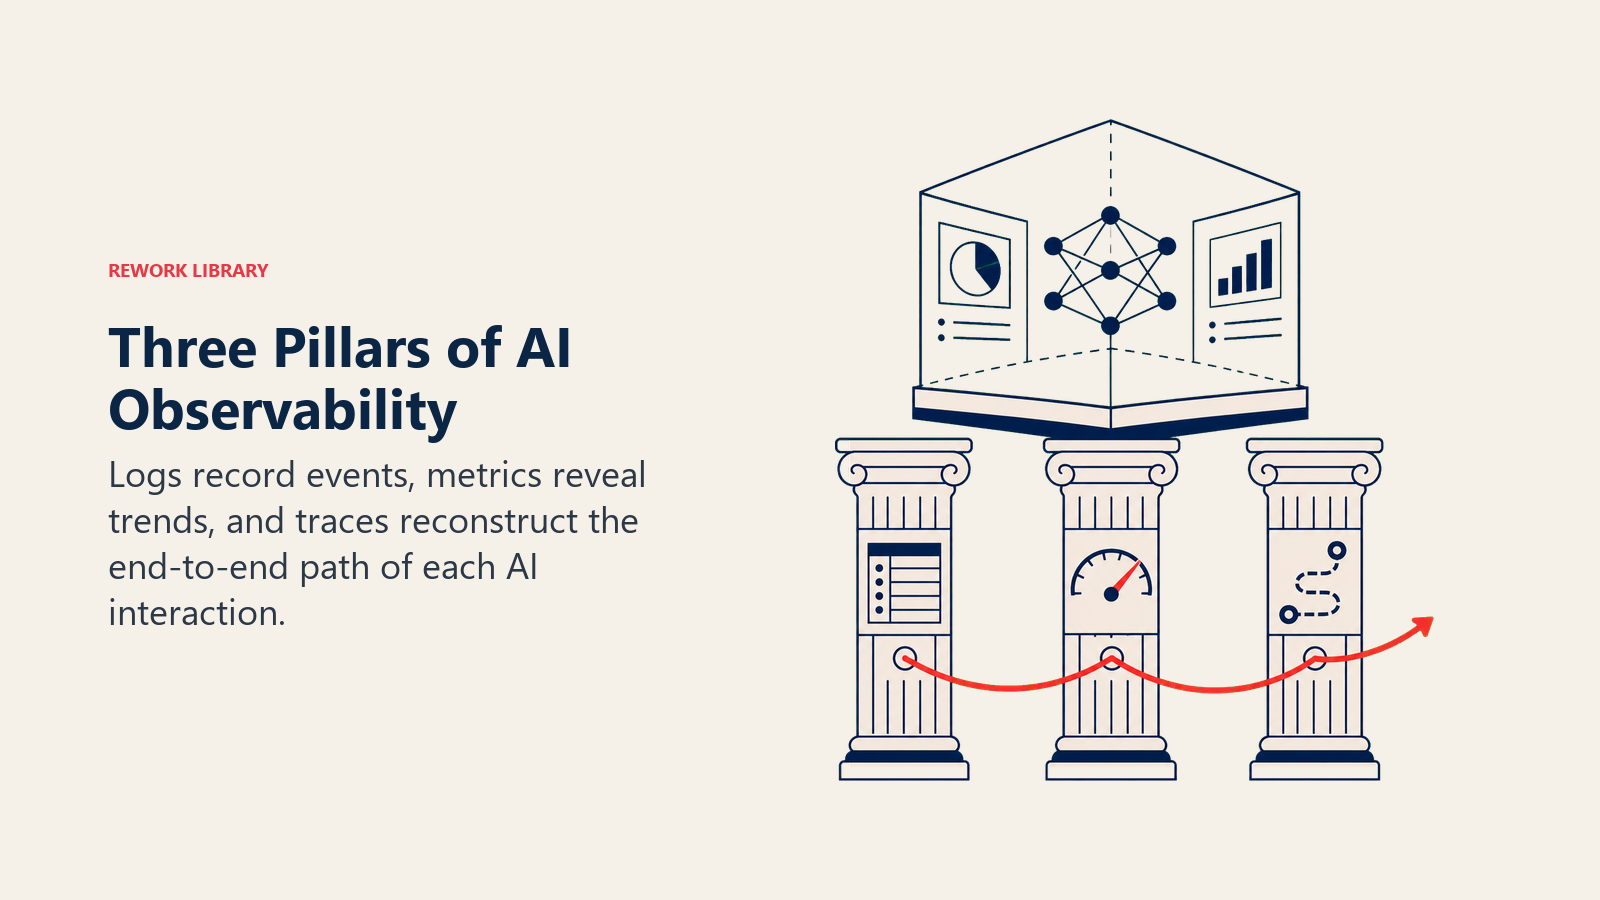
Les logs consignent des événements ponctuels : un prompt reçu, une réponse générée, un appel d'outil effectué, une requête de récupération exécutée. Dans les systèmes d'IA, les logs doivent capturer non seulement les erreurs mais aussi les interactions réussies, avec assez de contexte pour reconstituer ce qui s'est passé. Une ligne de log qui indique « le modèle a répondu en 240 ms » est bien moins utile qu'une ligne qui inclut le prompt, la version du modèle, le nombre de tokens et les extraits de contexte récupérés.
Les métriques sont des mesures numériques dans le temps : taux de requêtes, taux d'erreur, percentiles de latence, consommation de tokens, coût par requête, et mesures propres au modèle comme la distribution de la longueur des sorties ou le taux de refus. De bonnes métriques d'IA relient le comportement technique aux résultats métier : le coût par requête se rattache ainsi au coût par interaction client réussie.
Les traces montrent le parcours complet d'une requête unique à travers un système. Pour les workflows agentiques et les pipelines de RAG, une seule interaction d'utilisateur peut impliquer cinq appels de récupération, trois appels de LLM, deux exécutions d'outils et une écriture en base de données. Une trace suit toute cette chaîne, avec les temps à chaque étape, pour repérer l'origine d'une latence ou d'une erreur.
Les systèmes d'IA ajoutent un quatrième signal que le logiciel traditionnel ne connaît pas :
Les évaluations sont des appréciations systématiques de la qualité des sorties de l'IA. Comme ces sorties sont probabilistes et souvent subjectives, on ne peut pas se contenter de vérifier des codes d'erreur. Les évaluations font passer des échantillons de sorties de production par des scoreurs de qualité, des évaluateurs humains ou des LLM de référence, afin de mesurer des dimensions comme l'exactitude factuelle, le ton, la pertinence ou l'accomplissement de la tâche. C'est ce qui permet de repérer le cas où « le modèle fonctionne techniquement mais produit de moins bonnes sorties que le mois dernier ».
À quoi ressemble une bonne observabilité de l'IA en pratique
Un système d'IA bien observé permet à un ingénieur de répondre à ces questions en quelques minutes, et non en quelques jours :
« Nous avons constaté un pic de plaintes d'utilisateurs hier à 15 h. Qu'est-ce qui a changé ? » Grâce à l'observabilité, vous pouvez rapprocher le pic de plaintes d'un déploiement, d'un changement dans la qualité de la récupération, d'un glissement des requêtes des utilisateurs ou d'un problème de qualité des données en amont.
« Pourquoi cette interaction client précise a-t-elle mal tourné ? » Grâce aux traces, vous pouvez rejouer la séquence exacte des appels, voir quel contexte le modèle a reçu et déterminer si l'échec venait de la récupération, du raisonnement du modèle ou d'un appel d'outil en aval.
« Notre IA devient-elle plus chère sans devenir meilleure ? » En suivant ensemble les métriques de coût et de qualité, vous repérez le moment où l'usage de tokens grimpe alors que les scores de qualité des sorties restent plats, ce qui signale souvent un prompt trop long ou une récupération inefficace.
« Notre modèle compressé donne-t-il les mêmes performances que le modèle complet ? » L'observabilité permet de mener en production des comparaisons A/B entre versions de modèle, avec une vraie rigueur statistique, plutôt que de s'en remettre à des benchmarks hors ligne.
L'argumentaire économique de l'investissement
L'infrastructure d'observabilité de l'IA coûte de l'argent. Les équipes rechignent à la bâtir quand mettre des fonctionnalités en production paraît plus urgent. L'argumentaire repose sur trois réalités :
D'abord, les défaillances de l'IA sont souvent silencieuses. Contrairement à un serveur planté qui renvoie des erreurs 500, un modèle mal calibré continue de fonctionner tout en produisant des sorties subtilement fausses. Sans observabilité, vous apprenez les problèmes de qualité de l'IA par les plaintes de clients ou par les indicateurs métier en aval, des semaines après le début de la dégradation.
Ensuite, déboguer sans observabilité est d'une lenteur rédhibitoire. Quand un système d'IA non observé se comporte mal, l'enquête peut prendre des semaines. Reproduire les conditions exactes, retrouver le composant défaillant et identifier la cause première sans instrumentation oblige souvent à reconstruire le contexte à partir de zéro.
Enfin, les coûts de l'IA sont variables et peuvent s'envoler sans prévenir. Une modification de prompt qui augmente de 30 % le nombre moyen de tokens peut passer inaperçue dans les tests unitaires, et pourtant doubler votre facture mensuelle d'inférence. L'observabilité des coûts détecte ces changements en quelques heures, et non au bout d'un cycle de facturation.
Les plateformes de MLOps intègrent de plus en plus d'outils d'observabilité, ce qui évite aux équipes de tout construire. Des outils spécialisés comme LangSmith, Arize AI et Weights and Biases proposent une observabilité conçue spécifiquement pour les charges de travail de LLM et de ML. Notre comparatif de 12 plateformes d'observabilité pour LLM chiffre leurs tarifs pour un million de traces par mois.
Démarrer sans tout reconstruire
Les organisations qui partent de zéro n'ont pas besoin d'une pile d'observabilité complète dès le premier jour. Voici une progression réaliste :
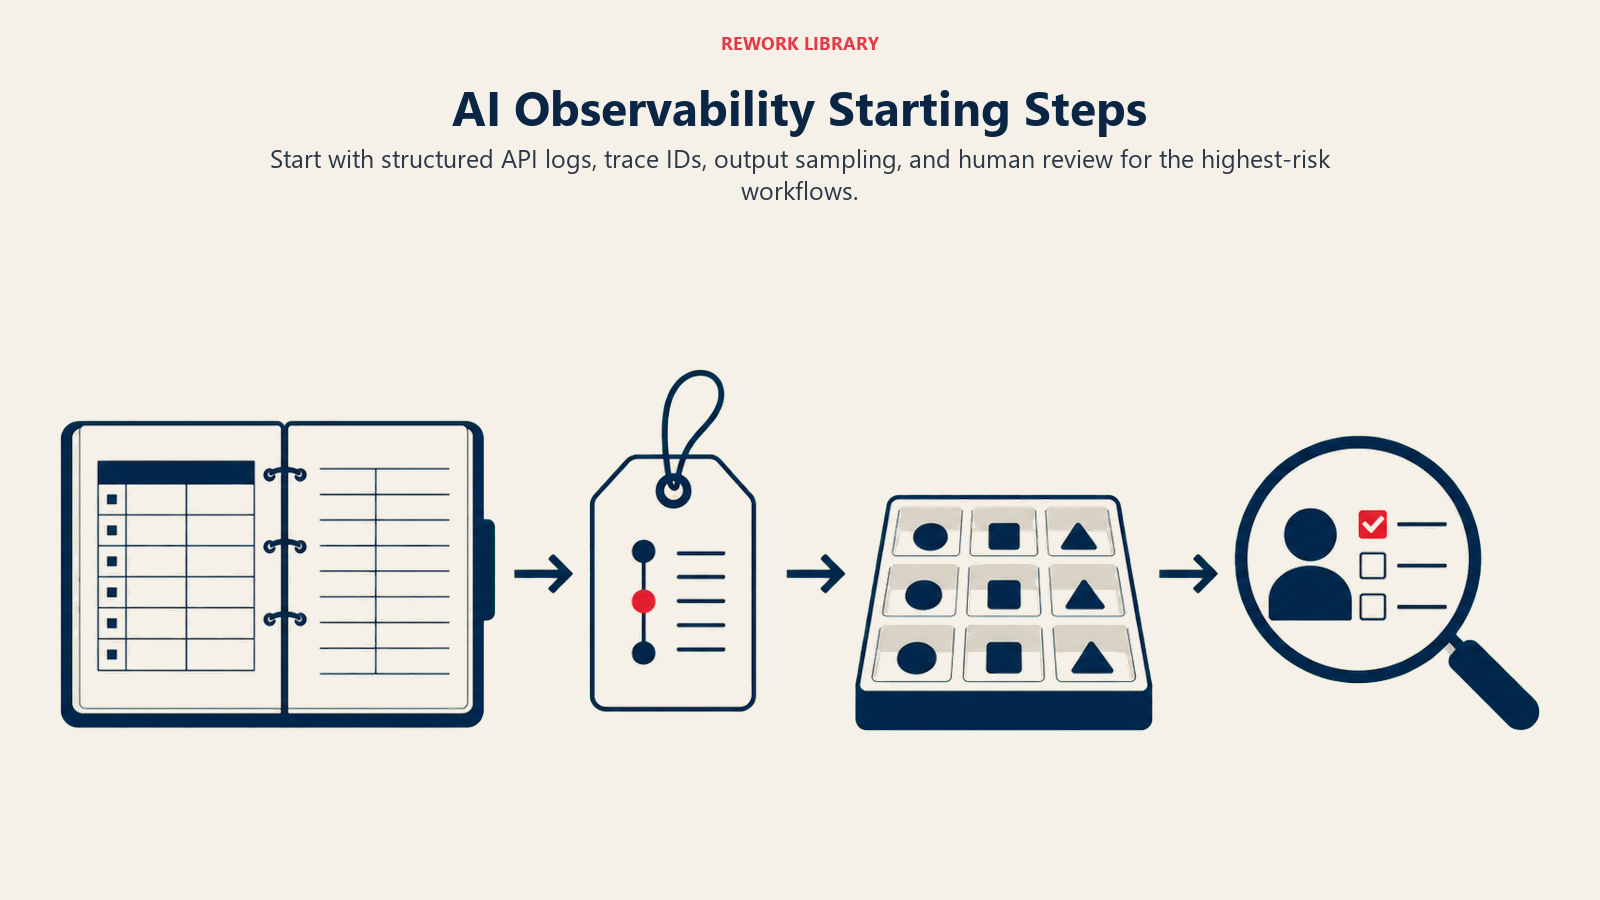
Commencez par une journalisation structurée de chaque appel d'API d'IA : horodatage, version du modèle, nombre de tokens en entrée, nombre de tokens en sortie, latence et identifiant de trace unique. Cela suffit déjà pour le débogage rétroactif et le suivi des coûts.
Ajoutez ensuite l'échantillonnage des sorties et l'évaluation humaine pour vos workflows d'IA à plus forte valeur ou à plus haut risque. Même relire à la main 50 interactions par semaine fait ressortir les tendances de qualité avant qu'elles ne deviennent des crises.
Ajoutez le tracing distribué dès que vous avez des workflows d'IA en plusieurs étapes dont il faut comprendre le chemin complet des requêtes.
Intégrez enfin des métriques d'évaluation automatisées, une fois que vous disposez d'assez d'échantillons relus par des humains pour calibrer les scoreurs automatiques.
L'objectif n'est pas une observabilité parfaite, mais une visibilité suffisante pour que les problèmes apparaissent avant que les clients ne les remarquent.
Concepts d'IA associés
- Model monitoring - Suivi des performances d'un modèle dans le temps en production
- MLOps - La discipline plus large qui consiste à faire tourner les systèmes d'IA de façon fiable
- Gouvernance de l'IA - Dispositifs de responsabilité pour les systèmes d'IA
- Workflows agentiques - Systèmes d'IA en plusieurs étapes, où le tracing est particulièrement critique
- Retrieval-Augmented Generation - Pipelines de RAG qui gagnent à être observés à la fois en récupération et en génération
- AI Audit Trail - Le pendant de l'observabilité tourné vers la conformité
Ressources externes
- OpenTelemetry - Standard ouvert pour le tracing distribué et les métriques, de plus en plus adopté pour les systèmes d'IA
- Arize AI - Plateforme d'observabilité du ML conçue à cet effet
- LangSmith - Outils d'observabilité et d'évaluation pour les applications de LLM
Questions fréquentes sur l'observabilité de l'IA
Qu'est-ce que l'observabilité de l'IA ?
L'observabilité de l'IA consiste à construire les systèmes d'IA avec assez d'instrumentation (logs, métriques, traces et évaluations) pour comprendre leur état interne et leur comportement à partir de leurs sorties. Elle permet aux équipes de repérer les problèmes, de déboguer les défaillances et de suivre la qualité des systèmes d'IA en production.
En quoi l'observabilité de l'IA diffère-t-elle du model monitoring ?
Le model monitoring suit des métriques au niveau du modèle, comme la précision et la dérive. L'observabilité de l'IA couvre toute la pile du système : pipelines de données, infrastructure, appels d'API, latence, coût et qualité des sorties. Le monitoring vous dit que quelque chose ne va pas ; l'observabilité vous dit pourquoi et où.
Que doit consigner au minimum chaque système d'IA ?
Au minimum : l'horodatage, la version du modèle, le nombre de tokens en entrée et en sortie, la latence, l'identifiant de trace unique et les éventuels états d'erreur. Pour les applications de LLM, consignez aussi la version du prompt système et le contexte récupéré si vous utilisez du RAG. Cette base permet le suivi des coûts et le débogage rétroactif.
Faut-il des outils spécialisés pour l'observabilité de l'IA ?
Pas nécessairement. Vous pouvez commencer par une journalisation structurée dans n'importe quel système de gestion de logs existant. Des outils spécialisés comme LangSmith, Arize ou Weights and Biases apportent de la valeur aux équipes qui exploitent l'IA à grande échelle, notamment pour l'évaluation des LLM et le tracing d'agents en plusieurs étapes.

Co-Founder, Rework.com