Qu'est-ce que la dette technique de l'IA ? Le coût caché de la vitesse
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Votre projet d'IA a été lancé dans les délais et sous le budget. Six mois plus tard, la précision a chuté de 15 %, les coûts de maintenance ont triplé et l'équipe de data science passe 80 % de son temps à corriger des problèmes au lieu de développer de nouvelles fonctionnalités. Bienvenue dans la dette technique de l'IA.
Définir la dette technique de l'IA
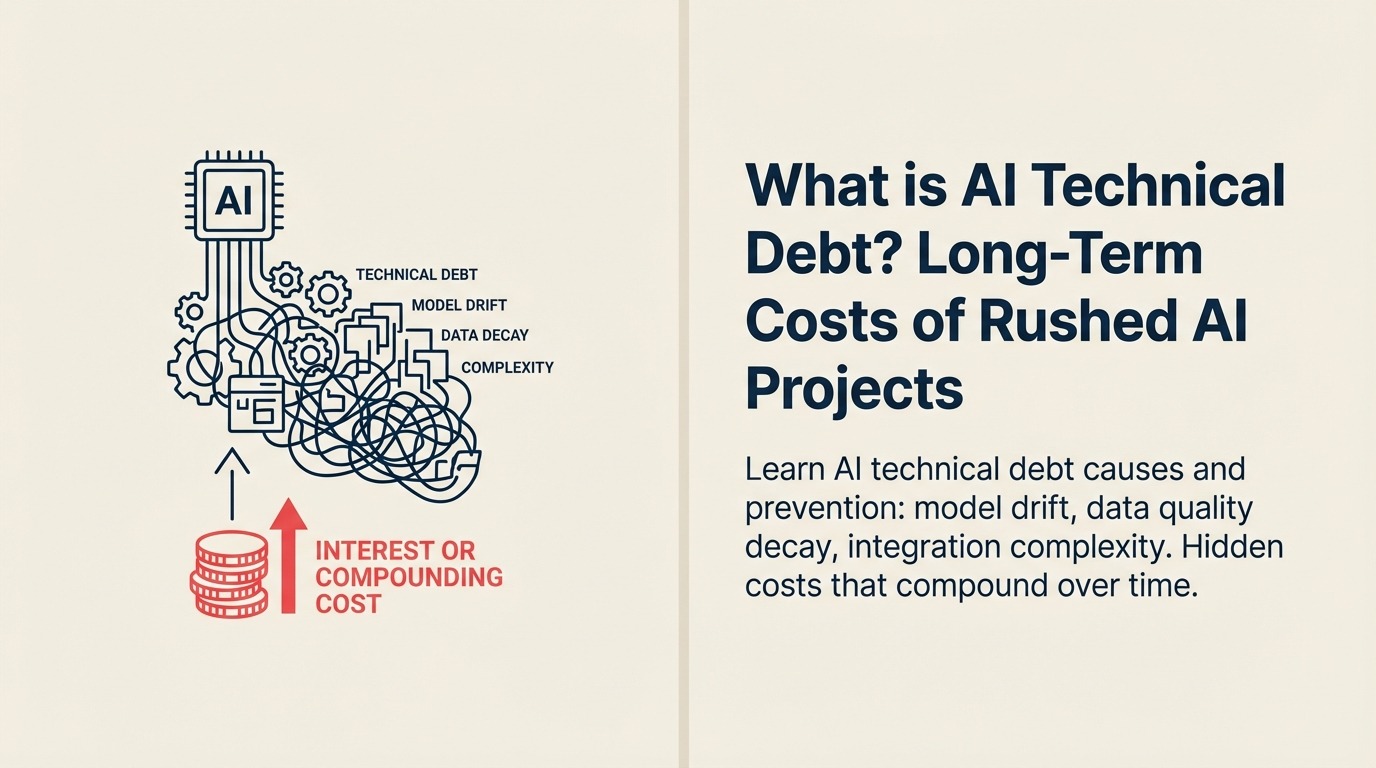
La dette technique de l'IA est le coût implicite des reprises et de la maintenance futures, causé par le choix de solutions d'IA expéditives aujourd'hui plutôt que d'approches plus solides qui demanderaient plus de temps. Elle englobe les raccourcis d'architecture des modèles, les compromis sur la qualité des données, les tests insuffisants, la documentation lacunaire et les bricolages d'intégration qui font peser une charge de maintenance toujours plus lourde.
Selon Google Research, « la dette technique dans les systèmes de ML est particulièrement insidieuse : le système peut sembler fonctionner correctement tout en accumulant une dette qui se traduit, avec le temps, par une dégradation des performances, une hausse des coûts de maintenance et une perte d'agilité. » Ce constat est issu de l'analyse de systèmes de machine learning en production, devenus de plus en plus coûteux à maintenir.
À la différence de la dette logicielle classique, la dette technique de l'IA comporte des éléments propres : des modèles entraînés qui se dégradent avec le temps (dérive du modèle), des pipelines de données qui se corrompent peu à peu, et des systèmes étroitement couplés où la modification d'un modèle en casse d'autres. La dette devient ainsi plus difficile à détecter et plus coûteuse à rembourser.
Perspective dirigeant
Pour les dirigeants, la dette technique de l'IA fait la différence entre des systèmes d'IA dont la valeur se cumule avec le temps et des projets d'IA dont la maintenance devient exponentiellement plus chère : c'est la raison pour laquelle votre budget IA ne cesse de grossir sans que les capacités suivent.
Pensez à la dette technique de l'IA comme à un entretien d'immeuble repoussé. Sauter l'entretien courant fait économiser de l'argent au début, mais le toit finit par fuir, les canalisations par éclater, et les réparations coûtent 10 fois plus cher que la prévention. L'immeuble tient encore debout, mais ses coûts d'exploitation explosent.
Concrètement, la dette technique de l'IA se traduit par des modèles qu'il faut réentraîner en permanence, des pipelines de données qui cassent sans prévenir, des mises à jour de systèmes qui virent au cauchemar d'intégration et des data scientists talentueux coincés à réparer d'anciens projets au lieu de créer de la valeur nouvelle.
Les sources de dette technique de l'IA
Là où la dette s'accumule :
Dette de modèle :
- Bricolages rapides au lieu d'une vraie architecture
- Modèles trop complexes, choisis pour les benchmarks plutôt que pour les besoins de la production
- Hypothèses non documentées sur la distribution des données
- Aucun contrôle de version ni reproductibilité
- Exemple : utiliser les derniers modèles issus de la recherche sans évaluer leur maturité pour la production
Dette de données :
- Contrôles de qualité des données irréguliers
- Dépendances de données instables entre systèmes
- Traitements manuels non automatisés
- Aucune surveillance des changements en amont
- Exemple : le pipeline suppose que le format des données ne change jamais, et casse quand le système source est mis à jour
Dette d'intégration :
- Code de colle reliant des systèmes incompatibles
- Couplage étroit entre l'IA et la logique métier
- Configurations et seuils codés en dur
- Absence de couches d'abstraction d'API
- Exemple : des règles métier intégrées au code du modèle, qui obligent à mobiliser un data scientist pour le moindre changement métier
Dette de configuration :
- Paramètres codés en dur au lieu d'être configurables
- Aucune gestion systématique des hyperparamètres
- Feature flags éparpillés dans le code
- Bricolages propres à chaque environnement
- Exemple : des chemins de code différents entre prod et dev au lieu d'une configuration
Dette de tests :
- Couverture de tests insuffisante pour les cas limites
- Aucun test systématique des prédictions du modèle
- Tests de validation des données absents
- Tests d'intégration et de système sautés
- Exemple : ne tester que le scénario nominal, pas la dégradation de la qualité des données
Un effet cumulatif
Pourquoi la dette de l'IA croît de façon exponentielle :
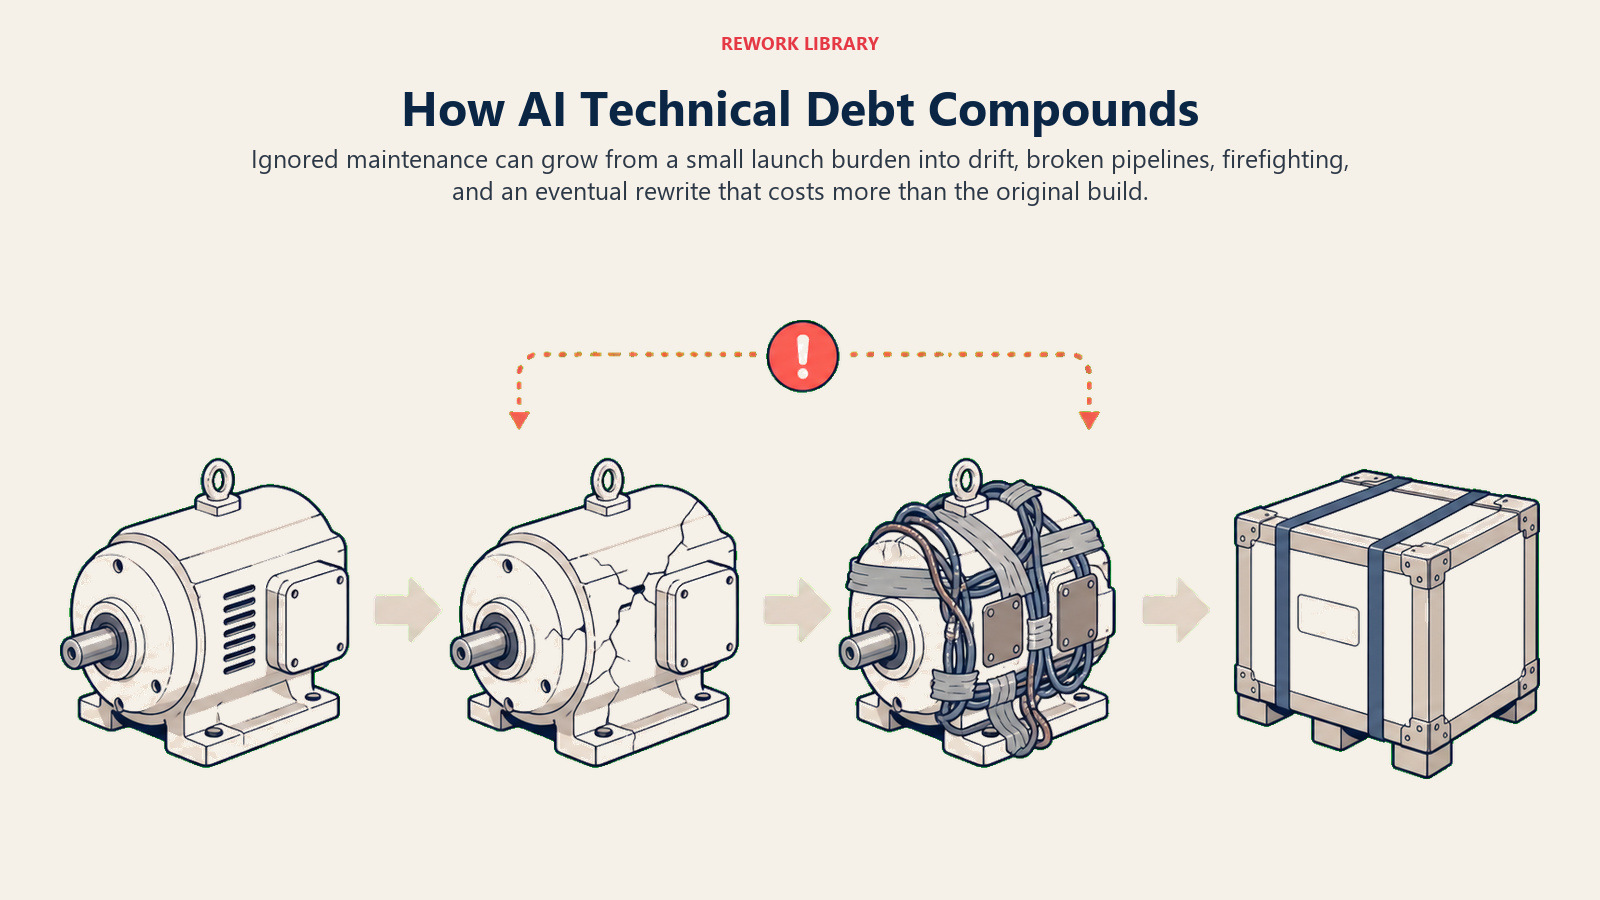
Année 1 : le lancement
- Le modèle fonctionne bien, l'équipe fête le succès
- Les petits problèmes de maintenance sont ignorés
- « On corrigera plus tard » devient une habitude
- Coût : 5 % du budget en corrections
Année 2 : les fissures apparaissent
- La précision baisse sous l'effet de la dérive des données
- Le pipeline casse à cause de changements en amont
- Les nouvelles fonctionnalités deviennent plus difficiles à ajouter
- Coût : 20 % du budget en maintenance
Année 3 : le mode crise
- Les défaillances critiques se multiplient
- L'équipe est paralysée par des problèmes imbriqués
- Les métiers réclament de nouvelles fonctionnalités que l'équipe ne peut pas livrer
- Coût : 60 % du budget à éteindre des incendies
Année 4 : réécrire ou disparaître
- Une dette si élevée qu'il devient moins cher de tout réécrire
- De la valeur métier perdue pendant la reconstruction
- Les mêmes erreurs se répètent faute d'avoir tiré les leçons
- Coût : plus de 100 % du développement initial
Dérive et dégradation des modèles
La dégradation des performances au fil du temps :
Dérive conceptuelle (concept drift) :
- Problème : la relation entre les entrées et les sorties change
- Exemple : le comportement des clients évolue après la pandémie, et l'ancien modèle prédit à tort
- Détection : surveiller les changements de distribution des prédictions
- Solution : des pipelines de réentraînement automatisés avec le MLOps
Dérive des données (data drift) :
- Problème : la distribution des données d'entrée change avec le temps
- Exemple : de nouvelles catégories de produits absentes des données d'entraînement
- Détection : comparer les données entrantes aux statistiques des données d'entraînement
- Solution : validation des données et alertes automatiques
Changements de données en amont :
- Problème : les systèmes sources changent de format ou de signification
- Exemple : le champ « âge » du client est remplacé par une date de naissance
- Détection : validation de schéma et contrôles de qualité des données
- Solution : des contrats de données formels avec les équipes en amont
Boucles de rétroaction :
- Problème : les prédictions du modèle influencent les données futures
- Exemple : un système de recommandation qui restreint peu à peu les centres d'intérêt des clients
- Détection : des indicateurs de diversité dans les prédictions
- Solution : des stratégies d'exploration explicites
Dégradation de la qualité des données
Comment les données se détériorent :
Complexité des pipelines :
- Les étapes de transformation multiples créent autant de points de défaillance
- Chaque étape augmente le risque de perte de qualité
- Le débogage tourne à l'expédition archéologique
- Prévention : simplifier les pipelines, limiter les transformations
Chaînes de dépendances :
- Le modèle dépend de variables issues d'autres modèles
- Ces modèles dépendent eux-mêmes d'autres modèles
- Des pannes en cascade dès que l'un d'eux casse
- Prévention : limiter les dépendances entre modèles
Interventions manuelles :
- Corrections de données ponctuelles, non automatisées
- Savoir informel sur les particularités des données
- Quand la personne part, le savoir disparaît
- Prévention : automatiser toutes les opérations sur les données
Failles de surveillance :
- Partir du principe que la qualité des données reste constante
- Aucune alerte quand les distributions changent
- Des problèmes découverts par les utilisateurs, pas par les systèmes
- Prévention : une surveillance complète des pipelines de données
Complexité d'intégration
Le problème du plat de spaghettis :
Couplage étroit :
- Logique métier mêlée au code de ML
- Modifier une règle métier oblige à réentraîner les modèles
- Exemple : des règles de tarification intégrées au modèle de recommandation
- Solution : séparer les responsabilités et utiliser le modèle comme un composant
L'enfer de la configuration :
- Des centaines de paramètres éparpillés entre les systèmes
- Aucune source unique de référence
- Des valeurs différentes entre prod et staging, source de bugs
- Solution : une gestion centralisée de la configuration
Incompatibilité de versions :
- Modèle entraîné avec la bibliothèque v1.0, production sous v2.0
- Les mises à jour de framework cassent les modèles déployés
- Exemple : une mise à niveau de TensorFlow rend les anciens modèles incompatibles
- Solution : conteneurisation et verrouillage des versions
Systèmes enchevêtrés :
- Impossible de mettre à jour un composant sans en casser d'autres
- Les tests exigent de lancer toute l'infrastructure
- Exemple : des tests A/B impossibles à cause des interconnexions
- Solution : une architecture en microservices avec des interfaces claires
Des catastrophes de dette bien réelles
Quelques récits édifiants :
Exemple dans l'e-commerce : un distributeur a construit son système de recommandation avec des identifiants de catégories codés en dur. Quand le catalogue a été restructuré, le modèle a cessé de fonctionner. La reconstruction d'urgence, étalée sur 6 mois, a coûté 3 M$, contre 200 K$ pour le faire correctement dès le départ, et le chiffre d'affaires perdu pendant l'interruption a dépassé le coût de la reconstruction.
Exemple dans les services financiers : le modèle de détection de fraude d'une banque est passé de 95 % à 72 % de précision en 2 ans à mesure que les schémas de fraude évoluaient. Aucune surveillance n'a détecté la dérive, découverte seulement quand les pertes liées à la fraude ont explosé. Le réentraînement d'urgence et la mise en place d'une surveillance ont coûté 5 M$, sans compter l'atteinte à la réputation.
Exemple dans la santé : un système d'aide à la décision clinique reposait sur un pipeline de données qui supposait un format de dossier médical électronique précis. Une mise à jour de l'éditeur a modifié le schéma, et le système a échoué silencieusement pendant 3 semaines en produisant des recommandations erronées, ce qui a entraîné une enquête des autorités de régulation et un procès.
Stratégies de prévention
Éviter l'accumulation de la dette :
Phase de conception :
- Construire pour la production dès le premier jour, pas pour un prototype de recherche
- Anticiper explicitement la dérive des données et la dérive conceptuelle
- Concevoir des architectures simples, capables d'évoluer
- Documenter les hypothèses et les dépendances
Phase de développement :
- Mettre en œuvre dès le départ les pratiques de MLOps
- Tout automatiser : tests, déploiement, surveillance
- Relire le code des systèmes d'IA comme celui d'une infrastructure critique
- Versionner les données, les modèles et les configurations
Phase de déploiement :
- Surveillance complète des modèles et des données
- Pipelines de réentraînement automatisés
- Déploiements progressifs avec possibilité de retour en arrière
- Responsabilités clairement attribuées et astreintes organisées
Phase de maintenance :
- Audits réguliers des modèles et revues de performance
- Sprints planifiés de remboursement de la dette
- Refactorisation et simplification en continu
- Retours d'expérience après incident et améliorations des systèmes
Stratégie de remboursement de la dette
S'attaquer à la dette existante :
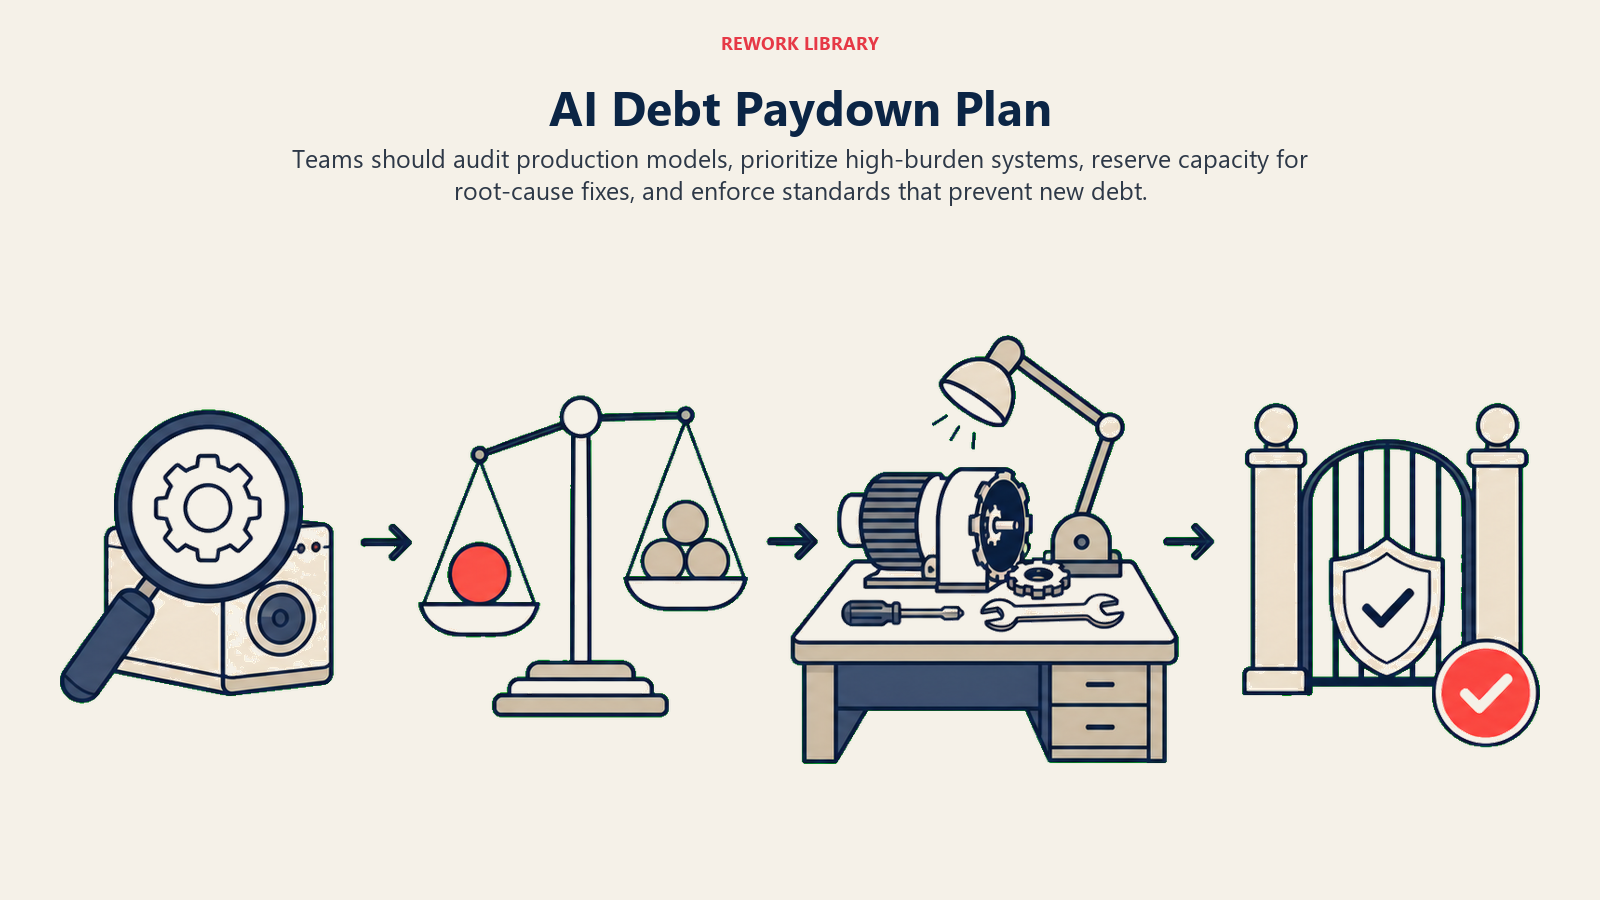
Évaluer la dette actuelle :
- Auditer tous les modèles en production
- Repérer les systèmes qui demandent le plus de maintenance
- Chiffrer les coûts de maintenance et l'impact métier
- Prioriser selon le poids de la dette et la criticité pour l'activité
Établir un plan de remboursement :
- Consacrer 20 à 30 % de la capacité à la réduction de la dette
- Commencer par les améliorations au meilleur ROI
- Traiter les causes profondes, pas les symptômes
- Suivre la réduction de la dette comme un indicateur clé
Empêcher la dette nouvelle :
- Exiger des revues d'AI governance pour les nouveaux projets
- Imposer les standards de MLOps
- Rendre la dette visible dans la planification
- Récompenser la qualité plus que la vitesse
Discipline sur le long terme :
- Revues d'architecture régulières
- Culture de la refactorisation continue
- Partage des connaissances et documentation
- Célébrer le remboursement de la dette, pas seulement les nouvelles fonctionnalités
Mesurer la dette technique de l'IA
Chiffrer l'invisible :
Indicateurs de coût direct :
- Heures passées en maintenance par rapport au développement nouveau
- Fréquence des incidents et temps de résolution
- Fréquence et effort des réentraînements
- Évolution des coûts d'infrastructure dans le temps
Indicateurs de qualité :
- Taux de dégradation des performances du modèle
- Scores de qualité des données dans le temps
- Couverture de tests et taux de réussite
- Nombre de correctifs d'urgence en production
Indicateurs d'agilité :
- Délai de déploiement des mises à jour de modèles
- Délai pour ajouter de nouvelles fonctionnalités
- Vitesse d'expérimentation
- Scores de satisfaction des développeurs
Impact sur l'activité :
- Chiffre d'affaires perdu à cause de défaillances de modèles
- Satisfaction des clients vis-à-vis des fonctionnalités d'IA
- Position concurrentielle face aux concurrents natifs de l'IA
- ROI des projets d'IA en baisse
Bâtir une IA durable
Les étapes pour des systèmes d'IA sans dette :
- Mettre en place le MLOps pour une exploitation durable
- Surveiller en continu avec le Model Monitoring
- Construire des données de qualité grâce aux bonnes pratiques de Data Pipeline
- Gouverner efficacement via l'AI Governance
Questions fréquentes sur la dette technique de l'IA
Qu'est-ce que la dette technique de l'IA ?
La dette technique de l'IA est le coût implicite des reprises et de la maintenance futures, causé par le choix de solutions d'IA expéditives plutôt que d'approches plus solides qui demandent plus de temps. Elle englobe les raccourcis d'architecture des modèles, les compromis sur la qualité des données, les tests insuffisants, la documentation lacunaire et les bricolages d'intégration qui font peser une charge de maintenance toujours plus lourde.
Quelles sont les cinq principales sources de dette technique de l'IA ?
La dette de modèle (raccourcis d'architecture et complexité excessive), la dette de données (qualité irrégulière et dépendances instables), la dette d'intégration (code de colle et couplage étroit), la dette de configuration (paramètres codés en dur) et la dette de tests (couverture et validation insuffisantes).
Qu'est-ce que la dérive d'un modèle et pourquoi est-ce important ?
La dérive d'un modèle est la dégradation de ses performances au fil du temps, due à la dérive conceptuelle (la relation entrées-sorties change), à la dérive des données (la distribution des entrées change), aux changements en amont (le format des données sources change) ou aux boucles de rétroaction (les prédictions influencent les données futures). Elle fait perdre silencieusement aux systèmes d'IA jusqu'à 25 points de précision, de 95 % à 70 %.
Comment la dette technique de l'IA s'accumule-t-elle avec le temps ?
Année 1 : 5 % du budget en corrections, les petits problèmes sont ignorés. Année 2 : 20 % en maintenance à mesure que la précision baisse et que les pipelines cassent. Année 3 : 60 % à éteindre des incendies, l'équipe est paralysée. Année 4 : plus de 100 % du coût initial pour réécrire le système, ce qui rend les raccourcis du départ bien plus chers qu'une construction soignée.
Comment prévenir la dette technique de l'IA ?
Concevoir pour la production dès le premier jour, appliquer les pratiques de MLOps dès le départ, automatiser les tests et le déploiement, surveiller de près les modèles et les données, tenir une documentation claire, consacrer 20 à 30 % de la capacité à la prévention de la dette et imposer des revues de gouvernance pour les nouveaux projets.
Ressources externes
- Google Research on ML Technical Debt - Travaux de recherche fondateurs
- MLOps Community - Bonnes pratiques et études de cas
- Microsoft MLOps - Recommandations pour les entreprises
Ressources associées
Explorez ces concepts associés pour prévenir et gérer la dette technique de l'IA :
- MLOps - Pratiques pour une exploitation durable de l'IA
- Model Monitoring - Détecter tôt la dérive et la dégradation
- Data Pipeline - Bâtir une infrastructure de données fiable
- AI Governance - Un cadre pour empêcher l'accumulation de la dette
Fait partie de la collection AI Terms. Dernière mise à jour : 2026-02-09

Co-Founder, Rework.com
On this page
- Définir la dette technique de l'IA
- Perspective dirigeant
- Les sources de dette technique de l'IA
- Un effet cumulatif
- Dérive et dégradation des modèles
- Dégradation de la qualité des données
- Complexité d'intégration
- Des catastrophes de dette bien réelles
- Stratégies de prévention
- Stratégie de remboursement de la dette
- Mesurer la dette technique de l'IA
- Bâtir une IA durable
- Ressources externes
- Ressources associées