Qu'est-ce que le clustering ? Découvrir les tribus cachées de vos données
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Le clustering en entreprise est une technique d'apprentissage automatique non supervisé qui regroupe des clients, des produits ou des marchés en segments naturels, selon leur comportement réel, sans que vous ayez à définir les groupes à l'avance. Il fait émerger des segments à forte valeur que les données démographiques classiques ne voient pas, d'où son usage pour la segmentation client, l'analyse de marché et la détection de motifs.
87 % des entreprises segmentent mal leurs clients. Elles s'en tiennent à des données démographiques de base (âge, revenu, lieu) alors que le véritable filon se trouve dans les comportements. C'est là qu'intervient le clustering : une IA qui trouve des groupes naturels dans vos données et révèle des segments dont vous ignoriez l'existence. Comme ce distributeur qui a découvert que ses « acheteurs de yaourt du dimanche matin » constituaient son segment le plus rentable.
Comprendre le clustering
Lors d'une soirée, les gens se regroupent naturellement : les fans de sport se retrouvent, les parents se repèrent, les passionnés de technologie se rassemblent dans un coin. Les algorithmes de clustering font la même chose avec les données : ils trouvent des regroupements naturels sans qu'on leur dise quoi chercher.
Plus techniquement, le clustering est une technique d'apprentissage automatique non supervisé qui regroupe des points de données similaires selon leurs caractéristiques. Contrairement à la classification (qui exige des étiquettes), le clustering découvre les motifs de lui-même.
La différence essentielle tient à la découverte face à la prédiction. La classification par apprentissage supervisé demande « Ce client est-il à forte valeur ? » alors que vous savez déjà ce que « forte valeur » signifie. Le clustering demande « Quels types de clients avons-nous ? » et laisse les données apporter la réponse.
Comment fonctionne réellement le clustering
Le clustering repose sur la mesure de la similarité. D'abord, il représente chaque point de données dans un espace mathématique : l'âge du client peut être une dimension, la fréquence d'achat une autre, le panier moyen une troisième. Un peu comme placer des points sur une carte à plusieurs dimensions.
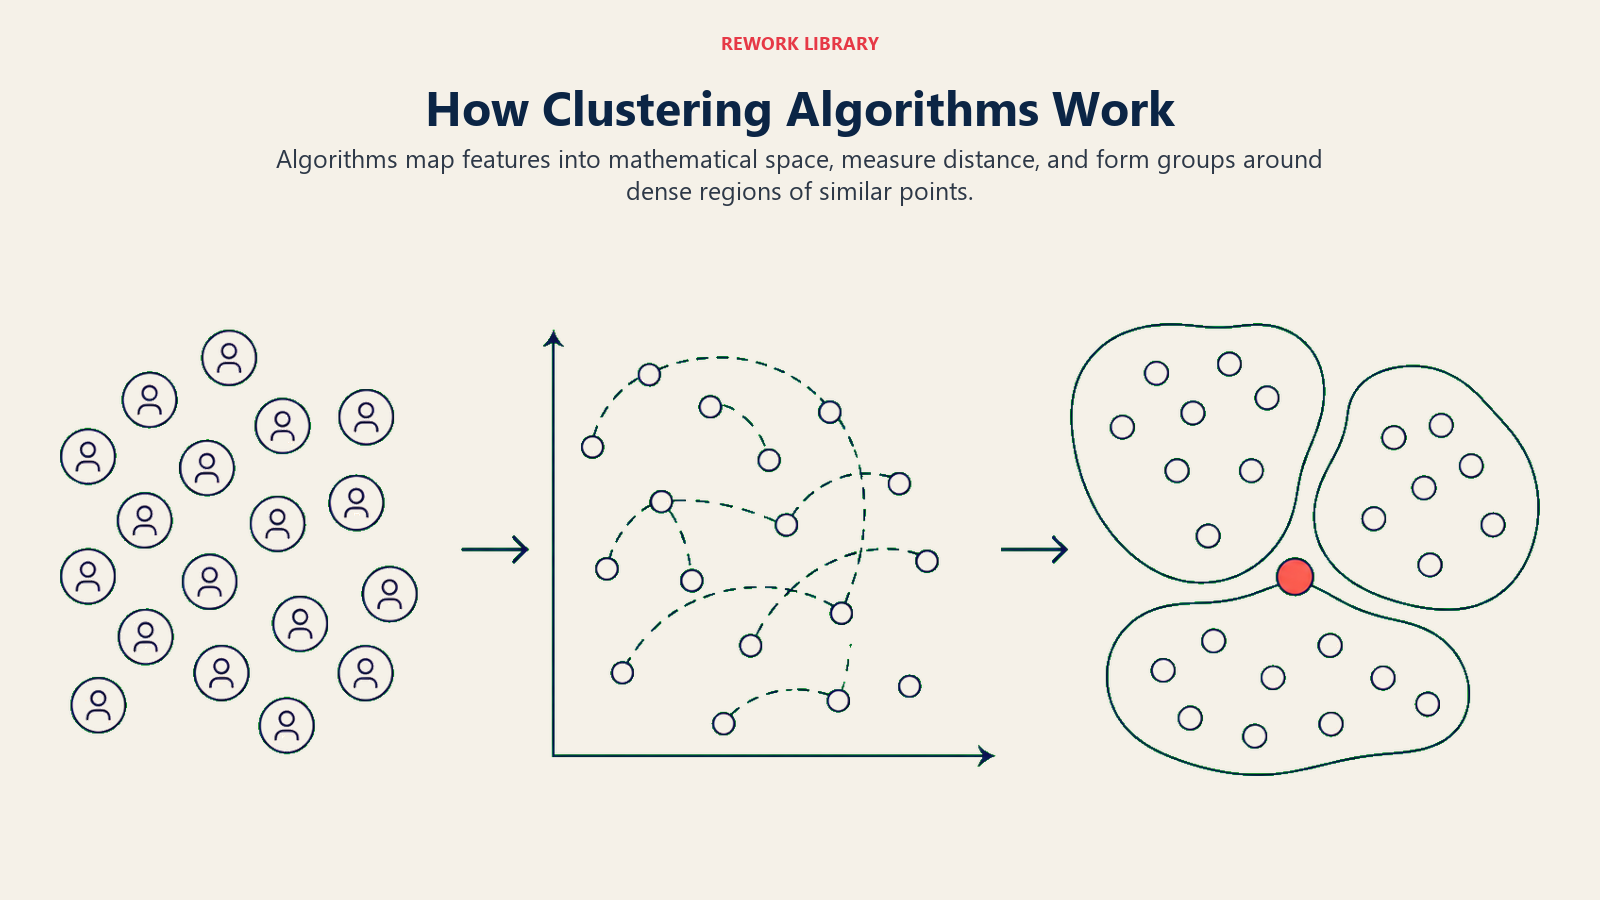
Ensuite, les algorithmes calculent les distances entre tous les points. Les éléments similaires sont proches, les éléments différents sont éloignés. Un acheteur de produits de luxe et un acheteur à petit budget peuvent être très éloignés même s'ils ont le même âge et vivent au même endroit.
Enfin, les groupes se forment selon la proximité. L'algorithme trace des frontières autour des zones denses de points similaires. Vous pouvez découvrir cinq segments de clients distincts là où vous pensiez en avoir deux.
Toute la magie tient à la définition de la « similarité » : les algorithmes modernes de machine learning savent gérer des centaines de dimensions et des relations complexes que l'humain ne peut pas visualiser.
Applications concrètes du clustering
Segmentation client dans le retail Un distributeur de mode a appliqué le clustering à l'historique d'achats, au comportement de navigation et aux schémas de retours. Il a découvert sept segments, dont les « suiveurs de tendances » (qui achètent dès le lancement) et les « chasseurs de promos » (qui n'achètent que des articles soldés). Un marketing personnalisé pour chaque segment a augmenté le chiffre d'affaires de 34 %.
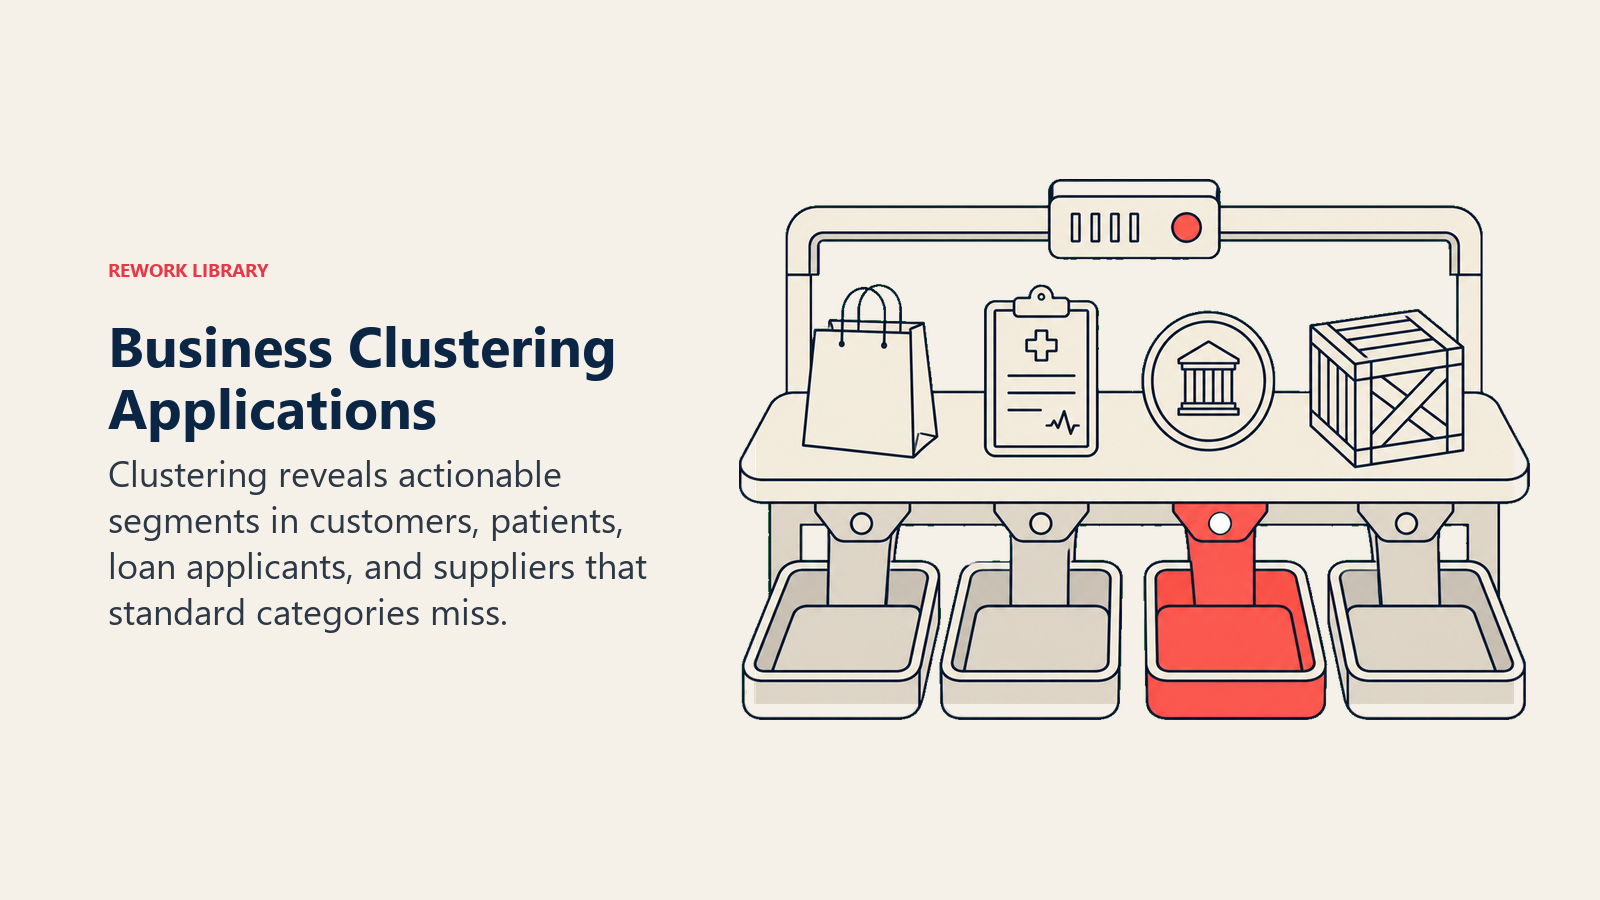
Groupes de patients en santé Un hôpital a regroupé les données de ses patients au-delà des facteurs de risque traditionnels. Il a trouvé des sous-groupes qui réagissent différemment aux traitements. Un cluster de patients diabétiques a répondu 3 fois mieux aux interventions sur le mode de vie qu'aux médicaments. La personnalisation des traitements a amélioré les résultats de 40 %.
Évaluation du risque financier Une banque a regroupé des demandeurs de prêts de petites entreprises à partir d'indicateurs financiers, de données sectorielles et de schémas de transactions. Elle a identifié des clusters de risque que le scoring traditionnel manquait. Les taux de défaut ont baissé de 25 % tandis que les taux d'acceptation ont augmenté de 15 %.
Optimisation de la supply chain Un industriel a regroupé ses fournisseurs selon leur performance de livraison, leurs indicateurs de qualité et leurs schémas de communication. Cela a révélé des profils de fiabilité cachés. La refonte des relations fournisseurs a réduit les retards de 30 %.
Types d'algorithmes de clustering
Clustering K-Means Le cheval de trait du clustering. Vous indiquez le nombre de clusters souhaité, et il trouve les meilleurs regroupements. Idéal pour la segmentation client quand il vous faut des groupes distincts qui ne se chevauchent pas. Rapide et évolutif.
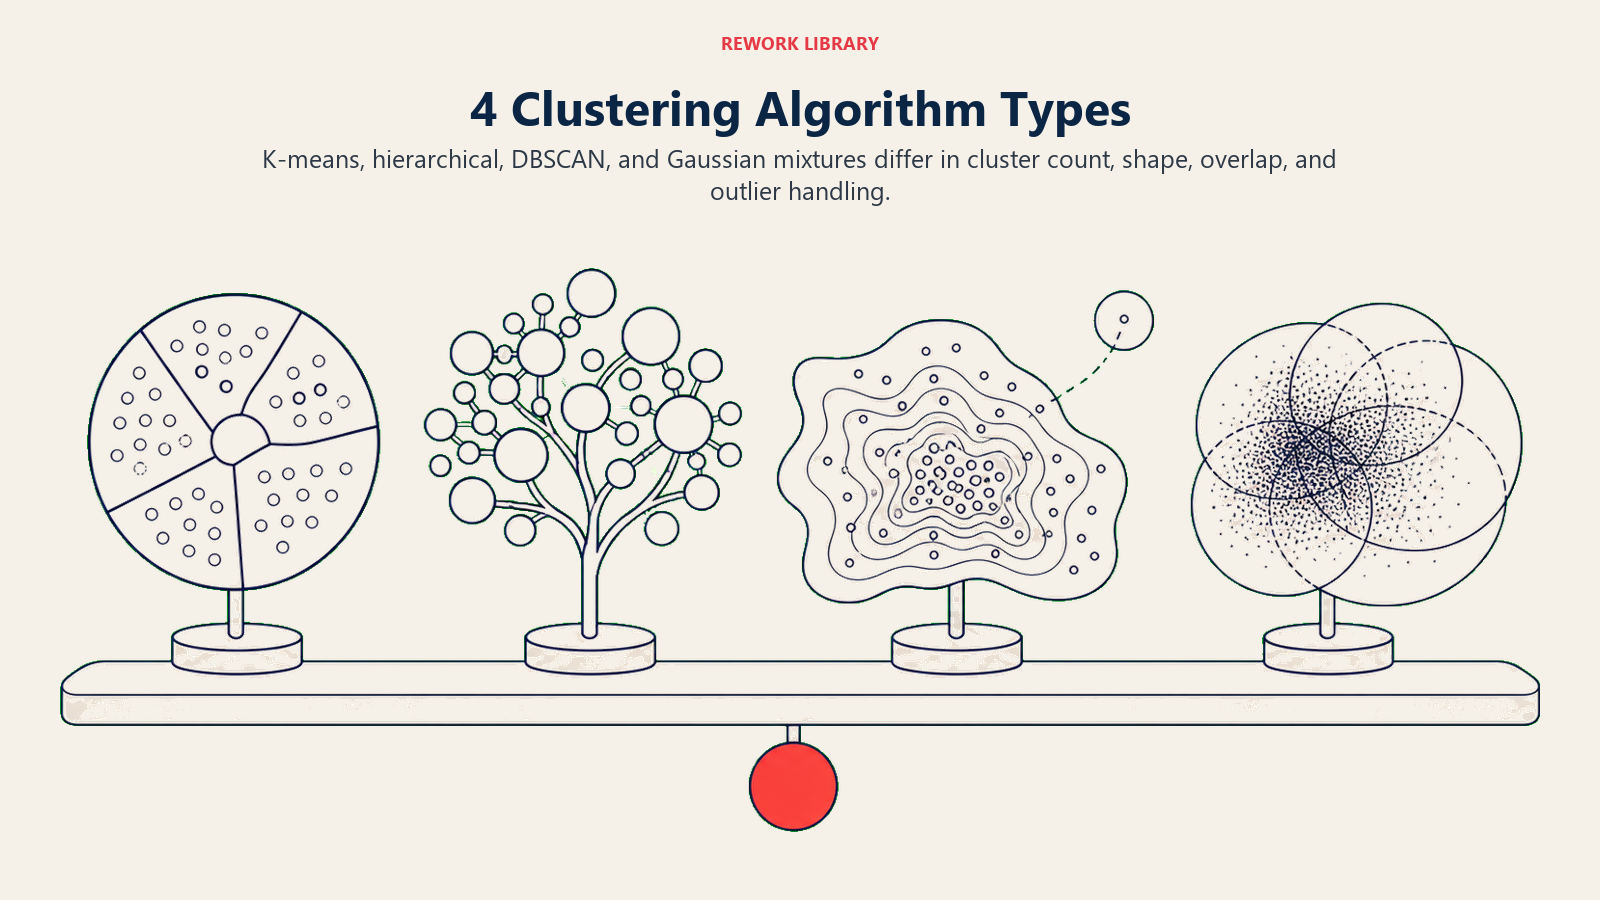
Clustering hiérarchique Construit un arbre de clusters, comme l'organisation d'une entreprise en départements, équipes puis individus. Très utile quand vous avez besoin de différents niveaux de granularité. Les chaînes de magasins l'emploient pour regrouper leurs points de vente.
DBSCAN (fondé sur la densité) Trouve des clusters de forme arbitraire et identifie les points aberrants. Excellent pour la détection de fraude et la détection d'anomalies : les transactions normales se regroupent, les transactions frauduleuses ressortent comme des points aberrants.
Modèles de mélange gaussien Supposent que les données proviennent de plusieurs distributions statistiques. Plus élaborés, mais puissants. Utilisés dans l'industrie pour repérer différents états de qualité en production.
Choisir le bon algorithme revient à savoir si vous connaissez déjà le nombre de groupes attendu, si les groupes se chevauchent et si vous devez signaler les points aberrants. Ce tableau associe chaque algorithme à la situation métier pour laquelle il convient le mieux :
| Algorithme | Faut-il fixer le nombre de clusters ? | Gestion des points aberrants | Meilleur usage métier |
|---|---|---|---|
| K-Means | Oui | Non (force chaque point dans un groupe) | Segments clients nets et distincts |
| Hiérarchique | Non | Limitée | Regroupements de magasins ou de produits à plusieurs niveaux |
| DBSCAN | Non | Oui (les isole) | Détection de fraude et d'anomalies |
| Mélange gaussien | Oui | Souple (probabiliste) | Segments qui se chevauchent, états de qualité |
Une règle pratique : commencez par K-Means quand vous voulez des segments simples, sans chevauchement, et que vous avez une idée approximative de leur nombre, puis testez DBSCAN si vos données contiennent du bruit ou si les points qui n'entrent dans aucun groupe vous intéressent. Le clustering hiérarchique prend tout son sens quand une même segmentation doit servir plusieurs décisions à la fois, comme une vue régionale et une vue par magasin à partir des mêmes données.
La différence du clustering
Avant le clustering : le marketing envoie la même campagne aux « femmes de 25-34 ans » Après le clustering : cinq segments distincts sont identifiés :
- Les professionnelles centrées sur leur carrière (sensibles aux messages d'efficacité)
- Les jeunes mères (attachées à la sécurité et à la praticité)
- Les passionnées de fitness (qui veulent des fonctions de performance)
- Les étudiantes soucieuses de leur budget (sensibles au prix)
- Les acheteuses éco-responsables (pour qui la durabilité compte)
Résultat : les taux de clics ont augmenté de 250 %. Même audience, segmentation plus fine.
Quand le clustering a du sens
Imaginez que vous avez des milliers de produits mais que vous ne savez pas comment les organiser. Les catégories traditionnelles (électronique, vêtements) sont trop larges. Le clustering révèle des regroupements naturels fondés sur la manière dont les clients achètent vraiment : les « essentiels du quotidien » ou les « achats qui demandent des recherches ».
Ou admettons que vous entriez sur un nouveau marché. Vous ne connaissez pas encore les segments de clients. Le clustering analyse les premiers utilisateurs et révèle des types d'utilisateurs distincts à cibler.
Feuille de route de mise en œuvre
Semaine 1 : préparation des données
- Rassembler les variables pertinentes (comportement plutôt que démographie)
- Nettoyer et normaliser les données grâce à une bonne curation des données (essentielle pour le clustering)
- Supprimer les points aberrants évidents
- Créer des variables dérivées (ratios, fréquences)
Semaine 2 : exploration
- Essayer plusieurs algorithmes
- Tester différents nombres de clusters
- Vérifier que les résultats ont un sens métier
- Recueillir l'avis des parties prenantes sur les regroupements
Semaines 3-4 : validation
- Tester la stabilité des clusters dans le temps
- S'assurer que les clusters sont exploitables
- Calculer les indicateurs métier de chaque cluster
- Concevoir des stratégies propres à chaque cluster
Mois 2 et suivants : mise en production
- Automatiser l'affectation des nouvelles données aux clusters grâce aux pratiques de MLOps
- Créer des dashboards de suivi
- Élaborer des traitements propres à chaque cluster
- Mesurer l'impact et affiner
Outils de clustering
Solutions no-code :
- Tableau - Clustering intégré (70 $/utilisateur/mois)
- Microsoft Power BI - Fonctions de clustering automatique (10 $/utilisateur/mois)
- Google Analytics 4 - Découverte d'audiences (gratuit avec limites)
Bibliothèques Python (gratuites) :
- scikit-learn - Tous les principaux algorithmes
- HDBSCAN - Clustering avancé par densité
- pyclustering - Algorithmes spécialisés
Plateformes d'entreprise :
- SAS Enterprise Miner - Suite complète de clustering (tarif sur mesure)
- IBM SPSS Modeler - Clustering visuel (99 $/utilisateur/mois)
- DataRobot - Clustering automatisé (75 K $ et plus/an)
Services cloud :
- AWS SageMaker - Clustering intégré (0,05 $/heure)
- Google Vertex AI - Clustering AutoML (20 $/heure)
- Azure ML - Modules de clustering (9,90 $/heure de calcul)
Pièges courants du clustering
Piège 1 : imposer un mauvais nombre de clusters Le CEO veut 5 segments de clients parce que les concurrents en ont 5. Les données montrent clairement 3 ou 8 groupes naturels. Solution : laissez les données guider le nombre de clusters. Utilisez les courbes du coude et les scores de silhouette. La logique métier doit affiner, pas définir.
Piège 2 : utiliser les mauvaises variables Regrouper les clients par âge et revenu alors que le comportement d'achat varie davantage selon le mode de vie et les valeurs. Solution : privilégiez les variables comportementales et transactionnelles. La démographie joue les seconds rôles, pas les premiers.
Piège 3 : ignorer l'évolution des clusters Des segments de clients définis en 2019 et jamais mis à jour. La COVID a tout changé. Solution : refaites le clustering chaque trimestre ou lors d'événements majeurs. Mettez en place un suivi des modèles pour repérer la dérive des clusters.
Stratégies de clustering avancées
Clustering multi-vues Combinez différentes perspectives de données. Regroupez les clients selon leur comportement d'achat ET leurs interactions avec le support ET leur activité sur le site web. Cela révèle des segments plus riches.
Clustering semi-supervisé Intégrez quelques étiquettes connues pour guider le clustering. « Nous savons que ceux-ci sont des clients VIP, trouvez des groupes similaires. » Cela équilibre découverte et connaissance métier.
Clustering dynamique Des clusters qui évoluent dans le temps. Suivez la façon dont les clients passent d'un segment à l'autre. Utilisez l'analyse de séries temporelles pour prédire les transitions entre segments. Cela permet d'intervenir de manière proactive.
Mesurer la réussite du clustering
Indicateurs techniques :
- Coefficient de silhouette (séparation des clusters)
- Indice de Davies-Bouldin (compacité des clusters)
- Score de Calinski-Harabasz (définition des clusters)
Indicateurs métier :
- Chiffre d'affaires par cluster
- Taux de réponse marketing par cluster
- Écarts de rétention entre clusters
- Coûts opérationnels par cluster
Test d'exploitabilité : Pouvez-vous définir des stratégies distinctes pour chaque cluster ? Si tous les clusters reçoivent le même traitement, le clustering a échoué.
Le clustering selon les secteurs
E-commerce :
- Groupes d'affinité produit
- Segments de comportement d'achat
- Clusters d'acheteurs saisonniers
- Groupes de sensibilité au prix
B2B :
- Segmentation des comptes
- Groupes de schémas d'usage
- Clusters de potentiel de croissance, enrichis par l'analyse prédictive
- Segments de profil de risque
Santé :
- Groupes de patients à risque
- Clusters de réponse aux traitements
- Segments d'utilisation des ressources
- Groupes de prédiction des résultats
Faire travailler le clustering pour vous
Soyons clairs : le clustering n'a rien de magique. Mais si vous traitez tous vos clients de la même façon, vous laissez filer de l'argent.
Commencez petit : regroupez vos 1 000 meilleurs clients selon leur comportement d'achat. Vous découvrirez des segments que vous n'aviez jamais imaginés.
En savoir plus
Explorez ces concepts connexes pour approfondir votre compréhension du clustering et de la découverte fondée sur les données :
- Apprentissage non supervisé - La catégorie plus large des techniques de ML qui découvrent des motifs sans étiquettes
- Apprentissage profond (deep learning) - Des approches neuronales avancées pour les tâches de clustering complexes
- Réseaux de neurones - L'architecture sous-jacente des algorithmes de clustering modernes
- Business Intelligence - Comment les enseignements du clustering alimentent la prise de décision stratégique
Ressources externes
- Stanford HAI: Clustering Research - Recherche universitaire sur les algorithmes de clustering
- Scikit-learn Clustering Guide - Documentation pratique de mise en œuvre
- Papers With Code: Clustering - Les dernières techniques de clustering et leurs benchmarks
Questions fréquentes sur le clustering
Qu'est-ce que le clustering ?
Le clustering est une technique d'apprentissage automatique non supervisé qui regroupe des points de données similaires selon leurs caractéristiques et découvre des motifs naturels sans qu'on lui dise quoi chercher.
Quelle différence entre clustering et classification ?
La classification prédit des catégories quand on sait déjà lesquelles existent. Le clustering découvre des groupes inconnus dans les données, sans étiquettes ni catégories prédéfinies.
Quels sont les quatre grands types d'algorithmes de clustering ?
K-Means (on précise le nombre de clusters), hiérarchique (construit un arbre de clusters), DBSCAN (trouve des formes arbitraires et des points aberrants) et modèles de mélange gaussien (supposent des distributions statistiques).
Quels sont les principaux avantages du clustering pour l'entreprise ?
La découverte de segments de clients cachés, une meilleure personnalisation, une meilleure compréhension du marché, l'optimisation des ressources et l'identification de motifs que la segmentation traditionnelle manque.
Quels sont les pièges courants de la mise en œuvre du clustering ?
Imposer un mauvais nombre de clusters (laissez les données guider), utiliser les mauvaises variables (privilégiez le comportement à la démographie) et ignorer l'évolution des clusters (les segments changent avec le temps).
Fait partie de la Collection Glossaire de l'IA. Dernière mise à jour : 2026-07-21

Co-Founder, Rework.com
On this page
- Comprendre le clustering
- Comment fonctionne réellement le clustering
- Applications concrètes du clustering
- Types d'algorithmes de clustering
- La différence du clustering
- Quand le clustering a du sens
- Feuille de route de mise en œuvre
- Outils de clustering
- Pièges courants du clustering
- Stratégies de clustering avancées
- Mesurer la réussite du clustering
- Le clustering selon les secteurs
- Faire travailler le clustering pour vous
- En savoir plus
- Ressources externes