Qu'est-ce que la self-attention ? Le secret de la compréhension du langage par l'IA
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Imaginez que vous lisiez « The bank was steep » puis « The bank was closed ». Comment savez-vous aussitôt que la première phrase parle d'une berge et la seconde d'un établissement financier ? Votre cerveau s'appuie sur le contexte : il considère tous les mots ensemble, et pas seulement dans l'ordre. C'est exactement ce que fait la self-attention pour l'IA, et c'est pourquoi ChatGPT parvient réellement à comprendre ce que vous voulez dire.
L'histoire de la self-attention
Avant 2017, les modèles d'IA lisaient le texte comme un lecteur pressé avec une vision en tunnel : un mot à la fois, en oubliant le contexte précédent. La traduction était maladroite et la compréhension superficielle. Puis des chercheurs de Google ont présenté la self-attention dans leur article « Attention Is All You Need ».

Aujourd'hui, la self-attention a révolutionné la façon dont l'IA comprend le langage, les images et même les séquences d'ADN. Elle est au cœur de GPT, de BERT et de pratiquement toutes les avancées majeures du traitement du langage naturel.
Pour les entreprises modernes, cela signifie une IA qui saisit vraiment le contexte, perçoit les nuances et produit des réponses proches de celles d'un humain. C'est pourquoi les bots de service client sont soudain devenus intelligents, et pourquoi l'IA sait désormais rédiger des textes marketing cohérents.
Comment fonctionne réellement la self-attention
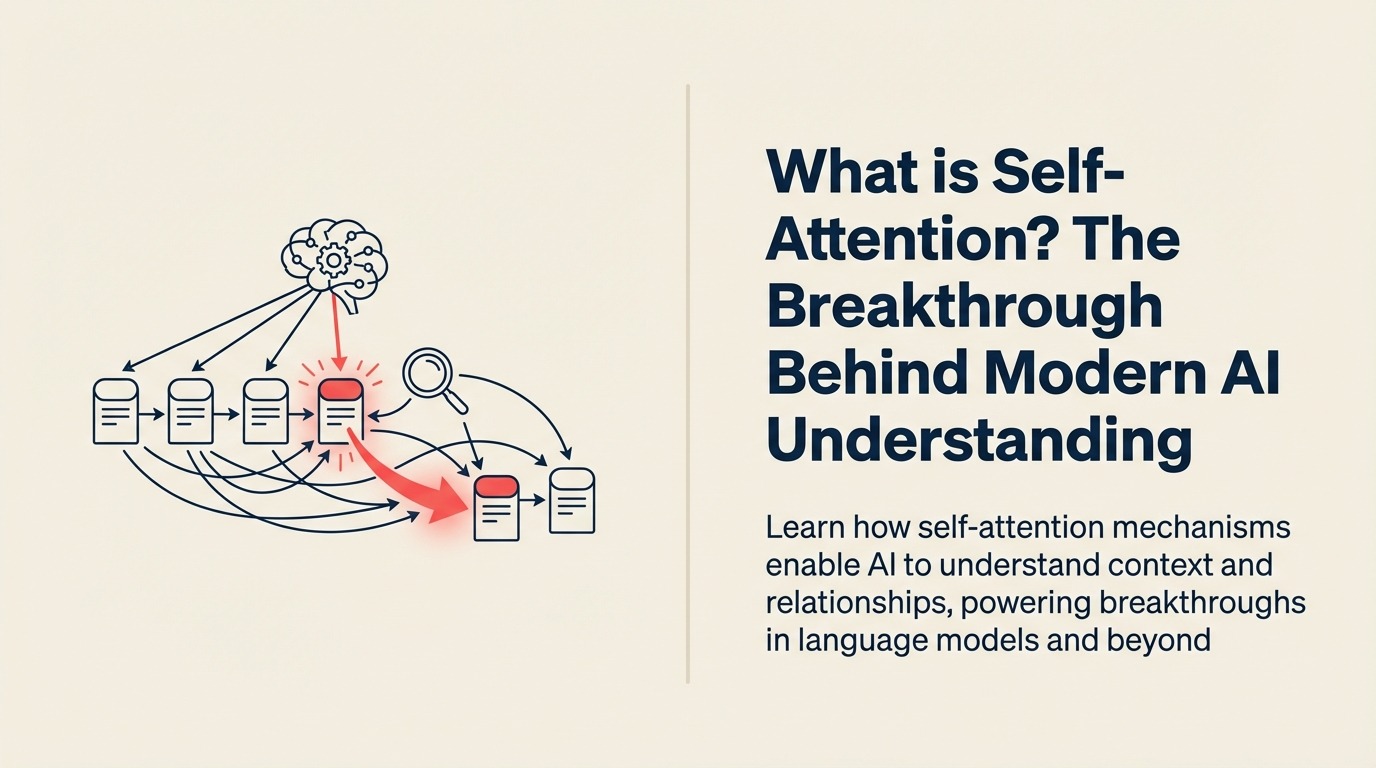
La self-attention repose sur un processus d'une grande simplicité. D'abord, elle examine simultanément chaque mot (ou token) de votre texte, et non l'un après l'autre. C'est comme avoir des yeux capables de se concentrer sur plusieurs choses à la fois.

Ensuite, pour chaque mot, elle calcule l'attention à accorder à tous les autres mots. En traitant « The cat sat on the mat », elle sait que « cat » doit beaucoup regarder « sat » (que faisait le chat ?) et « mat » (où s'est-il assis ?).
Enfin, elle crée des représentations enrichies, où chaque mot contient des informations sur ses relations avec tous les autres. « Bank » sait alors s'il se trouve près de « river » ou de « money ».
La magie vient d'opérations mathématiques qui évaluent ces relations et produisent une carte d'attention, laquelle capte un sens qui dépasse celui des mots pris isolément.
L'impact de la self-attention sur l'activité
Une révolution pour le service client Avant la self-attention : « I can't log in to my account » recevait des instructions génériques de réinitialisation du mot de passe. Après la self-attention : l'IA comprend tout le contexte, pose les bonnes questions de suivi et propose des solutions précises. Les taux de résolution ont progressé de 45 %.
Génération de contenu Les équipes marketing utilisent désormais des outils reposant sur la self-attention pour créer des contenus adaptés au contexte. Une agence produit 10 fois plus de campagnes d'e-mails personnalisées, avec un meilleur engagement qu'en rédaction manuelle.
Analyse de documents Des cabinets juridiques utilisent des modèles de self-attention pour examiner des contrats. L'IA comprend les relations entre les clauses et repère des problèmes que des relecteurs humains manquent. Le temps de relecture baisse de 70 % et la précision augmente de 25 %.
Compréhension du code Les plateformes de développement s'appuient sur la self-attention pour saisir l'intention du programmeur. Les suggestions d'autocomplétion tiennent maintenant compte du contexte, ce qui améliore la productivité des développeurs de 40 %.
Les types de mécanismes d'attention
Single-Head Attention (attention à une seule tête) Comme un projecteur braqué sur un seul aspect des relations. Efficace pour des tâches simples, mais la perspective reste limitée.
Multi-Head Attention (attention multi-têtes) Plusieurs projecteurs examinent en même temps différents types de relations. Une tête peut se concentrer sur la grammaire, une autre sur le sens, une autre sur le style. C'est ce qu'utilisent la plupart des réseaux de neurones modernes.
Cross-Attention (attention croisée) Elle met en relation deux séquences différentes, par exemple des questions et des réponses ou des images et leurs légendes. Indispensable pour l'IA multimodale.
Causal (Masked) Attention (attention causale) Elle ne regarde qu'en arrière, jamais en avant. Utilisée dans la génération de texte pour éviter de « tricher » en voyant les mots suivants.
La self-attention en action
Traduction Autrefois : « The spirit is willing but the flesh is weak » devenait « The vodka is good but the meat is rotten » (un véritable échec des premières traductions automatiques). Avec la self-attention : le contexte est parfaitement compris, la traduction atteint un niveau professionnel et les nuances sont préservées.
Compréhension des recherches Requête : « Apple stock performance not the fruit » La self-attention comprend que « not the fruit » qualifie « Apple » et ne renvoie que des résultats financiers. La pertinence des recherches a progressé de 60 %.
Analyse de sentiment « I don't think this product is not worth avoiding. » La self-attention démêle la double négation et comprend qu'il s'agit en fait d'une recommandation. Précision de l'analyse de sentiment : 94 %.
Pourquoi la self-attention surpasse les méthodes traditionnelles
Traitement parallèle Les modèles traditionnels traitent le texte de façon séquentielle, mot après mot. La self-attention traite tous les mots simultanément. Résultat : un entraînement 100 fois plus rapide.
Dépendances à longue portée Elle peut relier des concepts liés mais séparés par des centaines de mots. Les modèles traditionnels oublient, alors que la self-attention retient tout.
Efficacité de calcul Même si elle traite davantage de relations, les implémentations modernes sont très optimisées. On obtient de meilleurs résultats pour un coût de calcul raisonnable.
Transfer learning Les modèles entraînés avec la self-attention transfèrent mieux leurs connaissances vers de nouvelles tâches. On entraîne une fois, on applique partout.
Mettre en œuvre la self-attention dans votre entreprise
Option 1 : utiliser des modèles pré-entraînés Exploitez des modèles comme GPT ou BERT, qui intègrent déjà la self-attention. C'est le chemin le plus rapide vers la valeur.
- API OpenAI : 0,002 à 0,03 $ pour 1 000 tokens
- Modèles Hugging Face : de gratuit à 20 $ de l'heure
- Google Cloud AI : paiement à l'usage
Option 2 : affiner (fine-tuning) des modèles existants Reprenez des modèles pré-entraînés et adaptez-les à vos besoins. C'est le meilleur équilibre entre personnalisation et efficacité.
- Prérequis : 1 000 à 10 000 exemples
- Durée : 1 à 2 semaines
- Coût : 500 à 5 000 $ de puissance de calcul
Option 3 : construire des modèles sur mesure Uniquement pour des besoins spécifiques que les modèles existants ne couvrent pas. Cela exige une expertise et des ressources importantes.
- Équipe : ingénieurs ML nécessaires
- Durée : 3 à 6 mois
- Coût : 50 000 à plus de 500 000 $
Idées reçues
« C'est trop complexe pour un usage professionnel » En réalité : inutile de comprendre les mathématiques. Les modèles prêts à l'emploi et les API rendent la self-attention accessible à tout développeur.
« Cela demande une puissance de calcul énorme » En réalité : l'inférence (l'utilisation des modèles) est légère. L'entraînement coûte cher, mais il est rare de devoir partir de zéro.
« C'est réservé au langage » En réalité : la self-attention fonctionne pour toute donnée séquentielle ou relationnelle. Les images avec la vision par ordinateur, les séries temporelles, les graphes : tous en profitent.
Le côté technique (version simplifiée)
Voici ce qui rend la self-attention spéciale, sans avoir besoin d'un doctorat :
Le système Query-Key-Value
- Query : « Que suis-je en train de chercher ? »
- Key : « Quelles informations ai-je ? »
- Value : « Que dois-je retenir ? »
C'est un peu comme un système de classement intelligent qui sait exactement quoi récupérer en fonction du contexte.
Scores d'attention Une similarité mathématique entre les mots. Score élevé : on y prête attention. Score faible : on l'ignore. Il est calculé pour chaque paire de mots.
Encodage positionnel Il ajoute l'information sur l'ordre des mots. Le modèle sait que « dog bites man » diffère de « man bites dog », même en traitant tous les mots en même temps.
Exemples concrets de mise en œuvre
Recherche e-commerce Avant : correspondance par mots-clés. « Blue running shoes » ne trouvait pas « azure athletic footwear ». Après : la self-attention permet une recherche sémantique qui comprend le sens. 35 % de résultats pertinents en plus.
Classification des e-mails clients Avant : routage par règles. 65 % de précision. Après : un modèle de self-attention comprend le contexte et l'intention. Routage exact à 92 %.
Analyse de rapports financiers Avant : lecture manuelle des conférences de résultats. Des jours de travail. Après : la self-attention extrait les points clés, le sentiment et les perspectives annoncées. Quelques minutes, au lieu de plusieurs jours.
Votre stratégie de self-attention
Voilà donc la self-attention en quelques mots. C'est plus clair maintenant, non ?

Vous voudrez ensuite comprendre l'architecture transformer, le cadre complet construit sur la self-attention. Notre guide sur les grands modèles de langage montre en outre comment la self-attention passe à l'échelle pour faire fonctionner ChatGPT et les systèmes similaires.
Questions fréquentes sur la self-attention
Qu'est-ce que la self-attention ?
La self-attention est un mécanisme d'IA qui permet aux modèles de comprendre le contexte et les relations en examinant comment chaque mot se rapporte à tous les autres dans une séquence, simultanément, plutôt que de les traiter un par un.
Quelle est la différence entre la self-attention et le traitement de texte traditionnel par l'IA ?
Les modèles traditionnels lisent le texte de manière séquentielle (mot après mot) et oublient souvent le contexte précédent. La self-attention traite tous les mots en même temps et conserve les relations entre toutes les parties du texte, ce qui améliore la compréhension.
Quels sont les principaux types de mécanismes d'attention ?
La Single-Head Attention (se concentre sur un seul aspect), la Multi-Head Attention (examine plusieurs types de relations en même temps), la Cross-Attention (relie deux séquences différentes) et la Causal Attention (ne regarde qu'en arrière pour la génération de texte).
Comment la self-attention fonctionne-t-elle en pratique ?
Elle utilise un système Query-Key-Value dans lequel chaque mot se demande « Que suis-je en train de chercher ? » (Query), « Quelles informations ai-je ? » (Key) et « Que dois-je retenir ? » (Value), puis calcule des scores d'attention entre toutes les paires de mots.
Pourquoi la self-attention est-elle importante pour l'IA moderne ?
Elle permet le traitement parallèle (un entraînement 100 fois plus rapide), gère les dépendances à longue portée, favorise un meilleur transfer learning et sert de base à des modèles majeurs comme GPT, BERT et ChatGPT, qui comprennent réellement le contexte et les nuances.
Ressources externes
Explorez des recherches et de la documentation de référence sur la self-attention :
- L'article « Attention Is All You Need » de Google - L'article fondateur de 2017 qui a introduit l'architecture transformer
- The Illustrated Transformer - Un guide visuel pour comprendre la self-attention et les transformers
- Stanford CS224N: NLP with Deep Learning - Un cours complet sur les mécanismes d'attention
Pour aller plus loin
Explorez des concepts d'IA connexes pour approfondir votre compréhension :
- Attention Mechanism - La famille plus large de techniques qui inclut la self-attention
- Deep Learning - La base qui rend la self-attention possible
- Embeddings - Comment les mots sont représentés avant d'être traités par la self-attention
- Generative AI - Les applications reposant sur les mécanismes de self-attention
Fait partie de la Collection AI Terms. Dernière mise à jour : 2026-07-21

Co-Founder, Rework.com
On this page
- L'histoire de la self-attention
- Comment fonctionne réellement la self-attention
- L'impact de la self-attention sur l'activité
- Les types de mécanismes d'attention
- La self-attention en action
- Pourquoi la self-attention surpasse les méthodes traditionnelles
- Mettre en œuvre la self-attention dans votre entreprise
- Idées reçues
- Le côté technique (version simplifiée)
- Exemples concrets de mise en œuvre
- Votre stratégie de self-attention
- Ressources externes
- Pour aller plus loin