Qu'est-ce que les données synthétiques ? Entraîner l'IA sans compromettre la vie privée
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Tout modèle d'IA a besoin de données pour apprendre. Mais que faire si vos données les plus précieuses sont verrouillées par la réglementation sur la vie privée ou par des enjeux de concurrence, ou si elles n'existent tout simplement pas encore ? Les données synthétiques apportent la réponse : elles permettent aux entreprises d'entraîner des large language models et des systèmes d'IA sans exposer d'informations sensibles sur leurs clients et sans attendre des années pour réunir des exemples réels.
D'une contrainte à un avantage concurrentiel
La génération de données synthétiques est devenue une technologie clé vers 2018, lorsque des réglementations sur la vie privée comme le RGPD ont rendu de plus en plus difficile le partage de données clients réelles pour entraîner l'IA. Ce qui n'était au départ qu'un contournement est devenu un avantage stratégique.
Gartner définit les données synthétiques comme « des informations fabriquées artificiellement plutôt que produites par des événements réels, conçues pour reproduire les motifs, les corrélations et les propriétés statistiques des données réelles, sans contenir la moindre information personnelle réelle ».
Le domaine a pris son essor quand les chercheurs ont constaté que des jeux de données synthétiques soigneusement générés pouvaient entraîner des modèles d'IA aussi efficacement que des données réelles, tout en éliminant les questions de confidentialité, en réduisant les biais et en permettant de couvrir des scénarios qui ne se sont pas encore produits.
Ce que cela change pour les dirigeants
Pour les dirigeants, les données synthétiques permettent d'entraîner des systèmes d'IA sur des scénarios réalistes sans exposer d'informations clients, sans partager de renseignements concurrentiels et sans attendre des années que des événements rares se produisent, ce qui accélère le déploiement de l'IA tout en préservant la conformité et la sécurité.
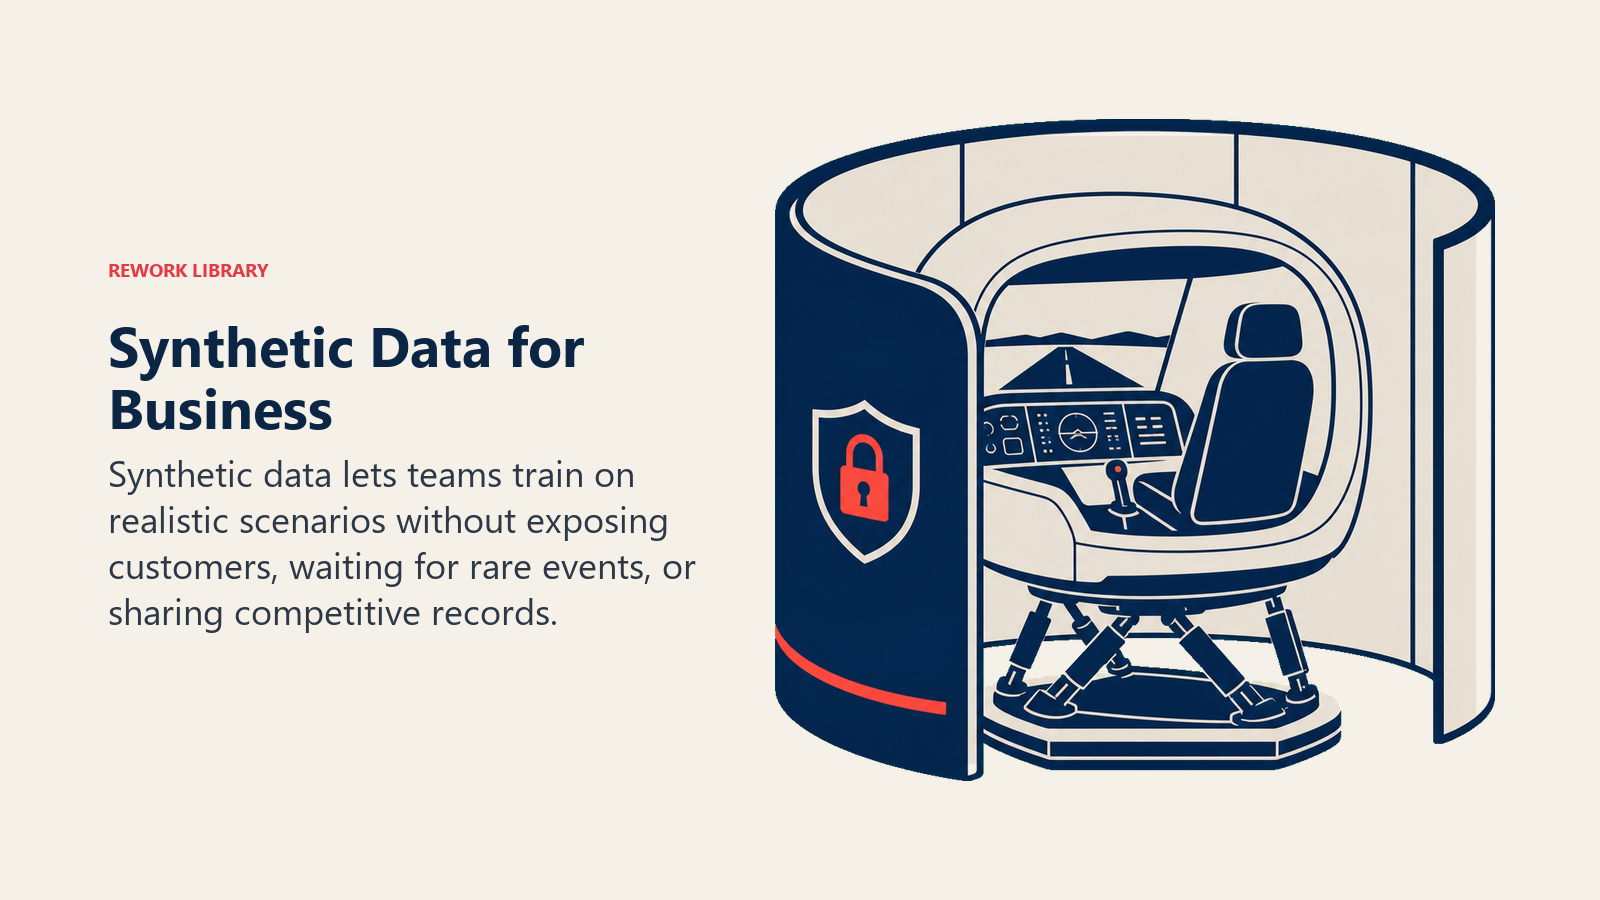
Imaginez un simulateur de vol ultraréaliste qui vous évite de risquer de vrais avions et de vrais pilotes. L'environnement synthétique capture tous les motifs importants et les cas limites, sans aucune conséquence dans le monde réel. Un établissement financier peut ainsi générer des millions de transactions frauduleuses réalistes pour l'entraînement, sans utiliser de données clients réelles.
Concrètement, les données synthétiques vous permettent de construire des systèmes d'IA pour des domaines sensibles comme la santé et la finance, d'enrichir des jeux de données limités avec des scénarios rares et de partager des données d'entraînement avec des partenaires sans risque juridique ni concurrentiel.
Les caractéristiques clés des données synthétiques
Les données synthétiques se distinguent par les caractéristiques essentielles suivantes :
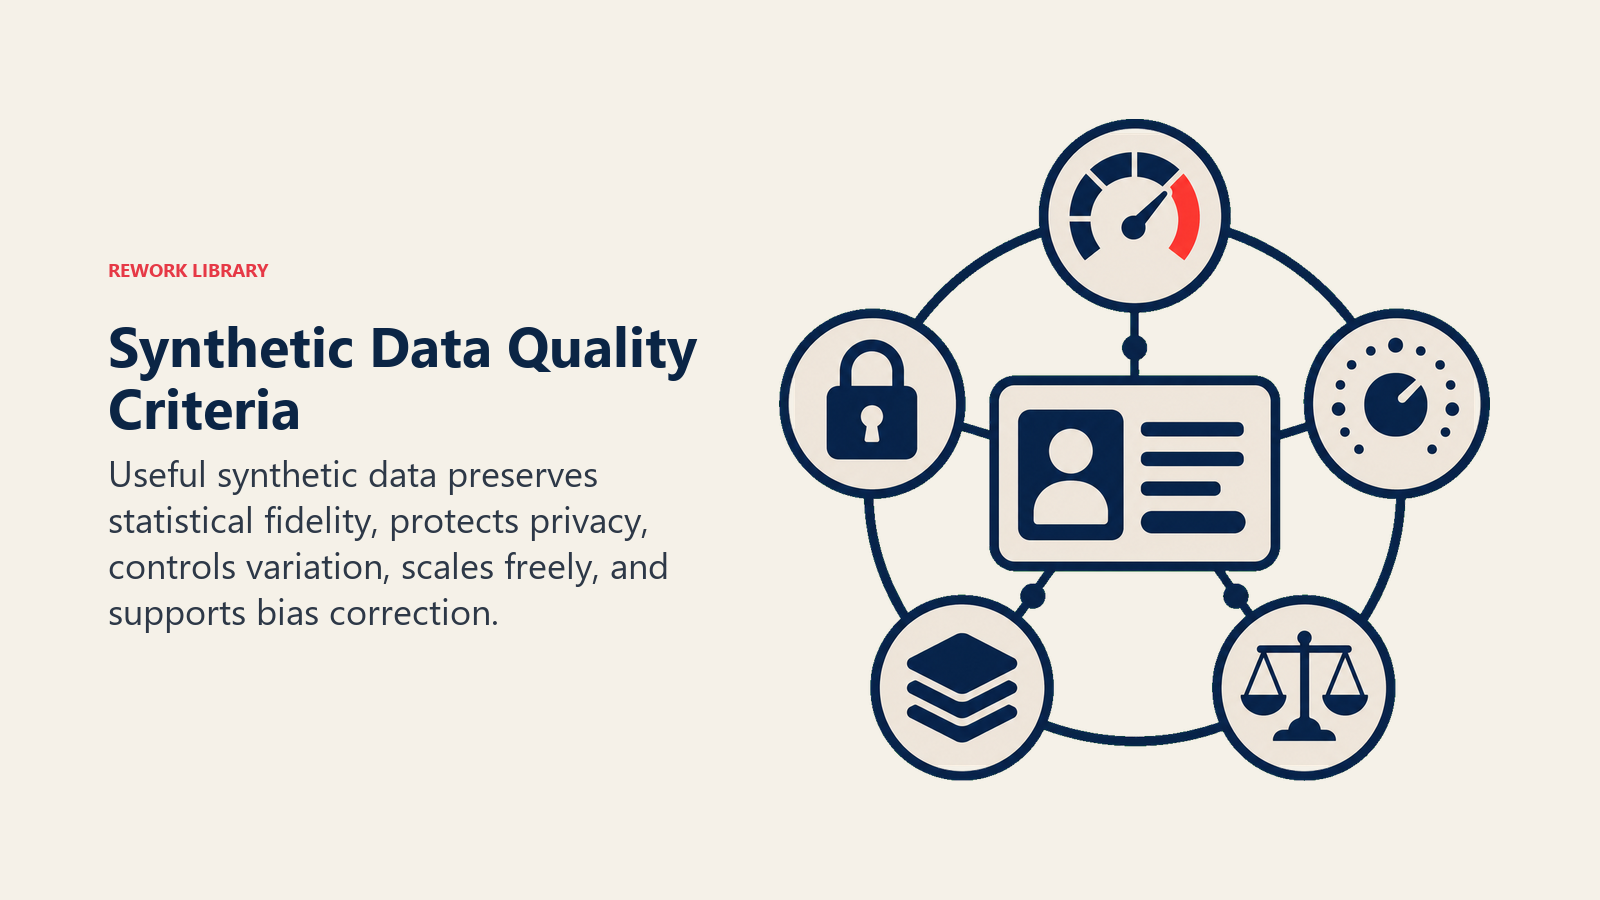
• Fidélité statistique : les données générées conservent les mêmes propriétés statistiques et corrélations que les données réelles, ce qui garantit que les modèles d'IA apprennent les bons motifs
• Protection de la vie privée : elles ne contiennent aucune information personnelle réelle et peuvent donc être partagées, stockées et utilisées sans souci de confidentialité ni restriction réglementaire
• Variation maîtrisée : vous pouvez générer exactement les cas limites et les scénarios dont vous avez besoin, y compris des événements rares qu'il faudrait des années pour collecter naturellement
• Volume illimité : vous créez autant de données d'entraînement que nécessaire, sans le coût, les délais ni les contraintes de confidentialité de la collecte de données réelles
• Maîtrise des biais : vous équilibrez volontairement les jeux de données pour réduire les biais ou créer des échantillons représentatifs que la collecte réelle risquerait de manquer
Comment les données synthétiques sont générées
La création de données synthétiques suit plusieurs approches :
Apprendre les motifs réels : des modèles d'IA analysent des jeux de données existants pour comprendre les relations statistiques, les distributions et les motifs qui rendent les données réalistes
Générer de nouveaux exemples : grâce à des techniques comme l'IA générative, le système crée de nouveaux points de données qui suivent les mêmes motifs mais ne contiennent aucune information réelle
Valider et affiner : les données générées sont testées pour vérifier qu'elles conservent leurs propriétés statistiques et qu'aucun enregistrement individuel ne peut être rattaché à une personne ou à un événement réels
Ce processus transforme des données limitées ou sensibles en ressources d'entraînement illimitées et partageables.
Les types de données synthétiques
Les données synthétiques existent sous plusieurs formes :
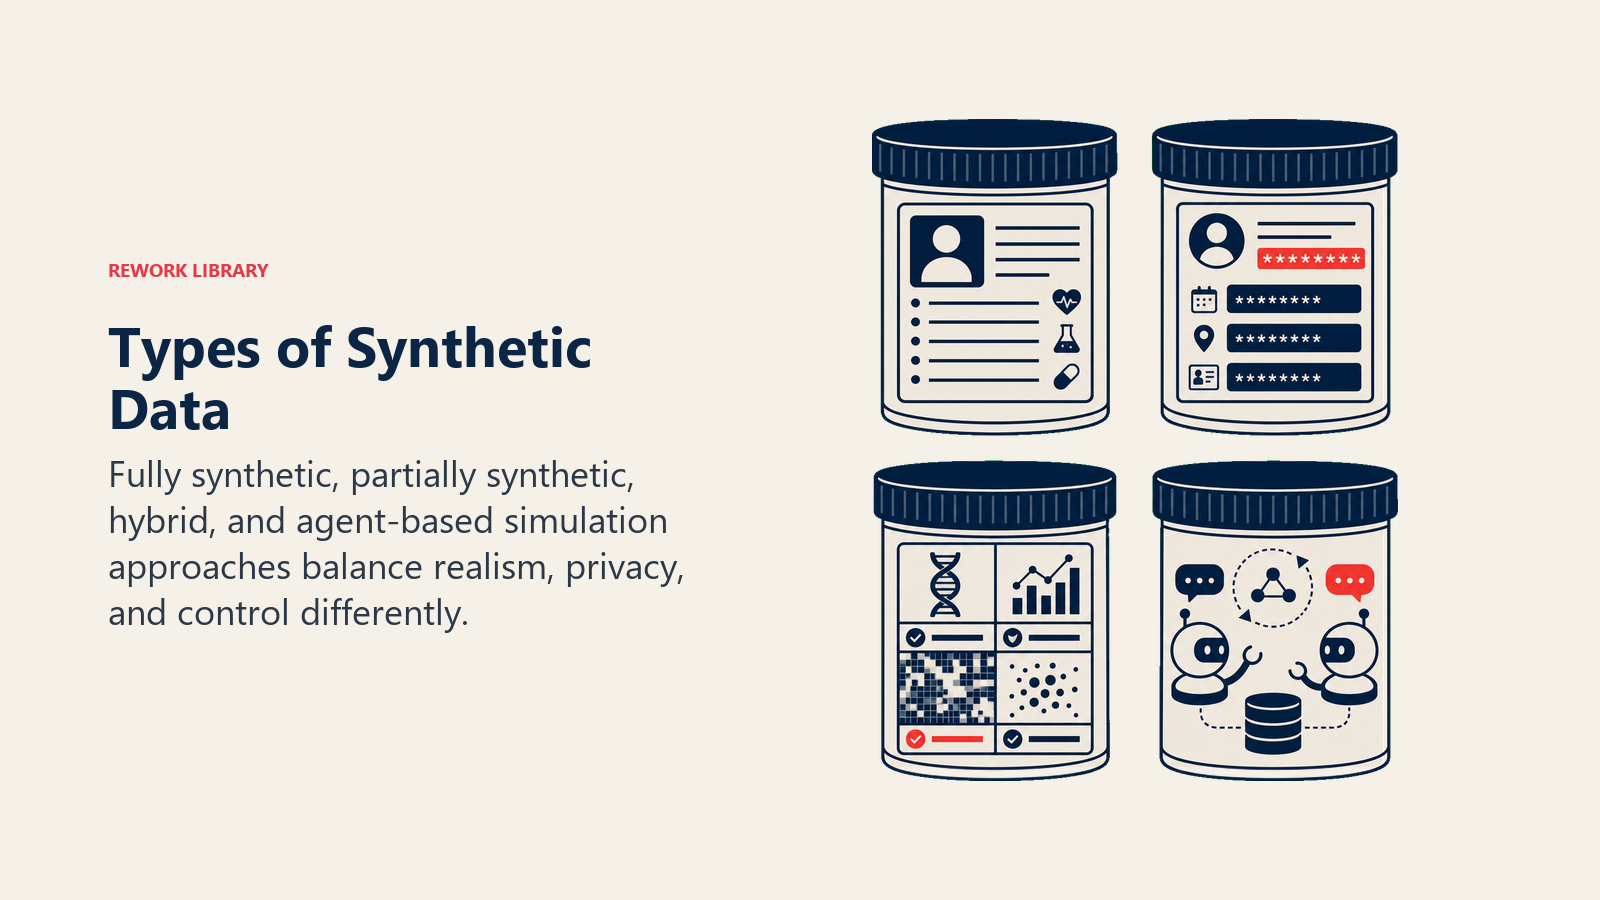
Type 1 : entièrement synthétiques Idéal pour : une protection maximale de la vie privée Caractéristique clé : données entièrement générées, sans aucun point de données réel Exemple : créer toute une base de patients à partir de modèles statistiques, sans utiliser le moindre dossier patient réel
Type 2 : partiellement synthétiques Idéal pour : concilier réalisme et confidentialité Caractéristique clé : données réelles dont les champs sensibles sont remplacés Exemple : conserver les schémas de transactions réels, mais générer des noms de clients et des numéros de compte synthétiques
Type 3 : synthétiques hybrides Idéal pour : les scénarios complexes comportant des événements rares Caractéristique clé : combinaison de données réelles et générées Exemple : enrichir un nombre limité de cas de fraude avec des variantes synthétiques pour entraîner des systèmes de détection
Type 4 : simulation à base d'agents Idéal pour : modéliser des systèmes complexes Caractéristique clé : simulation des interactions et des comportements Exemple : générer des scénarios de chaîne d'approvisionnement en simulant les comportements des fournisseurs, des fabricants et des détaillants
Les données synthétiques en pratique
Voici comment des entreprises utilisent réellement les données synthétiques :
Exemple des services financiers : JPMorgan utilise des données synthétiques pour entraîner ses modèles de détection de fraude. Elle génère des millions de schémas de transactions frauduleuses réalistes sans exposer la moindre information financière de ses clients. Cette approche a amélioré les taux de détection de 30 % tout en garantissant une conformité totale.
Exemple de la santé : la Mayo Clinic génère des dossiers patients synthétiques qui conservent les corrélations médicales et les résultats des traitements sans contenir d'informations réelles sur les patients, ce qui permet de collaborer entre établissements sur la recherche en IA sans violer la loi HIPAA.
Exemple des véhicules autonomes : Waymo crée des scénarios de conduite synthétiques, y compris des cas limites rares comme des enfants qui courent sur la chaussée ou des obstacles inattendus. Ces événements sont trop dangereux pour être collectés en conduite réelle, mais essentiels à l'entraînement à la sécurité.
Votre parcours vers la maîtrise des données synthétiques
Prêt à exploiter tout le potentiel des données synthétiques ?
- Comprenez les techniques de génération avec l'IA générative
- Explorez les approches qui préservent la confidentialité avec le Federated Learning
- Découvrez l'entraînement des modèles avec le Transfer Learning
Ressources externes
Explorez des ressources de référence sur la génération de données synthétiques :
- Gartner: Synthetic Data Report - Analyse sectorielle et tendances du marché des données synthétiques
- NVIDIA Omniverse - Plateforme de génération de données d'entraînement synthétiques à grande échelle
En savoir plus
Approfondissez votre compréhension des concepts d'IA associés :
- Data Augmentation - Enrichir les jeux de données par des transformations
- Fine-tuning - Personnaliser les modèles d'IA avec vos données
- Adversarial Examples - Comprendre les vulnérabilités de l'IA
- Model Validation - Garantir la qualité et la fiabilité de l'IA
Questions fréquentes sur les données synthétiques
Que sont les données synthétiques ?
Les données synthétiques sont des informations générées artificiellement, qui reproduisent les propriétés statistiques et les motifs des données réelles sans contenir aucun enregistrement réel ni aucune information personnelle.
Les données synthétiques valent-elles les données réelles pour entraîner l'IA ?
Lorsqu'elles sont bien générées, les données synthétiques peuvent être aussi efficaces que les données réelles pour entraîner des modèles d'IA, et souvent supérieures, car elles peuvent inclure des scénarios rares et des cas limites difficiles à collecter naturellement.
Quelle est la différence entre données synthétiques et fausses données ?
Les données synthétiques sont générées de façon systématique pour préserver les motifs et les relations statistiques, ce qui les rend réalistes et utiles à l'entraînement de l'IA. Les fausses données sont aléatoires ou inventées, sans conserver les motifs sous-jacents qui font leur valeur.
Quels sont les principaux avantages des données synthétiques ?
La protection de la vie privée (aucune information personnelle réelle), la conformité réglementaire (partage et usage sans risque), un volume illimité (autant de données que nécessaire) et la maîtrise des scénarios (événements rares et cas limites créés à la demande).
Les données synthétiques remplaceront-elles les données réelles ?
Gartner prévoit que 60 % des données d'entraînement de l'IA seront synthétiques d'ici 2024, mais elles complètent les données réelles plutôt qu'elles ne les remplacent. Les données synthétiques sont générées à partir de motifs appris sur des données réelles, et elles sont plus efficaces lorsque les deux sont utilisées ensemble.
Fait partie de la collection AI Terms. Dernière mise à jour : 2026-02-09

Co-Founder, Rework.com
On this page
- D'une contrainte à un avantage concurrentiel
- Ce que cela change pour les dirigeants
- Les caractéristiques clés des données synthétiques
- Comment les données synthétiques sont générées
- Les types de données synthétiques
- Les données synthétiques en pratique
- Votre parcours vers la maîtrise des données synthétiques
- Ressources externes
- En savoir plus