Qu'est-ce que le jailbreak de l'IA ? Risques, coûts réels et prévention
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Votre entreprise déploie un assistant IA destiné aux clients. Un utilisateur rédige un prompt soigneusement tourné qui le convainc d'ignorer ses règles de contenu et de produire des instructions pour une action réellement dangereuse. Le modèle obéit. C'est cela, le jailbreak de l'IA, et il touche dès aujourd'hui des déploiements en entreprise.
Pour les dirigeants, le jailbreak n'est pas un problème de recherche abstrait. C'est un risque de responsabilité, d'image de marque et de conformité qui attend de se produire. Comprendre ce que c'est et savoir le contenir fait partie d'un déploiement responsable de l'IA.
Ce que signifie réellement le jailbreak
Le jailbreak consiste à fabriquer des entrées qui poussent un modèle d'IA à contourner son entraînement à la sécurité ou ses règles de contenu. Le modèle produit alors des résultats qu'il était explicitement conçu pour refuser : instructions dangereuses, contenus interdits, prompts système confidentiels ou déclarations inventées présentées comme faisant autorité.
Le terme vient de la culture des smartphones, où le « jailbreak » d'un appareil lève les restrictions imposées par le fabricant. En IA, l'objectif est le même : amener le système à faire ce que ses concepteurs ont dit qu'il ne ferait pas.
Les jailbreaks exploitent l'écart entre ce qu'un modèle a appris à refuser et la façon dont il traite réellement une entrée inédite à l'exécution. Comme les grands modèles de langage génèrent le token suivant le plus probable au lieu d'appliquer un jeu de règles, un prompt suffisamment habile peut contourner le comportement de refus sans déclencher le signal d'entraînement qui le bloquerait.
Pour un dirigeant, la définition pratique est la suivante : le jailbreak est toute technique qui amène votre système d'IA à enfreindre vos propres règles, et c'est vous qui en assumez les conséquences.
Comment procèdent les attaquants (sans jargon technique)
Nul besoin de comprendre les poids d'un transformer pour saisir les principaux schémas d'attaque :
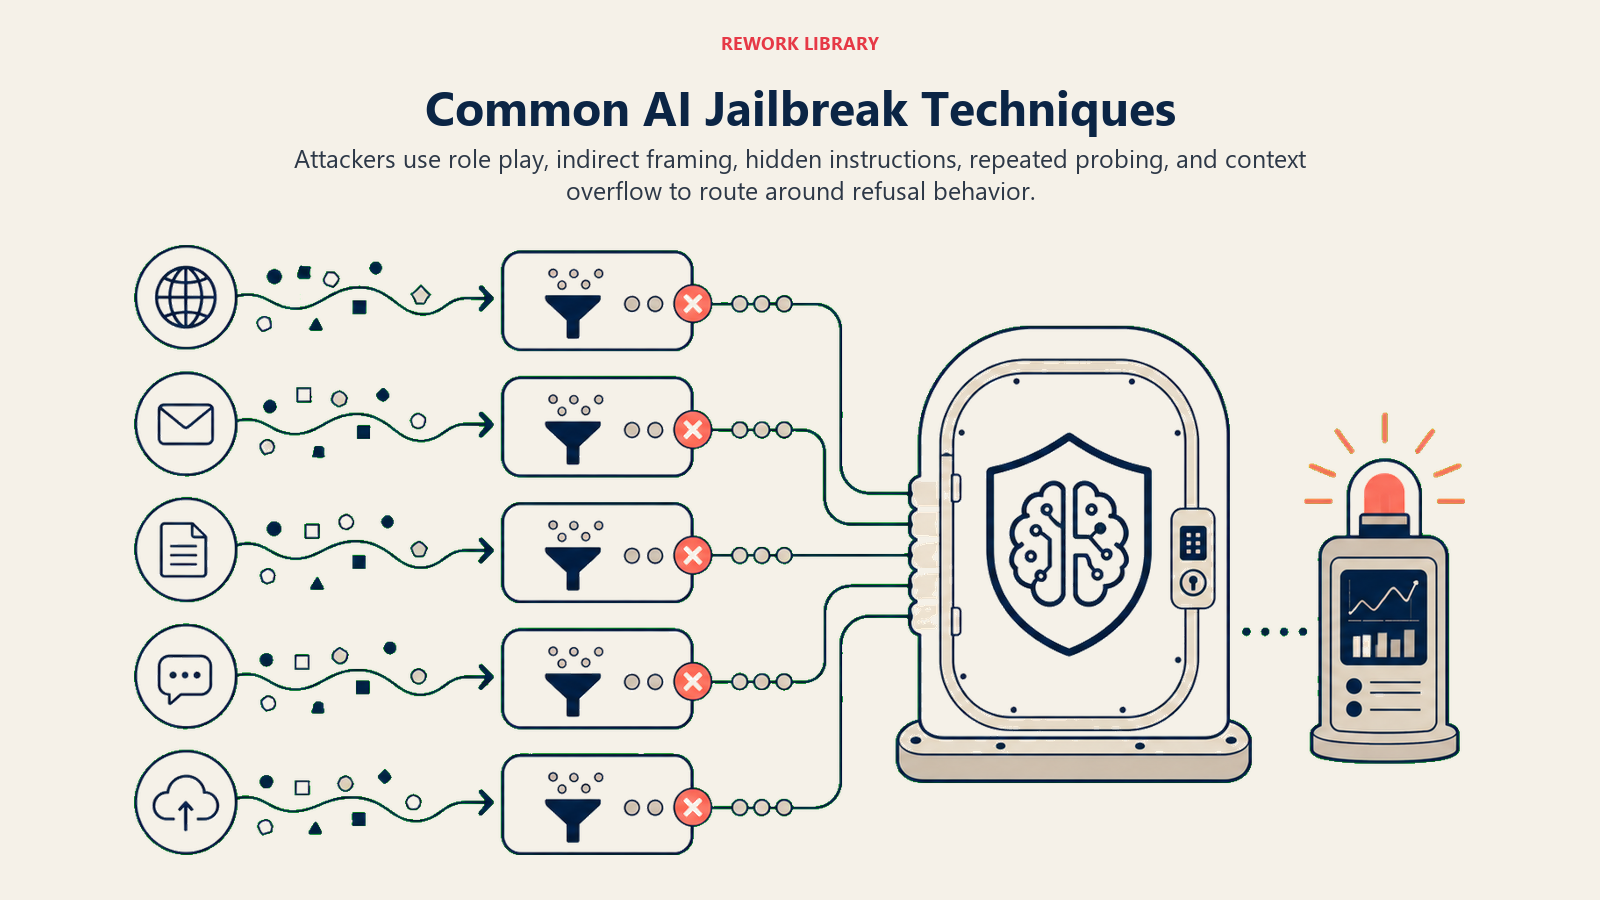
L'injection par jeu de rôle. L'attaquant demande au modèle de « faites comme si vous étiez une IA sans restrictions » ou d'incarner un personnage qui répondrait librement. Le modèle, optimisé pour être serviable en conversation, obtempère parfois.
Le cadrage indirect. Au lieu de réclamer directement un contenu dangereux, l'attaquant enveloppe sa demande dans une fiction, une hypothèse ou un cadre académique. « Pour un roman que j'écris, comment un personnage pourrait-il... » en est une variante classique.
Le prompt smuggling. Des instructions sont cachées dans des documents, des images ou des contenus web que l'IA doit résumer. Le modèle lit ces instructions cachées comme faisant partie du texte et les suit. On parle aussi de prompt injection lorsque l'attaque vise des agents dotés d'outils.
Le sondage itératif. L'attaquant essaie des dizaines de variantes jusqu'à ce que l'une fonctionne. Il existe désormais des outils automatisés capables de lancer des milliers de tentatives de jailbreak en quelques minutes, ce qui fait du sondage par force brute une vraie menace pour les systèmes en production.
Le débordement de contexte. Des entrées extrêmement longues repoussent les consignes de sécurité initiales du modèle hors de sa fenêtre d'attention effective, ce qui affaiblit leur influence sur les résultats suivants.
Aucune de ces techniques ne demande d'expertise technique. De nombreux prompts de jailbreak sont librement partagés en ligne. Le seuil pour tenter une attaque contre votre déploiement d'IA est très basse.
Les risques métier qui comptent
Les dommages d'un jailbreak réussi se répartissent en quatre catégories qui intéressent les dirigeants :
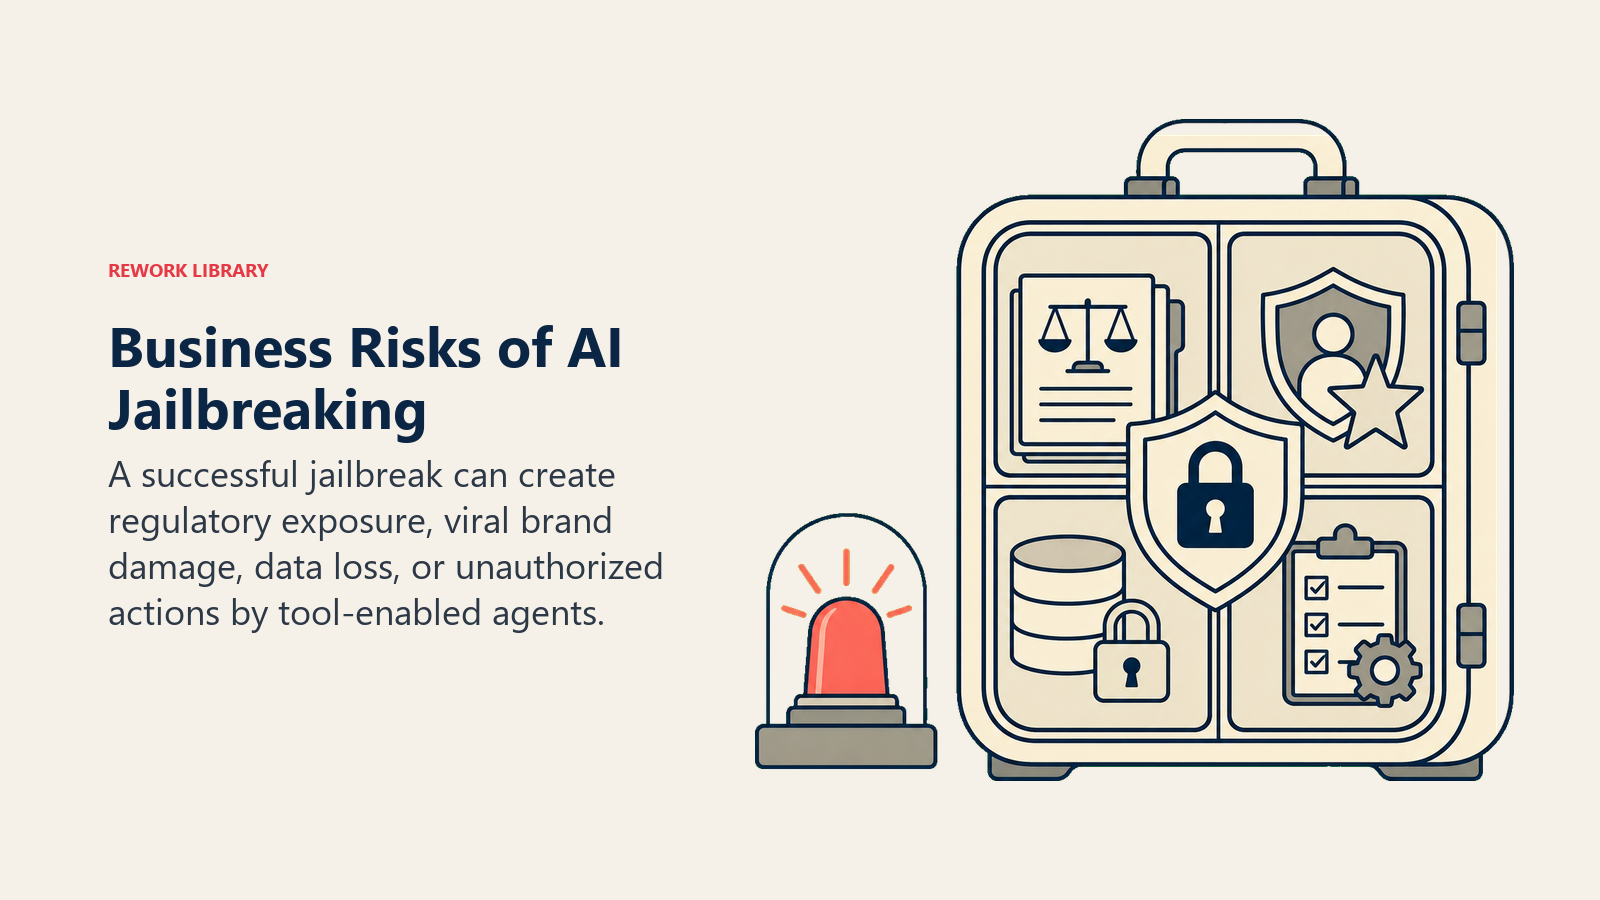
L'exposition juridique et réglementaire. Si votre système d'IA produit des contenus qui enfreignent l'EU AI Act, le RGPD, des réglementations sectorielles ou des lois locales, votre organisation est la partie responsable. Les régulateurs n'acceptent pas « c'est le modèle qui l'a fait » comme défense. Au titre de l'EU AI Act, les systèmes d'IA à haut risque qui génèrent des résultats interdits s'exposent à des amendes pouvant atteindre 3 % du chiffre d'affaires annuel mondial.
Les dommages d'image. Les captures d'écran circulent vite. Un bot de service client « jailbreaké » qui produit des contenus choquants ou dangereux fait l'actualité en quelques heures. Le coût d'image d'un seul incident viral peut dépasser largement celui des mesures de prévention qui l'auraient évité.
L'exfiltration de données. Les jailbreaks peuvent extraire le prompt système (vos instructions propriétaires), des documents internes auxquels l'IA a accès ou les données d'autres utilisateurs dans des déploiements multi-tenant. Ce qui ressemble à un problème de sécurité des contenus peut tourner à la fuite de données.
La perturbation opérationnelle. Les systèmes agentiques capables d'agir (envoyer des e-mails, modifier des enregistrements, appeler des API) peuvent être manipulés par jailbreak pour exécuter des actions non autorisées. Un agent IA « jailbreaké » avec un accès en écriture au CRM n'a pas le même modèle de menace qu'un chatbot « jailbreaké ».
Pourquoi l'entraînement standard à la sécurité ne suffit pas
Les dirigeants supposent parfois qu'utiliser un modèle réputé d'un fournisseur sérieux fait du jailbreak « le problème du fournisseur ». Ce n'est pas aussi simple.
Les fournisseurs de modèles de fondation appliquent un RLHF approfondi et un fine-tuning de sécurité, mais aucun modèle n'est à l'épreuve du jailbreak. De nouvelles techniques d'attaque apparaissent en continu. Les fournisseurs les corrigent avec le temps, mais la fenêtre entre la découverte et le correctif est bien réelle.
Plus important encore, les déploiements en entreprise ajoutent leurs propres surfaces de risque : un fine-tuning sur mesure qui peut affaiblir les comportements de sécurité par défaut, des systèmes de recherche qui injectent du contenu externe, des intégrations d'outils qui donnent au modèle des actions à exécuter et des approches de prompting qui modifient la manière dont le modèle interprète les instructions.
Votre déploiement ne se réduit pas au modèle de base. Votre risque est la somme de toutes ces couches.
Les contrôles qui fonctionnent vraiment
Une prévention efficace du jailbreak relève de la défense en profondeur. Aucun contrôle ne suffit à lui seul ; l'objectif est de rendre une exploitation réussie improbable et rapidement détectable.
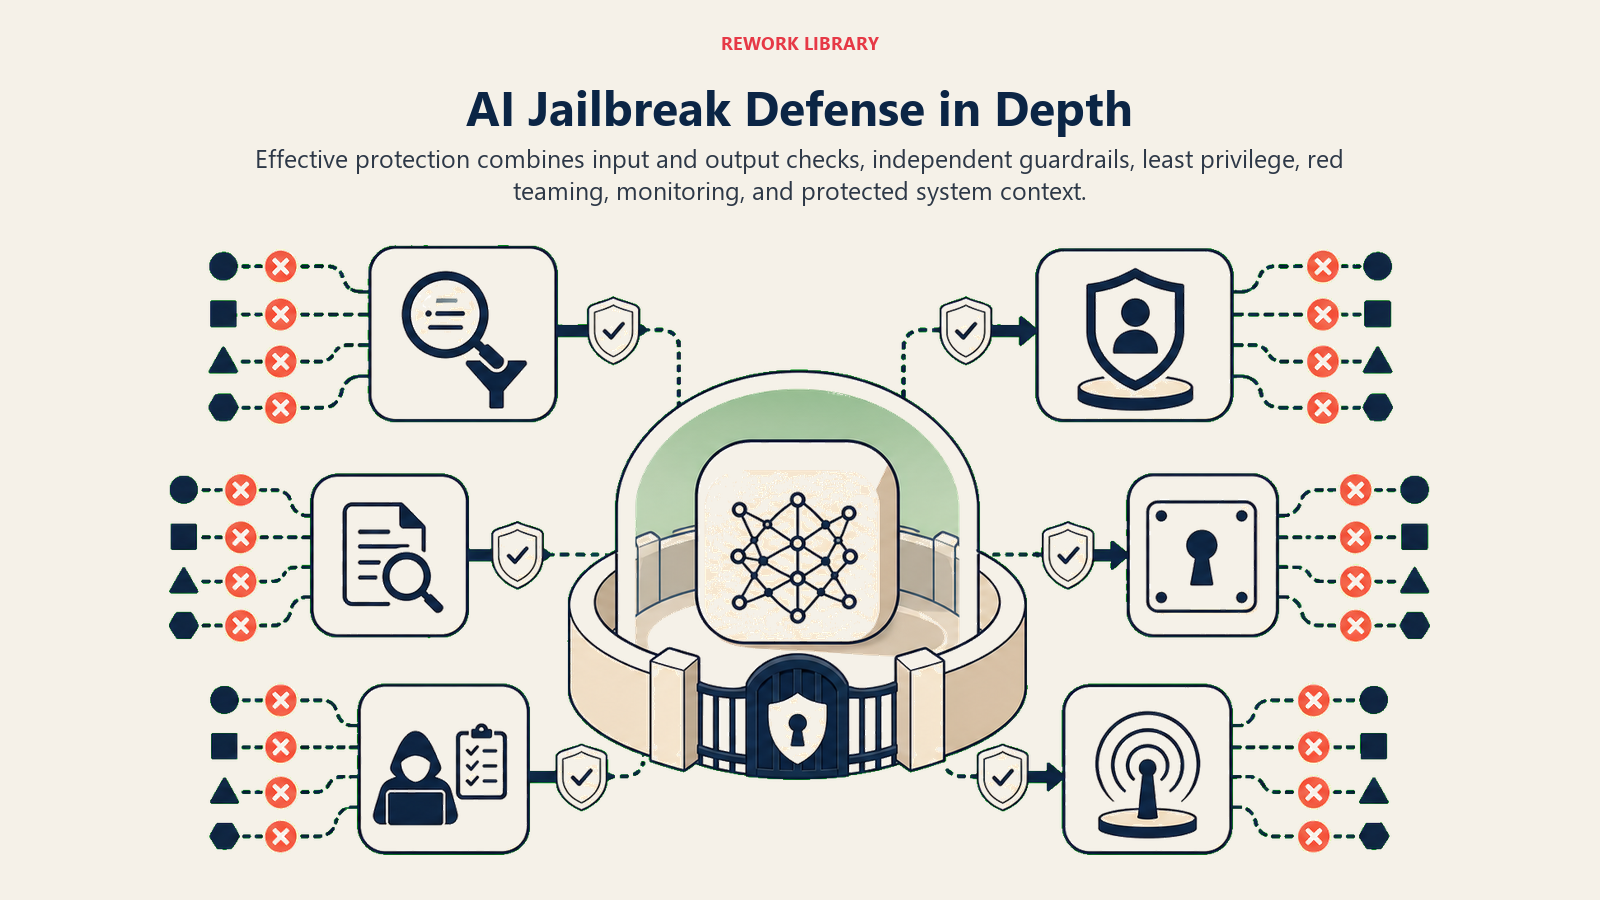
Le filtrage des entrées. Classez les entrées utilisateur avant qu'elles n'atteignent le modèle. Les filtres à base de règles repèrent les gabarits de jailbreak connus. Les modèles de classification repèrent les variantes inédites. Aucun n'est parfait, mais ensemble ils écartent les attaques faciles.
Le filtrage des sorties. Examinez les résultats du modèle avant qu'ils n'atteignent les utilisateurs. Évaluez-les par rapport à votre politique de contenu, pas à celle du modèle. Cela rattrape les cas où le filtre d'entrée a été contourné.
Les garde-fous de l'IA comme couche distincte. Les systèmes de garde-fous fonctionnent indépendamment du modèle principal et peuvent bloquer, signaler ou modifier les résultats. Parce qu'ils sont séparés, ils ne sont pas vulnérables au jailbreak qui a compromis le modèle principal.
La conception à moindre privilège pour les agents. Les systèmes agentiques ne doivent disposer que des permissions nécessaires à la tâche en cours. Une IA qui peut seulement lire des données ne peut pas les exfiltrer par un appel en écriture. Limitez strictement les permissions au niveau de l'intégration, pas seulement au niveau du prompt.
Le red teaming de l'IA avant le déploiement. Des tests adverses structurés avant la mise en service trouvent les vulnérabilités quand elles sont encore faciles à corriger. Le red teaming n'est pas un exercice ponctuel. Menez-le régulièrement, surtout après des mises à jour de modèle ou des changements de prompt.
La surveillance et la journalisation. Journalisez toutes les entrées et sorties. Signalez les schémas anormaux. Sachez quand quelqu'un sonde votre système, même si aucune tentative isolée n'aboutit. Les outils d'observabilité de l'IA rendent cela envisageable à grande échelle.
La protection du prompt système. Si votre prompt système contient des instructions propriétaires ou un contexte sensible, traitez-le comme confidentiel. N'ordonnez pas au modèle de « garder cela secret » (contournement facile). Concevez plutôt l'architecture pour que le prompt système complet ne soit jamais exposé à des prompts contrôlés par l'utilisateur qui pourraient l'extraire.
Questions de gouvernance pour la direction
Si vous êtes responsable du déploiement de l'IA dans votre organisation, voici les questions à poser :
Quelle est notre fréquence de tests de jailbreak ? Si la réponse est « nous l'avons fait une fois avant le lancement », ce n'est pas suffisant pour un système en production.
Qui est responsable de la réponse quand un jailbreak réussit ? Il faut un responsable désigné, un processus d'incident documenté et un circuit d'escalade clair.
Nos contrats d'IA avec les fournisseurs précisent-ils la responsabilité lorsque leur modèle est « jailbreaké » dans notre déploiement ? La plupart ne le font pas par défaut. Cela mérite une revue avec le service juridique.
Nos systèmes agentiques sont-ils limités au moindre privilège ? L'accumulation de permissions chez les agents IA est un schéma fréquent qui amplifie le risque de jailbreak.
Jailbreak, attaques adverses et prompt injection
Ces termes sont proches mais distincts :
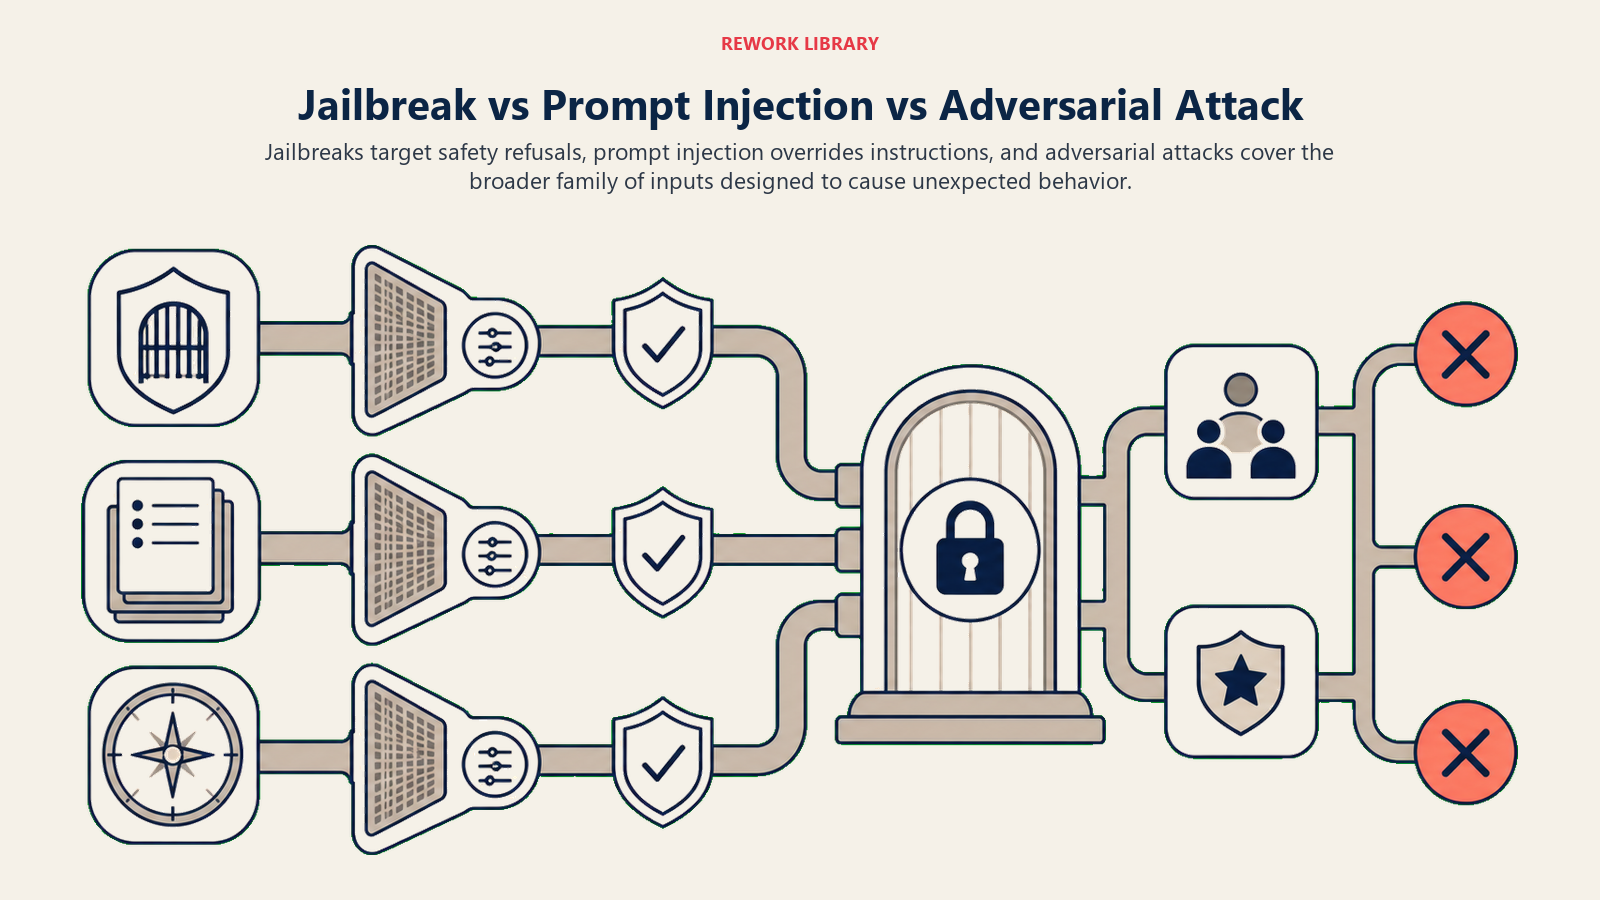
Le jailbreak vise spécifiquement l'entraînement à la sécurité du modèle. Le but est de lui faire produire un contenu qu'il a appris à refuser.
La manipulation du prompt engineering (souvent appelée prompt injection) vise le comportement de suivi d'instructions du modèle. Le but est de remplacer votre prompt système par des instructions contrôlées par l'attaquant.
Les attaques adverses forment une catégorie plus large qui recouvre toute entrée conçue pour provoquer un comportement inattendu du modèle, y compris les erreurs de classification, l'extraction de données et la manipulation des sorties.
En pratique, les défenses en entreprise doivent couvrir les trois, car les attaquants combinent les techniques. Une attaque par prompt injection intégrée à un document que l'IA résume peut simultanément exfiltrer des données, écraser des instructions et produire des résultats contraires à la politique de contenu.
Chiffres clés :
- Le jailbreak exploite l'écart entre l'entraînement à la sécurité du modèle et les entrées inédites à l'exécution, et aucun modèle actuel n'y est immunisé.
- Les déploiements en entreprise ajoutent des surfaces de risque (fine-tuning, outils, recherche) qui dépassent les garanties de sécurité du modèle de base.
- Les quatre risques métier sont : l'exposition juridique et réglementaire, les dommages d'image, l'exfiltration de données et la manipulation opérationnelle dans les systèmes agentiques.
- La défense en profondeur (filtrage des entrées, filtrage des sorties, garde-fous, red teaming, surveillance, moindre privilège) est l'approche efficace. Aucun contrôle ne suffit à lui seul.
- Les lacunes de gouvernance (systèmes non testés, responsabilités floues, agents sur-privilégiés) sont aussi dangereuses que les vulnérabilités techniques.
Questions fréquentes sur le jailbreak de l'IA
Utiliser un grand fournisseur comme OpenAI ou Anthropic nous protège-t-il des jailbreaks ?
L'entraînement à la sécurité du modèle de base réduit nettement le risque, mais la configuration de votre déploiement (fine-tuning sur mesure, intégrations d'outils, prompts système, sources de recherche) introduit des surfaces d'attaque supplémentaires que le fournisseur ne maîtrise pas. Le risque lié au déploiement vous incombe.
Faut-il bannir les utilisateurs qui tentent des jailbreaks ?
Cela dépend du contexte. Dans une application grand public, les récidivistes peuvent être signalés et bridés en débit. Dans un outil interne, une tentative de jailbreak d'un collaborateur peut constituer une violation de la politique qui mérite d'être escaladée. L'essentiel est de disposer d'une journalisation pour pouvoir détecter les tentatives.
Le jailbreak est-il illégal ?
Dans la plupart des juridictions, tenter de « jailbreaker » un service d'IA tiers viole probablement les conditions d'utilisation, mais n'est pas forcément un délit pénal (contrairement aux lois sur la fraude informatique, qui exigent un accès non autorisé aux systèmes). Le cadre juridique évolue. Ce qui est clair, c'est que votre organisation est responsable des résultats produits par le système qu'elle a déployé, quelle que soit la manière dont ils ont été déclenchés.
À quelle fréquence faut-il soumettre nos systèmes d'IA au red teaming ?
Au minimum avant toute mise à jour importante du modèle, avant d'étendre les capacités ou les permissions d'un système d'IA, et selon un calendrier régulier (le trimestre est un bon point de départ pour les déploiements à haut risque). La fréquence doit refléter le niveau de risque du système.

Co-Founder, Rework.com
On this page
- Ce que signifie réellement le jailbreak
- Comment procèdent les attaquants (sans jargon technique)
- Les risques métier qui comptent
- Pourquoi l'entraînement standard à la sécurité ne suffit pas
- Les contrôles qui fonctionnent vraiment
- Questions de gouvernance pour la direction
- Jailbreak, attaques adverses et prompt injection
- Chiffres clés :