Qu'est-ce que le RLHF ? Apprendre à l'IA ce que les humains attendent vraiment
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
ChatGPT n'est pas devenu utile par hasard. Derrière ses réponses polies et pertinentes se cache une technique d'entraînement qui pousse l'IA à se soucier de ce que les humains attendent réellement, et pas seulement de ce qui est techniquement exact. Cette technique, c'est le RLHF, et c'est elle qui explique pourquoi l'IA actuelle paraît si différente des versions précédentes.
La percée qui a changé l'IA
Le Reinforcement Learning from Human Feedback est né de travaux d'OpenAI en 2017, mais il s'est imposé auprès du grand public en 2022, lorsqu'il a propulsé ChatGPT. Cette technique a résolu un problème crucial : rendre l'IA non seulement intelligente, mais réellement utile.
Selon les recherches d'OpenAI, le RLHF est « une technique de machine learning qui entraîne les modèles d'IA à se comporter selon les préférences humaines en apprenant à partir de retours comparatifs, et qui optimise les réponses que les humains jugent réellement utiles plutôt que simplement probables sur le plan statistique ».
Le déclic est venu quand les chercheurs ont compris que prédire le mot suivant (l'entraînement classique des modèles de langage) ne conduit pas naturellement à un comportement utile. Il faut enseigner explicitement à l'IA ce que les humains considèrent comme une bonne réponse, et le RLHF a apporté la pièce manquante.
Le RLHF pour les dirigeants
Pour les dirigeants, le RLHF est le processus d'entraînement qui transforme une IA brute en outil professionnel utile : il lui apprend à être serviable, inoffensive et honnête, plutôt que simplement exacte sur le plan technique ou probable sur le plan statistique.
Pensez à la différence entre un stagiaire qui répond aux questions au pied de la lettre et un autre qui comprend ce dont vous avez vraiment besoin. Le RLHF revient à confier à des milliers de formateurs experts le soin de commenter chaque réponse, jusqu'à ce que l'IA apprenne non seulement ce qui est correct, mais aussi ce qui est réellement utile.
Concrètement, c'est grâce au RLHF que l'IA sait désormais refuser les demandes inappropriées, expliquer clairement des sujets complexes et admettre qu'elle ne sait pas. C'est une évolution de fond par rapport aux approches classiques de machine learning, qui optimisent uniquement la précision.
Les composants essentiels du RLHF
Le RLHF repose sur les éléments suivants :
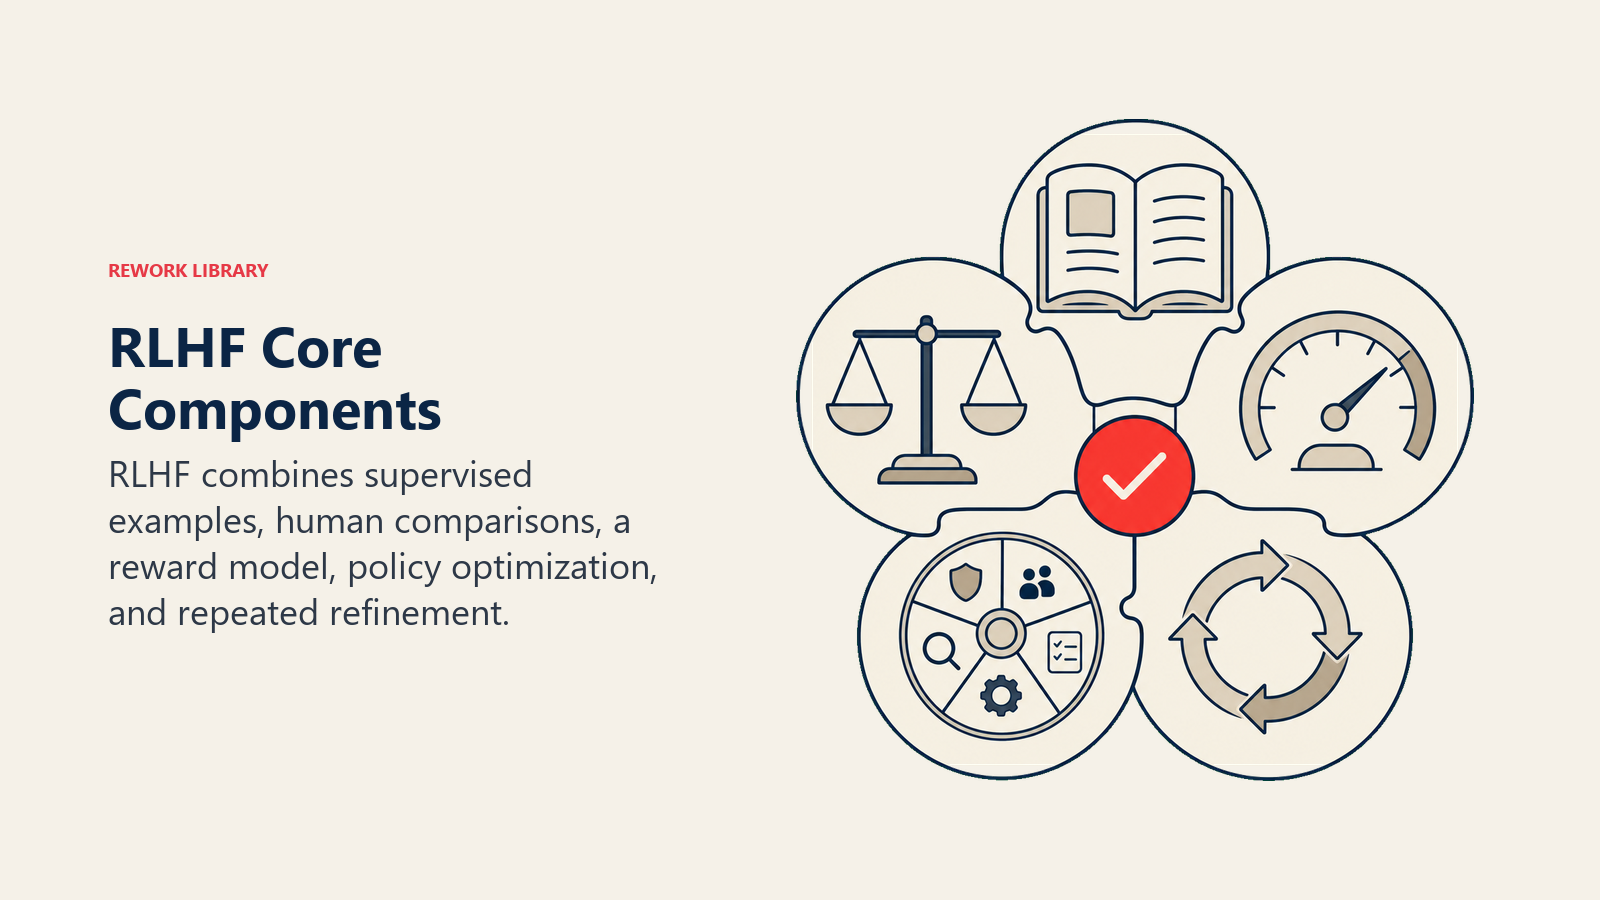
• Supervised Fine-Tuning (SFT) : phase initiale d'entraînement où des humains démontrent les réponses idéales à différents prompts, ce qui donne à l'IA des exemples de sorties de haute qualité dont elle peut s'inspirer
• Modélisation de la récompense : des humains comparent plusieurs réponses de l'IA et indiquent laquelle est la meilleure, ce qui permet d'entraîner un modèle distinct à prédire automatiquement les préférences humaines
• Apprentissage par renforcement : l'IA s'exerce à générer des réponses et reçoit des « récompenses » fondées sur le modèle de préférences, apprenant peu à peu à produire les sorties que les humains préfèrent
• Évaluateurs humains : des équipes de relecteurs qui fournissent les retours comparatifs dont dépend tout le processus, souvent avec des consignes détaillées sur l'utilité, la sécurité et l'exactitude
• Affinage itératif : des cycles continus de retours et d'entraînement qui alignent progressivement le modèle sur les valeurs et les attentes humaines
Comment fonctionne le RLHF
Le processus RLHF se déroule en trois étapes :
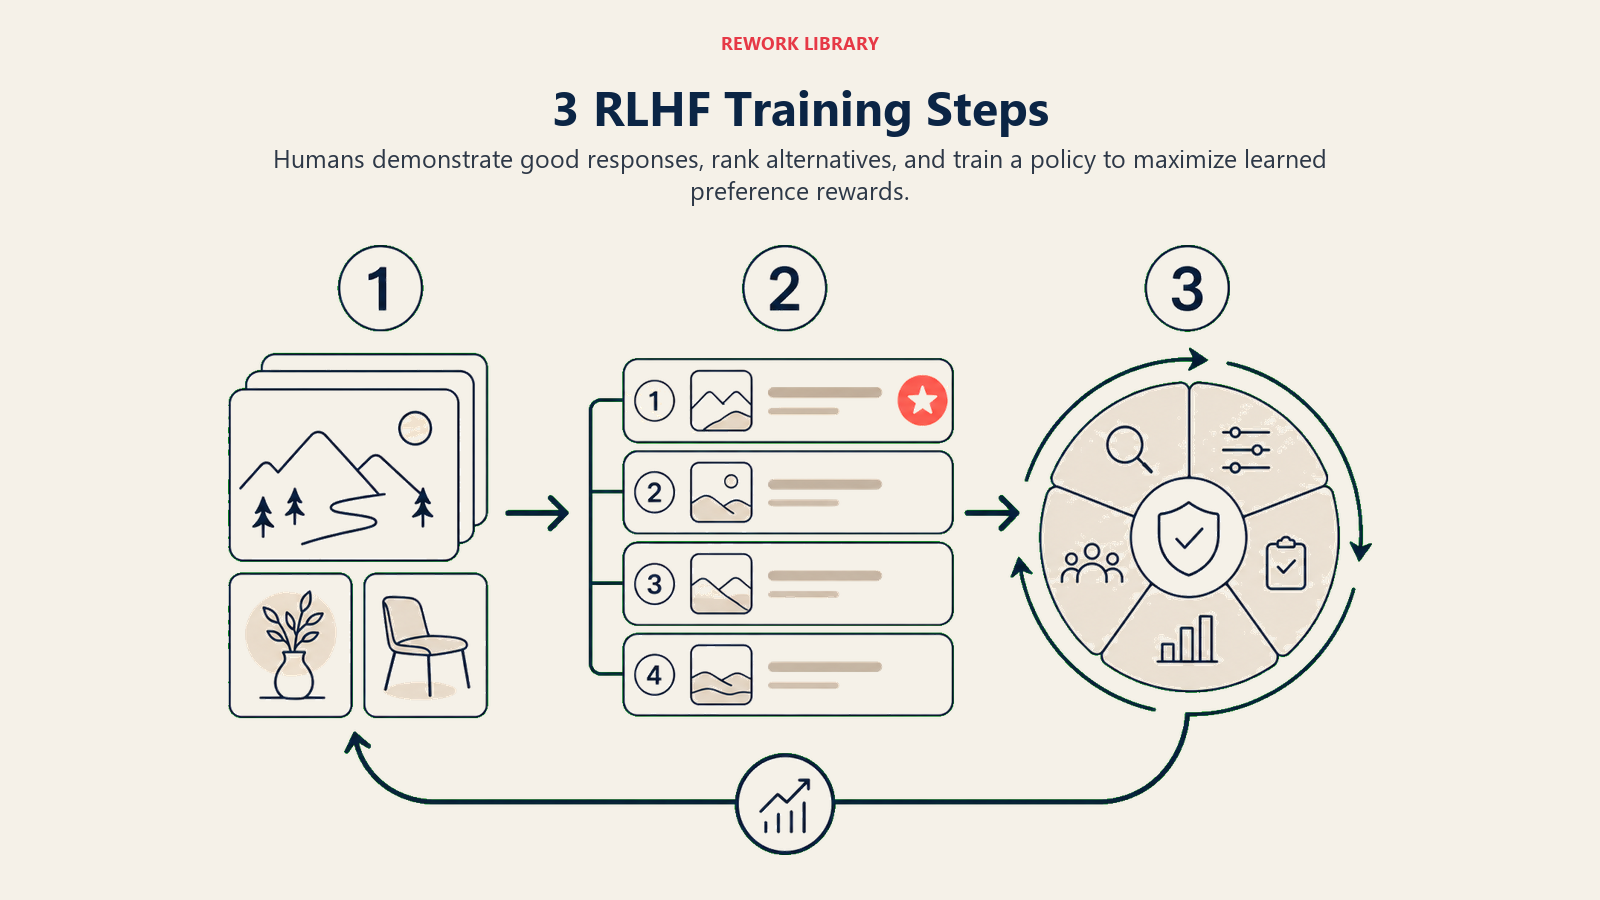
Collecte de démonstrations : des formateurs humains rédigent des exemples de conversations qui montrent comment l'IA doit répondre à diverses requêtes, ce qui pose les bases d'un comportement utile
Apprentissage des préférences : l'IA génère plusieurs réponses à un prompt et des humains les classent de la meilleure à la moins bonne, ce qui apprend au système à distinguer les bonnes sorties des mauvaises
Optimisation de la politique : l'IA apprend une politique, c'est-à-dire une stratégie de génération de réponses, qui maximise l'approbation humaine attendue d'après les préférences apprises, à l'aide d'algorithmes d'apprentissage par renforcement
Ce cycle se répète des milliers de fois, et l'IA intègre peu à peu ce qui rend une réponse utile, sûre et conforme aux intentions humaines.
Les modèles de mise en œuvre du RLHF
Les systèmes RLHF existent en plusieurs variantes :
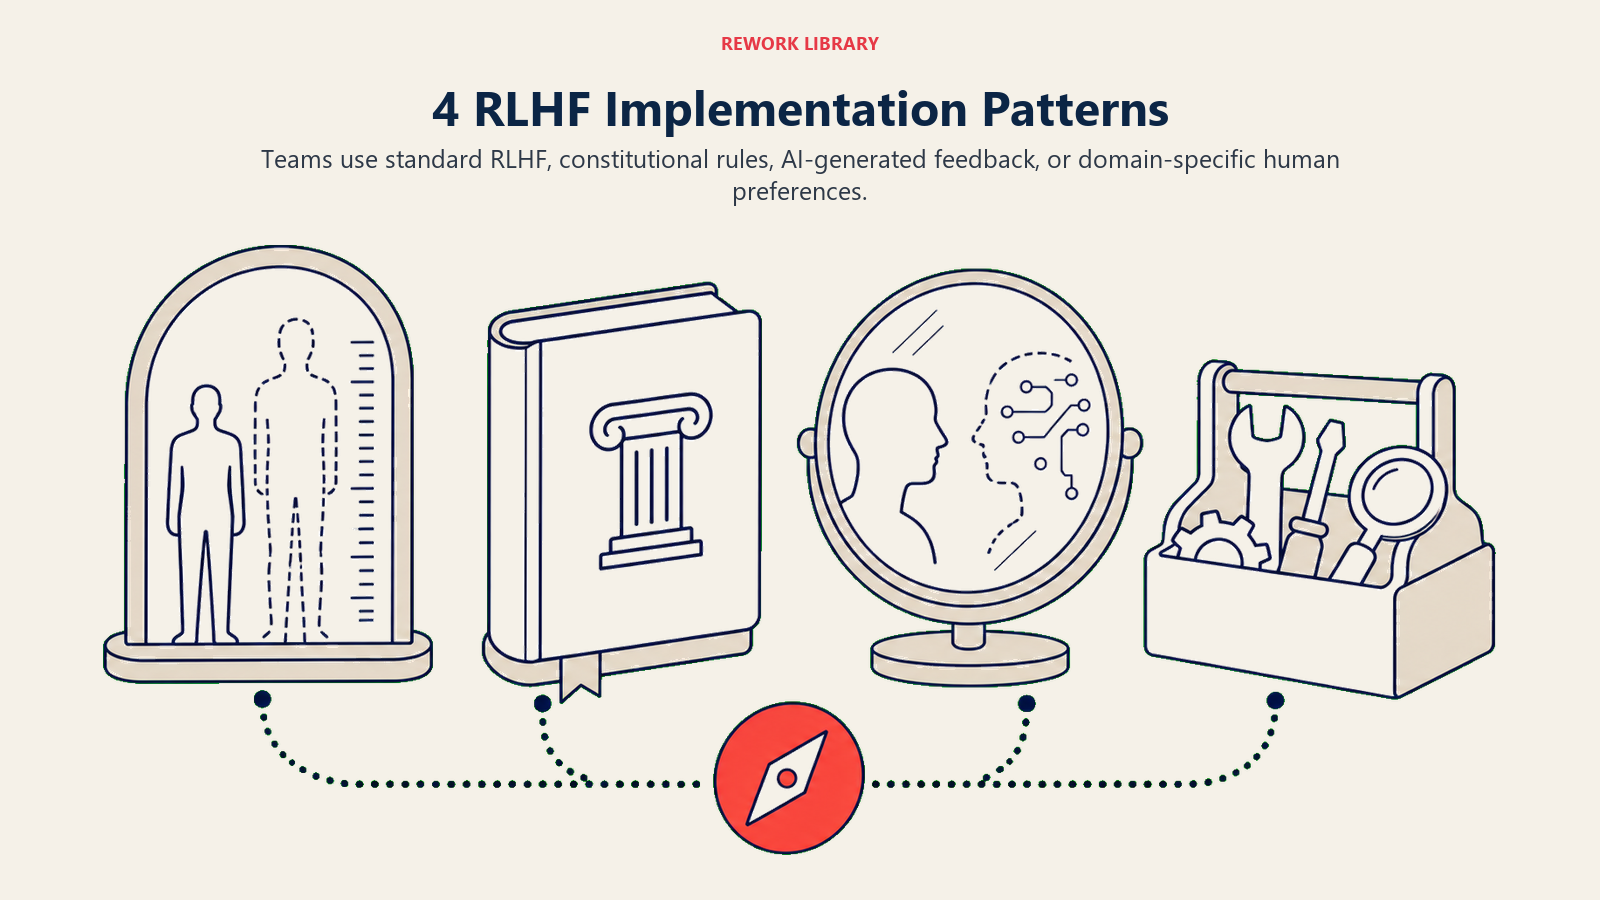
Type 1 : RLHF classique Idéal pour : l'IA conversationnelle généraliste Caractéristique clé : apprentissage standard des préférences à partir de comparaisons Exemple : le comportement d'assistant serviable de ChatGPT
Type 2 : Constitutional AI Idéal pour : les applications où la sécurité est critique Caractéristique clé : entraînement par rapport à des principes et des valeurs explicites (voir AI Alignment) Exemple : Claude d'Anthropic et sa prévention des contenus nuisibles
Type 3 : RLAIF (RL from AI Feedback) Idéal pour : l'apprentissage des préférences à grande échelle Caractéristique clé : utilise l'IA pour générer les étiquettes de préférence Exemple : entraînement automatisé à la sécurité à grande échelle
Type 4 : RLHF spécifique à un domaine Idéal pour : les applications métier spécialisées Caractéristique clé : préférences ajustées aux exigences d'un secteur Exemple : une IA médicale entraînée sur la pertinence clinique
Des exemples concrets de réussite du RLHF
Voici comment le RLHF alimente des applications réelles :
Exemple du service client : Intercom a entraîné son agent IA de service client avec le RLHF à partir des retours de l'équipe support. Résultat : 45 % d'escalades en moins et 90 % de satisfaction client maintenue, l'IA ayant appris les subtilités de la communication attendue.
Exemple de la génération de code : GitHub Copilot s'appuie sur le RLHF pour produire du code que les développeurs utilisent réellement, plutôt que des suggestions techniquement correctes mais peu pratiques : 46 % du code est accepté, contre 26 % sans RLHF.
Exemple de la modération de contenu : GPT-4 d'OpenAI utilise le RLHF pour trancher des décisions complexes de politique de contenu, avec 40 % de faux positifs en moins que les systèmes à base de règles, grâce à une meilleure compréhension des nuances du contexte.
Mettre en œuvre le RLHF
Prêt à aligner votre IA sur les préférences humaines ?
- Comprenez les fondations avec les Large Language Models
- Découvrez les bases de l'apprentissage par renforcement
- Explorez le Prompt Engineering pour guider le modèle
- Envisagez le Fine-Tuning comme approche complémentaire
Questions fréquentes sur le RLHF
Qu'est-ce que le RLHF (Reinforcement Learning from Human Feedback) ?
Le RLHF est une technique de machine learning qui entraîne les modèles d'IA à se comporter selon les préférences humaines en apprenant à partir de retours comparatifs, afin d'optimiser les réponses utiles plutôt que simplement probables sur le plan statistique.
Quelle est la différence entre le RLHF et l'entraînement classique de l'IA ?
L'entraînement classique apprend à l'IA à prédire des schémas dans les données. Le RLHF lui apprend à produire des sorties que les humains préfèrent réellement, ce qui la rend utile et en phase avec les valeurs humaines, et pas seulement exacte.
Quels sont les principaux types d'approches RLHF ?
Le RLHF classique (apprentissage standard des préférences), la Constitutional AI (entraînement fondé sur des principes), le RLAIF (retours générés par l'IA) et le RLHF spécifique à un domaine (préférences ajustées à un secteur).
Quels sont les composants essentiels du RLHF ?
Le supervised fine-tuning (démonstration), la modélisation de la récompense (apprentissage des préférences), l'apprentissage par renforcement (optimisation de la politique), les évaluateurs humains (source des retours) et l'affinage itératif (amélioration continue).
Ressources externes
Explorez des recherches et de la documentation de référence sur le RLHF :
- OpenAI RLHF Research - Recherche fondatrice sur l'apprentissage à partir de retours humains
- Anthropic's Constitutional AI Paper - Approche RLHF avancée fondée sur des retours générés par l'IA
- Hugging Face RLHF Blog - Guide complet pour mettre en œuvre le RLHF en pratique
Ressources associées
Explorez ces concepts connexes pour approfondir votre compréhension du RLHF :
- Apprentissage par renforcement - Le paradigme d'apprentissage sur lequel repose le RLHF
- AI Alignment - L'objectif plus large : faire en sorte que l'IA se comporte comme prévu
- Fine-Tuning - Autre approche pour personnaliser le comportement de l'IA
- Prompt Engineering - Technique complémentaire pour guider les réponses de l'IA
Fait partie de la collection AI Terms. Dernière mise à jour : 2026-02-09
