Qu'est-ce que l'optimisation de l'inférence ? Passer l'IA à l'échelle sans exploser le budget
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
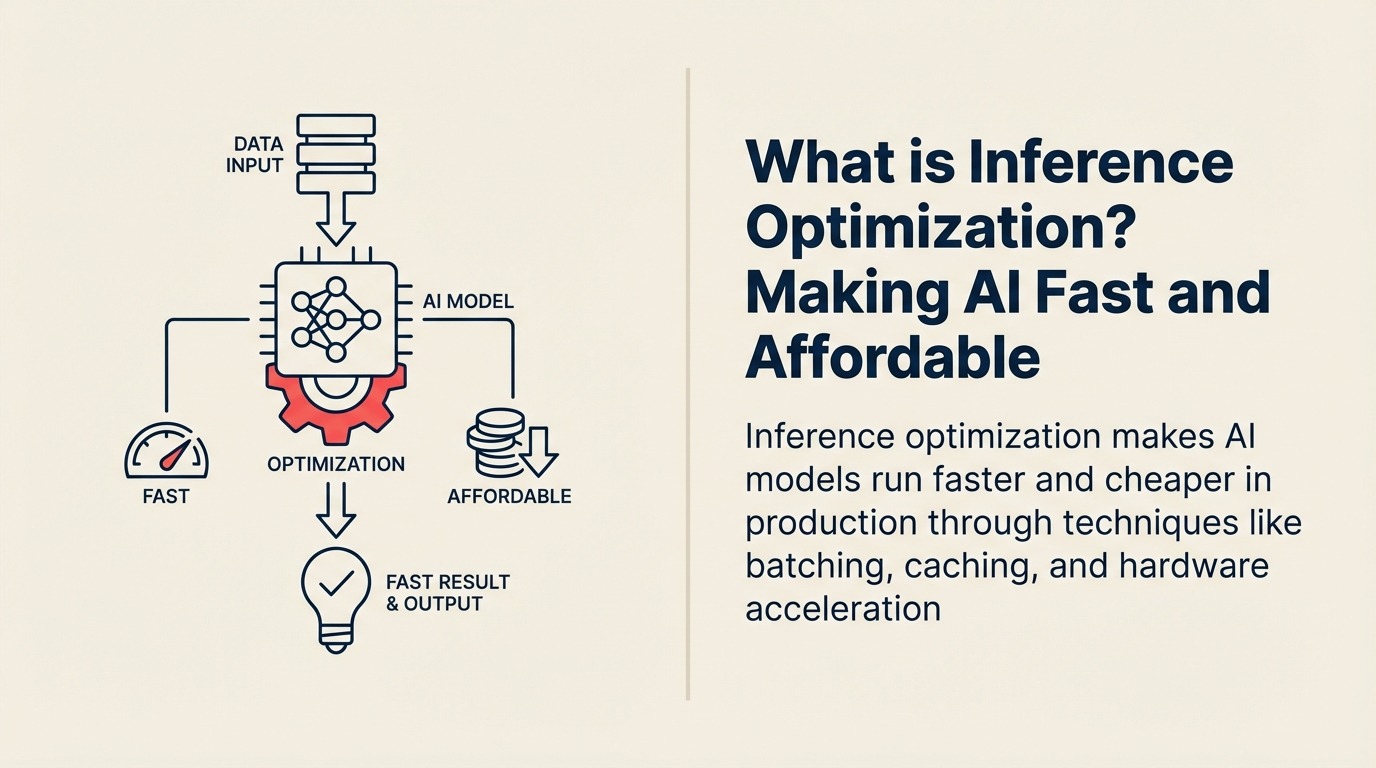
Entraîner un modèle d'IA une seule fois coûte des millions. Mais l'exécuter des milliards de fois coûte encore plus cher. Un seul grand modèle de langage qui sert 100 000 utilisateurs par jour peut générer 50 000 $ de coûts de calcul par mois. L'optimisation de l'inférence est devenue la discipline décisive, celle qui sépare les pilotes d'IA des produits d'IA rentables : elle permet de fournir des résultats de même qualité pour un coût 10 fois plus bas et avec une vitesse 5 fois supérieure.
Du prototype à la réalité de la production
L'optimisation de l'inférence s'est imposée comme un domaine à part vers 2019, lorsque les entreprises ont compris que la précision d'un modèle ne suffisait pas : en production, les systèmes d'IA doivent être rapides, économiques et capables de monter en charge. Ce qui n'était au départ que du réglage de performance au cas par cas est devenu une discipline d'ingénierie structurée.
NVIDIA définit l'optimisation de l'inférence comme « le processus qui consiste à maximiser le débit, à minimiser la latence et à réduire les coûts de calcul des prédictions des modèles d'IA en environnement de production, grâce à l'optimisation logicielle, à l'accélération matérielle et à des améliorations d'architecture ».
Le domaine a pris son essor lorsque les entreprises ont constaté que des techniques d'optimisation simples pouvaient réduire les coûts de 70 à 90 % tout en ramenant les temps de réponse de quelques secondes à quelques millisecondes, ce qui rend les applications d'IA instantanées et économiquement viables.
Ce que cela signifie pour les dirigeants
Pour les dirigeants, l'optimisation de l'inférence consiste à offrir les mêmes capacités d'IA pour une fraction du coût et de la latence : elle rend possibles les applications en temps réel, réduit les dépenses d'infrastructure de 60 à 80 % et permet de faire croître les services d'IA de façon rentable, même quand l'usage augmente de manière exponentielle.
Imaginez un restaurant qui cuisine chaque commande séparément, face à un autre qui prépare les ingrédients à l'avance, regroupe les commandes similaires et utilise du matériel spécialisé. La qualité des plats est la même, mais le second est 10 fois plus efficace.
Concrètement, l'optimisation de l'inférence vous permet de servir des milliers d'utilisateurs en même temps sans faire flamber votre facture cloud, de répondre aux demandes de vos clients en quelques millisecondes plutôt qu'en quelques secondes, et de passer du pilote à la production sans que les coûts augmentent de façon linéaire.
Les éléments clés de l'optimisation de l'inférence
L'optimisation de l'inférence repose sur les techniques essentielles suivantes :
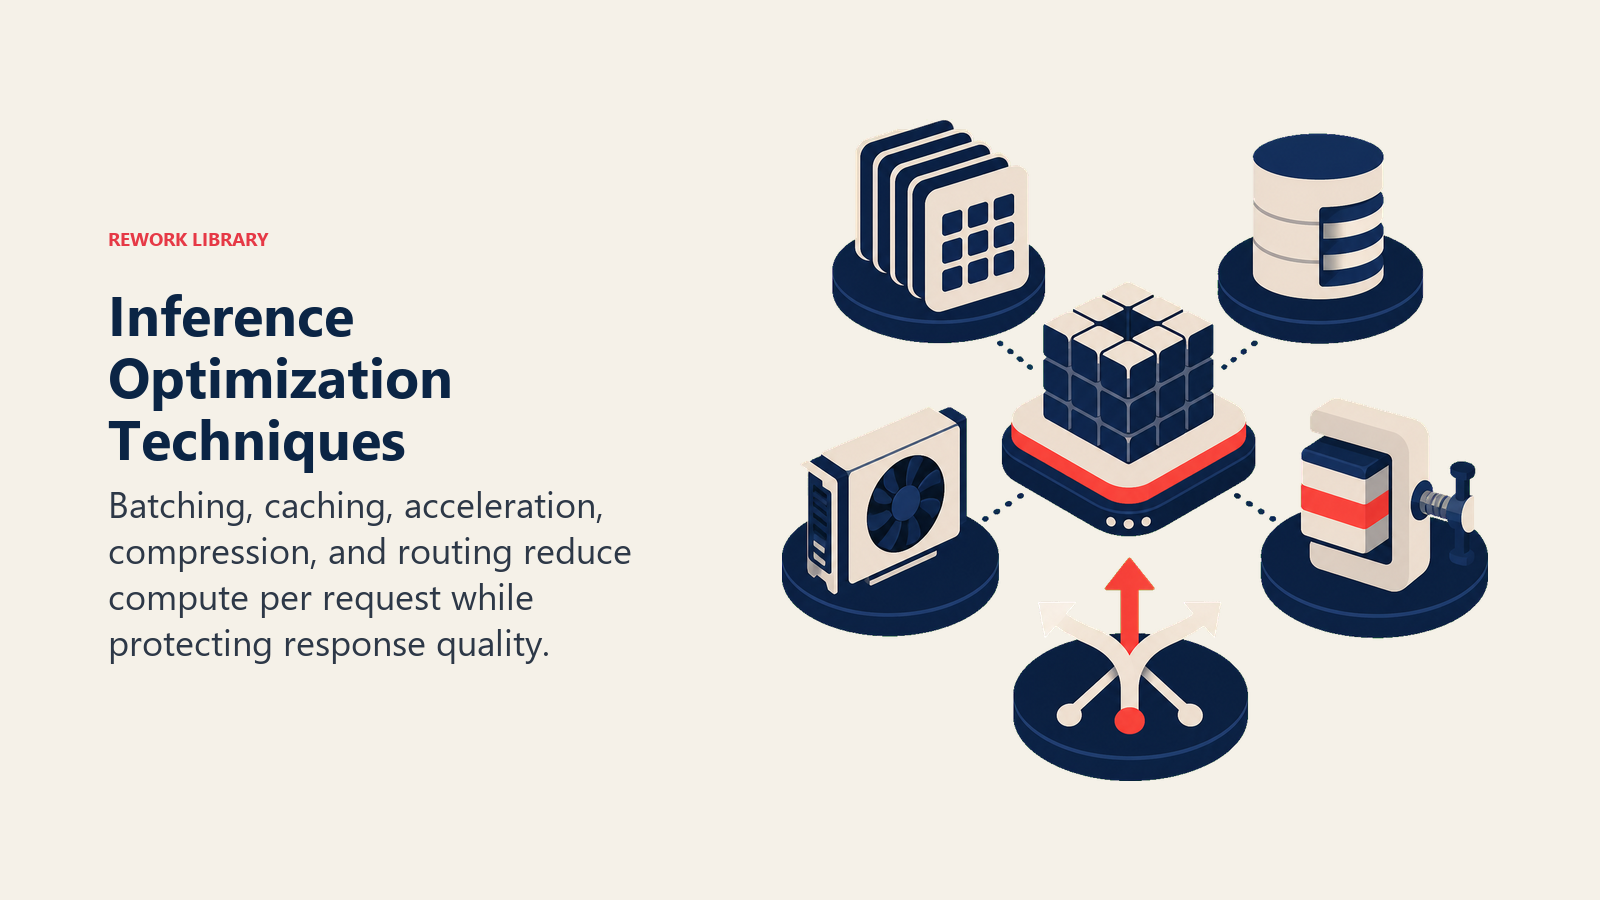
• Batching : traiter plusieurs requêtes ensemble plutôt qu'une par une, ce qui améliore fortement le débit en tirant parti du traitement parallèle des GPU
• Mise en cache : stocker les requêtes et réponses courantes pour éviter des calculs redondants, ce qui ramène la latence de quelques secondes à quelques millisecondes pour les questions fréquentes
• Accélération matérielle : utiliser des processeurs spécialisés (GPU, TPU, ASIC sur mesure) optimisés pour l'inférence d'IA, avec des gains de vitesse de 10 à 100 fois par rapport aux CPU généralistes
• Compression de modèle : réduire la taille du modèle par quantification et élagage (pruning) tout en préservant la précision, pour un chargement et une exécution plus rapides
• Routage des requêtes : orienter chaque type de requête vers le modèle adapté (les requêtes simples vers de petits modèles, les complexes vers de grands modèles), afin d'optimiser l'arbitrage entre coût et précision
Le processus d'optimisation de l'inférence
La mise en œuvre de l'optimisation de l'inférence suit ces étapes :
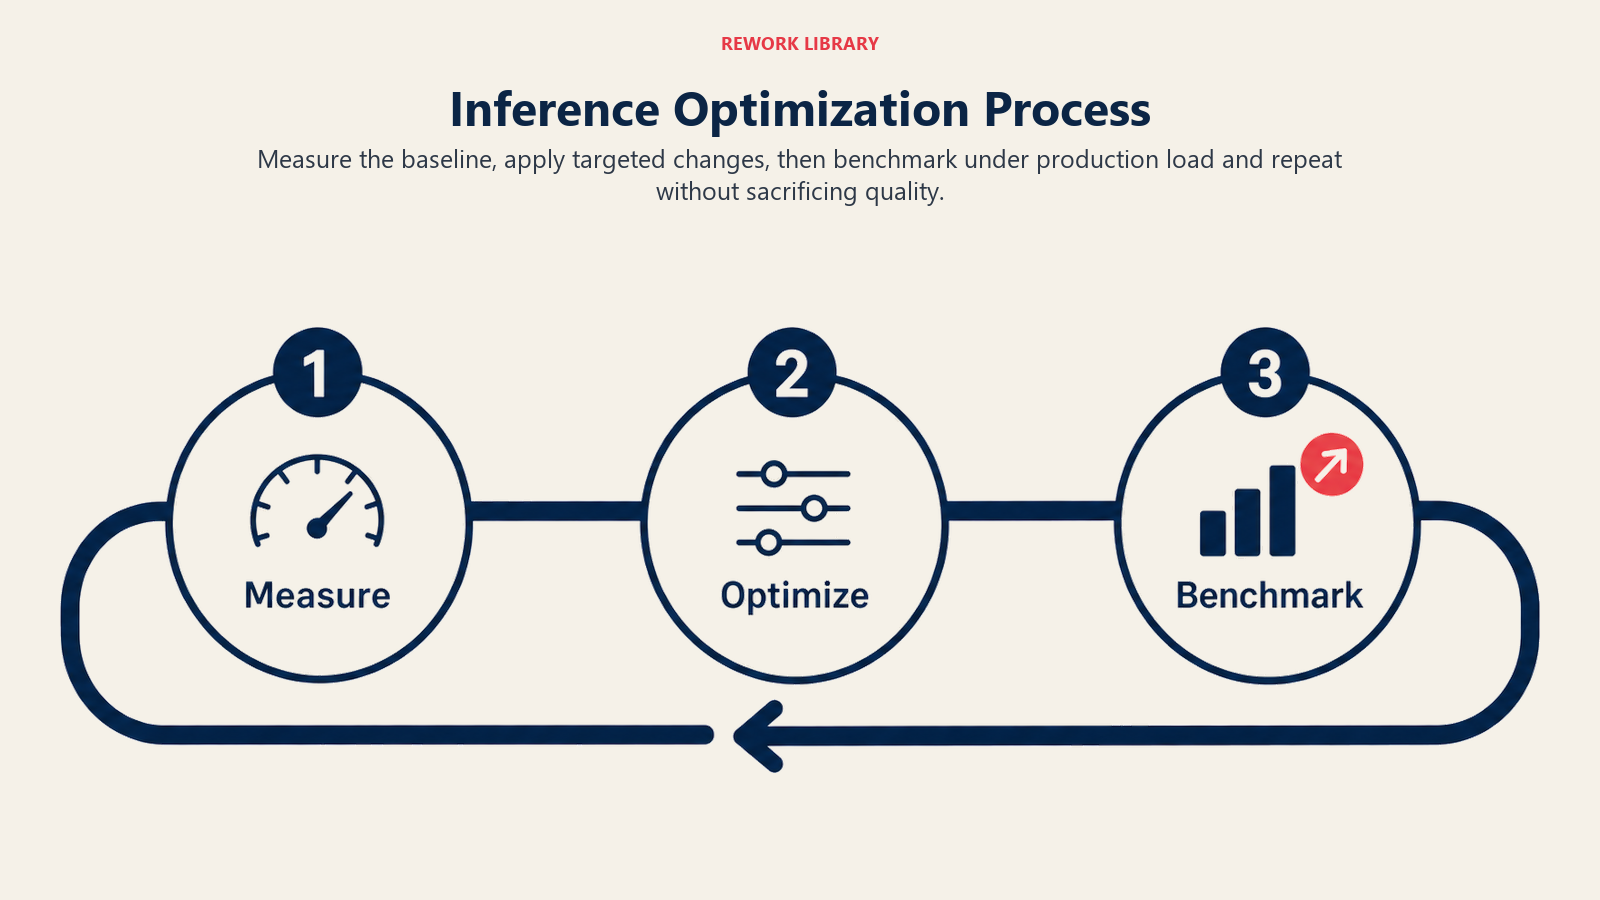
Mesurer la situation de départ : établir le profil des performances d'inférence actuelles et repérer les goulots d'étranglement du prétraitement, de l'exécution du modèle et du post-traitement, pour savoir où les efforts d'optimisation auront le plus d'effet
Appliquer les optimisations : mettre en place le batching pour le débit, la mise en cache pour les requêtes courantes, la compression de modèle pour la taille et l'accélération matérielle pour la vitesse, en combinant souvent plusieurs techniques
Mesurer et itérer : tester le système optimisé sous charge de production en mesurant latence, débit et coût, pour vérifier que les gains répondent aux besoins de l'entreprise sans sacrifier la qualité
Ce processus fait passer une preuve de concept qui traite 10 requêtes par seconde à un système de production capable d'en servir 10 000 par seconde, pour un coût total plus faible.
Les types d'optimisation de l'inférence
L'optimisation de l'inférence recourt à plusieurs approches :
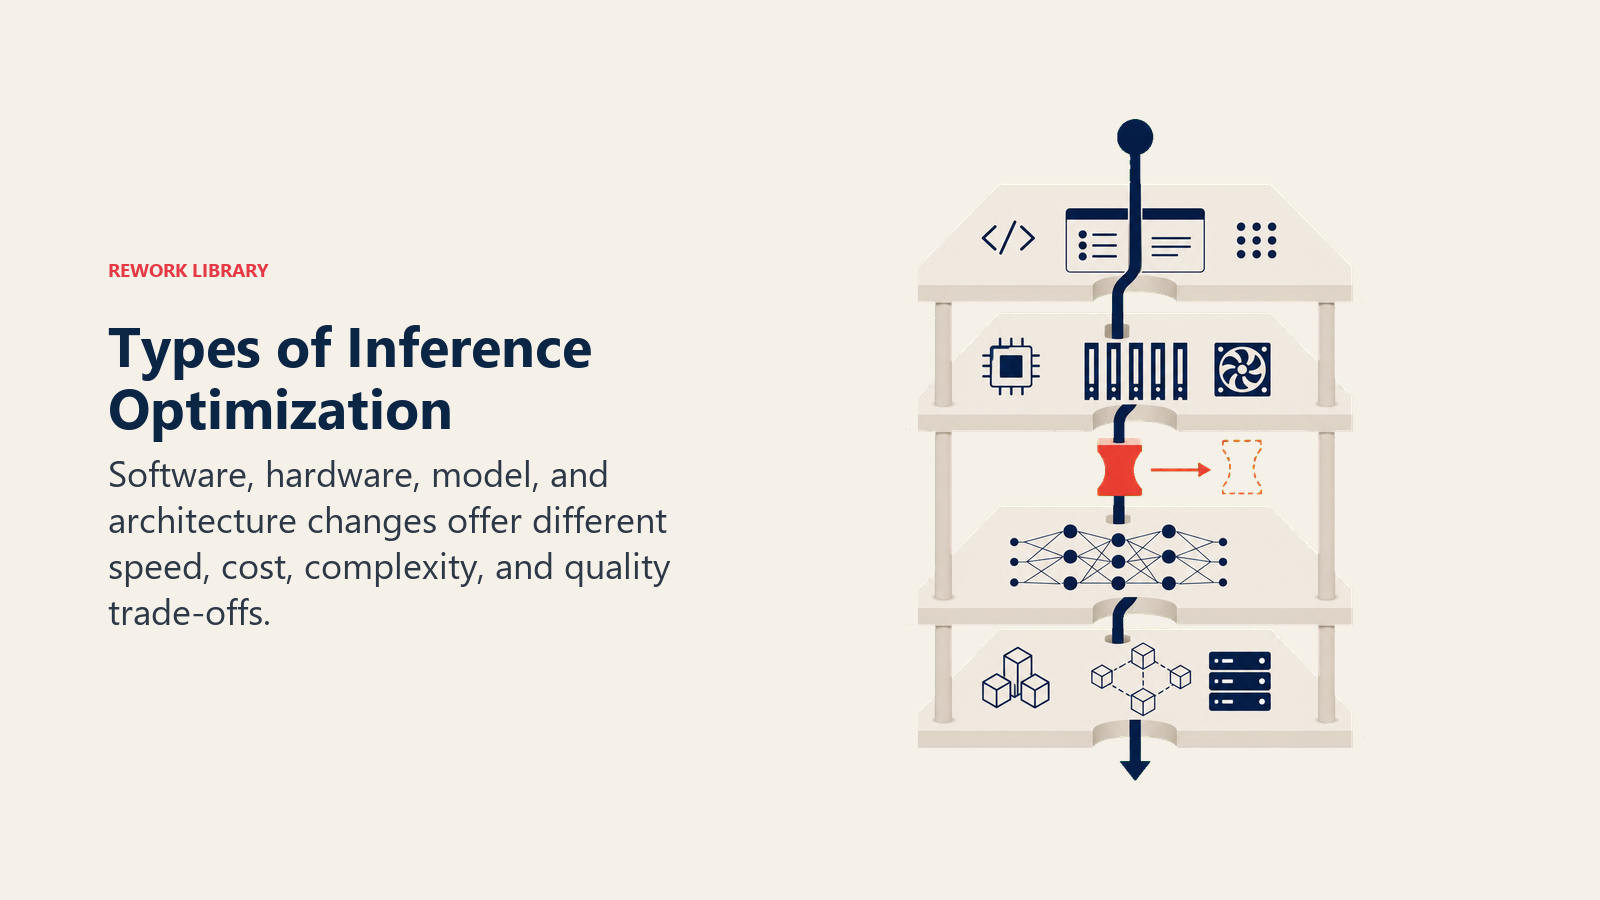
Type 1 : optimisation logicielle Idéal pour : obtenir des gains rapides sans toucher à l'infrastructure Caractéristique clé : améliorations au niveau du code et réglage des algorithmes Exemple : mettre en place le batching des requêtes pour traiter 50 requêtes simultanément plutôt que l'une après l'autre
Type 2 : accélération matérielle Idéal pour : obtenir les meilleures améliorations de performance Caractéristique clé : processeurs d'inférence spécialisés Exemple : passer des CPU aux GPU NVIDIA T4 pour une accélération de 20 fois
Type 3 : optimisation du modèle Idéal pour : réduire les besoins en calcul Caractéristique clé : des modèles plus petits et plus rapides, aux capacités équivalentes Exemple : recourir à la distillation de connaissances pour créer un modèle 4 fois plus petit qui conserve 95 % de la précision d'origine
Type 4 : optimisation de l'architecture Idéal pour : les systèmes de production à grande échelle Caractéristique clé : traitement distribué et répartition de charge Exemple : déploiement multirégion avec routage intelligent des requêtes
L'optimisation de l'inférence en action
Voici comment des entreprises l'utilisent concrètement :
Exemple en e-commerce : Shopify a optimisé son moteur de recommandation de produits grâce au batching, à la mise en cache et à la quantification du modèle. Les temps de réponse sont passés de 800 ms à 50 ms et les coûts d'infrastructure ont baissé de 73 %, alors que le volume de requêtes servies a été multiplié par 10.
Exemple en service client : le système d'IA de routage des tickets de Zendesk s'appuie sur l'optimisation de l'inférence pour traiter 100 000 tickets par jour. En mettant en cache les schémas de questions courantes et en confiant 80 % des requêtes à de petits modèles spécialisés, l'entreprise a réduit ses coûts de 200 000 $ par an.
Exemple en services financiers : Stripe a optimisé l'inférence de sa détection de fraude pour analyser les transactions en moins de 100 ms (contre 2 secondes), en combinant accélération GPU, batching des requêtes et compression de modèle. Cela a permis une prévention de la fraude en temps réel sans dégrader l'expérience client.
Votre parcours vers la maîtrise de l'optimisation de l'inférence
Prêt à rendre vos systèmes d'IA rapides et abordables ?
- Comprenez la compression de modèle avec la quantification
- Explorez les architectures efficaces grâce à la distillation de connaissances
- Découvrez le déploiement en production avec le MLOps
En savoir plus
Approfondissez votre compréhension des notions d'IA voisines :
- Model Serving : déployer des modèles en production
- Edge AI : exécuter l'inférence sur des appareils
- Compression de modèle : réduire la taille et la complexité d'un modèle
- Latence : comprendre les facteurs du temps de réponse
Ressources externes
- Plateforme d'inférence IA de NVIDIA : techniques d'accélération matérielle et d'optimisation
- Guide d'optimisation de Hugging Face : tutoriels pratiques sur l'optimisation des modèles
- Performance IA de Google Cloud : modèles d'architecture d'inférence évolutive
Questions fréquentes sur l'optimisation de l'inférence
Qu'est-ce que l'optimisation de l'inférence ?
L'optimisation de l'inférence consiste à rendre les prédictions des modèles d'IA plus rapides, moins chères et plus évolutives en production, grâce à des techniques comme le batching, la mise en cache, l'accélération matérielle et la compression de modèle.
Quelle est la différence entre l'optimisation de l'entraînement et celle de l'inférence ?
L'optimisation de l'entraînement vise à entraîner les modèles plus vite et à moindre coût (cela n'arrive qu'une fois). L'optimisation de l'inférence vise à produire les prédictions plus vite et à moindre coût (cela arrive des millions de fois en production). Elle a un impact économique plus important, car elle touche chaque requête d'utilisateur.
De combien l'optimisation de l'inférence peut-elle réduire les coûts ?
Bien menée, l'optimisation de l'inférence réduit généralement les coûts de 60 à 90 % et accélère les traitements de 5 à 50 fois. Les économies exactes dépendent de la situation de départ, des techniques appliquées et des caractéristiques de la charge de travail.
Quelles sont les principales techniques d'optimisation de l'inférence ?
Les techniques de base sont le batching (traiter plusieurs requêtes ensemble), la mise en cache (stocker les résultats courants), l'accélération matérielle (utiliser des processeurs spécialisés), la compression de modèle (réduire la taille du modèle) et le routage des requêtes (associer chaque requête au modèle adapté).
Quand faut-il optimiser l'inférence ?
Commencez à optimiser lorsque vous passez du prototype à la production, lorsque les coûts augmentent proportionnellement à l'usage, lorsque la latence nuit à l'expérience utilisateur ou lorsque vous servez des milliers de requêtes par jour. Optimiser tôt évite de coûteuses montées en charge de l'infrastructure.
Fait partie de la Collection AI Terms. Dernière mise à jour : 2026-02-09

Co-Founder, Rework.com
On this page
- Du prototype à la réalité de la production
- Ce que cela signifie pour les dirigeants
- Les éléments clés de l'optimisation de l'inférence
- Le processus d'optimisation de l'inférence
- Les types d'optimisation de l'inférence
- L'optimisation de l'inférence en action
- Votre parcours vers la maîtrise de l'optimisation de l'inférence
- En savoir plus
- Ressources externes