Qu'est-ce que la distillation de connaissances ? Les performances de GPT-4 à moindre coût
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
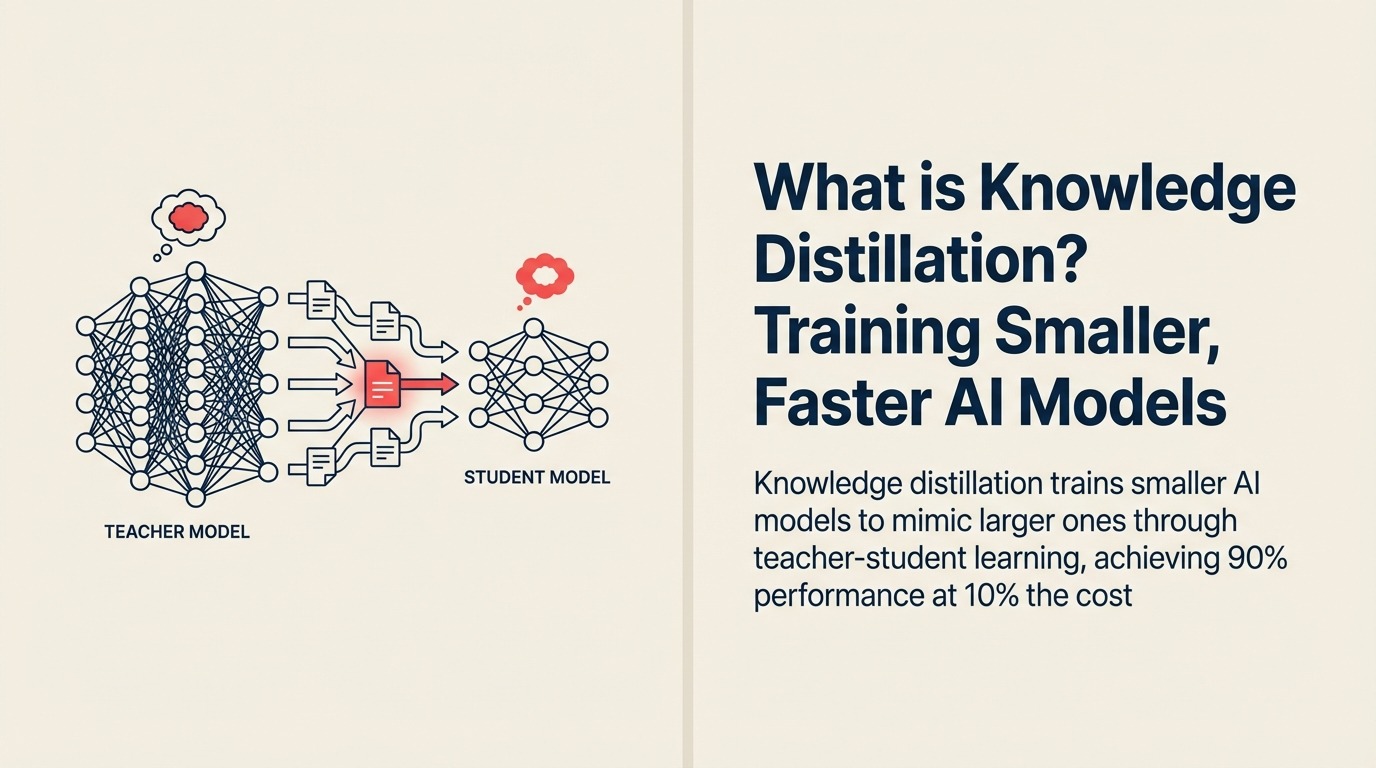
GPT-4 est brillant, mais coûte 20 \(par million de tokens. Un petit modèle spécialisé facture 0,20\) pour le même travail, sans pouvoir égaler les capacités de GPT-4. Du moins en apparence. La distillation de connaissances est la technique qui permet de transférer l'intelligence des immenses grands modèles de langage vers des versions compactes, rapides et abordables, avec 90 % des performances pour 10 % du coût sur des cas d'usage précis.
Du monopole des grands modèles à l'intelligence efficiente
La distillation de connaissances est apparue en 2015, lorsque des chercheurs ont découvert que de petits réseaux de neurones pouvaient apprendre à imiter de grands réseaux en étudiant leur comportement, plutôt qu'en repartant des données brutes. Ce qui n'était qu'une curiosité académique est devenu une nécessité en production.
Google Research définit la distillation de connaissances comme « le processus qui consiste à transférer les connaissances d'un grand modèle enseignant, complexe, vers un modèle élève plus petit et plus efficace, en l'entraînant à reproduire les sorties et les représentations internes de l'enseignant ».
Le domaine a pris son essor quand les entreprises ont compris qu'elles pouvaient créer des modèles spécialisés égalant les performances de GPT-3 sur des tâches précises, tout en tournant 100 fois plus vite sur du matériel local : des API cloud coûteuses deviennent ainsi des déploiements en périphérie (edge) abordables.
Ce que cela signifie pour les dirigeants
Pour les dirigeants, la distillation de connaissances consiste à capturer l'intelligence des modèles d'IA les plus avancés dans des versions plus petites, plus rapides et moins chères, optimisées pour votre cas d'usage : elle réduit les coûts de 80 à 95 % tout en maintenant la qualité sur les tâches qui comptent pour votre entreprise.
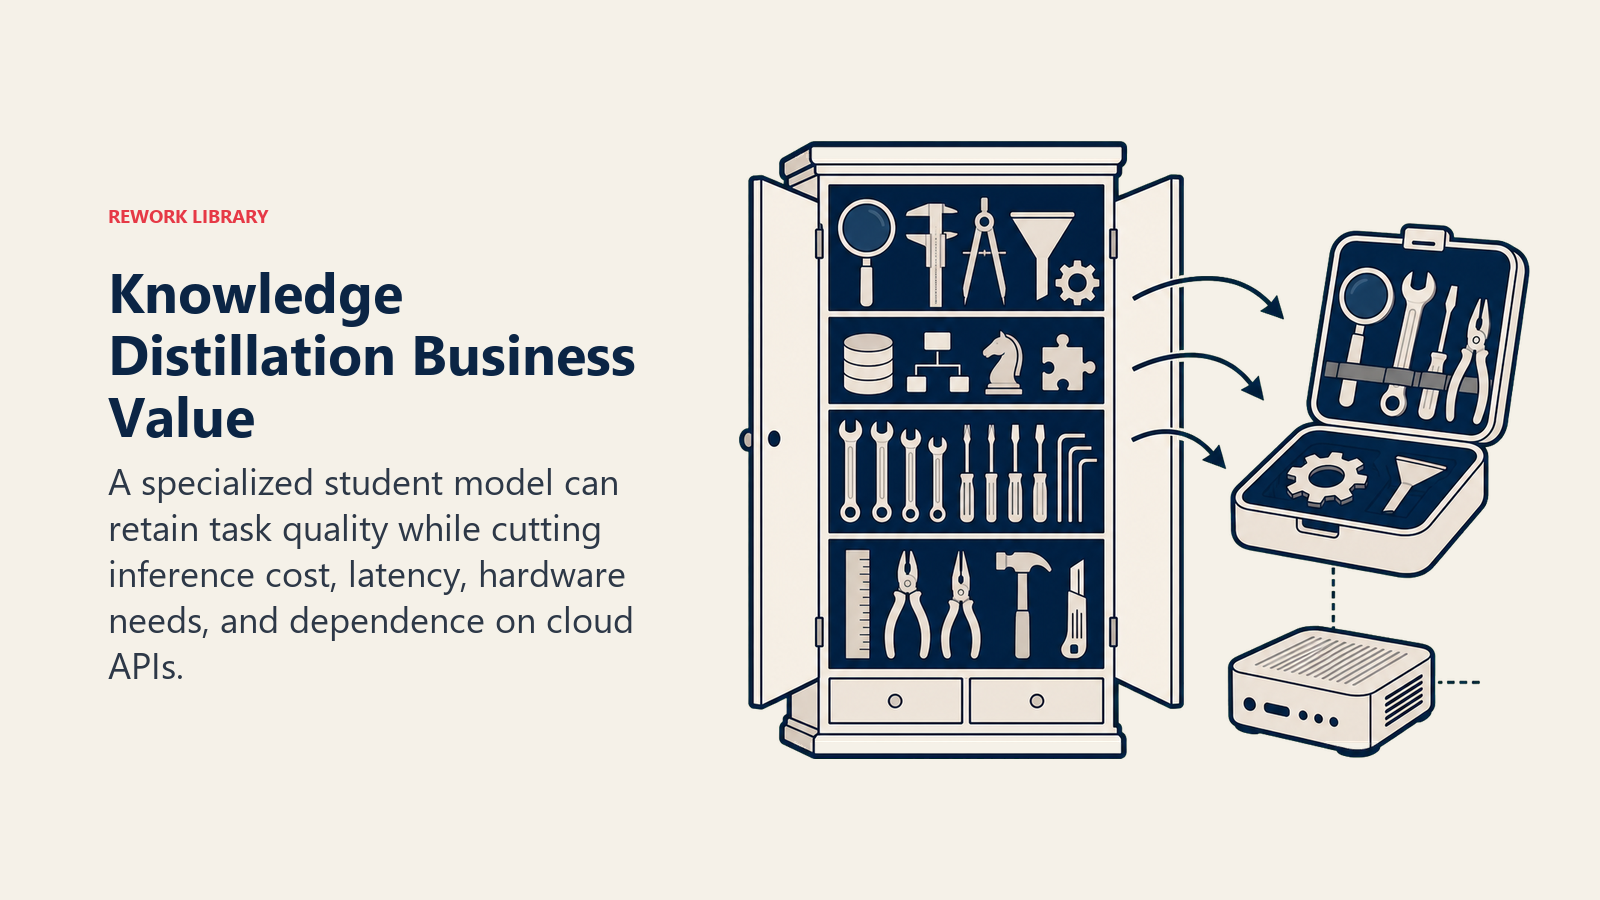
Imaginez que vous engagiez un expert senior pour former une équipe de spécialistes. L'équipe ne saura pas tout ce que sait l'expert, mais elle excellera sur les tâches précises dont vous avez besoin, et vous pourrez vous offrir 10 spécialistes pour le prix d'un seul expert.
Concrètement, la distillation de connaissances vous permet de faire tourner sur des smartphones une intelligence de la classe de GPT-4, de traiter les demandes de vos clients pour quelques centimes au lieu de plusieurs dollars, et de déployer une IA qui fonctionne hors ligne sans perdre en précision pour votre cas d'usage.
Les éléments clés de la distillation de connaissances
La distillation de connaissances repose sur les composantes essentielles suivantes :
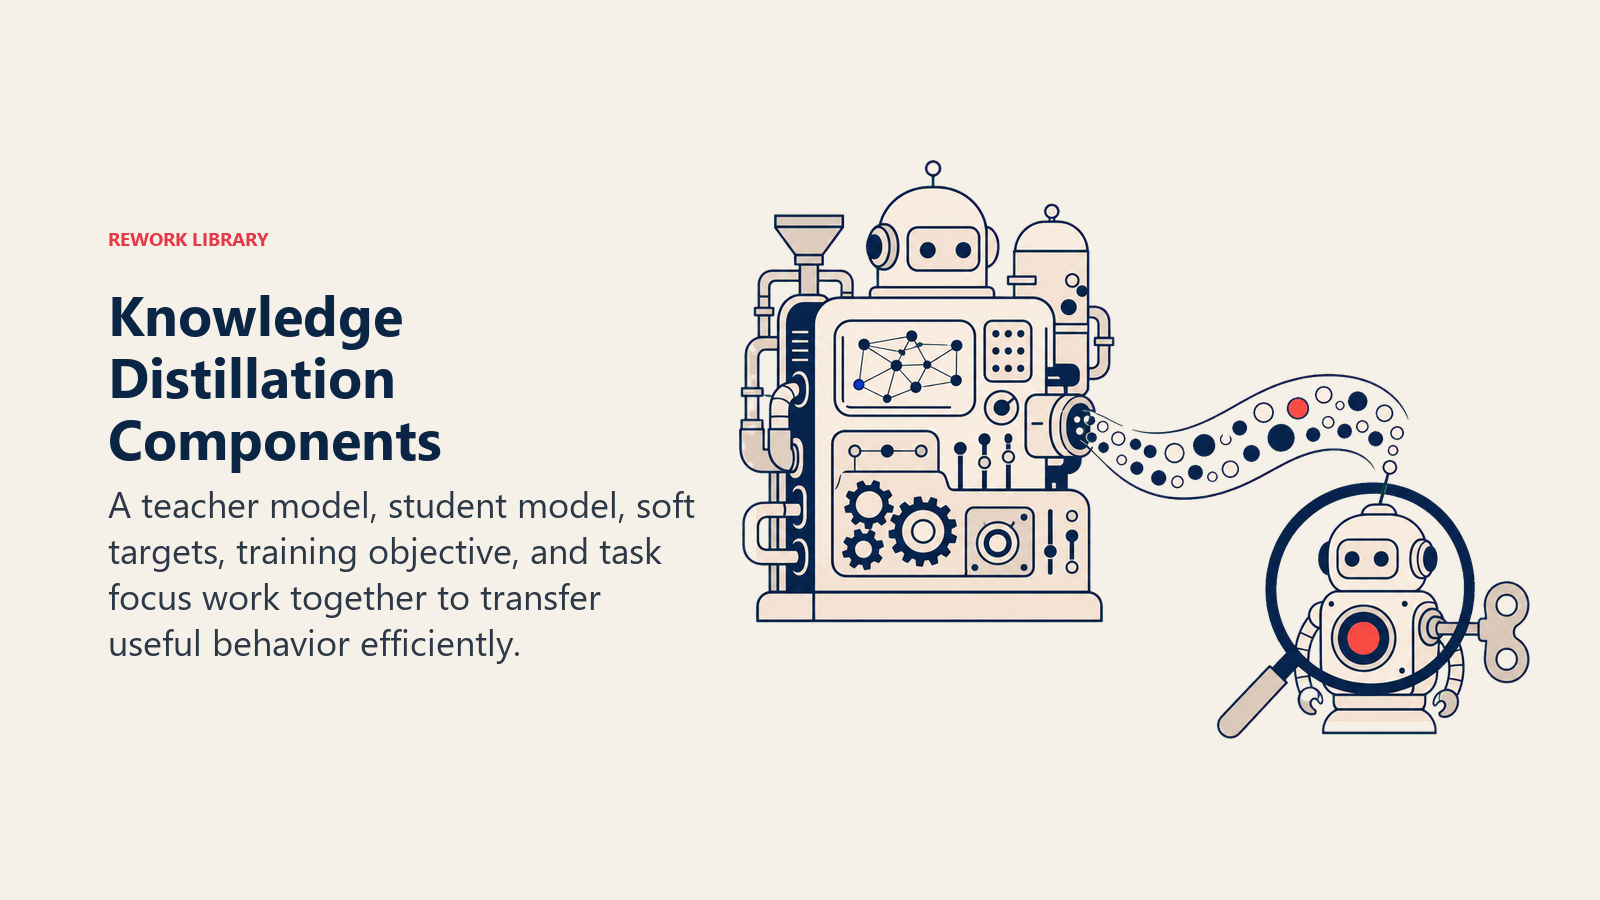
• Modèle enseignant : un grand modèle puissant (comme GPT-4 ou Claude) qui atteint des performances de pointe, mais reste trop coûteux ou trop lent pour un déploiement en production
• Modèle élève : un modèle plus petit et plus rapide, conçu pour apprendre des connaissances de l'enseignant plutôt que des données d'entraînement brutes, et optimisé pour l'efficacité
• Cibles souples (soft targets) : les distributions de probabilité de l'enseignant sur les réponses possibles, et pas seulement la réponse finale, ce qui fournit des signaux d'apprentissage plus riches sur l'incertitude et les nuances
• Entraînement par distillation : l'élève apprend à reproduire à la fois les réponses finales de l'enseignant et ses schémas de raisonnement, et capte ainsi sa façon de prendre des décisions
• Spécialisation par tâche : le modèle élève se concentre sur des cas d'usage où il peut approcher les performances de l'enseignant, plutôt que de viser une intelligence générale
Le processus de distillation de connaissances
La mise en œuvre de la distillation de connaissances suit ces étapes :
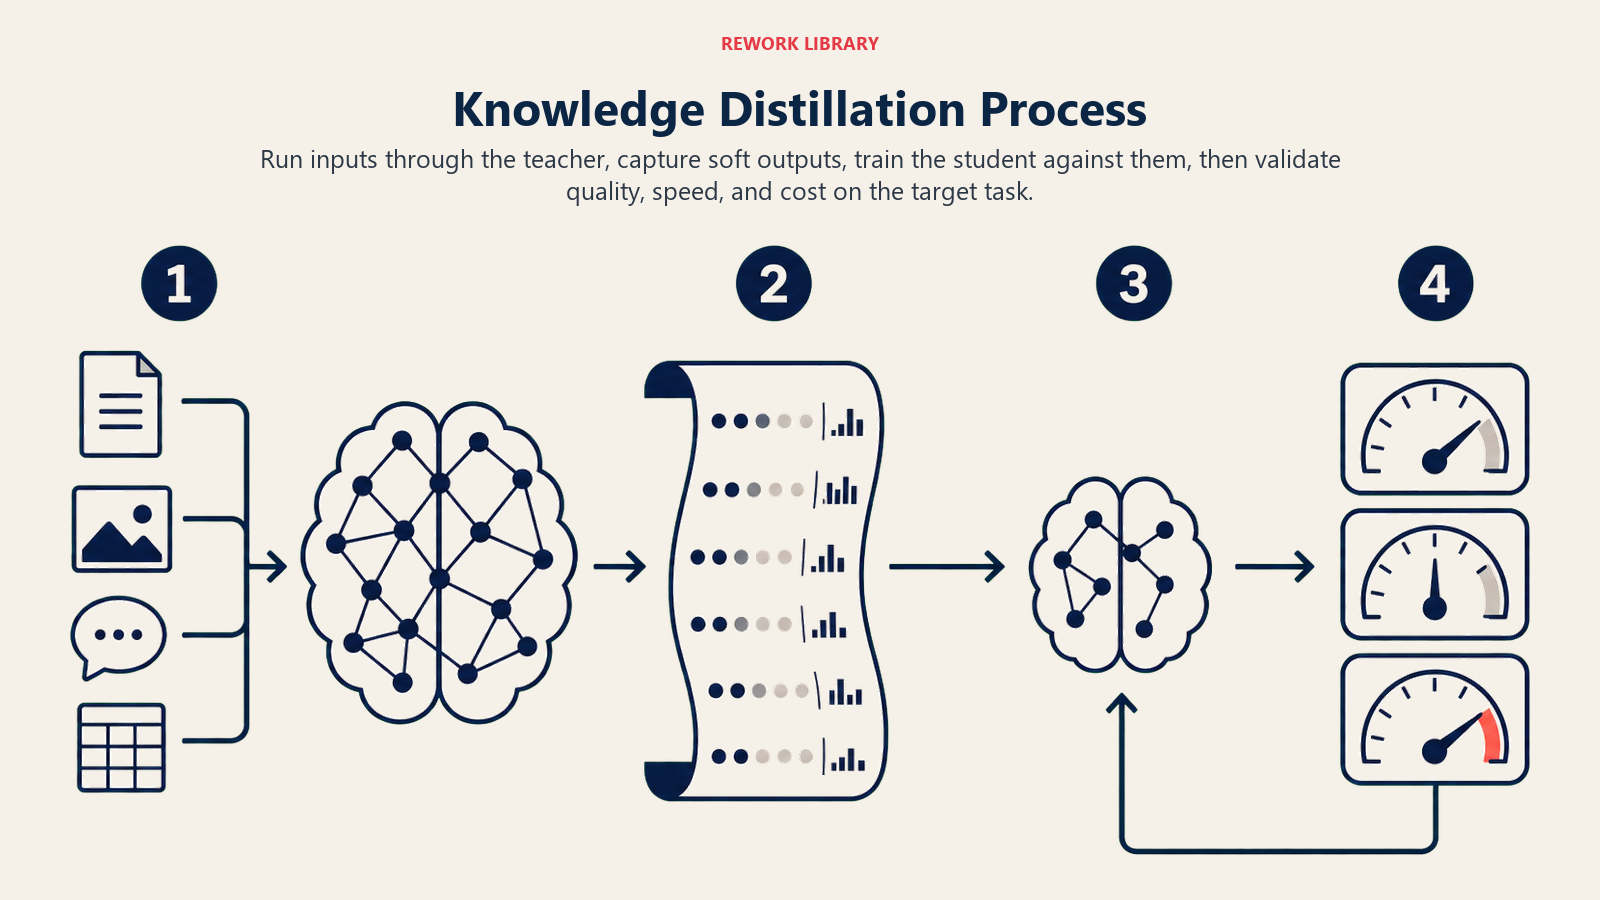
Choisir l'enseignant et l'élève : retenez un modèle enseignant puissant pour votre domaine et concevez une architecture d'élève plus petite (10 à 100 fois moins de paramètres) qui tourne efficacement dans votre environnement
Générer les données d'entraînement : faites passer vos exemples d'entraînement dans le modèle enseignant et collectez ses sorties, ses distributions de probabilité et ses activations intermédiaires pour capter ses schémas de décision
Entraîner l'élève à imiter : entraînez le modèle élève à reproduire les sorties et le raisonnement de l'enseignant, en s'appuyant à la fois sur les bonnes réponses et sur les niveaux de confiance de l'enseignant pour transférer une compréhension nuancée
Ce processus transforme un modèle de 175 milliards de paramètres qui coûte 50 $/heure à exécuter en un modèle d'un milliard de paramètres qui atteint 95 % des performances pour 0,50 $/heure.
Les types de distillation de connaissances
La distillation de connaissances existe sous plusieurs formes :
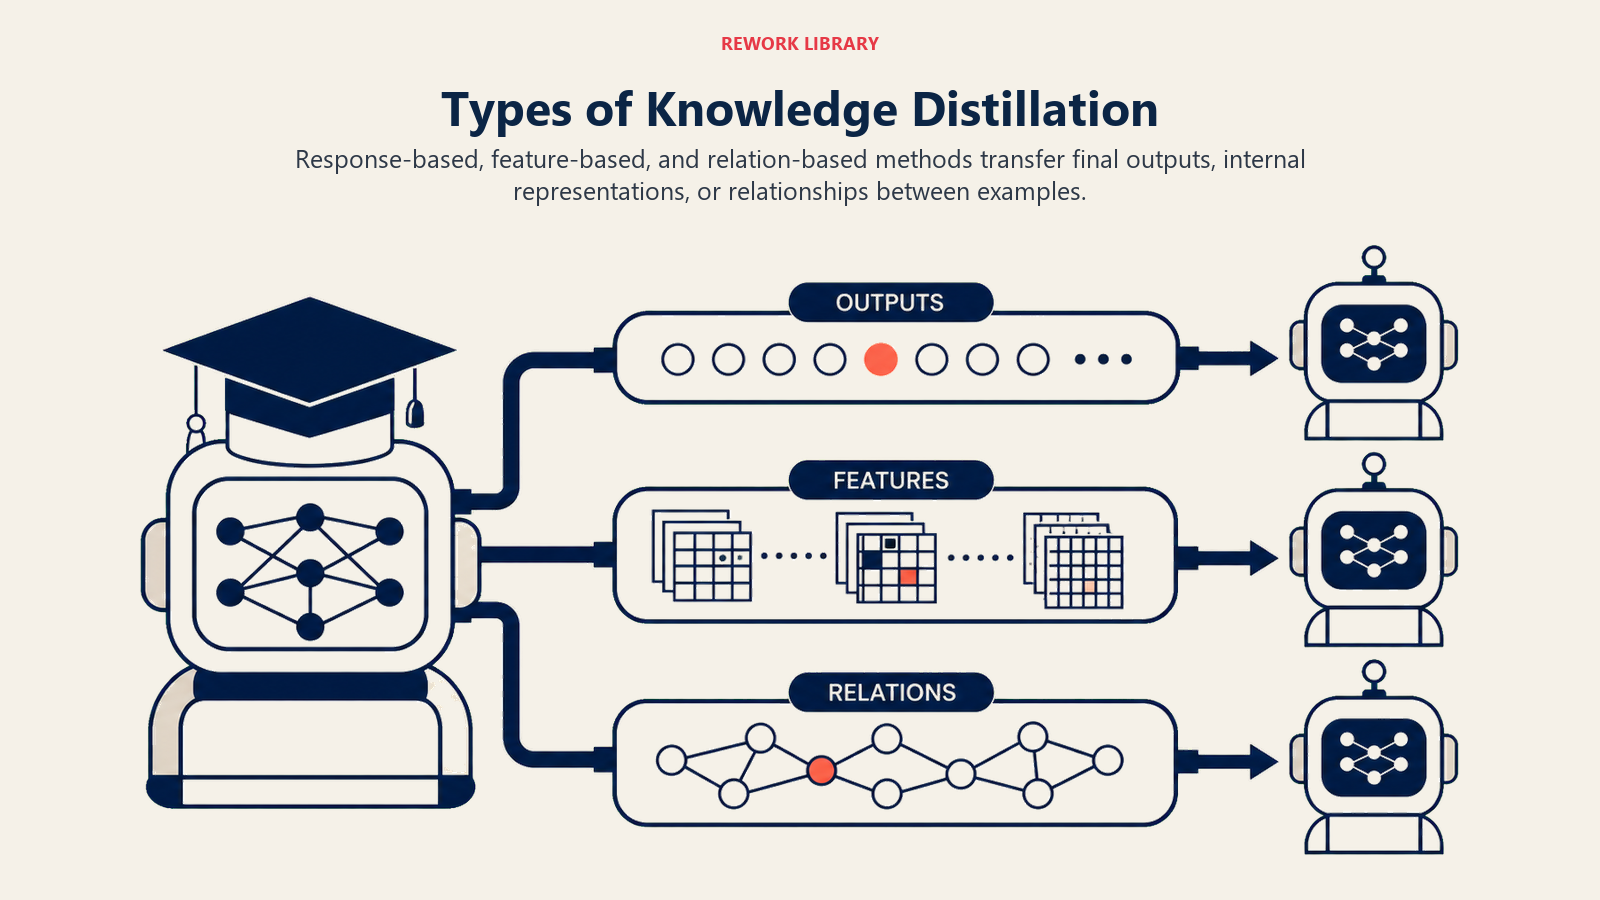
Type 1 : distillation fondée sur les réponses Idéal pour : une mise en œuvre rapide et des tâches simples Caractéristique clé : l'élève apprend à partir des sorties finales de l'enseignant Exemple : entraîner un chatbot de service client à reproduire les réponses de GPT-4 aux questions courantes
Type 2 : distillation fondée sur les caractéristiques Idéal pour : capter une compréhension plus profonde Caractéristique clé : l'élève apprend à partir des représentations internes de l'enseignant Exemple : créer un classifieur d'images spécialisé qui imite l'extraction de caractéristiques d'un grand modèle de vision
Type 3 : distillation fondée sur les relations Idéal pour : les tâches de raisonnement complexe Caractéristique clé : l'élève apprend les relations entre les concepts Exemple : construire un modèle d'analyse de contrats qui reprend la compréhension qu'a un grand modèle des interactions entre clauses juridiques
Type 4 : distillation multi-enseignants Idéal pour : combiner plusieurs capacités Caractéristique clé : l'élève apprend auprès de plusieurs enseignants spécialisés Exemple : créer un assistant de business intelligence formé par des experts distincts en finance, en opérations et en ventes
La distillation de connaissances en action
Voici comment des entreprises l'utilisent concrètement :
Exemple en support client : Intercom a distillé les connaissances de GPT-3.5 dans un modèle de 125 millions de paramètres chargé de répondre aux questions sur le produit. Le modèle distillé atteint 92 % de la précision de GPT-3.5, tourne 40 fois plus vite et coûte 95 % moins cher, ce qui permet des réponses en temps réel sur des serveurs en périphérie.
Exemple en legal tech : LawGeex a créé un modèle spécialisé de revue de contrats en distillant les connaissances de GPT-4 sur 50 000 documents juridiques. Le modèle obtenu égale la précision de GPT-4 pour l'analyse de contrats, tourne sur site (on-premise) et protège la confidentialité des clients, pour 10 % du coût.
Exemple en e-commerce : Amazon utilise la distillation de connaissances pour créer des modèles de recommandation de produits qui reprennent l'intelligence de ses immenses systèmes de deep learning tout en tournant efficacement sur les applications mobiles, avec des recommandations personnalisées en 50 ms au lieu de 2 secondes.
Votre parcours vers la maîtrise de la distillation de connaissances
Prêt à créer des modèles d'IA efficaces et spécialisés ?
- Comprenez l'efficacité des modèles avec la quantification
- Explorez l'optimisation en production avec l'optimisation de l'inférence
- Découvrez l'entraînement des modèles avec le transfer learning
En savoir plus
Approfondissez votre compréhension des notions d'IA voisines :
- Compression de modèle : d'autres techniques pour obtenir des modèles plus petits
- Fine-tuning : personnaliser des modèles pré-entraînés
- Élagage (pruning) : supprimer les composants inutiles d'un modèle
- Recherche d'architecture neuronale : concevoir des structures de modèle efficaces
Ressources externes
- Google Research sur la compression de modèles : articles académiques sur les techniques de distillation
- Tutoriels Hugging Face sur la distillation : guides pratiques pour mettre en œuvre la distillation de connaissances
- Recherche d'OpenAI sur l'efficacité des modèles : stratégies de déploiement d'IA économiques
Questions fréquentes sur la distillation de connaissances
Qu'est-ce que la distillation de connaissances ?
La distillation de connaissances consiste à entraîner un modèle élève plus petit et plus rapide à imiter le comportement et les connaissances d'un modèle enseignant plus grand et plus puissant, pour obtenir des performances similaires à une fraction du coût de calcul.
De combien le modèle élève peut-il être plus petit ?
Les modèles élèves sont généralement 10 à 100 fois plus petits que les enseignants. Une approche courante consiste à distiller GPT-3 (175 milliards de paramètres) en modèles spécialisés de 1 à 7 milliards de paramètres, qui égalent ses performances sur des tâches précises tout en tournant 50 à 100 fois plus vite.
Quelle est la différence entre la distillation de connaissances et le fine-tuning ?
Le fine-tuning adapte un modèle pré-entraîné à de nouvelles données en conservant la même architecture. La distillation de connaissances transfère le savoir d'un grand modèle vers un modèle plus petit, d'architecture différente, ce qui produit un modèle plus efficace et optimisé pour le déploiement.
Le modèle élève égale-t-il les performances de l'enseignant ?
Sur des tâches étroites et bien définies, les modèles élèves atteignent généralement 85 à 95 % des performances de l'enseignant. La contrepartie, c'est l'étendue : les élèves excellent sur des tâches précises, mais n'ont pas les capacités générales de l'enseignant.
Quand faut-il recourir à la distillation de connaissances ?
Recourez-y lorsque vos coûts d'inférence sont élevés, que vous avez besoin de temps de réponse rapides, que vous voulez déployer sur des appareils en périphérie ou que vous recherchez la performance sur une tâche précise sans les capacités générales d'un grand modèle. Elle est essentielle pour faire croître les applications d'IA de façon rentable.
Fait partie de la Collection AI Terms. Dernière mise à jour : 2026-02-09

Co-Founder, Rework.com
On this page
- Du monopole des grands modèles à l'intelligence efficiente
- Ce que cela signifie pour les dirigeants
- Les éléments clés de la distillation de connaissances
- Le processus de distillation de connaissances
- Les types de distillation de connaissances
- La distillation de connaissances en action
- Votre parcours vers la maîtrise de la distillation de connaissances
- En savoir plus
- Ressources externes