Qu'est-ce que l'IA multimodale ? Un seul modèle pour tous vos contenus
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
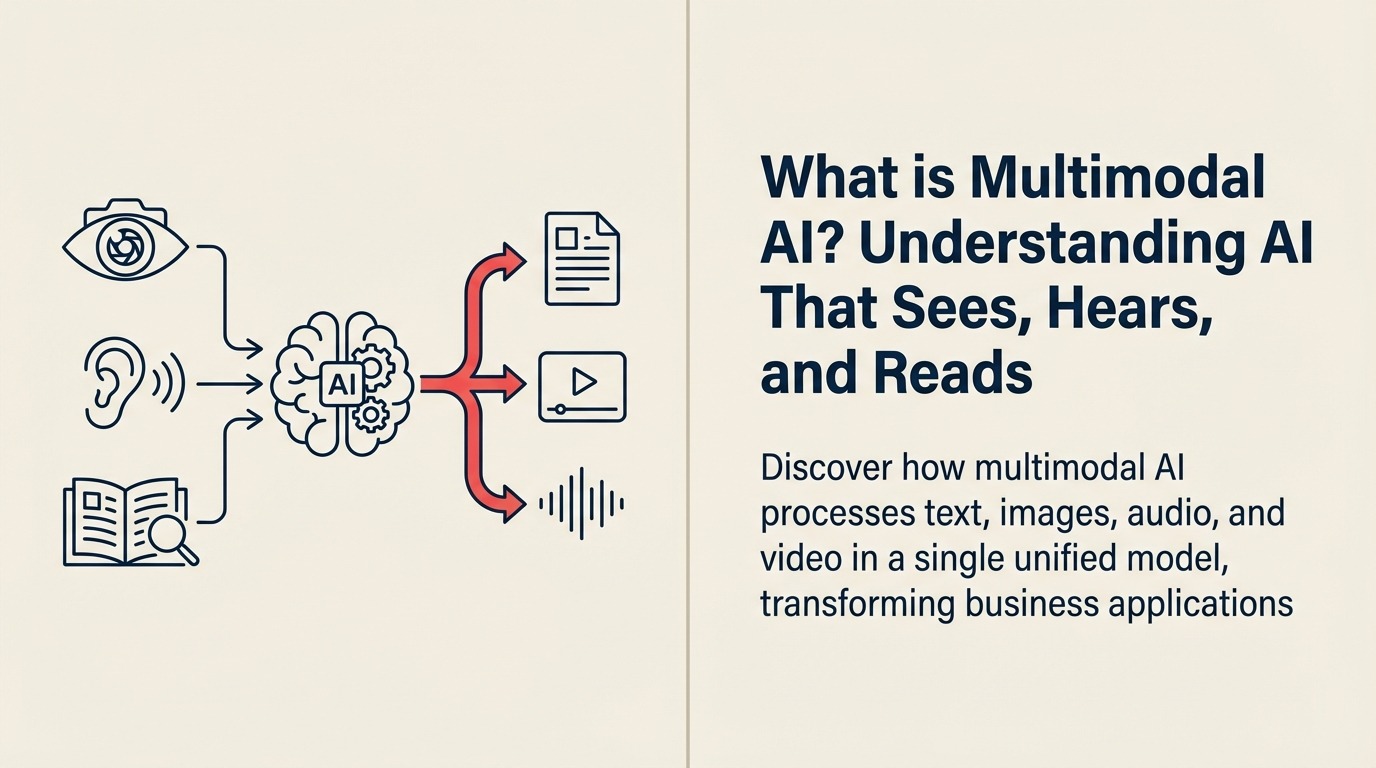
Imaginez une IA capable de lire votre e-mail, d'analyser le tableur en pièce jointe, de visionner la vidéo de démonstration et de vous répondre avec des enseignements tirés des trois. Plus besoin de passer d'un outil à l'autre, ni de résumer à la main : un seul système intelligent comprend tout ce que vous lui soumettez. C'est cela, l'IA multimodale.
La révolution de l'IA unifiée
L'IA multimodale est née quand les chercheurs ont mesuré les limites des systèmes à entrée unique. Les premiers modèles d'IA ne traitaient que du texte ou que des images. En 2023, des modèles décisifs comme GPT-4V et Gemini de Google ont tout changé.
Selon Google Research, l'IA multimodale désigne des « modèles capables de traiter et de raisonner sur plusieurs types de données d'entrée, dont le texte, les images, l'audio et la vidéo, au sein d'une même architecture unifiée, à l'image de la façon dont les humains perçoivent et comprennent naturellement le monde ».
Le tournant est venu quand OpenAI a lancé GPT-4 avec des capacités de vision en septembre 2023, suivi de Gemini de Google en décembre 2023 et de Claude 3 d'Anthropic en mars 2024. Chacun a montré que l'IA pouvait enfin égaler l'aisance humaine avec des contenus de formats mixtes.
L'IA multimodale pour les dirigeants
Pour les dirigeants, l'IA multimodale revient à embaucher un expert capable de lire des documents, d'interpréter des graphiques, de regarder des vidéos et d'écouter des appels, le tout en même temps, puis de synthétiser les enseignements de tous les formats que produit votre entreprise.
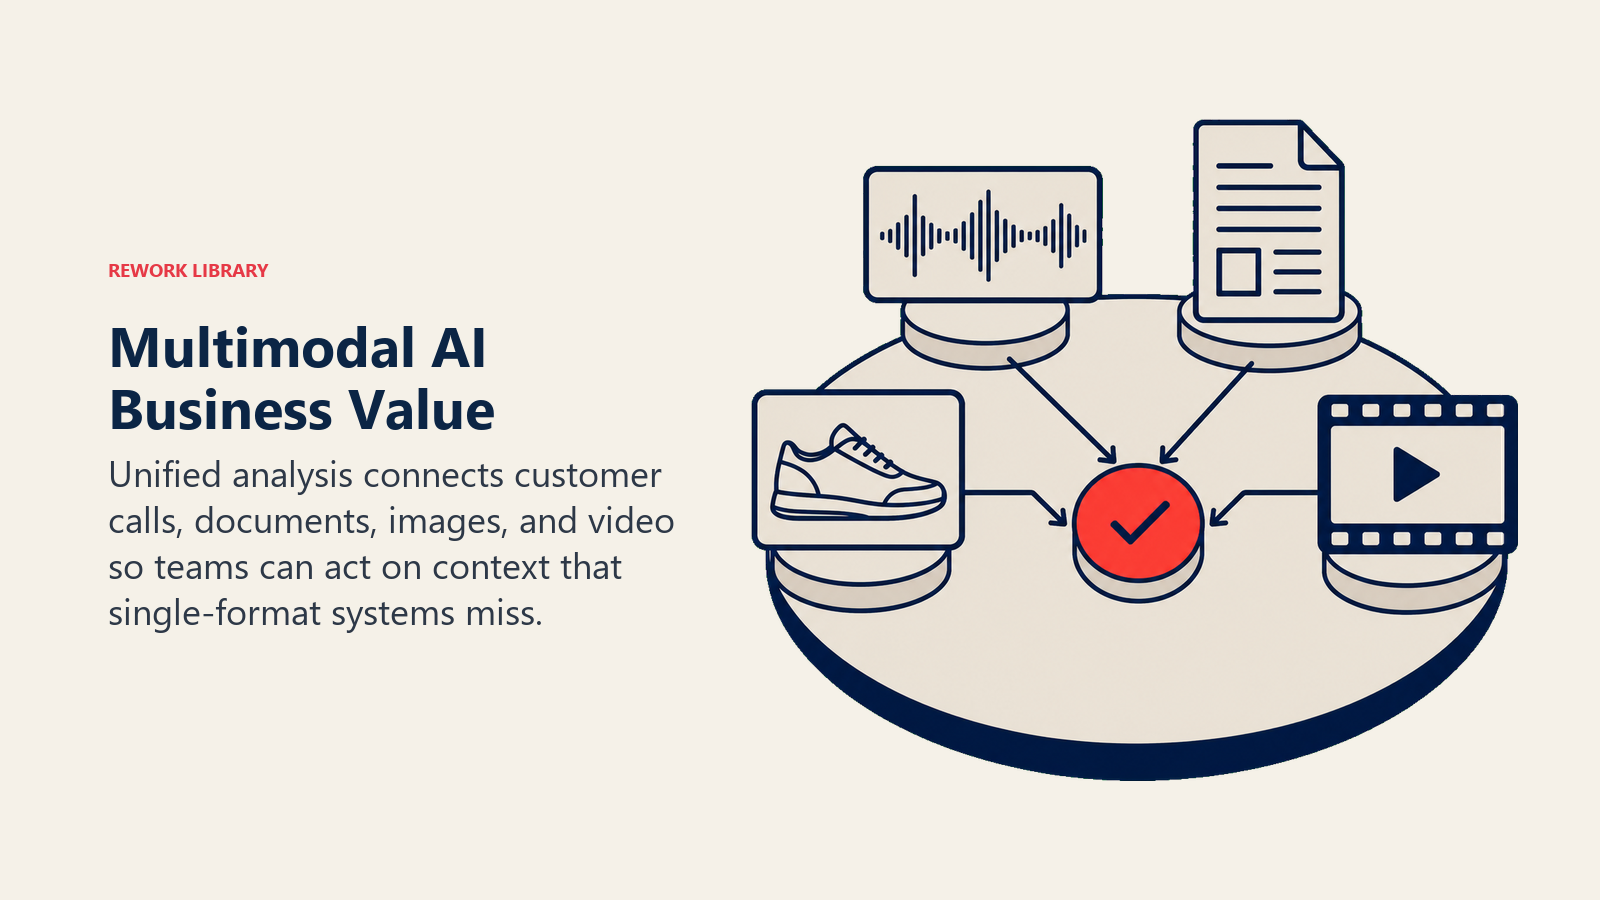
Comparez des spécialistes distincts pour le texte, les images et l'audio avec un seul expert qui comprend les trois ensemble. L'expert multimodal repère des schémas, des liens et des enseignements que des spécialistes travaillant chacun de leur côté laisseraient passer.
Concrètement, l'IA multimodale peut analyser les appels de vos clients (audio), examiner les images de vos produits, lire les tickets de support (texte) et repérer les tendances sur tous les canaux simultanément. C'est un immense pas en avant par rapport aux grands modèles de langage classiques, qui ne géraient que du texte.
Les composants essentiels de l'IA multimodale
Les systèmes d'IA multimodale reposent sur les éléments suivants :
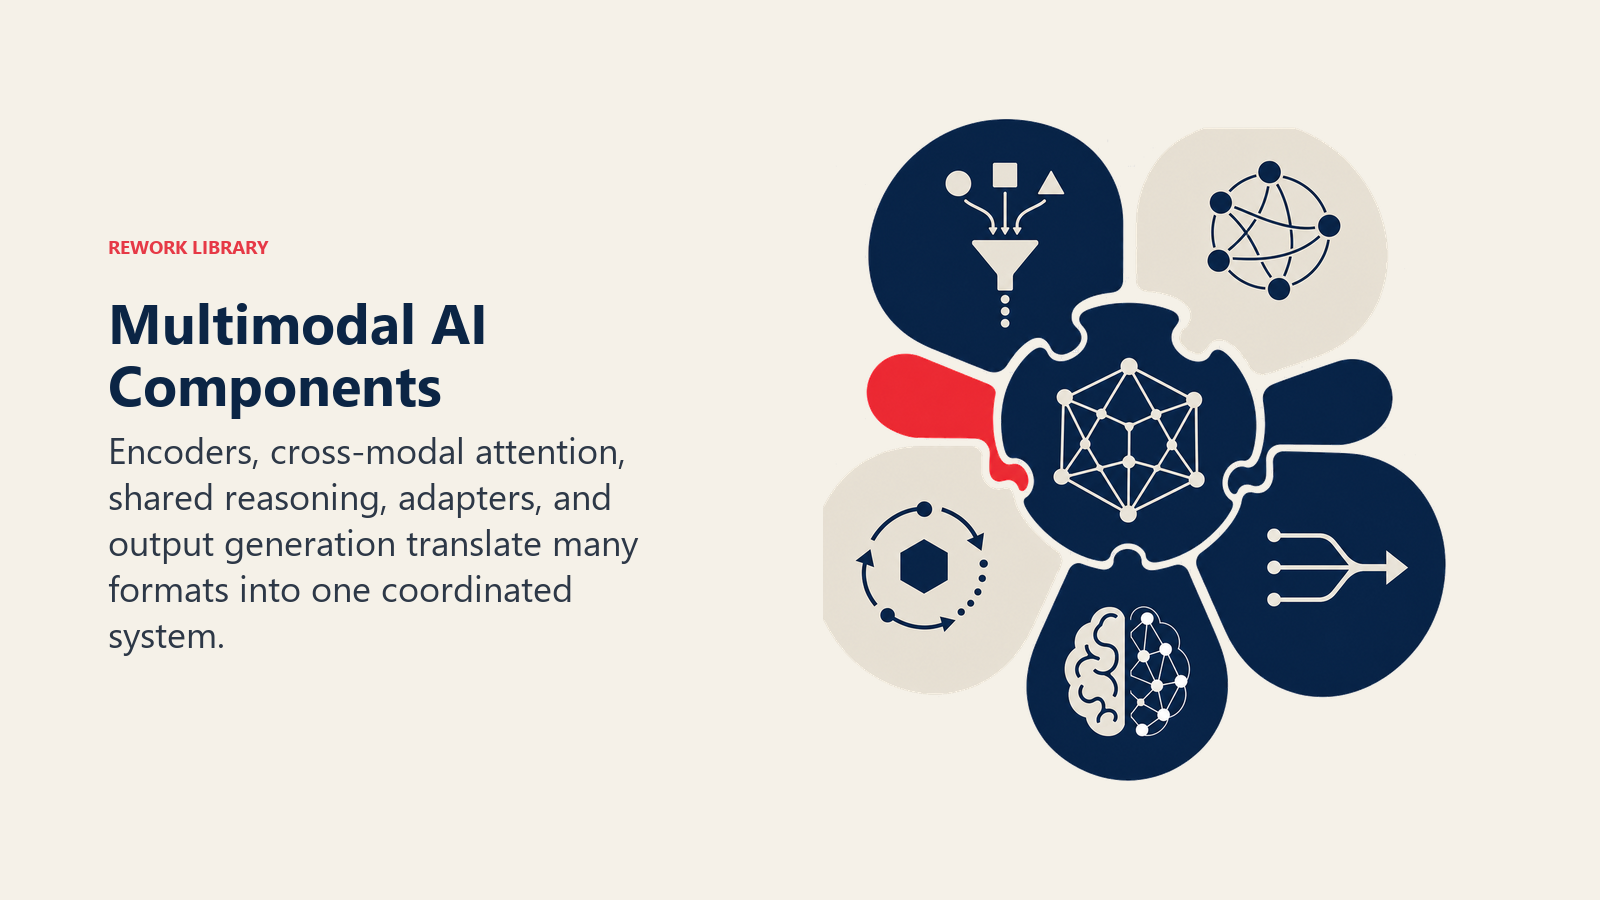
• Encodeur unifié : convertit des types de données différents (texte, images, audio, vidéo) en une représentation commune que le modèle peut traiter ensemble, comme un traducteur universel des formats d'information
• Attention intermodale (cross-modal attention) : mécanisme qui permet au modèle de comprendre les relations entre différents types d'entrée, par exemple de relier des paroles dans un audio à des objets dans une image
• Couche de raisonnement partagée : moteur de traitement commun qui réfléchit sur tous les types d'entrée à la fois, pour une vraie synthèse plutôt qu'une analyse séparée
• Adaptateurs de modalité : composants spécialisés qui gèrent les particularités de chaque type d'entrée avant de l'injecter dans le système unifié
• Génération de sorties : capacité à répondre dans plusieurs formats, du texte aux images en passant par les données structurées, selon ce qui sert le mieux le cas d'usage
Comment fonctionne l'IA multimodale
L'IA multimodale suit ce cycle de fonctionnement :
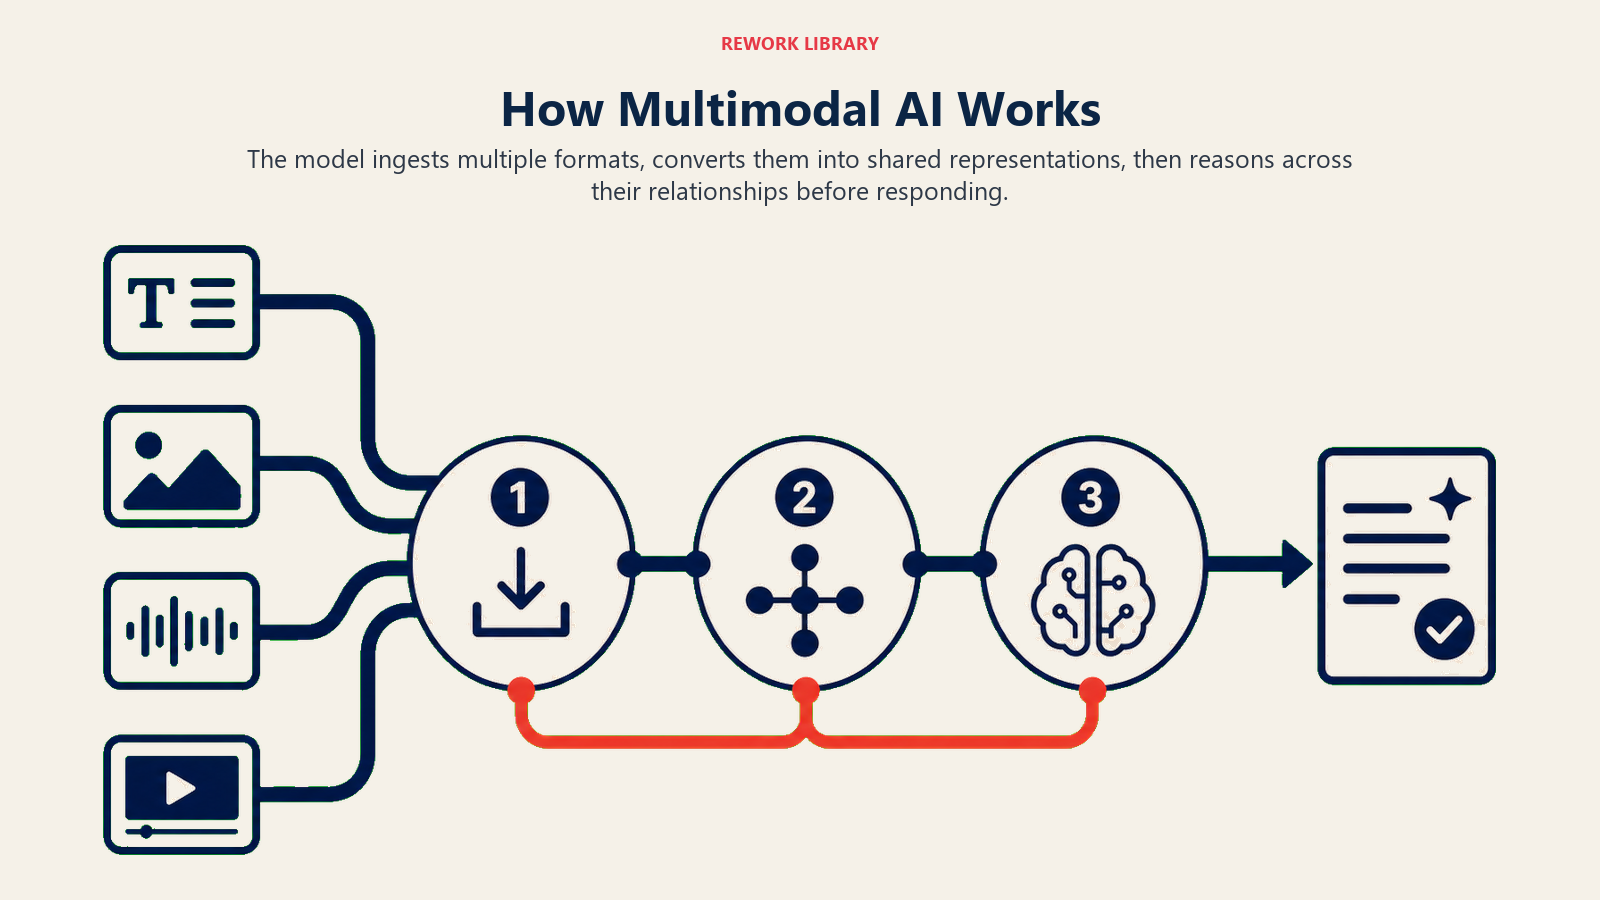
Ingestion simultanée : le modèle reçoit des entrées dans plusieurs formats, par exemple l'image d'un produit, le texte d'un avis client et une vidéo de démonstration, le tout en même temps
Traitement unifié : il convertit toutes les entrées en représentations internes communes, ce qui lui permet de comprendre les relations entre modalités, par exemple le lien entre l'image et les descriptions écrites
Raisonnement intermodal : il analyse des schémas et des enseignements qui couvrent plusieurs types de données, par exemple en remarquant qu'un sentiment positif à l'audio va de pair avec certaines caractéristiques visuelles du produit
Le cycle se poursuit : le modèle apprend des retours sur toutes les modalités et comprend de mieux en mieux comment les différents types d'information s'articulent.
Les types de systèmes d'IA multimodale
L'IA multimodale répond à différentes fonctions de l'entreprise :
Type 1 : modèles vision-langage Idéal pour : la compréhension de documents et l'analyse visuelle Caractéristique clé : combinent texte et images de façon fluide Exemple : GPT-4V qui analyse des graphiques et des rapports
Type 2 : modèles audio-visuels Idéal pour : l'analyse vidéo et l'intelligence des réunions Caractéristique clé : comprennent la parole dans le contexte du contenu visuel Exemple : comptes rendus de réunion automatisés avec identification des intervenants
Type 3 : systèmes texte-image-audio Idéal pour : une analyse complète des contenus Caractéristique clé : traitent ensemble tous les grands types de médias grâce à l'IA générative Exemple : Google Gemini qui gère des requêtes aux formats mixtes
Type 4 : modèles de fusion de capteurs Idéal pour : l'IoT et les applications en conditions réelles Caractéristique clé : combinent des données de capteurs structurées et des médias Exemple : contrôle qualité en usine avec caméras et mesures
L'IA multimodale à l'épreuve des résultats
Voici comment des entreprises déploient l'IA multimodale :
Exemple en santé : Siemens Healthineers utilise l'IA multimodale pour analyser ensemble des images médicales, des résultats de laboratoire et des notes cliniques. Le temps de diagnostic baisse de 40 %, et des anomalies que les systèmes à modalité unique manquaient sont détectées.
Exemple en commerce de détail : la recherche de produits d'Amazon s'appuie désormais sur l'IA multimodale pour comprendre des requêtes comme « montre-moi des chaussures comme sur cette photo, mais en bleu » : elle associe reconnaissance d'images et compréhension du texte et livre des résultats 35 % plus précis.
Exemple en services financiers : JPMorgan analyse les conférences de résultats avec une IA multimodale qui traite simultanément le langage parlé, les diapositives de présentation et les documents financiers, et repère des enseignements d'investissement 50 % plus vite que des équipes d'analystes.
Mettre en œuvre l'IA multimodale
Prêt à unifier vos capacités d'IA ?
- Commencez par les bases des grands modèles de langage
- Comprenez les notions de base de la vision par ordinateur
- Découvrez le traitement automatique du langage naturel
- Envisagez l'orchestration de l'IA pour les workflows complexes
Questions fréquentes sur l'IA multimodale
Qu'est-ce que l'IA multimodale ?
L'IA multimodale désigne des modèles capables de traiter et de raisonner sur plusieurs types de données d'entrée, dont le texte, les images, l'audio et la vidéo, au sein d'une même architecture unifiée, à la manière dont les humains comprennent naturellement le monde.
Quelle est la différence entre l'IA multimodale et l'IA classique ?
Les modèles d'IA classiques traitent un seul type de données (texte seul ou image seule). L'IA multimodale traite plusieurs types de données simultanément, comprend les relations entre eux et produit des enseignements qui couvrent plusieurs formats.
Quels sont les principaux types de systèmes d'IA multimodale ?
Les modèles vision-langage (texte et images), les modèles audio-visuels (parole et vidéo), les systèmes texte-image-audio (tous les grands types de médias) et les modèles de fusion de capteurs (données structurées et médias).
Quels sont des exemples de modèles d'IA multimodale ?
GPT-4V (OpenAI), Gemini (Google), Claude 3 (Anthropic), ainsi que des modèles spécialisés comme CLIP (image-texte), Whisper (audio) et ImageBind (toutes les modalités).
Ressources associées
Explorez ces notions voisines pour approfondir votre compréhension de l'IA multimodale :
- Vision par ordinateur : comment l'IA traite et comprend les images
- Réseaux de neurones : l'architecture de base des systèmes multimodaux
- Architecture Transformer : le socle technique des modèles multimodaux modernes
- Embeddings : comment différents types de données sont convertis en représentations communes
Ressources externes
- Google Research : Multimodal AI : dernières avancées sur les modèles d'IA unifiés
- Meta AI : Vision and Language : recherches sur la compréhension intermodale
- Microsoft Research : Multimodal Systems : applications multimodales en entreprise
Fait partie de la Collection AI Terms. Dernière mise à jour : 2026-02-09

Co-Founder, Rework.com