Qu'est-ce que le model serving ? Déployer des modèles d'IA qui tiennent à grande échelle
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Entraîner un modèle d'IA est un problème de recherche. Lui faire répondre de façon fiable à des milliers de requêtes par seconde, avec une latence constante, une haute disponibilité et des coûts prévisibles, est un problème d'ingénierie d'une tout autre nature. Le model serving est la couche d'infrastructure qui fait le pont entre un modèle entraîné et un système de production sur lequel l'entreprise peut compter.
Pour les responsables technologiques et opérationnels, le model serving est l'endroit où se jouent la réussite ou l'échec de la plupart des déploiements d'IA réels. Le modèle peut être excellent. Mais si l'infrastructure de serving ne tient pas la charge, ne garantit pas la disponibilité ou ne maîtrise pas les coûts, la valeur métier ne se concrétise jamais.
Ce qu'est le model serving
Le model serving désigne l'ensemble des logiciels et de l'infrastructure qui exposent un modèle de machine learning entraîné sous la forme d'un service appelable. Quand votre application envoie une requête d'utilisateur à un assistant IA, le model serving est la couche qui reçoit la requête, l'achemine vers une instance de modèle en fonctionnement, exécute le modèle et renvoie le résultat.
Dans sa forme la plus simple, le model serving comprend :
- Une instance du modèle en fonctionnement (chargée en mémoire GPU ou CPU)
- Un point d'accès API qui reçoit les requêtes
- Une logique de gestion de la concurrence (traiter plusieurs requêtes simultanées)
- Un mécanisme pour renvoyer les résultats à l'appelant
En pratique, le model serving de production est beaucoup plus complexe. Il inclut l'autoscaling (démarrer davantage d'instances de modèle sous charge et en réduire le nombre pour économiser), le load balancing (répartir les requêtes entre les instances), les contrôles de santé (détecter et remplacer les instances défaillantes), le versioning (exécuter plusieurs versions du modèle en parallèle pendant un déploiement progressif) et le monitoring (suivre la latence, les taux d'erreur et l'utilisation des ressources).
En quoi le model serving diffère des termes voisins
Ces termes sont souvent employés à la légère, et les distinctions comptent pour décider.
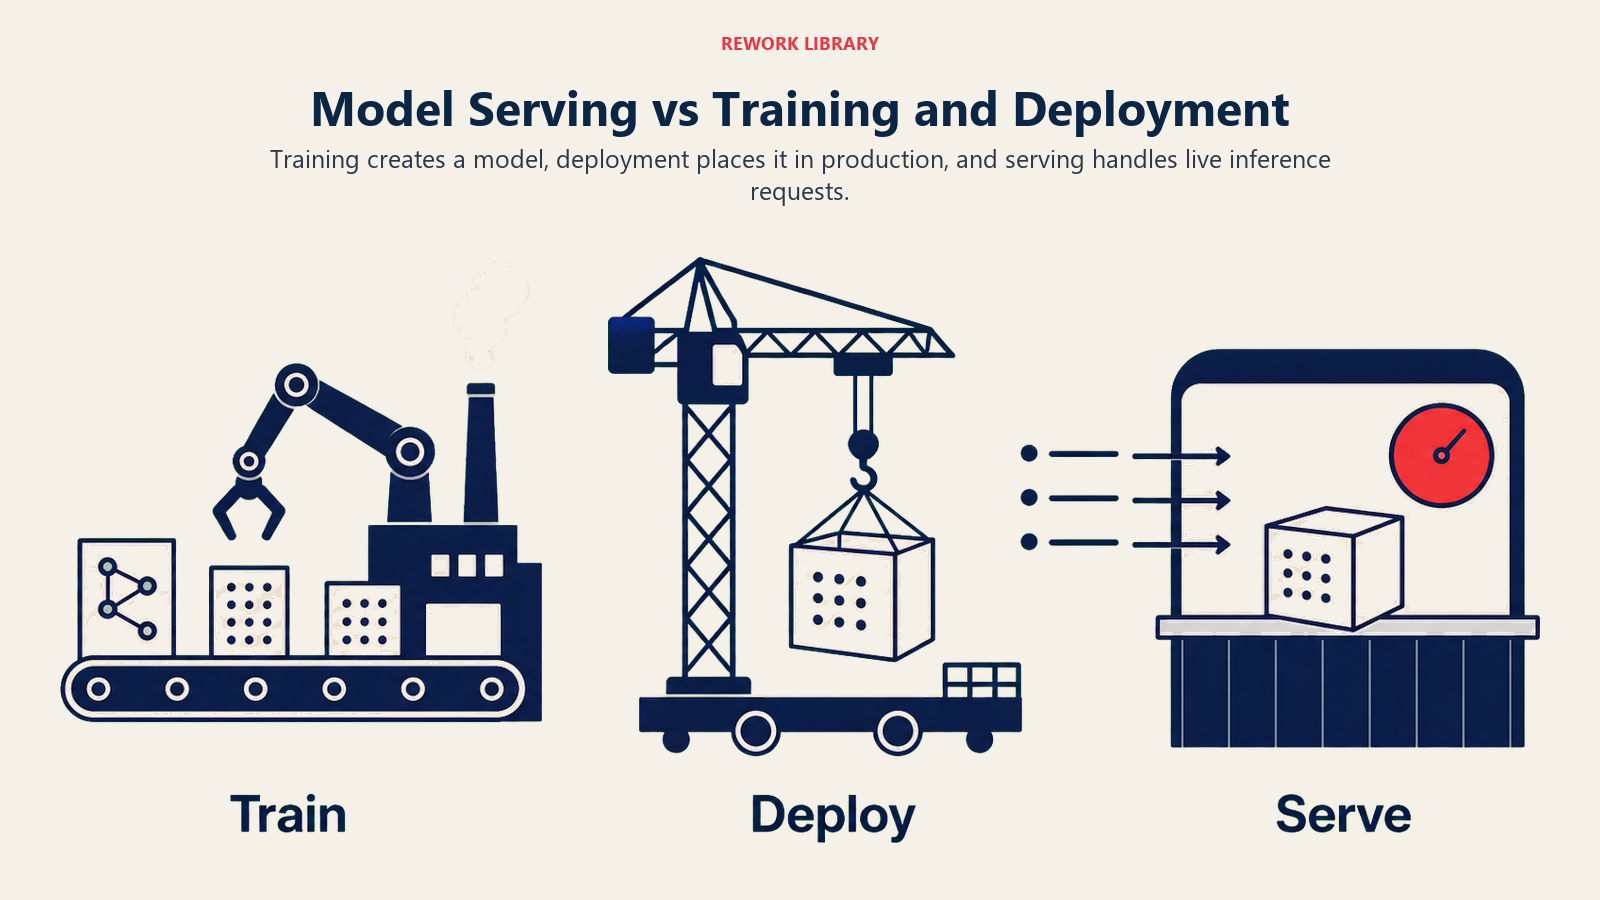
L'inférence est l'acte d'exécuter un modèle sur une entrée pour produire une sortie. C'est une opération de calcul. Le model serving est l'infrastructure qui rend l'inférence disponible comme service fiable.
L'optimisation de l'inférence regroupe les techniques qui rendent l'inférence plus rapide ou moins chère : quantization, batching, mise en cache, optimisation des kernels. L'optimisation est une propriété du modèle et de son runtime. Le serving est le système qui héberge et expose le modèle optimisé.
Le MLOps est la pratique plus large de l'industrialisation du machine learning : pipelines d'entraînement, suivi des expériences, registre de modèles, automatisation du déploiement et monitoring. Le model serving est l'un des composants du cycle de vie MLOps, plus précisément la couche de déploiement et d'exécution.
Le déploiement de modèle est parfois employé comme synonyme du model serving, mais il désigne plus exactement l'acte de rendre un modèle disponible (l'événement de transition), tandis que le serving désigne l'état opérationnel continu de cette disponibilité.
L'architecture d'un système de serving en production
Un système de model serving en production comporte généralement plusieurs couches :
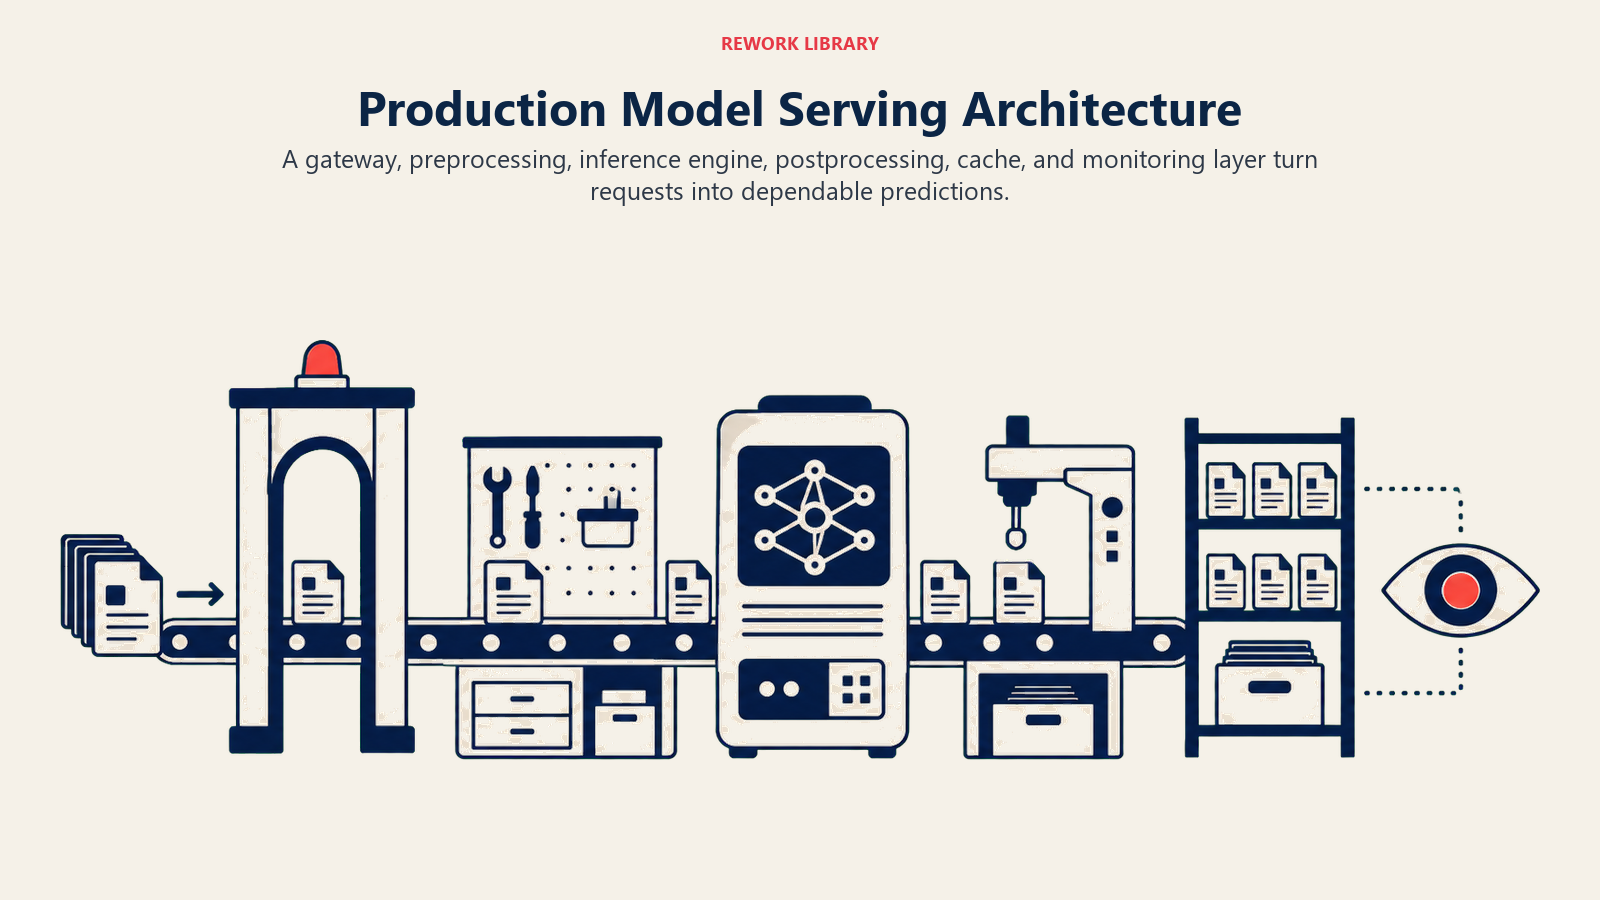
Registre de modèles. Un entrepôt versionné des artefacts de modèles entraînés. Avant d'être servi, un modèle doit y être enregistré (avec ses métadonnées : date d'entraînement, benchmarks de performance, dépendances).
Runtime de serving. Le logiciel qui charge le modèle et exécute l'inférence. Parmi les options courantes figurent TensorFlow Serving, TorchServe, NVIDIA Triton Inference Server et les runtimes gérés par les fournisseurs, comme les endpoints AWS SageMaker ou Azure ML. Pour les grands modèles de langage en particulier, des frameworks comme vLLM, TGI (Text Generation Inference) et Ollama sont très utilisés.
API gateway. Elle achemine les requêtes entrantes, applique l'authentification et les limites de débit, et fournit une adresse de point d'accès stable qui ne change pas quand l'infrastructure de serving monte en charge ou se met à jour.
Autoscaler. Il surveille le volume de requêtes et l'utilisation des ressources, puis ajoute ou retire des instances de modèle pour suivre la charge. C'est le mécanisme qui permet à un système d'absorber des pics de trafic multipliés par 10 sans surprovisionner en permanence pour la capacité maximale.
Suivi des modèles. Il suit la latence, les taux d'erreur et la qualité des sorties en production, et alerte quand le comportement du modèle s'écarte de la référence.
Les décisions métier du model serving
Le model serving est le moment où les arbitrages de coût et de fiabilité de votre investissement en IA deviennent concrets. Les dirigeants influencent généralement plusieurs décisions clés.
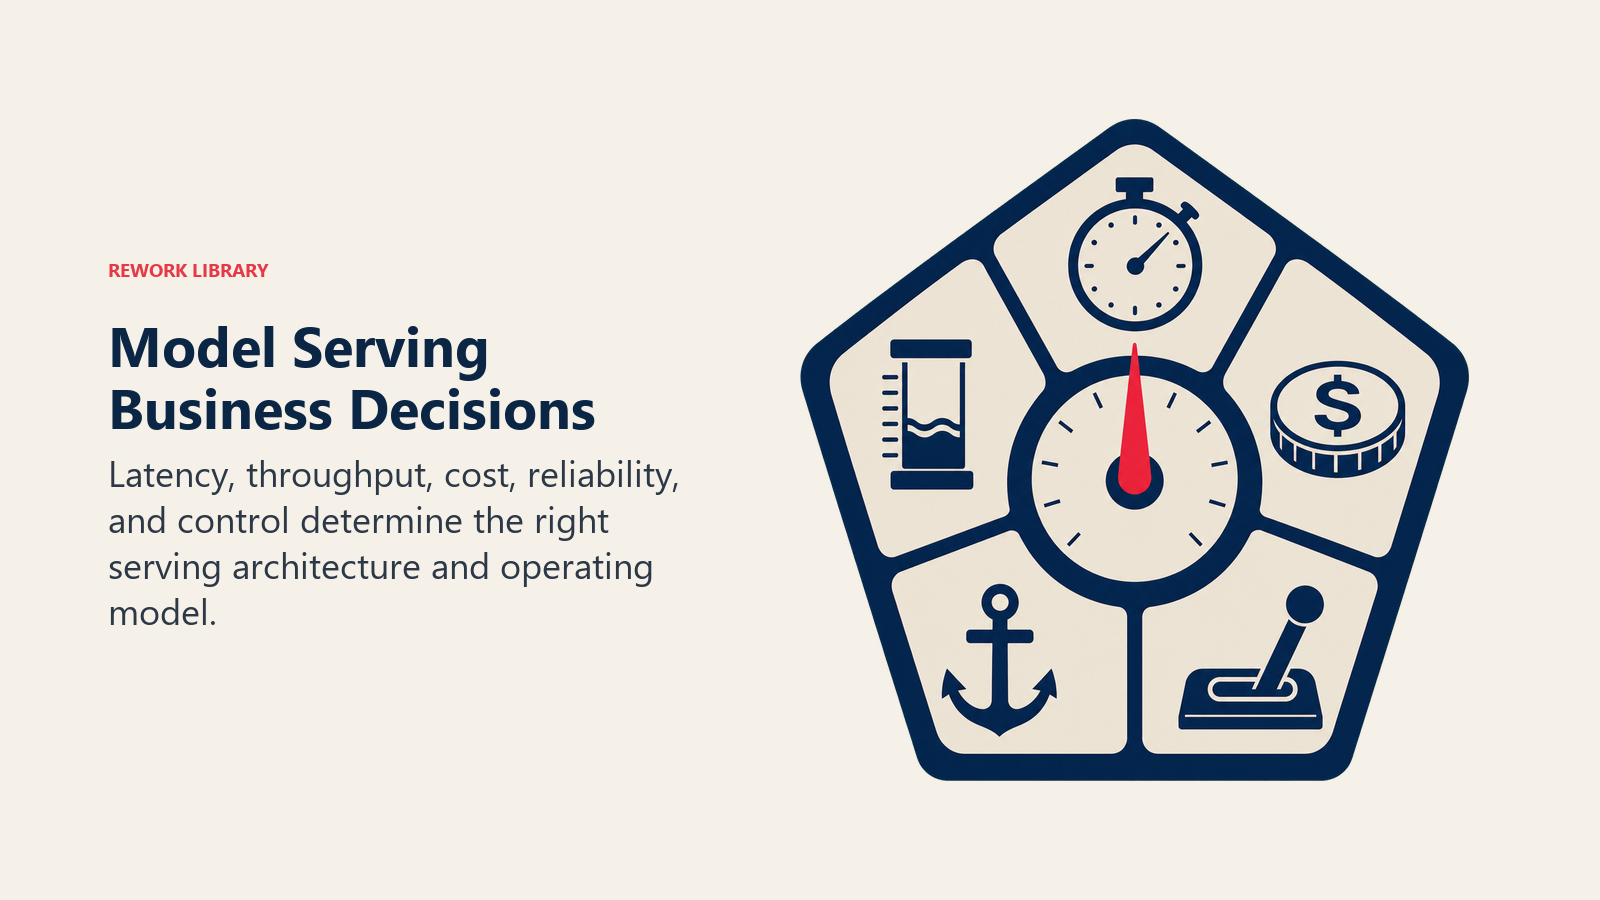
Géré ou auto-hébergé. Les fournisseurs cloud (AWS, Azure, Google Cloud) proposent des plateformes de model serving gérées, où le fournisseur s'occupe de la montée en charge, du matériel et du runtime. Le serving auto-hébergé (sur votre propre infrastructure cloud ou sur site) offre plus de contrôle et un coût potentiellement plus bas à grande échelle, mais demande un investissement en ingénierie pour l'exploiter.
La plupart des entreprises de taille intermédiaire commencent par un serving géré auprès d'un grand fournisseur, puis passent à l'auto-hébergement à plus grande échelle, ou quand l'équilibre économique justifie la charge d'ingénierie.
Endpoints partagés ou dédiés. La plupart des API d'IA tournent sur une infrastructure partagée, où vos requêtes font la queue avec celles d'autres clients. Les endpoints dédiés vous réservent de la capacité et garantissent latence et disponibilité, mais à un coût plus élevé. Pour les applications de production sensibles à la latence, le coût d'un endpoint dédié est souvent justifié.
Arbitrage entre latence et coût. Un matériel plus rapide, de gamme supérieure, coûte plus cher. Regrouper les requêtes (attendre que plusieurs s'accumulent pour les traiter ensemble) améliore l'utilisation du matériel et réduit le coût, mais ajoute de la latence. Le bon arbitrage dépend de la sensibilité de votre cas d'usage au temps de réponse.
Configuration de la montée en charge. Quel est le nombre minimal d'instances de modèle à garder actives (zéro signifie des délais de démarrage à froid à la reprise du trafic ; un nombre non nul signifie que l'on paie en permanence une capacité inutilisée) ? Quel est le maximum ? Avec quelle vigueur l'autoscaler doit-il ajouter de la capacité ?
Ces décisions ont des conséquences directes sur les coûts. Un déploiement de serving surdimensionné peut gaspiller des dizaines de milliers de dollars par mois. Un déploiement sous-dimensionné dégrade l'expérience utilisateur pendant les pics.
Le model serving pour les grands modèles de langage
Les grands modèles de langage posent des défis de serving que les modèles plus petits ne connaissent pas, principalement à cause de leur taille.
Un modèle de classe GPT-4 exige des dizaines, voire des centaines de gigaoctets de mémoire GPU rien que pour être chargé. La plupart des déploiements de LLM en production nécessitent un serving multi-GPU, où le modèle est réparti sur plusieurs GPU. On parle de parallélisme tensoriel ou de parallélisme de pipeline, et le framework de serving doit l'orchestrer.
La gestion du cache clé-valeur (KV) est une préoccupation opérationnelle majeure pour le serving de LLM. Quand le modèle génère une réponse token par token, il met en cache les calculs intermédiaires des tokens précédents (le cache KV) pour éviter de les recalculer. Ce cache réside en mémoire GPU et grossit avec la longueur du contexte. Un système de serving doit gérer cette mémoire avec soin entre les requêtes concurrentes.
Le batching continu est une optimisation propre aux LLM : le système de serving regroupe les nouvelles requêtes entrantes avec celles qui sont déjà en cours de génération, ce qui maintient une forte utilisation du GPU au lieu d'attendre la fin des lots avant d'en démarrer de nouveaux. Des systèmes comme vLLM ont ouvert la voie à cette approche.
Pour les déploiements d'Edge AI, le model serving sur du matériel contraint (ordinateurs portables, téléphones, appareils embarqués) demande des optimisations supplémentaires : modèles plus petits, inférence en précision réduite et frameworks de serving conçus pour des environnements CPU ou GPU mobile plutôt que pour les GPU de centres de données.
Signes qu'un problème de serving nuit à la valeur métier
Les problèmes de model serving ne se manifestent pas toujours comme des pannes d'infrastructure. Le plus souvent, ils prennent ces formes :
- Des utilisateurs signalent que l'IA « semble lente », sans alerte technique claire
- L'adoption retombe après un pic initial de lancement, sans problème de qualité évident
- Les coûts augmentent plus vite que l'usage
- Des temps de réponse irréguliers (rapides parfois, lents à d'autres moments) donnent à la fonctionnalité un air peu fiable
- Les taux d'erreur grimpent sous charge alors que le modèle fonctionne bien en conditions normales
Si vous observez ces symptômes, le problème ne vient généralement pas du modèle lui-même, mais de la couche de serving.
Chiffres clés :
- Le model serving est l'infrastructure qui met un modèle d'IA entraîné à disposition comme service de production, à distinguer de l'inférence (le calcul) et du MLOps (la pratique opérationnelle plus large).
- Les systèmes de serving en production comprennent un registre de modèles, un runtime de serving, une API gateway, un autoscaler et du monitoring.
- Les décisions métier clés : géré ou auto-hébergé, endpoints partagés ou dédiés, arbitrage entre latence et coût, configuration de la montée en charge.
- Les grands modèles de langage posent des défis de serving spécifiques : gestion de la mémoire multi-GPU, cache KV et batching continu.
- La plupart des problèmes de serving se manifestent par une dégradation de l'expérience utilisateur (lenteur, irrégularité) plutôt que par des pannes franches.
Questions fréquentes sur le model serving : déployer des modèles d'IA qui tiennent à grande échelle
Devons-nous nous préoccuper du model serving si nous utilisons l'API d'un fournisseur comme OpenAI ?
Oui, même si le fournisseur en gère l'essentiel. Vous devez tout de même réfléchir aux endpoints partagés ou dédiés (pour les garanties de latence), aux limites de débit (qui influent sur le serving sous charge) et aux endpoints régionaux (pour la latence et la résidence des données). Si vous utilisez l'API d'un fournisseur pour un système de production, vous dépendez implicitement de son infrastructure de serving.
Quand faut-il envisager d'auto-héberger notre propre model serving ?
Quand votre volume d'usage est assez élevé pour que l'économie unitaire d'une infrastructure auto-hébergée batte les coûts d'une API gérée (en général au-delà de 50 à 100 k$ par an de dépenses d'inférence, selon le modèle), quand vos exigences de confidentialité interdisent d'envoyer des données à des API externes, ou quand vos exigences de latence ne peuvent pas être satisfaites par les endpoints partagés des fournisseurs.
Qu'est-ce qu'un « cold start » en model serving ?
Quand un endpoint de serving redescend à zéro instance pour économiser, la requête suivante doit attendre le démarrage d'une nouvelle instance et le chargement du modèle en mémoire GPU. Cela peut prendre de 30 secondes à plusieurs minutes selon la taille du modèle, et l'utilisateur le vit comme un long délai. Garder au moins une instance active (un « warm pool ») supprime les cold starts, mais revient à payer une capacité inutilisée.
Quel est le lien entre le model serving et les tests A/B de modèles ?
L'infrastructure de model serving rend les tests A/B possibles en dirigeant un pourcentage du trafic vers une nouvelle version du modèle pendant que le reste va vers la version existante. Vous pouvez ainsi mesurer l'effet du nouveau modèle sur le comportement des utilisateurs et les indicateurs de qualité avant un déploiement complet. C'est l'une des capacités clés qui rendent gérable le passage de « le modèle est entraîné » à « le modèle est déployé en toute sécurité ».

Co-Founder, Rework.com