Qu'est-ce que la sécurité de l'IA ? Protéger les systèmes d'IA contre les attaques
Turn this article into takeaways for your work.


Each assistant summarizes the article only for you and suggests best practices for your work.
Une société de services financiers a déployé une IA de traitement documentaire pour extraire les données des factures. En deux semaines, un fournisseur a découvert qu'en intégrant du texte caché dans les images de factures, il pouvait pousser le système à extraire des montants erronés. Personne n'a écrit de charge d'injection SQL. Personne n'a exploité un dépassement de mémoire tampon. L'attaque a fonctionné en exploitant la façon dont le modèle lui-même traitait les données d'image.
Voilà le défi central de la sécurité de l'IA. La surface d'attaque ne se limite pas à l'infrastructure environnante : elle comprend le modèle, les données d'entraînement, les prompts qui commandent son comportement et les sorties qui alimentent les systèmes en aval. Les disciplines classiques de cybersécurité protègent les logiciels. La sécurité de l'IA protège l'IA elle-même.
Pourquoi la sécurité de l'IA se distingue de la cybersécurité classique
La sécurité logicielle classique protège contre des attaquants qui exploitent le code : dépassements de mémoire tampon, attaques par injection, contournements d'authentification. Ces attaques fonctionnent parce que le code se comporte de façon déterministe : un attaquant qui trouve une entrée déclenchant des chemins d'exécution inattendus peut causer des dégâts prévisibles.
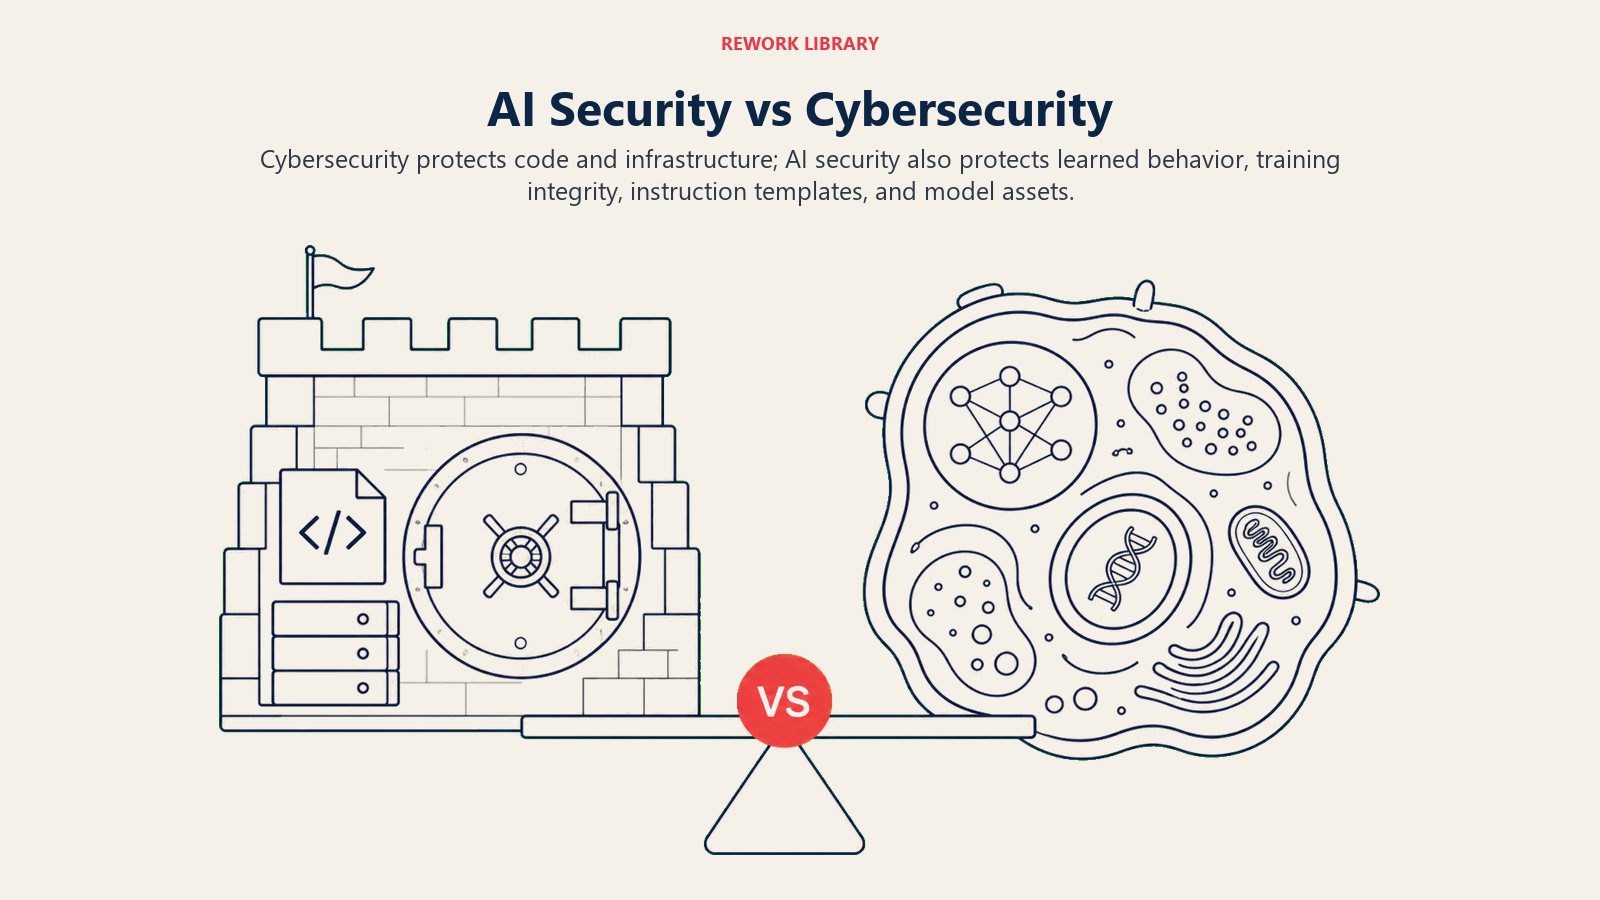
Les systèmes d'IA introduisent un autre type de vulnérabilité. Les modèles sont entraînés sur des données, et cet entraînement peut être manipulé. Ils réagissent aux entrées d'une manière que des exemples adverses soigneusement construits, d'apparence normale pour un humain, peuvent influencer. Les modèles qui traitent du texte peuvent recevoir, dans leurs entrées, des instructions intégrées qui l'emportent sur leur comportement prévu. Et les modèles eux-mêmes, qui représentent une valeur commerciale considérable, peuvent être volés ou répliqués.
Aucune de ces attaques ne suppose de trouver un bug dans le code. Elles exploitent des propriétés du fonctionnement même du machine learning.
Cela ne veut pas dire que la sécurité classique est sans objet pour les systèmes d'IA. La sécurité de l'infrastructure, les contrôles d'accès et le développement logiciel sécurisé s'appliquent tous. Mais ils ne suffisent pas. La sécurité de l'IA ajoute une couche de préoccupations propres au comportement du modèle, à l'intégrité de l'entraînement et à la manipulation au moment de l'inférence.
Les principales catégories de menaces pour la sécurité de l'IA
Les attaques adverses manipulent les entrées pour que les modèles produisent des sorties incorrectes. En vision par ordinateur, cela consiste à ajouter à une image un bruit calculé au niveau du pixel : l'image paraît normale à l'œil humain, mais un modèle de classification renvoie une étiquette totalement fausse, avec un niveau de confiance élevé. Dans les systèmes textuels, les attaques adverses fabriquent des entrées qui exploitent des faiblesses précises dans la façon dont les modèles représentent le langage. Ces attaques comptent pour tout système d'IA qui prend des décisions lourdes de conséquences à partir de ses entrées, de la détection de fraude à la modération de contenu en passant par l'imagerie médicale.
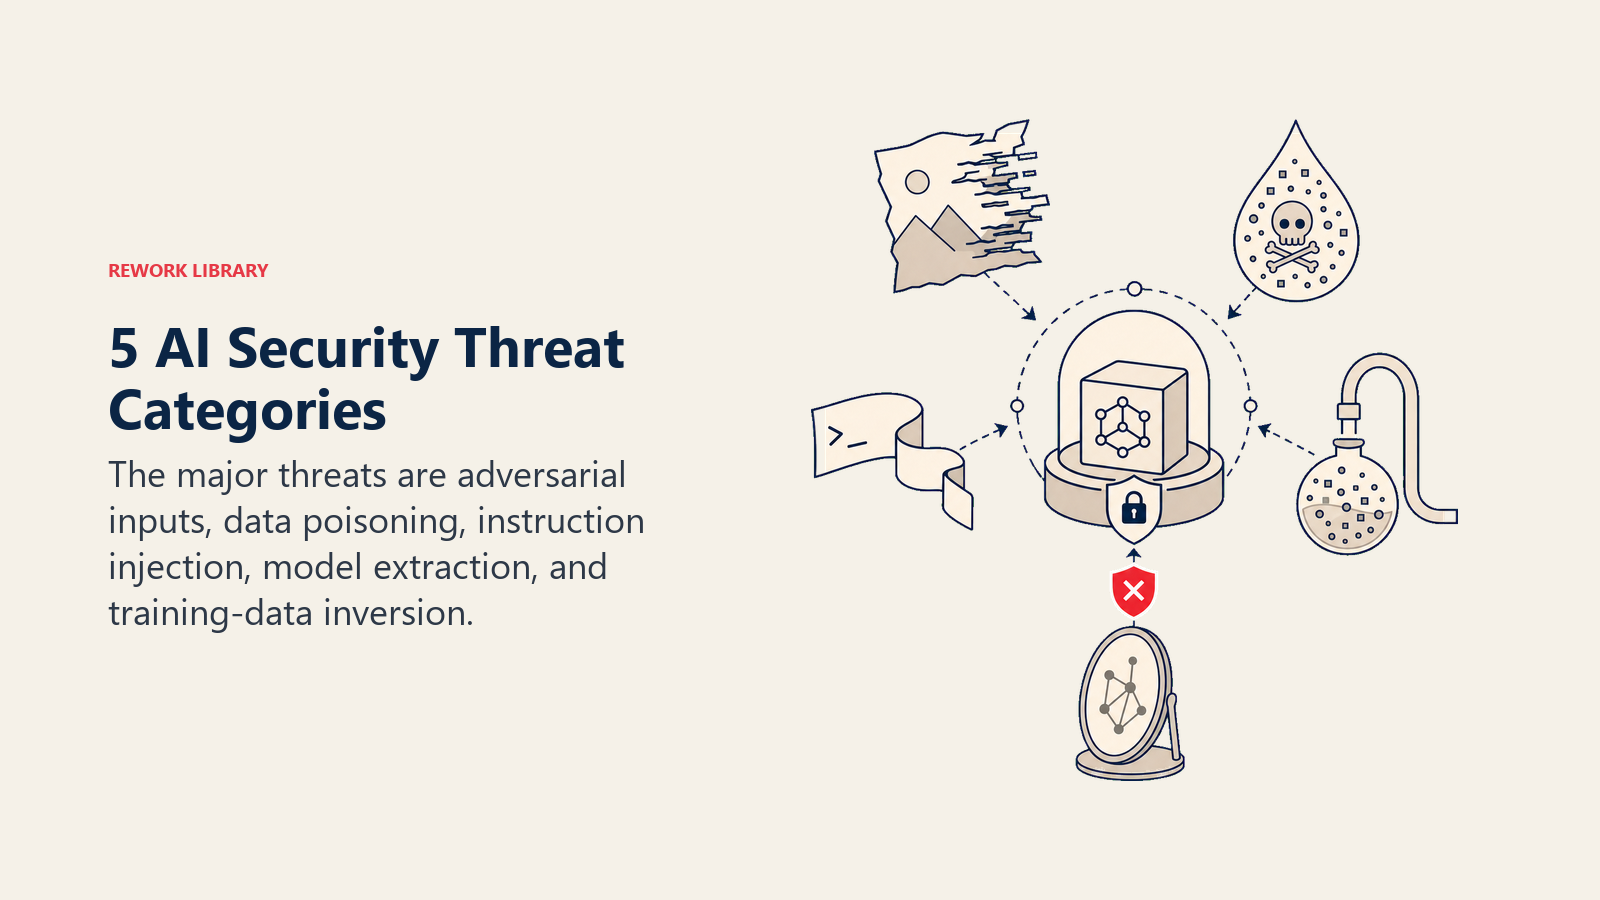
L'empoisonnement de données corrompt le processus d'entraînement. Un attaquant qui peut influencer les données d'entraînement d'un modèle peut créer une « porte dérobée » : un motif précis qui pousse le modèle à se comporter de façon incorrecte chaque fois qu'il apparaît en production, alors qu'il fonctionne normalement le reste du temps. Un modèle entraîné sur des données collectées sur le web est exposé à tout contenu qui peut y être publié. Les attaques sur la chaîne d'approvisionnement des jeux de données d'entraînement sont une préoccupation croissante, en particulier pour les organisations qui utilisent des données publiques ou des fournisseurs de données tiers.
Le prompt injection vise les grands modèles de langage et les autres systèmes qui suivent des instructions en langage naturel. Un attaquant intègre des instructions dans un contenu que l'IA va traiter, et ces instructions l'emportent sur le comportement prévu du système. Un bot de service client à qui l'on demande de « résumer ce document » peut recevoir un document contenant des instructions cachées lui ordonnant plutôt de révéler son prompt système, d'ignorer ses filtres de contenu ou d'exfiltrer des informations. À mesure que les systèmes d'IA prennent en charge des workflows agentiques avec accès à des outils et à des bases de données, le prompt injection devient une menace sérieuse : une instruction injectée avec succès peut amener l'agent à exécuter des actions que ses exploitants n'ont jamais voulues.
Le vol et l'extraction de modèle visent le modèle lui-même, en tant qu'actif de valeur. À force de requêtes répétées, un attaquant peut reconstituer une approximation du comportement d'un modèle propriétaire, et donc voler la propriété intellectuelle qu'il renferme sans jamais accéder à ses poids. Les organisations qui ont investi des millions dans l'entraînement ou l'ajustement de modèles courent un vrai risque de vol de propriété intellectuelle de la part d'adversaires bien dotés en moyens.
L'inversion de modèle extrait des informations sur les données d'entraînement. Dans certains cas, des attaquants peuvent interroger un modèle de façon à révéler des détails sur ce qui a servi à l'entraîner, y compris des données potentiellement sensibles sur des personnes dont les informations figuraient dans le jeu d'entraînement. Cela crée un risque pour la vie privée distinct d'une fuite de données : l'information sensible n'est pas volée dans une base de données, elle est extraite d'un modèle.
En quoi la sécurité de l'IA diffère de la sûreté de l'IA
Les deux termes sont souvent confondus, mais ils couvrent des menaces différentes.
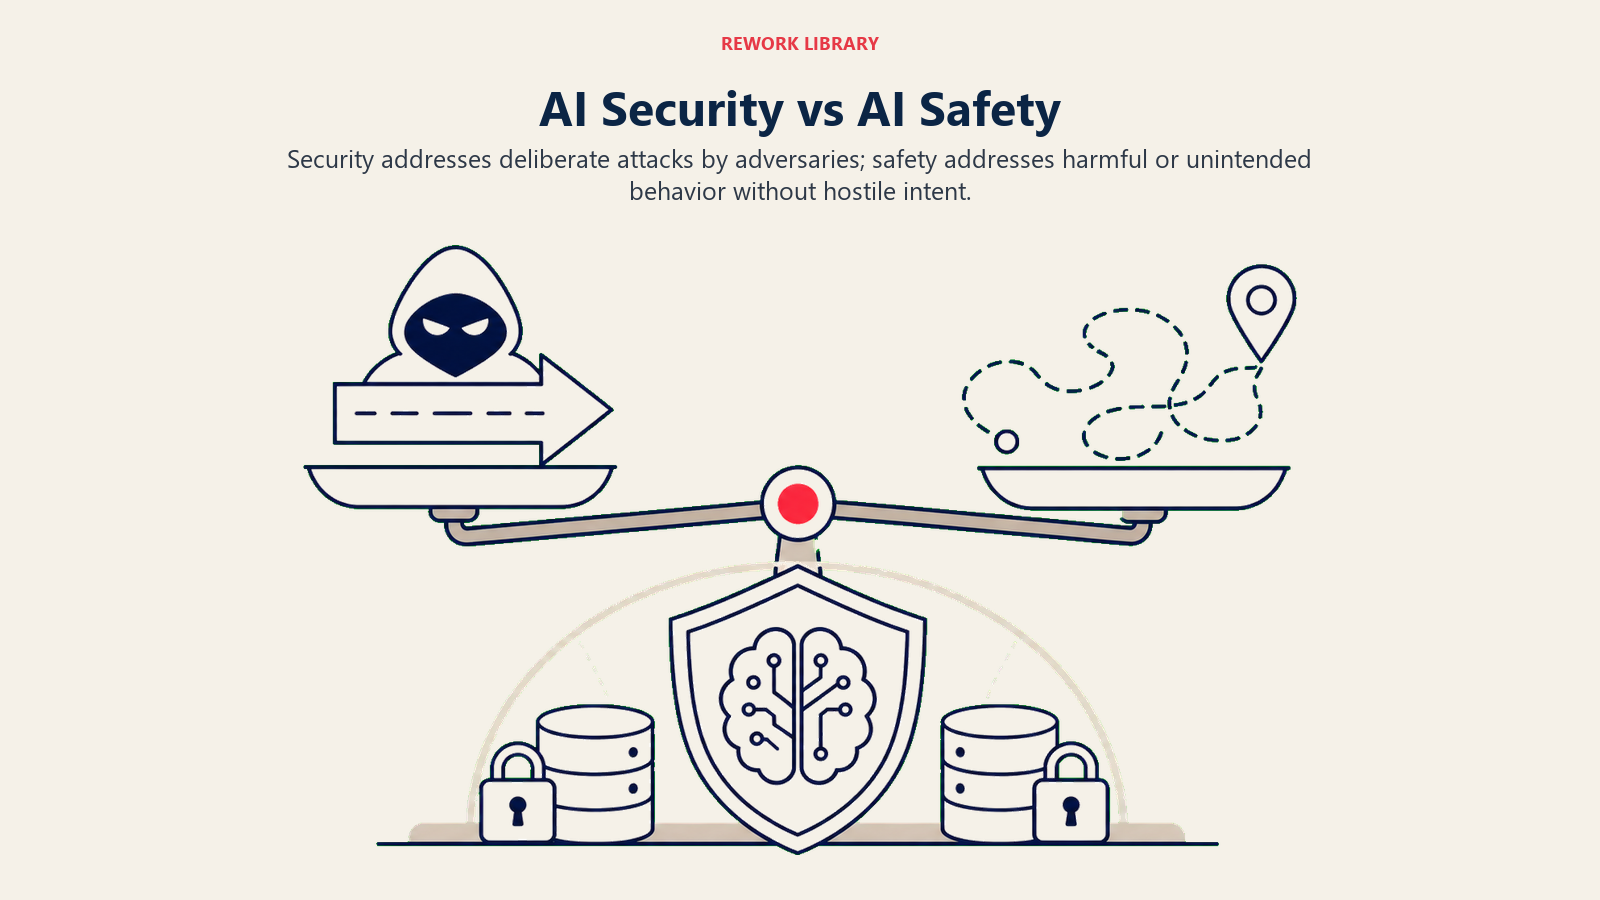
La sûreté de l'IA s'intéresse aux systèmes d'IA qui se comportent de façon imprévue à cause d'un défaut d'alignement, de cas limites ou de défaillances de capacités. Elle pose la question suivante : que se passe-t-il quand l'IA se trompe sans aucune intention hostile ? Par exemple, un système de recommandation qui optimise l'engagement au détriment du bien-être des utilisateurs, une défaillance de robustesse quand un modèle rencontre des entrées hors distribution, ou un workflow agentique qui atteint son objectif d'une manière que ses concepteurs n'avaient pas anticipée.
La sécurité de l'IA s'intéresse à l'attaque délibérée. Elle pose cette autre question : que peut faire un adversaire pour que l'IA se comporte d'une manière qui profite à l'attaquant ? Les mêmes concepts techniques de fond, comme les entrées adverses, apparaissent parfois dans les deux domaines. Mais la recherche en sûreté porte sur les défaillances involontaires, alors que la recherche en sécurité porte sur l'exploitation intentionnelle.
Les deux comptent. Un système d'IA en production a besoin d'ingénierie de la sûreté pour gérer proprement les entrées inattendues, et d'ingénierie de la sécurité pour faire face aux attaques délibérées.
La sécurité de l'IA dans la pratique en entreprise
Pour les organisations qui déploient de l'IA, les enjeux de sécurité se traduisent en pratiques concrètes.
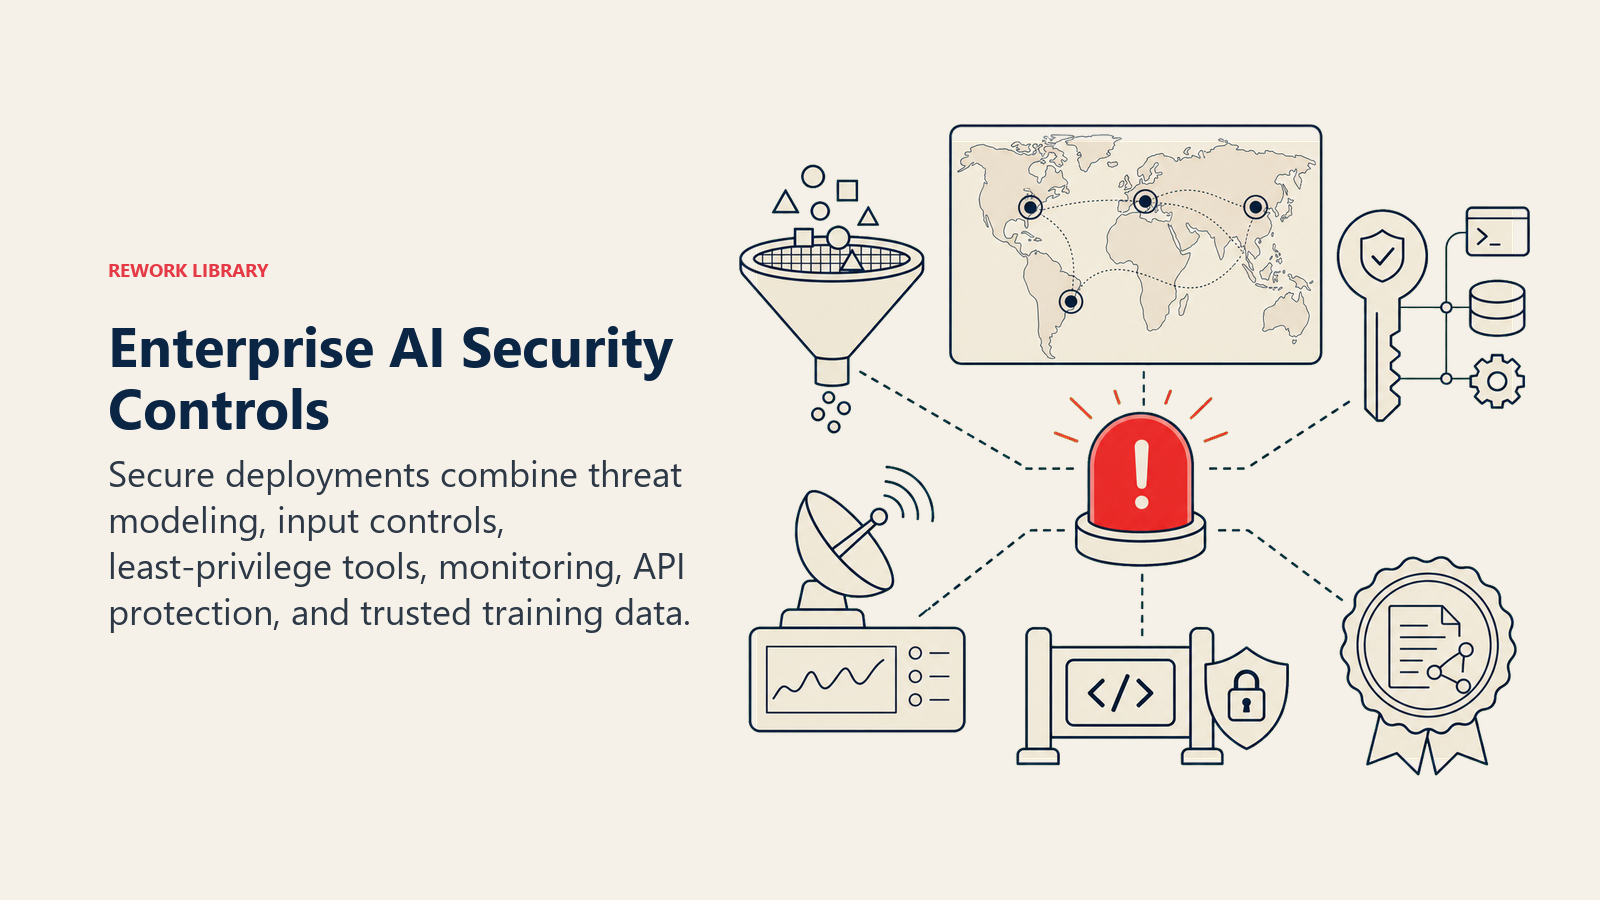
Modélisation des menaces avant le déploiement. Avant qu'un modèle passe en production, passez en revue les surfaces d'attaque précises qu'il expose. Qui peut lui envoyer des entrées ? Quelles actions peut-il exécuter ? Que gagnerait un attaquant motivé en le manipulant ? Cette analyse détermine les contrôles de sécurité qui valent la peine d'être financés.
Validation et assainissement des entrées. Pour les systèmes qui traitent du contenu fourni par les utilisateurs, mettez en place des filtres sur les entrées avant qu'elles n'atteignent le modèle. Pour les systèmes fondés sur des LLM, cela revient à repérer les motifs de prompt injection, même si aucun filtre n'est complet face à un attaquant déterminé. Pour les systèmes de traitement de documents, considérez chaque document comme potentiellement hostile.
Défenses contre le prompt injection pour les systèmes agentiques. Les agents IA ayant accès à des outils demandent une attention particulière. Des contrôles d'architecture, comme séparer l'espace des instructions de l'espace des contenus, limiter les outils auxquels un agent peut accéder et exiger une confirmation humaine pour les actions sensibles, réduisent le rayon d'impact d'une injection réussie. La défense en profondeur est le bon modèle mental : aucun contrôle ne suffit à lui seul.
Supervision des sorties et détection d'anomalies. Les outils d'observabilité de l'IA qui suivent ce que les modèles produisent en production peuvent repérer un comportement anormal révélateur d'une attaque en cours. Des motifs de sortie inhabituels, des appels d'outils inattendus dans les systèmes agentiques ou une dérive statistique des sorties sont autant de signaux à surveiller.
Contrôles d'accès sur les API de modèles. Les points d'accès des modèles doivent être traités comme des actifs sensibles. La limitation de débit réduit la faisabilité des attaques par extraction. L'authentification garantit que seuls les clients autorisés peuvent interroger le modèle. La journalisation crée une piste d'audit pour l'analyse forensique.
Sécurité de la chaîne d'approvisionnement des données d'entraînement. Les organisations qui s'entraînent sur des données externes devraient examiner la provenance de ces données avec la même rigueur que leurs dépendances logicielles. Des jeux de données sélectionnés et vérifiés sont plus sûrs que de vastes collectes web indifférenciées. Quand des données tierces sont inévitables, des exercices de red-teaming périodiques à la recherche de portes dérobées valent l'investissement.
La dimension réglementaire
La sécurité de l'IA devient un enjeu de conformité, pas seulement technique. L'AI Act européen exige que les systèmes d'IA à haut risque mettent en œuvre des mesures de sécurité appropriées, dont une protection contre les attaques adverses. Le NIST AI Risk Management Framework fait de la sécurité un élément central d'une gouvernance responsable de l'IA. Les organisations des secteurs réglementés (services financiers, santé, infrastructures critiques) doivent de plus en plus démontrer que leurs systèmes d'IA sont sûrs, et pas seulement fonctionnels.
Cette pression réglementaire relève le niveau d'exigence de la documentation de sécurité de l'IA. Les fiches de modèle d'IA et les pistes d'audit de l'IA doivent de plus en plus préciser comment les modèles ont été testés sur le plan de la sécurité, quelles vulnérabilités connues subsistent et quelles mesures d'atténuation sont en place.
Développer une capacité de sécurité de l'IA
Pour la plupart des organisations, la capacité de sécurité de l'IA se construit sur des fondations de sécurité existantes. Les équipes sécurité maîtrisent déjà la modélisation des menaces, l'architecture sécurisée et la réponse aux incidents. Il leur faut en plus connaître les catégories de menaces propres à l'IA et les techniques pour les tester.
Le red-teaming de l'IA est le moyen le plus direct de développer à la fois les connaissances et les défenses. Les exercices de red team menés sur des systèmes d'IA en production révèlent de vraies vulnérabilités dans de vrais contextes de déploiement, plutôt que des scénarios de menace abstraits. Les organisations qui pratiquent régulièrement le red-teaming de l'IA développent à la fois les défenses et le réflexe organisationnel pour les maintenir.
L'autre voie, découvrir les faiblesses de sécurité de l'IA après un incident en production, coûte nettement plus cher.
Concepts d'IA associés
- Sûreté de l'IA - Protéger l'IA contre les modes de défaillance involontaires
- Red-teaming de l'IA - Tests adverses pour repérer les vulnérabilités de sécurité
- Garde-fous de l'IA - Contrôles techniques sur les sorties des modèles
- Jailbreak - Comment les attaquants fabriquent des prompts pour contourner les contrôles de sûreté
- Observabilité de l'IA - Surveiller le comportement des modèles en production
- Gouvernance de l'IA - Responsabilité de l'organisation en matière de sécurité de l'IA
- Workflows agentiques - Systèmes d'IA à haut risque à prendre en compte pour la sécurité
- Piste d'audit de l'IA - Journalisation à des fins d'analyse forensique et de conformité
Ressources externes
- NIST AI Risk Management Framework - Cadre du gouvernement américain couvrant les exigences de sécurité de l'IA
- OWASP Top 10 for LLM Applications - La liste de référence de la communauté de la sécurité sur les vulnérabilités des LLM, dont le prompt injection
- MITRE ATLAS - Panorama des menaces adverses visant les systèmes d'IA, avec des études de cas d'attaques réelles
Questions fréquentes sur la sécurité de l'IA
Qu'est-ce que la sécurité de l'IA ?
La sécurité de l'IA est la discipline qui protège les modèles de machine learning et les pipelines d'IA contre les attaques délibérées : entrées adverses qui provoquent des sorties incorrectes, données d'entraînement empoisonnées, attaques par prompt injection sur les modèles de langage et vol de modèle. Elle étend la cybersécurité classique aux surfaces d'attaque propres au fonctionnement des systèmes d'IA.
En quoi la sécurité de l'IA diffère-t-elle de la sûreté de l'IA ?
La sûreté de l'IA traite les défaillances involontaires, c'est-à-dire les cas où un système d'IA produit des sorties nuisibles ou se comporte de façon imprévue sans intervention hostile. La sécurité de l'IA traite les attaques délibérées d'adversaires qui cherchent à exploiter l'IA à leur profit. Les deux comptent et appellent des défenses différentes, même si elles se recoupent par endroits.
Qu'est-ce que le prompt injection et pourquoi est-ce un risque sérieux ?
Le prompt injection consiste à intégrer des instructions malveillantes dans un contenu que l'IA va traiter, de sorte qu'elle suive ces instructions plutôt que sa programmation d'origine. C'est un risque sérieux parce que les systèmes d'IA agissent de plus en plus dans le monde réel : interroger des bases de données, envoyer des messages ou exécuter du code. Une instruction injectée avec succès peut amener un agent IA à exécuter des actions que ses exploitants n'ont jamais autorisées.
Que doit faire une organisation en premier pour améliorer la sécurité de l'IA ?
Commencez par une modélisation des menaces pour chaque système d'IA en production : identifiez qui peut lui envoyer des entrées, quelles actions il peut exécuter et ce qu'un attaquant gagne à le manipuler. Cette analyse révèle les attaques réellement pertinentes pour vos systèmes et concentre votre investissement sur les contrôles qui comptent le plus.

Co-Founder, Rework.com
On this page
- Pourquoi la sécurité de l'IA se distingue de la cybersécurité classique
- Les principales catégories de menaces pour la sécurité de l'IA
- En quoi la sécurité de l'IA diffère de la sûreté de l'IA
- La sécurité de l'IA dans la pratique en entreprise
- La dimension réglementaire
- Développer une capacité de sécurité de l'IA
- Concepts d'IA associés
- Ressources externes